原論文
Robust fine-tuning of zero-shot models
- 発表先
- CVPR 2022国際会議
- arXiv への初回投稿
- arXiv:2109.01903
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingwiseft2021,
  title = {{Robust fine-tuning of zero-shot models}},
  author = {Mitchell Wortsman and Gabriel Ilharco and Jong Wook Kim and Mike Li and Simon Kornblith and Rebecca Roelofs and Raphael Gontijo-Lopes and Hannaneh Hajishirzi and Ali Farhadi and Hongseok Namkoong and Ludwig Schmidt},
  year = {2021},
  eprint = {2109.01903},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2109.01903}
}
CLIP の登場時に驚かされたことの一つは、その頑健さだった。
ImageNet のラベルでタスク向けに微調整する前から、画像と言語の事前訓練で学んだ表現を使い、「a photo of a {クラス}」のテキストベクトルを分類器にしてゼロショット分類ができる。さらに、写真を集め直した ImageNetV2、スケッチの ImageNet-Sketch、芸術的な表現の ImageNet-R などに変えても、一般的な ImageNet モデルより精度低下がずっと小さかった。
ところが、微調整すると頑健さが消える。CLIP 原論文と BASIC の実験では、ImageNet で微調整すると ImageNet 自体の精度は大きく上がるが、複数の分布シフトデータセットではゼロショットモデルを下回った。
ワシントン大学、OpenAI、Columbia、Google、AI2 などの Wortsman、Ilharco らは、両方を手に入れようとした。
問題の定義
論文はまず、有効頑健性(effective robustness)という測り方を導入する。
ImageNet で訓練した一般的なモデルを散布図に置く。横軸を ImageNet 精度、縦軸を分布シフトデータセットの平均精度にすると、点はおおむね一本の直線に並ぶ。軸には logit 変換を施している。有効頑健性は、モデルがその線をどれだけ上回るかだ。
は一般的なモデルの傾向線。ゼロショット CLIP はそれより上の線にあり、有効頑健性が大きい。微調整後は右へ動き、ImageNet 精度が上がる一方で、一般的なモデルの線へ向かって下がる。
著者らは微調整でさらに二つの問題を観察した。第一に、ハイパーパラメータのわずかな違いでシフト後の精度が大きく変わる。例えば二つの学習率は ImageNet で 0.3 ポイントしか違わないのに、シフト後は 8 ポイント違い、ImageNet だけでは選べない。第二に、学習率を上げるなど強く微調整するほど、ImageNet は改善するが頑健さを大きく失う。
問題を解く
二つのステップ
WiSE-FT(weight-space ensembles for fine-tuning)は二段階だけだ。
- ゼロショットモデルを通常どおり微調整する。
- ゼロショットモデルと微調整後のモデルを、重み空間で線形に混ぜる。
がゼロショット、 が微調整後のモデルだ。中間値に追加訓練は要らず、得られるのも一つのモデルなので、推論コストは元と同じになる。
分類ヘッドはどうする?
混ぜるには、二つのモデルの各重みが対応していなければならない。CLIP のゼロショット分類器は線形層 で、各列は「a photo of a {クラス}」というクラス記述のテキストベクトルになる。出力は画像特徴と各列の内積だ。
エンドツーエンドの微調整では、このゼロショット分類器で最終分類層を初期化し、画像エンコーダと一緒に訓練する。構造、パラメータ形状、起点が一致するため、重みごとに混ぜられる。
実験の分類ヘッドには CLIP が学んだ温度スケールも含まれる。クラスのテキストは複数のプロンプトのベクトル平均で構成し、ImageNet では元の著者が提供した 80 テンプレートを使う。マージ時にはクラス順序、特徴の正規化、スケールの定義もそろえる必要がある。行列がどちらも だと確認するだけでは、第 列のクラスの一致までは確認できない。
LC の場合を計算してみよう。画像表現 を固定すると、
右辺は二組の logits の加重平均だ。例えばある画像の二クラスのスコアが と なら、 で になる。分類ヘッドを先に平均しても同じスコアを得る。各 logits を softmax に通してから確率を平均するのは別の演算だ。
エンドツーエンドの微調整では も変わるため、この分配則でネットワーク全体を二つの出力へ分解できない。そこで論文は、重み平均と出力アンサンブルを別々に測る。どちらも頑健さを改善するが、エンドツーエンドでは重み平均が比較上有利で、エンコーダも一つだけで済む。出力アンサンブルは画像を二度エンコードする。LC では固定特徴を共有でき、差は主に分類ヘッドの計算にある。
議論
散布図に描く曲線
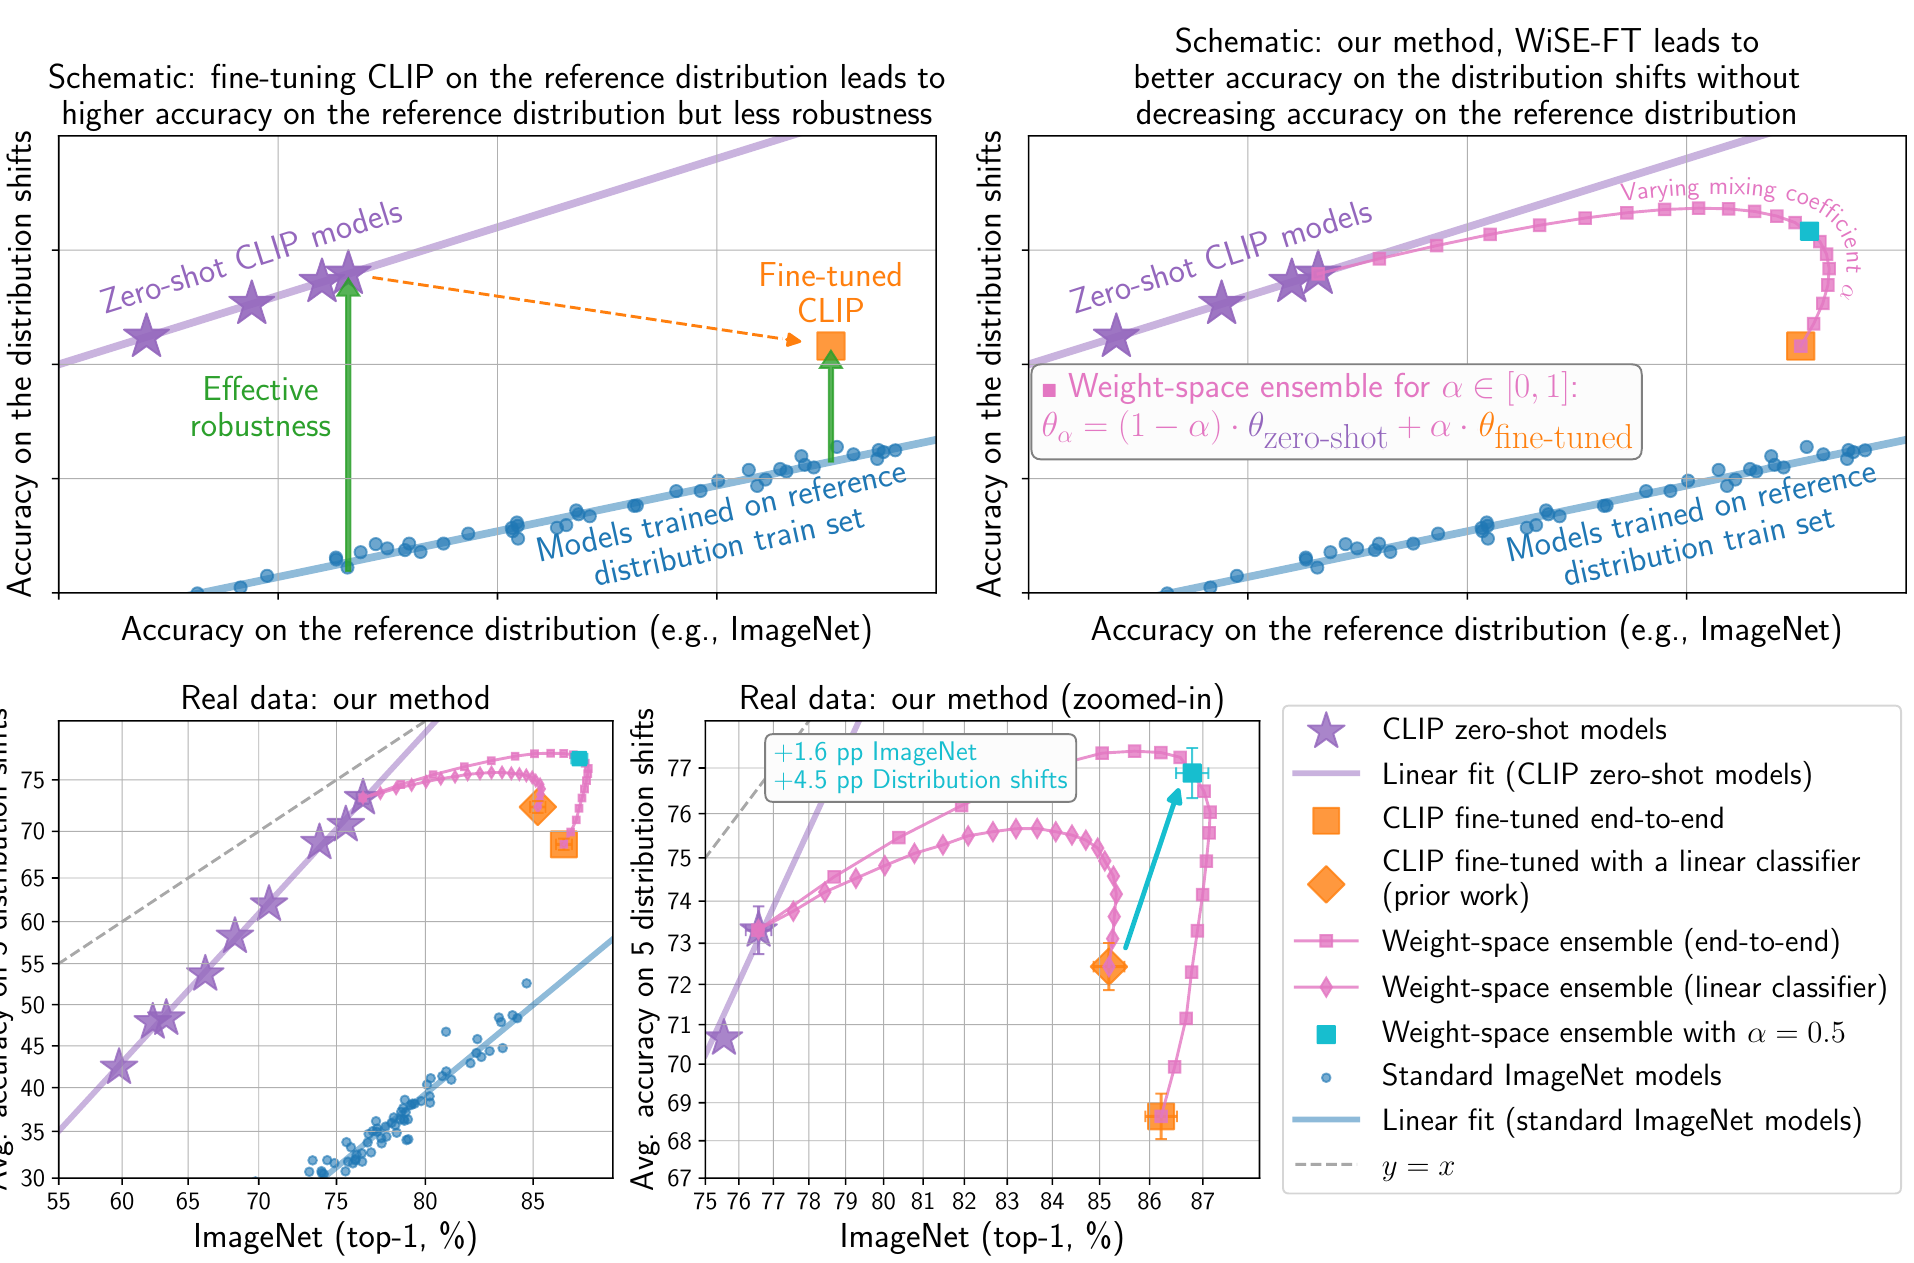
上段は概念図だ。左のゼロショット CLIP(紫の星)は一般的なモデルの傾向線より上にあり、緑の矢印の長さが有効頑健性になる。微調整後(橙の四角)は右へ進みつつ下がる。右の WiSE-FT は を 0 から 1 へ変えると、ピンクの点が右上へ膨らむ曲線を描き、中間に両端より右かつ上になる区間がある。
下段は ViT-L/14@336px の実測。右下の拡大図では、エンドツーエンド微調整の混合を表すピンクの四角が紫の星から右上へ膨らみ、最後に微調整モデルの橙の四角へ戻る。
数値を見る
主に使う CLIP ViT-L/14@336px の、ImageNet と五つの分布シフト派生データセットでの結果は次のとおり。
| モデル | ImageNet | 五つのシフトの平均 |
|---|---|---|
| ゼロショット(PyTorch 再現) | 76.6 | 73.4 |
| 線形分類器の微調整 | 85.2 | 72.6 |
| エンドツーエンド微調整 | 86.2 | 68.6 |
| WiSE-FT、エンドツーエンド、 | 86.8 | 76.9 |
| WiSE-FT、エンドツーエンド、各列で最適な | 87.1 | 77.4 |
精度(%)。原論文 Table 1 より整理。最終行の は列ごとに選んでいる。
エンドツーエンド微調整で ImageNet は 76.6% から 86.2% へ上がるが、シフトの平均は 73.4% から 68.6% へ下がる。WiSE-FT の は ImageNet が 86.8% で微調整後を少し上回り、シフト平均は 76.9% でゼロショットも上回る。CLIP 原論文の線形分類器微調整と比べ、シフト後の精度は 4~6 ポイント高い。
五つのシフトは異なる変化を調べる。ImageNetV2 は近い分布の写真を集め直す。ImageNet-R は彫刻や絵画などで、200 クラスのみ。Sketch はスケッチに変える。ObjectNet は背景や視点の違いを調べ、ImageNet と 113 クラスが重なる。ImageNet-A は ResNet-50 が誤分類する自然画像を集め、200 クラスを含む。評価は各データセットに対応するクラス集合に限定する必要があり、同じ 1,000 クラスのテスト集合として扱うことはできない。
| データセット | ゼロショット | エンドツーエンド微調整 | WiSE-FT、 |
|---|---|---|---|
| ImageNetV2 | 70.5 | 76.8 | 79.5 |
| ImageNet-R | 89.0 | 79.8 | 89.4 |
| ImageNet-Sketch | 60.9 | 57.9 | 64.7 |
| ObjectNet | 69.1 | 63.3 | 71.1 |
| ImageNet-A | 77.7 | 65.4 | 79.9 |
同じ ViT-L/14@336px の精度(%)。原論文 Table 1 より整理。
ImageNetV2 は微調整だけでも改善し、混合でさらによくなる。ImageNet-R と ImageNet-A は微調整で大きく下がり、混合で回復する。五つの平均だけでは、この二つの状況が混ざる。また、各列で最適な を選んだ行は、異なる目標に有利な選択を集めたもので、一つのモデルの成績としては読めない。
CLIP 以外でも、ALIGN、BASIC、JFT で事前訓練した ViT に似た傾向が見られた。さらに六つの分布シフト、すなわち WILDS の衛星画像と野生動物カメラ、CIFAR-10.1 と 10.2、動画フレームの摂動でも役立つ。通常の七つの転移学習データセットでも有効で、相対誤り率を 4%~49% 減らした。
ハイパーパラメータ選択が簡単になる
散布図の代わりに、 に対して精度を直接描いてみる。六つの図は、横軸がゼロショットの 0 から微調整後の 1 まで、ピンクの線が重み補間だ。斜めの破線は端点の精度を線形に混ぜた基準、水平の破線はよいほうの端点を示す。
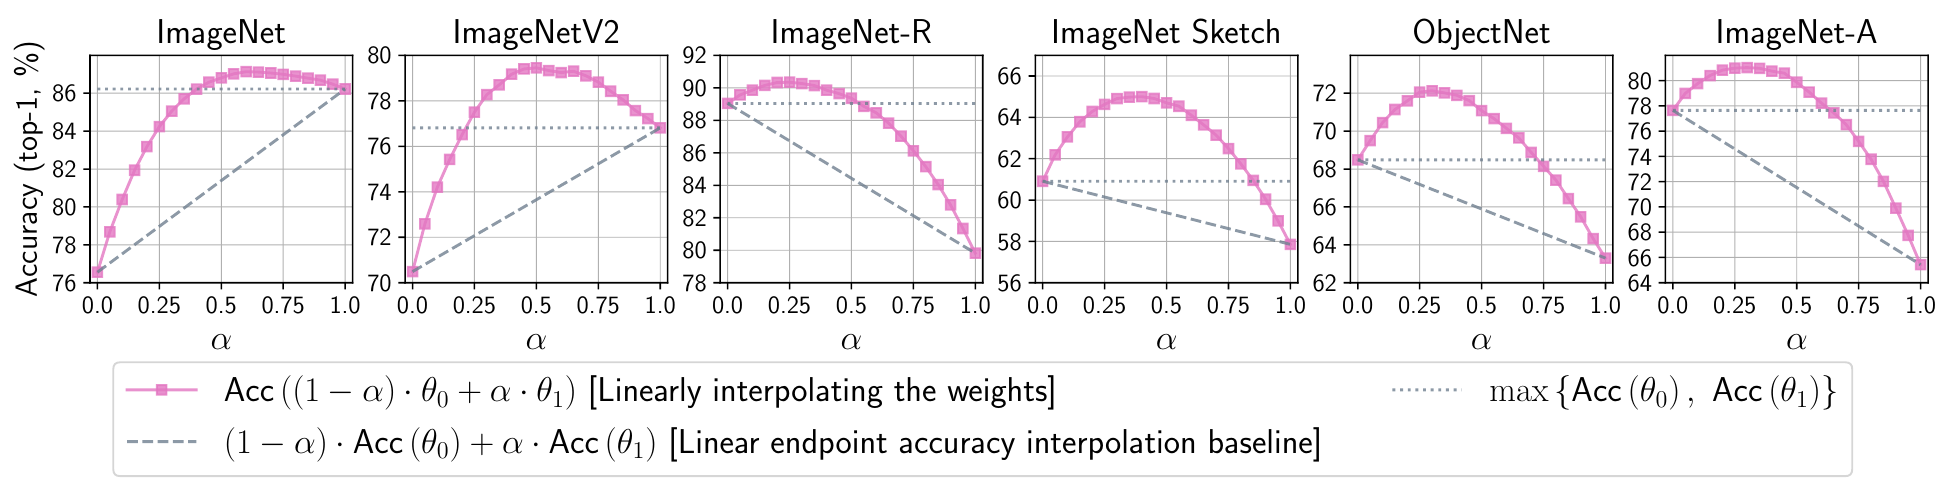
ピンクの線は中間で膨らみ、六つすべてに両端を上回る区間があるが、最良の位置は一致しない。トレードオフ曲線が見えるとともに、最適な一係数は対象データ次第だとわかる。
先ほどの第一の問題に戻ろう。ハイパーパラメータが少し変わるとシフト後の成績が大きく変わり、ImageNet だけでは見分けられない。
WiSE-FT はこれを 一つの調整へ置き換える。頑健さが大きく落ちる学習率で微調整しても、 を調整すれば ImageNet とシフト後のよいトレードオフを取り戻せる。しかも の調整に再訓練は要らない。実験でこの最良の曲線に達したのは、WiSE-FT と全反復点の EMA という重み平均の手法だけだった。
は便利な出発点で、副題の「半分」もここから来る。常に最良になるという導出はない。付録で半分固定と各設定の最適値を比較すると、ImageNet と五つのシフトの総合平均の差は約 0~0.4 ポイントだった。デプロイ先を代表する検証集合があれば、補間線上で係数を調べよう。各候補の順伝播評価は必要だが、微調整をやり直す時間は省ける。
相補性はどこで生まれるか
著者らはまず固定特徴の LC で二つの分類器を解析する。予測の不一致だけでなく、不一致時にどちらがアンサンブルの結果を決めるかも調べた。ImageNet では微調整分類器が優勢になりやすく、ほとんどのシフトではゼロショット分類器が優勢になる。ImageNetV2 は例外だ。
これはスコアの確信度の尺度と関わる。最大と 2 番目の logit の差を margin とすると、参照分布では微調整モデル、シフト後ではゼロショットモデルの margin が大きい。それぞれ得意な標本が異なれば、logits の加重平均が相補性を保てる可能性がある。これは LC の実験解析であり、表現自体も変わるエンドツーエンドについては、誤り地形の経験的観察にとどめている。
ほかのベースラインも丁寧に比較している。学習率、訓練長、早期停止、ゼロショット重みへの 正則化を調べ、LC ではゼロショット出力への蒸留、label smoothing、、weight decay も試す。一部の頑健さを取り戻す手法もあるが、再訓練や正則化強度の選択が要る。WiSE-FT は微調整を終えてから、安価な重み補間でトレードオフを調整できる。
対象範囲も具体的だ。主結果は自然な分布シフトであり、敵対的攻撃やあらゆる未知分布まで調べてはいない。重み混合には互換性のある構造とクラスの意味が必要だ。エンコーダ自体が異なるなら、出力アンサンブルを比較する必要があり、この一行の重み平均は適用できない。
結論
WiSE-FT は一行の式で書ける。微調整したら、半分戻ってみる。
ここではゼロショット CLIP と微調整後の CLIP が事前訓練重みを共有し、分類ヘッドも同じゼロショット分類器から始める。線上の実験で、中間に有用な領域があると確かめられた。自分のモデルでは微調整前の checkpoint を保存し、検証データでその線をたどろう。正則化係数をもう一巡推測するより、たいてい手軽だ。
半年後、同じ著者らはもう一歩進めた。捨てていた、ハイパーパラメータの異なる微調整モデルも、一緒に平均できるだろうか。その論文が Model Soups だ。