原論文
Tulu 3: Pushing Frontiers in Open Language Model Post-Training
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2411.15124
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformerstulu32024,
  title = {{Tulu 3: Pushing Frontiers in Open Language Model Post-Training}},
  author = {Nathan Lambert and Jacob Morrison and Valentina Pyatkin and Shengyi Huang and Hamish Ivison and Faeze Brahman and Lester James V. Miranda and Alisa Liu and Nouha Dziri and Shane Lyu and Yuling Gu and Saumya Malik and Victoria Graf and Jena D. Hwang and Jiangjiang Yang and Ronan Le Bras and Oyvind Tafjord and Chris Wilhelm and Luca Soldaini and Noah A. Smith and Yizhong Wang and Pradeep Dasigi and Hannaneh Hajishirzi},
  year = {2024},
  eprint = {2411.15124},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2411.15124}
}
事前訓練モデルの重みはますます公開されるようになったが、後訓練はたいてい霧の中だ。
Llama 3 の技術報告は SFT、拒否サンプリング、DPO を六ラウンド回したと書いているが、どんなデータを使い、どう選別したのかは外からは見えない。Tülu 3 の報告の脚注には、ある統計が載っている。2024 年 11 月時点で、LMSYS Chatbot Arena の上位 50 モデルのうち、後訓練データを公開したものは一つもなかった。
オープンソースコミュニティ独自の後訓練レシピ、たとえば Tülu 2 や Zephyr-β は、チャット系の評価ではまずまずだが、数学(MATH、GSM8K)と厳密な指示追従(IFEval)では明らかに遅れている。
アレン人工知能研究所(AI2)とワシントン大学の Lambert らは 2024 年 11 月に Tülu 3 を発表し、この空白を埋めようとした。Tülu はヒトコブラクダとフタコブラクダの交雑種で、著者らはこの名前を第三世代まで使い続けている。今回はモデルの重みに加えて、訓練データ、データ生成の流れ、訓練コード、評価ツール、途中の checkpoint までまとめて公開した。
このノートでは、SFT、DPO、そして著者らが新たに提案した RLVR という三段階のレシピに沿って進む。
問題の定義
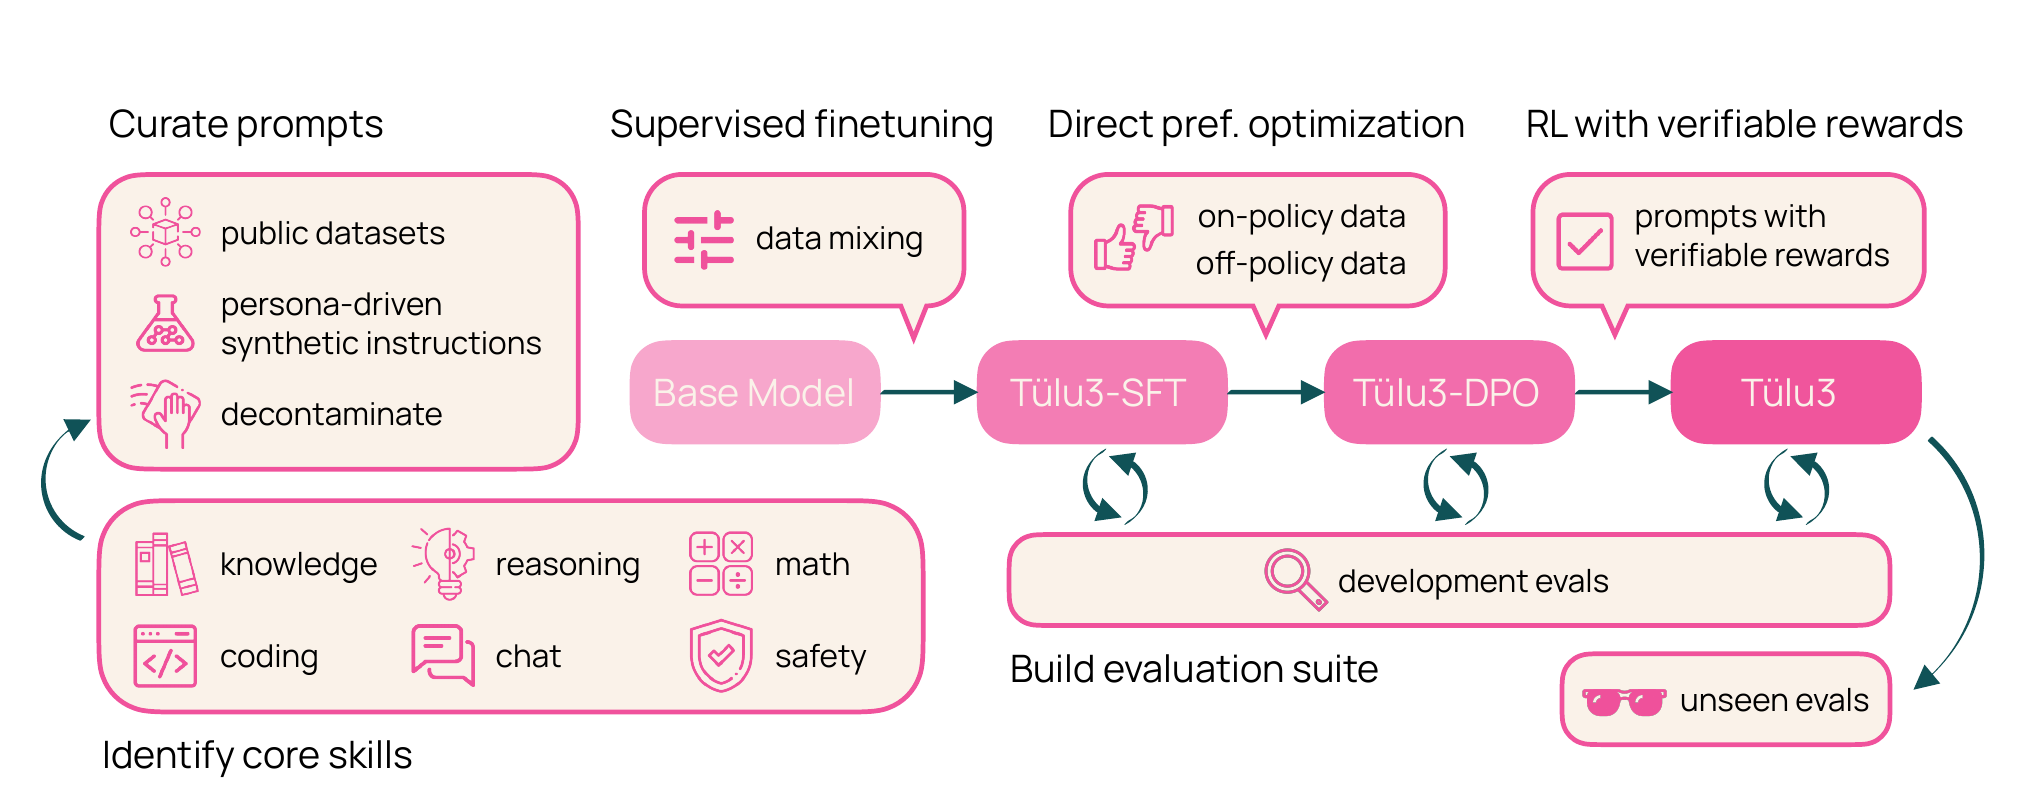
この図は左下から見る。著者らはまず、強化したい中核能力の一覧を定める。知識、推論、数学、コード、指示追従とチャット、安全性だ。各能力にいくつかの評価が対応する。
評価は二組に分かれる。開発セットは研究開発の全期間を通じて繰り返し使い、データ選びやハイパーパラメータ調整に用いる。未見セットは最後に一度だけ評価し、モデルが開発セットに過度に適合していないかを確かめる。たとえば知識の開発評価は MMLU、PopQA、TruthfulQA で、未見評価は MMLU-Pro と GPQA。指示追従の開発評価は IFEval と AlpacaEval 2 で、未見評価は IFEval-OOD と HREF だ。
ベースモデルは Llama 3.1 の 8B と 70B で、後に 405B も加えた。レシピ全体が答えようとするのは、公開済みまたは公開可能なデータだけで、Llama 3.1 Instruct と同等か、それ以上の後訓練モデルを作れるのかという問いだ。
問題を解く
データ:まず試験問題を洗い出す
プロンプトの出所は二種類ある。一つは既存の公開データセットで、たとえば WildChat の実ユーザーの対話だ。もう一つは合成データだ。合成には面白い方法を使っている。まず大量の「ペルソナ」(persona)を用意し、GPT-4o にその人物になりきって問題を作らせ、問題の多様性を増やす。数学とコードでそれぞれ約 22 万件と 3.5 万件を合成した。
公開データセットの最大のリスクは、評価の問題が紛れ込んでいることだ。そのために著者らは汚染除去の流れを作った。
- プロンプトだけを照合する。訓練データの回答は生成し直されていることが多く、回答を照合しても意味がない。
- 8-gram で照合する。評価中の各 token について、それを含むいずれかの 8-gram がある訓練データにも現れれば、その token は一致したとみなす。ある評価問題で 50% を超える token が同じ一件の訓練データと一致すれば、両者は重複していると判定する。著者らは完全一致の文字列照合と埋め込みベクトルによる照合も試した。前者は厳しすぎ、後者は「言い換え」と「テーマが似ているだけ」を区別しにくい。8-gram なら「数字だけを変えた数学の問題」のようなケースを捉えられる。
- データセットごと残すかどうか。ある訓練データセットが、いずれかの評価と 2% を超える問題で重複していれば、汚染ありとみなす。未見セットと重複するものはデータセットごと削除する。開発セットと重複するものは、データセットごと削除しても性能に影響しなければ丸ごと削除し、影響するなら重複した問題だけを削除する。
この流れは実際に多くを捉えた。たとえばよく使われる数学データ NuminaMath-TIR は、11.3% の問題が MATH の評価と重複しており、削除したうえで再公開された。
SFT:データ配合と、損失関数の落とし穴
SFT の要は配合だ。著者らは Tülu 2 の配合から出発し、新しいデータを加えてはアブレーションを行うことを何度も繰り返し、さらに数回の汚染除去を経て、最終的な Tülu 3 SFT の配合を得た。汚染除去で開発セットのスコアはわずかに下がるが、これは想定内の代償だ。
訓練設定は 2 epoch、バッチ 128、最大 4,096 token。学習率は 8B が 、70B が 。8B は 32 枚の GPU で 6 時間、70B は 64 枚の GPU で 50 時間訓練した。
この節には、モデルマージにも実装にも関わる発見が二つある。
Model Soups は最良の単一モデルに勝てなかった。 著者らは異なる乱数シードで複数の SFT モデルを訓練し、MergeKit で線形平均した。8B の五つのシードは平均スコアが 59.8 から 60.1 の間で、最良の soup(二つのシードの平均)は 60.2。70B の三つのシードは 71.8、70.0、72.6 で、最良の soup は 72.5 だった。シード間の差は小さくなく、70B では 2.6 ポイント開いたが、soup が最良のシードを安定して上回ることはなかった。著者らは最終的に、最良の単一 SFT モデルをそのまま使った。
これは画像分類での Model Soups の結論とも、Llama 3 や Gemma 2 が平均を正式な工程に組み込んだやり方とも異なる。考えられる理由は、ここでは異なるシードを平均しただけで、異なるデータやハイパーパラメータを平均しておらず、モデル間の差が小さすぎたことだ。ただし論文はそれ以上分析していない。
損失の平均の取り方が、ひそかに重み付けを変える。 訓練の初期、著者らは同じデータでも、自分たちのフレームワークと TPU とで訓練したモデルの性能が違うことに気づいた。突き詰めると、Transformers ライブラリが勾配累積のときに損失を計算する方法に問題があった。
例で一度計算してみよう。一つのバッチに二件のデータがあり、一件目は有効 token が 10 個で総損失 20、二件目は有効 token が 90 個で総損失 90 とする。
- 二件を一緒に順伝播に送ると、ライブラリは有効 token 全体で平均し、 になる。各 token の重みが等しい。
- 勾配累積で二回に分けて送ると、毎回それぞれ平均してからさらに平均を取り、 になる。各サンプルの重みが等しく、短いサンプルの token は 9 倍に拡大される。
勾配累積のステップ数を変えただけで、訓練の目標まで変わってしまう。著者らの解決策は、token 数で割らない合計の損失に切り替え、学習率を調整し直すことだった。これは各 token の重みを等しくすることに相当し、実験でも成績がよかった。この問題は 2024 年秋にコミュニティで広く議論され、論文は Unsloth などの説明を引用している。
選好微調整:on-policy データと長さ正規化 DPO
選好データの生成は、UltraFeedback の流れを改良したものだ。
- プロンプトを選ぶ。SFT で使ったもの、同じ出所だが SFT では使っていないもの、新しいプロンプトを含む。
- 22 モデルからなるモデルプールから無作為に四つを選び、それぞれに回答させる。これが off-policy データだ。さらに Tülu 3 SFT モデル自身の回答も加える。これが on-policy データで、選好データを、訓練中のモデルが実際に出しそうな出力に近づける。
- GPT-4o に、有用性、指示追従、真実性、誠実さの四つの観点からそれぞれ 1~5 点を付けさせる。平均点が最も高い回答を「選択」とし、それより点の低い回答から一つを無作為に選んで「非選択」とする。
アブレーションの段階では、8B に 96,911 件の off-policy データと 19,444 件の on-policy データを使った。最終的な選好データは 27 万件を超える。著者らは、選好データに含まれる重複しないプロンプトの数が多いほど性能がよく、同じプロンプトを単に使い回しても効果は限られることも見つけた。
アルゴリズムでは DPO、SimPO、PPO などを比較し、最終的に長さ正規化 DPO を選んだ。
元の DPO との違いは、二つの対数確率比をそれぞれ回答の長さ 、 で割る点だけだ。人間もモデルの評価者も長い回答を好むので、正規化しないと、モデルは「長く書けばよい」と簡単に学んでしまう。著者らがこれを選んだのは、PPO よりシンプルで速く、データ配合を何度も調整しやすいからでもある。
RLVR:正解したときだけ得点
第三段階は、著者らが提案した RLVR(Reinforcement Learning with Verifiable Rewards、検証可能な報酬による強化学習)だ。
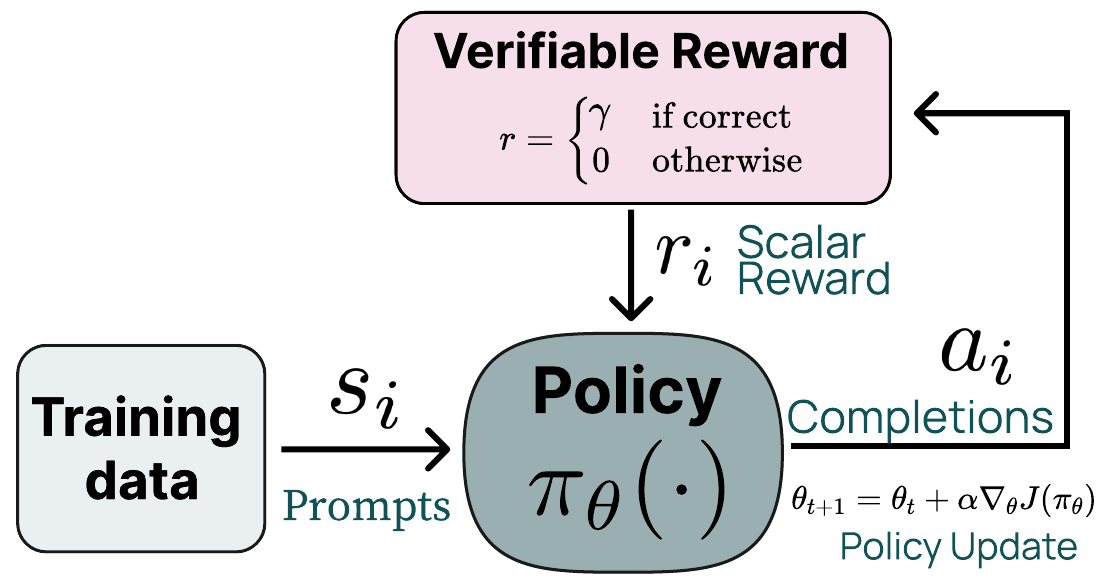
通常の RLHF は報酬モデルで採点する。RLVR は報酬モデルを、決定的なチェック関数に置き換える。
本文中の報酬は 、図では と書かれているが、同じ値を指す。著者らは予備実験に基づいて 10 に設定し、それ以上は調整しなかった。
チェック関数は、検証しやすい三種類のタスクにだけ使う。GSM8K と MATH の訓練セットでは、最後の答えを抜き出して正解と照合する。さらに Tülu 2 の SFT データから指示を取り出し、IFEval 式の書式制約(たとえば「回答は 100 語以内」)を加えて、守られているかをプログラムで確認する。プロンプトは合計約 3 万個だ。
最適化には PPO を使い、著者らは PPO を安定させる実装上の細部もいくつか挙げている。価値モデルを通常の報酬モデルから初期化する、訓練時に dropout を切る、回答が正常に終わらなければ 10 点減点する、アドバンテージを標準化する、といったものだ。基盤の面では、回答の生成は専用の GPU で vLLM を動かし、訓練は別の GPU 群で行う。両者は非同期に進み、方策は常に二番目に新しい生成データで訓練される。効率と再現性のバランスを取った設計だ。
議論
RLVR でどれだけ伸びるか
最良の DPO モデルから RLVR を行った結果を、論文の Table 23 から示す。
| 8B DPO | 8B RLVR | 70B DPO | 70B RLVR | |
|---|---|---|---|---|
| 平均 | 64.4 | 64.8 | 75.9 | 76.0 |
| MATH | 42.0 | 43.7 | 62.3 | 63.0 |
| GSM8K | 84.3 | 87.6 | 93.5 | 93.5 |
| IFEval | 81.1 | 82.4 | 82.6 | 83.2 |
| 安全性 | 87.2 | 85.5 | 89.0 | 88.3 |
8B では三つの目標タスクすべてが伸び、GSM8K は 3.3 ポイント増えた。しかし安全性のスコアは 1.7 ポイント下がり、全体平均は 0.4 しか増えなかった。70B の伸びはさらに小さく、GSM8K はすでに飽和に近い。8B の一部の実験では GSM8K を 89.4、IFEval を 84.8 まで引き上げられたが、他の指標が悪化して全体平均はかえって下がった、と著者らは率直に述べている。
訓練曲線を見ると、RLVR は訓練セットでの正解率を確かに上げ続けるが、KL ダイバージェンスが大きいほど平均スコアは低くなりがちだ。つまり、モデルが出発点から遠ざかるほど、過剰最適化のリスクが高まる。
405B のやり方は少し違う。GSM8K は SFT と DPO の後ですでに飽和しており、IFEval のデータも初期実験ではあまり役立たなかったので、MATH の訓練セットだけを使った。わずか 25 ステップで MATH は 5 ポイント以上伸び、計算資源の制約で 75 ステップまでしか回せなかったが、曲線はまだ飽和していなかった。405B には 256 枚の GPU を使い、16 枚で vLLM の生成、240 枚で訓練を行った。一ラウンドあたり、生成に約 550 秒、重みの同期に約 25 秒、訓練に約 1,500 秒かかる。計算資源を節約するため、価値モデルには 8B だけを使った。
全体の成績
著者らがまとめた評価セットで、Tülu 3 8B の平均スコアは 65.1 だった。Llama 3.1 8B Instruct の 62.9 より高いが、Qwen 2.5 7B Instruct の 66.5 よりわずかに低い。Tülu 3 70B は 76.2 で、Llama 3.1 70B Instruct の 74.1、Qwen 2.5 72B Instruct の 72.8 より高く、GPT-4o mini の 69.6 と Claude 3.5 Haiku の 75.3 も上回る。405B 版は安全性を除いた平均が 80.0 で、DeepSeek-V3 は 79.0、GPT-4o は 80.5 と、同じ範囲に収まる。
これらの評価の多くは著者ら自身が選んだ開発セットで、研究開発の全期間を通じて繰り返し最適化してきた対象でもある点には注意したい。未見セットは、まさにこのリスクを相殺するために設計されている。
うまくいかなかった試み
著者らは「結果が出なかった試み」という一節を設けている。技術報告では珍しい。
- Online DPO:各ステップで現在の方策から二つの回答をサンプリングし、報酬モデルで選好を付けて更新する。数学では GSM8K がほとんど伸びず、MATH はむしろ後退した。
- 拒否サンプリング:Llama 3 が多用した方法だが、ここでは投じた計算量のわりに得られた改善は限られていた。評価モデルが十分に強くないとよい回答を選び出せないこと、そして元の回答も候補に入れたほうが、新しく生成した回答だけから選ぶよりずっと効果的なことを、著者らは観察した。
限界
訓練データは短い対話が中心で、平均 2.4 ターンしかなく、ほとんどのサンプルは 2,048 token 未満だ。長文脈と多ターン対話は、はっきりした穴になっている。選好データと一部の合成データは GPT-4o が生成または採点しており、「完全オープン」とはデータと流れがすべて公開されているという意味で、データそのものは依然としてクローズドなモデルに依存している。
結論
Tülu 3 の価値は、半分がモデル、半分があの完全なレシピにある。汚染除去のしきい値、SFT の配合、損失の合計の仕方、選好データの作り方、PPO で気をつけるべき細部がすべてはっきり書かれ、失敗した試みまで説明されている。
RLVR 自体はとても素朴で、正解なら得点、不正解なら得点なしだ。数学と書式の遵守で、安定しているが大きくはない改善をもたらす。数か月後、DeepSeek-R1 はルールで判定する報酬で推論能力をさらに押し上げ、「検証可能な報酬」は強化学習による後訓練でよく使われるやり方になった。
この報告から一つだけ持ち帰るなら、自分の訓練コードが勾配累積のとき損失をどう平均しているか、もう一度確かめておこう。