原論文
Kimi k1.5: Scaling Reinforcement Learning with LLMs
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2501.12599
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformerskimik152025,
  title = {{Kimi k1.5: Scaling Reinforcement Learning with LLMs}},
  author = {Kimi Team and Angang Du and Bofei Gao and Bowei Xing and Changjiu Jiang and Cheng Chen and Cheng Li and Chenjun Xiao and Chenzhuang Du and Chonghua Liao and Chuning Tang and Congcong Wang and Dehao Zhang and Enming Yuan and Enzhe Lu and Fengxiang Tang and Flood Sung and Guangda Wei and Guokun Lai and Haiqing Guo and Han Zhu and Hao Ding and Hao Hu and Hao Yang and Hao Zhang and Haotian Yao and Haotian Zhao and Haoyu Lu and Haoze Li and Haozhen Yu and Hongcheng Gao and Huabin Zheng and Huan Yuan and Jia Chen and Jianhang Guo and Jianlin Su and Jianzhou Wang and Jie Zhao and Jin Zhang and Jingyuan Liu and Junjie Yan and Junyan Wu and Lidong Shi and Ling Ye and Longhui Yu and Mengnan Dong and Neo Zhang and Ningchen Ma and Qiwei Pan and Qucheng Gong and Shaowei Liu and Shengling Ma and Shupeng Wei and Sihan Cao and Siying Huang and Tao Jiang and Weihao Gao and Weimin Xiong and Weiran He and Weixiao Huang and Weixin Xu and Wenhao Wu and Wenyang He and Xianghui Wei and Xianqing Jia and Xingzhe Wu and Xinran Xu and Xinxing Zu and Xinyu Zhou and Xuehai Pan and Y. Charles and Yang Li and Yangyang Hu and Yangyang Liu and Yanru Chen and Yejie Wang and Yibo Liu and Yidao Qin and Yifeng Liu and Ying Yang and Yiping Bao and Yulun Du and Yuxin Wu and Yuzhi Wang and Zaida Zhou and Zhaoji Wang and Zhaowei Li and Zhen Zhu and Zheng Zhang and Zhexu Wang and Zhilin Yang and Zhiqi Huang and Zihao Huang and Ziyao Xu and Zonghan Yang and Zongyu Lin},
  year = {2025},
  eprint = {2501.12599},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2501.12599}
}
2025 年 1 月 20 日、DeepSeek が R1 を公開し、その約一時間後に月之暗面(Moonshot AI)も Kimi k1.5 を公開した。
二つのモデルがやろうとしたことはよく似ている。2024 年 9 月に OpenAI が o1 を発表してから、「答える前に長く考えさせる」と数学とコードの性能が大きく上がることは誰もが知っていたが、OpenAI はやり方を明かさなかった。二つの報告はどちらもその答えを示し、しかも答えは似ていた。強化学習でモデルに長い思考過程を書かせればよく、モンテカルロ木探索も、価値関数も、ステップごとに採点するプロセス報酬モデルも要らない。
違うのは、R1 が重みを公開したのに対し、k1.5 は公開せず、Kimi の製品と API を通じてしか使えないことだ。この報告はモデルのパラメータ数も明かしていない。だから k1.5 を読むときの焦点は、モデルそのものではなく訓練方法にある。その中には R1 の報告にない話が二つある。強化学習のコンテキスト長を 128K まで広げたこと、そして長い思考の能力を短く答えるモデルへ戻す方法に一節を丸ごと割いたことで、その方法の一つがモデルマージだ。
問題の定義
事前訓練のスケーリングは、高品質データの総量に縛られる。著者らは、拡大を続けられる別の道を探した。固定のデータセットを学ぶだけでなく、報酬を通じてモデルに自分で探索させる道だ。
問題設定はとても単純だ。問題 と正解 が与えられると、モデルはまず思考過程 を書き、それから答え を出す。報酬 は 0 か 1 だけだ。コードの問題はテストを通るかどうか、数学の問題は答えが合っているかどうかで決まる。
著者らは「長い思考」について面白い見方をしている。従来の推論時探索、たとえば木探索には、どの道が有望かを判断する評価器が必要で、その判断をもとにどのノードを展開するかを決める。しかし探索過程のすべての試行、評価、後戻りを一本の長い文章として書けば、長く書けるモデルは自分のコンテキストの中で暗黙的に探索できる。
この見方によって、問題は二つに置き換わる。コンテキストをどこまで伸ばせるか、そして強化学習がモデルにその長さをうまく使うことを教えられるかだ。
問題を解く
まず問題をうまく選ぶ
著者らは、強化学習の成否が問題集合に大きく左右されることに気づいた。よい問題集合は、多様な領域をカバーし、難易度が均等に分布し、しかも答えを正確に検証できなければならない。
難易度の推定にはモデル自身を使う。SFT モデルに高めのサンプリング温度で各問題に 10 回答えさせ、通過率が低いほど難しい問題とみなす。これで簡単すぎる問題もついでに除ける。
検証では「当てずっぽうの正解」を防ぐ。推論問題には答えを当てやすいものがあり、モデルが誤った推論で正しい答えにたどり着けば、報酬がだまされてしまう。著者らは選択問題、正誤問題、証明問題を除外した。一般の問答問題では、まずモデルに考えさせずに 8 回直接当てさせ、一度でも当たれば当てやすすぎる問題と判定して削除する。
長い思考のウォームアップ
本格的な強化学習の前に、著者らはまずプロンプトエンジニアリングで高品質な長い思考の例を少量生成した。計画、途中ステップの評価、振り返りと修正、別解の試行といった振る舞いを意図的に含めたうえで、軽い SFT を一回行う。狙いは、まずモデルにこの書き方を身につけさせ、それを強化学習で増幅することだ。
方策最適化:オンラインミラー降下
著者らが使うのは、オンラインミラー降下(online mirror descent)の変種だ。第 ラウンドでは現在のモデル を参照として、KL 正則化付きの問題を解く。
この問題には閉形式解 がある。両辺の対数を取ると、どのサンプルでも成り立つべき等式が得られ、著者らはそれを二乗誤差の代理損失として書き直す。
は、同じ問題で 個の回答をサンプリングしたときの平均報酬 で近似する。この損失の勾配を取ると、第一項は平均報酬を基準とする方策勾配、第二項は 正則化項になる。
平たく言えば、同じ問題で 個の回答をサンプリングし、正解したもの(報酬が平均より高いもの)の確率を上げ、不正解のものの確率を下げ、同時に前のラウンドのモデルから離れすぎないようにする。各ラウンドが終わると、参照モデルを新しいモデルに置き換え、オプティマイザの状態もリセットする。
この方法には価値ネットワークがない。著者らの理由づけは示唆に富む。モデルが途中まで書いたところで、次の一歩として正解に直行する道も、間違える道も選べるとしよう。従来の価値関数は後者を罰する。しかしモデルが間違えた後でそれに気づいて修正し、最終的に正解できるなら、この「間違えてから直す」経験こそ、長い思考を学ぶのに最も必要なものだ。だから著者らは最終的な答えだけを見て、途中のステップには信用割当を行わない。
長さペナルティ
強化学習を進めると、回答はどんどん長くなる。性能は確かに上がるが、推論コストも上がり続ける。そこで著者らは長さ報酬を加えた。
同じ問題の 個の回答のうち、最短と最長の長さをそれぞれ min_len と max_len とすると、 番目の回答の長さ報酬は次のとおりだ。
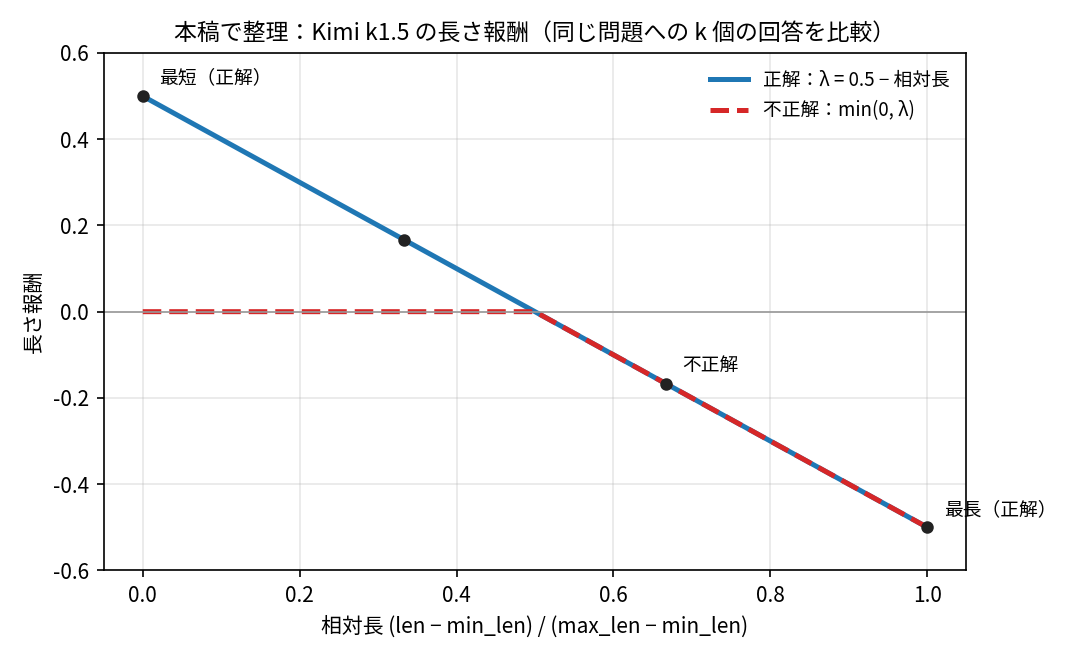
例で一度計算してみよう。同じ問題で四つの回答をサンプリングし、長さはそれぞれ 1,000、2,000、3,000、4,000 token、三つ目が不正解とする。
def length_reward(lengths, correct):
    lo, hi = min(lengths), max(lengths)
    if hi == lo:
        return [0.0] * len(lengths)
    out = []
    for n, ok in zip(lengths, correct):
        lam = 0.5 - (n - lo) / (hi - lo)
        out.append(lam if ok else min(0.0, lam))
    return out

lengths = [1000, 2000, 3000, 4000]
correct = [True, True, False, True]
for n, ok, r in zip(lengths, correct, length_reward(lengths, correct)):
    print(f"長さ {n:>5}  {'正解' if ok else '不正解'}  長さ報酬 {r:+.3f}")
長さ  1000  正解  長さ報酬 +0.500
長さ  2000  正解  長さ報酬 +0.167
長さ  3000  不正解  長さ報酬 -0.167
長さ  4000  正解  長さ報酬 -0.500
正解した回答の中では、短いほどよい。不正解の回答は短くても報酬を得られないが、長すぎればやはり減点される。最長の正解回答に注目すると、長さ報酬は −0.5 で、不正解の回答よりも低い。これで問題はない。長さ報酬はある重みを付けて元の 0 か 1 の正誤報酬に足されるので、正解の 1 点が依然として支配的だからだ。
著者らは、長さペナルティが訓練初期の進歩を遅らせることにも気づいた。そこで最初は加えず、しばらく訓練してから固定で加える。
サンプリング戦略と報酬モデル
問題のサンプリングには二つの戦略がある。カリキュラムサンプリングは易しい問題から難しい問題へと進む。最初はモデルが弱すぎて、難しい問題に計算資源を使っても正解のサンプルがほとんど得られないからだ。優先サンプリングは各問題の成功率 を記録し、 に比例して問題を抽出して、モデルが最も弱いところを集中的に練習させる。
コード問題のウェブデータにはテストケースがないことが多いので、著者らはモデルとテスト生成ライブラリ CYaRon を組み合わせて自動生成した。各問題でまず 50 個のテストケースを生成し、10 個の正しい解答で検証して、少なくとも 7 個の結果が一致したケースだけを残す。問題全体としては、9 個以上の解答が残ったケースをすべて通過した場合にだけ訓練セットに入れる。オンラインコンテストの 1,000 問のうち、最終的に採用されたのは 323 問だけだった。
数学問題の難しさは、同じ答えに多くの書き方があることだ。たとえば と だ。著者らは二種類の報酬モデルを比較した。スコアを出力する通常の報酬モデルは、人手による抜き取り検査で正解率が約 84.4%。先に推論過程を書いてから正誤を判断する CoT 報酬モデルは約 98.5% だった。強化学習には後者を使う。
128K の長文脈と部分ロールアウト
強化学習でモデルに 128K token まで書かせると、とりわけ長い一本の回答がサンプリング資源を占有し、バッチ全体の訓練を遅らせる。これが最大の工学的な問題だった。
著者らの解決策は部分ロールアウト(partial rollouts)と呼ばれる。サンプリングのたびに出力長の上限を固定し、書き終わらなかった回答はいったんリプレイバッファに保存して、次のラウンドで続きを書く。現在の部分だけを現在の方策で計算し、それより前の部分はバッファからそのまま取り出す。サンプリングのワーカーは非同期に動き、長い回答を処理しているものがある一方で、他は同時に短い回答を処理するので、資源が遊ばない。このシステムは繰り返しの内容も検出でき、早めに打ち切ってペナルティを与える。
議論
長い思考の成績
長い思考版の k1.5 は、OpenAI o1 と同等の成績だった。AIME 2024 は 77.5(o1 は 74.4)、MATH-500 は 96.2(o1 は 94.8)、Codeforces は 94 パーセンタイル(o1 と同じ)、LiveCodeBench は 62.5(o1 は 67.2)。視覚では、MathVista が 74.9、MMMU が 70.0 だった。
著者らは中規模のモデルで、スケーラビリティも観察した。訓練が進むにつれて回答の長さと正解率がともに上がり、難しい評価ほど長さの伸びが急だった。
別のアブレーションでは、モデルサイズと長い思考を比べた。同じデータで大小二つのモデルを訓練すると、大きいモデルは最初から性能がよいが、小さいモデルもより長く考えることで最終的に追いつける。ただし token 効率は大きいモデルのほうが高い。最高の性能を目指すなら、大きいモデルのコンテキストを広げるほうが上限は高い。推論の予算が限られるなら、小さいモデルに少し長く書かせるよう訓練するのも現実的な選択だ。
さらに二つのアブレーションがある。最良の回答だけを学び、誤った回答を罰しない ReST と比べると、著者らの方法はサンプル効率が明らかによく、長い思考の訓練では負の勾配が重要だとわかる。カリキュラムサンプリングも、一様サンプリングより明らかに優れていた。
長い話を短く
長い思考は強力だが、高くつく。著者らは 2.4 節で、長い思考の能力を短く答えるモデルへ移す四つの方法を比べた。
- モデルマージ:長い思考のモデルと短く答えるモデルの重みをそのまま平均する。訓練は一切要らない。
- 最短の拒否サンプリング:同じ問題で 8 回サンプリングし、最も短い正解回答を選んで SFT に使う。
- DPO:最も短い正解回答を正例とし、誤った長い回答と、正例の 1.5 倍を超える長さの正解回答を負例とする。
- long2short 強化学習:性能と長さのバランスが最もよいモデルを選び、長さペナルティを加え、サンプリング長の上限を大幅に縮めて、強化学習をもう一巡行う。
結果は、四つ目の token 効率が最も高かった。短く答える版の k1.5 は、AIME 2024 で平均わずか 3,272 token を使って 60.8 点を取った。GPT-4o は 9.3、Claude 3.5 Sonnet は 16.0 だ。MATH-500 では、最も短い版が、他の短く答えるモデルと同程度の token 数で 88.2 点を取った。
ここでのモデルマージは、有効だが最良ではない方法だ。利点はまったく訓練が要らないことだ。一方、訓練を伴う方法のほうが長さを精密に制御できる。この結論は後の Assembly of Experts にも引用され、推論を短くするうえでのマージの限界を示すのに使われた。
この報告を読むときの注意点
モデルはオープンソース化されておらず、パラメータ数も事前訓練の規模も公開されていないので、報告の数字を第三者は検証できない。long2short の比較は token 効率を図で示すだけで、各方法の具体的な数値はほとんど載っていない。アブレーションの多くは、より小さいモデルで行われている。
結論
Kimi k1.5 と DeepSeek-R1 は、同じ日に似た答えを出した。結果が正しいかどうかだけの報酬でも、十分に長いコンテキストと組み合わせれば、モデルは長い思考を学べる。木探索も、価値関数も、プロセス報酬も要らない。
k1.5 自身の貢献は、この道の工学的な細部を具体的に書いたことにある。問題の選び方、当てずっぽうの防ぎ方、128K の長さで効率よくサンプリングする方法、長さ報酬で考えすぎを抑える方法、そして長い思考を短い回答へ押し戻す方法だ。
長い思考のモデルで製品を作りたいなら、そのモデルが元の短く答えるモデルと同じベースから来ている限り、まず両者を平均してみるとよい。訓練は要らず、重みの演算一回で済む。それで足りなければ、long2short の強化学習を一巡回すことを考えればいい。