原論文
What Matters for Model Merging at Scale?
- arXiv への初回投稿
- arXiv:2410.03617
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingmergingatscale2024,
  title = {{What Matters for Model Merging at Scale?}},
  author = {Prateek Yadav and Tu Vu and Jonathan Lai and Alexandra Chronopoulou and Manaal Faruqui and Mohit Bansal and Tsendsuren Munkhdalai},
  year = {2024},
  eprint = {2410.03617},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2410.03617}
}
初期のマージ研究は CLIP、ViT、T5、BERT が中心で、一部はさらに大きな画像・言語モデルを扱い、DARE も 7B、13B の専門モデルをマージしていた。しかし基底の品質、規模、専門モデル数、手法を同じ実験で個別に比較する例は少ない。小規模で有効な工夫は、大規模でも重要なのだろうか。
2024 年にはマージが大モデルの訓練工程に登場し、論文も Llama 3 と Gemma 2 の技術報告を挙げる。小モデルの結論は、拡大後も成り立つのか。
TIES-Merging の第一著者で UNC の Prateek Yadav は Google のインターン中に、Google、Virginia Tech の Tu Vu、Jonathan Lai、Alexandra Chronopoulou、Manaal Faruqui、Tsendsuren Munkhdalai、UNC の Mohit Bansal と、PaLM-2 を最大 640 億パラメータまで体系的に調べた。
問題の定義
四つの問いを立てる。
- 純粋な事前訓練モデルと指示微調整モデルのどちらから専門モデルを作ると、マージしやすいか。
- 大きいほど、マージは容易になるか難しくなるか。
- 未知のタスクのゼロショット能力へ、どう影響するか。
- 大きな低下なしに何個をマージでき、規模とどう関わるか。
問題を解く
実験設計
新手法ではなく、実験設計に重点を置く。
基底モデル:PaLM-2 と指示微調整版 PaLM-2-IT の各 1B、8B、24B、64B。
専門モデル:T0 から八タスク群を held-in とし、群ごとに全パラメータ微調整する。訓練に使わない held-out タスクを別に残し、ゼロショット汎化を測る。
マージ:2、4、6、8 個を混ぜる。各設定で三つの乱数シードにより対象を選び、結果を平均する。
手法:追加情報不要で数百億パラメータへ拡張できる単純平均、タスク算術、TIES-Merging、DARE+TIES(論文では Dare-TIES)の四つ。Fisher 行列、逆伝播、活性値を要する方法は含めない。
比較基準:各タスクの専門モデルと、八群の混合データによるマルチタスクモデル。
展開すると専門モデルは 個。マージは 設定で、基準を含め約九千回のモデル評価になる。三シードはどの専門モデルをマージするかの抽出用で、各専門モデルを三度訓練するものではない。同じ部分集合シードを規模、基底、手法に共用し、特定手法だけが容易なタスクを引くことを避ける。
専門モデルは何ができるか
held-in は八群に各二つ、計 16 データセット。多肢選択質問応答、抽出型質問応答、外部資料を参照しない質問応答(closed-book QA)、感情分析、トピック分類、構造からのテキスト生成、要約、言い換え判定を含む。要約は CNN/DailyMail と XSum、言い換えは MRPC と QQP だ。「質問応答+要約」だけを混ぜるなら、held-in はその二群四データだけを測る。
held-out は四群七データで、文補完の COPA と HellaSwag、推論の ANLI と RTE、共参照の WSC と Winogrande、語義の WiC。全マージモデルで同じ集合を評価し、専門タスクを学んだ後の転移を見る。
PaLM-2-IT は、T0 mixture のタスクを除いた FLAN-v2 で最大 60,000 ステップ指示微調整し、そこから各専門モデルを全パラメータ訓練する。標準は 2,000 ステップ、学習率 、dropout 0.05 で、一部は収束に応じて長さを調整する。この IT は本研究の比較用に作った版だ。専門モデルのデータが比較的少ないことも、規模効果を読む条件になる。
スコアの読み方
すべて正規化する。held-in は各タスクの専門モデルのスコアで割り、1 は同等。held-out は基底のスコアで割り、1 は微調整前の基底と同等だ。1 超なら未知のタスクで改善している。
専門モデルが 80 点、マージが 72 点なら held-in は 0.9。保留タスクで基底が 40 点、マージが 44 点なら held-out は 1.1 で、相対改善は 10%、元の得点増は 4 点になる。要約など異なる指標が混在するため、正規化値 0.1 を一律に精度 10 ポイント増へ換算できない。
まず群内のデータセットの正規化スコアを平均し、次に群、三つの部分集合シードを平均する。各群が同じ重みになる。全データを直接平均すると、一つしかない WiC の群が軽くなってしまう。
議論
指示微調整済みの基底から始める
手法、規模、専門モデル数を問わず、すべての設定で PaLM-2-IT 由来のほうが held-in はよい。混ぜる数が多いほど差は広がる。
著者らは Ortiz-Jimenez らに沿って、大規模な指示微調整で重みがより「分離」され、異なるタスクの変更が干渉しにくくなる可能性を挙げる。手元で最良の基底から専門モデルを作り、基底の品質はゼロショット能力で判断することを勧めている。
大きいほどマージしやすい
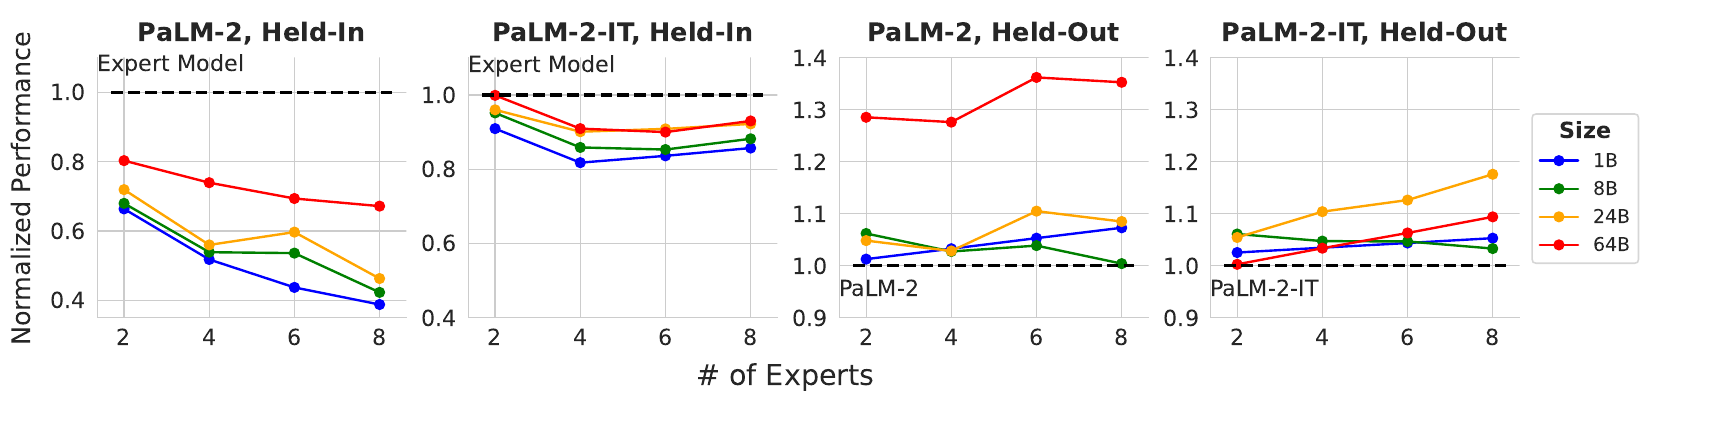
左の held-in は青の 1B から赤の 64B へ、おおむね大きいほど高い。大きな指示微調整モデルが最も混ぜやすく、64B の PaLM-2-IT はほぼ各専門モデルに並ぶ。
第四の問いにも答える。付録のタスク算術では、8B の PaLM-2 で 2 個から 8 個へ増やすと held-in は 0.68 から 0.42、8B の PaLM-2-IT は 0.95 から 0.88 になる。64B の PaLM-2-IT は 1.00 と 0.93。規模と基底品質が損失を減らすが、8 個を混ぜると保持性能の平均は約 7% 減る。
マージで未知のタスクも改善する
右の held-out は大半が 1 を超え、未知のタスクで基底よりよい。
二基底の傾向は違う。PaLM-2 は専門モデル数の影響が小さいが、64B は基底より約 30% よい。著者らは元のゼロショット能力が弱く、改善余地が大きいと考える。PaLM-2-IT は多いほどよく、特に 24B と 64B で明確だ。専門モデルのノイズが混合時に打ち消し合うと推測する。
64B の PaLM-2-IT で 8 個をタスク算術で混ぜると held-out は 1.09、マルチタスクは 1.05。一方 held-in は 0.93 で、マルチタスクの 0.99 より低い。未知タスクの平均汎化がよい代わりに、既習能力には取捨がある。24B の八個のタスク算術は held-out が 1.18 でマルチタスクの 1.18 と同じだ。この二例は分けて読む。
手法の重要性が薄れる
64B の PaLM-2-IT では、何個マージしても四手法の held-in、held-out はほぼ同じになる。
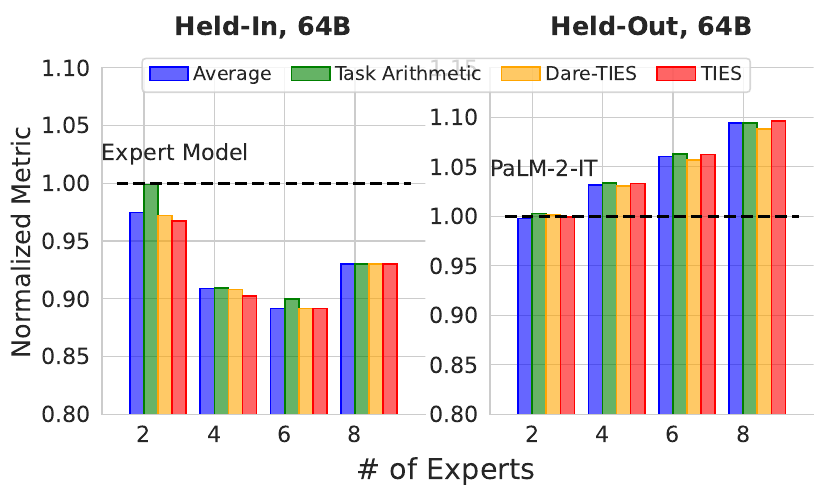
横軸は 2、4、6、8 個で、各群の四本の棒を比べる。左の基準線は専門モデル、右は IT 基底。同じ 1 でも分母が違う。左は専門モデルより少し低く、右は数とともに基底を超えるが、手法間の棒の差は小さい。
大モデルに対して専門訓練データが少ないと、専門モデルは強く過剰パラメータ化されるため、小モデルで有効な TIES の干渉処理や DARE のランダム疎化が重要でなくなる、と著者らは推測する。大きな指示微調整専門モデルには単純平均で足りる場合がある。
四手法を並べる
八個の IT 専門モデルをマージする同じ設定を、二規模で並べる。各値は上記の正規化による。
| 手法 | 24B held-in | 24B held-out | 64B held-in | 64B held-out |
|---|---|---|---|---|
| 重み平均 | 0.77 | 1.16 | 0.93 | 1.09 |
| タスク算術 | 0.92 | 1.18 | 0.93 | 1.09 |
| DARE-TIES | 0.88 | 1.17 | 0.93 | 1.09 |
| TIES | 0.86 | 1.16 | 0.93 | 1.10 |
| マルチタスク訓練 | 0.98 | 1.18 | 0.99 | 1.05 |
原論文付録 C の PaLM-2-IT 結果より整理。すべて八専門モデル。
64B はほぼ一致するが、24B の held-in は 0.15 の差が残る。「大きいほど混ぜやすい」は基底、タスク、規模の組合せの話で、あるパラメータ数を超えると全手法が同じになる普遍的なしきい値はない。同じ 64B でも未 IT の PaLM-2 で八個を混ぜると、タスク算術は 0.67、TIES は 0.56 で差が戻る。
尺度も異なる。重み平均は 、タスク算術は で、後者は総変更量を調整できる。TIES のマス別平均と DARE のランダム疎化は各位置の更新をさらに変える。最終結果が近くても、途中の演算は異なる。
この実験から何を学ぶか
第一に、held-out の正規化改善は基底スコアに依存する。未 IT の 64B PaLM-2 はゼロショットが弱く、八個のタスク算術は 1.35 になるが、マルチタスクの 1.72 より低い。三割超の改善だけでなく、基底、マルチタスク、専門モデルを戻して比較したい。
第二に、規模傾向には例外がある。未 IT の 24B PaLM-2 の八個の単純平均は held-out 0.83、TIES は 0.90 で、いずれも基底より低い。全体では強い基底と大規模が混ぜやすいが、低下時はタスク別の詳細を見る必要がある。指示微調整による分離やノイズの相殺は説明仮説であり、その因果関係は未検証だ。
第三に、一つのモデル家族、最大八専門モデル、指定の T0 タスクと微調整予算の研究だ。異なる tokenizer、独立の事前訓練、長期訓練した数十の専門モデルは混ぜていない。製品全体の遅延、安全性、サービスコストも測っていない。範囲を超えるなら、この実験行列を参考に、基底品質と専門モデル数を制御してから配合を比べるのが有用だ。
結論
PaLM-2 を 640 億まで拡大した結果は一貫している。十分強く、できれば指示微調整した基底から専門モデルを作る。大きいほど多く混ぜやすく、ゼロショット汎化も通常改善し、大規模ではマルチタスク訓練を超える場合もある。手法の差は大きいほど目立たなくなる。
ただし、専門モデル自身のタスクでは通常まだ届かない。著者らは、マルチタスクモデルと比べれば、その損失はさほど深刻ではない可能性があると考える。
最後の一点は覚えておきたい。TIES-Merging の著者自身が調べ、64B では TIES と単純平均がほぼ同じだと見いだした。