原論文
TIES-Merging: Resolving Interference When Merging Models
- 発表先
- NeurIPS 2023国際会議
- arXiv への初回投稿
- arXiv:2306.01708
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingtiesmerging2023,
  title = {{TIES-Merging: Resolving Interference When Merging Models}},
  author = {Prateek Yadav and Derek Tam and Leshem Choshen and Colin Raffel and Mohit Bansal},
  year = {2023},
  eprint = {2306.01708},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2306.01708}
}
タスク算術は各微調整モデルをタスクベクトル で表し、足して係数を掛け、マルチタスクモデルを作る。二タスクではよく働くが、タスクが増えると、マージモデルと個々の専門モデルの差が広がる。
ノースカロライナ大学チャペルヒル校(UNC)の Prateek Yadav、Derek Tam、Colin Raffel、Mohit Bansal と、IBM Research・MIT の Leshem Choshen は、この損失がどこから来るのかを調べた。
答えは、ベクトルを足すとき、パラメータ同士がけんかをすることだった。
問題の定義
干渉を二種類に分ける。
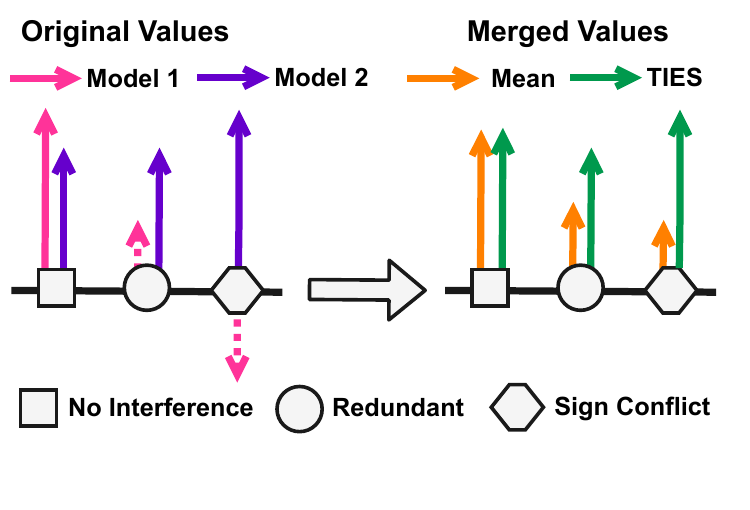
冗長なパラメータ(丸)。微調整でわずかにしか動かないパラメータは多く、その小さな変更はタスクにほとんど影響しない。しかし、あるパラメータが A には重要で B ではノイズなら、平均によって A の重要な変更が薄まり、短くなる。
符号の衝突(ひし形)。同じパラメータを A は大きく、B は小さくしたい。直接平均すると打ち消し合う。
どちらもマージ後の変更量が小さくなり、元の差がならされる。
著者らは両方の存在をデータで確認する。第一に、各タスクベクトルの絶対値上位 20% だけを残し、他をゼロにしても、十一タスクの平均性能は全保持とほぼ同じだった。変更の大半が冗長だとわかる。第二に、20% へ刈った後、二モデルのマージでは約 2% のパラメータで符号が衝突し、十一モデルでは約 30% に増える。
この十一タスクは T0-3B の (IA) 微調整だ。中間活性値をスケーリングする小さなベクトルだけを訓練し、本体は固定する。「20% を残す」の対象は、その微調整パラメータの変更量になる。全パラメータの T5 と CLIP は後で別途検証しており、この図だけであらゆる大モデルの変更を一律 80% 削れるとは判断できない。
問題を解く
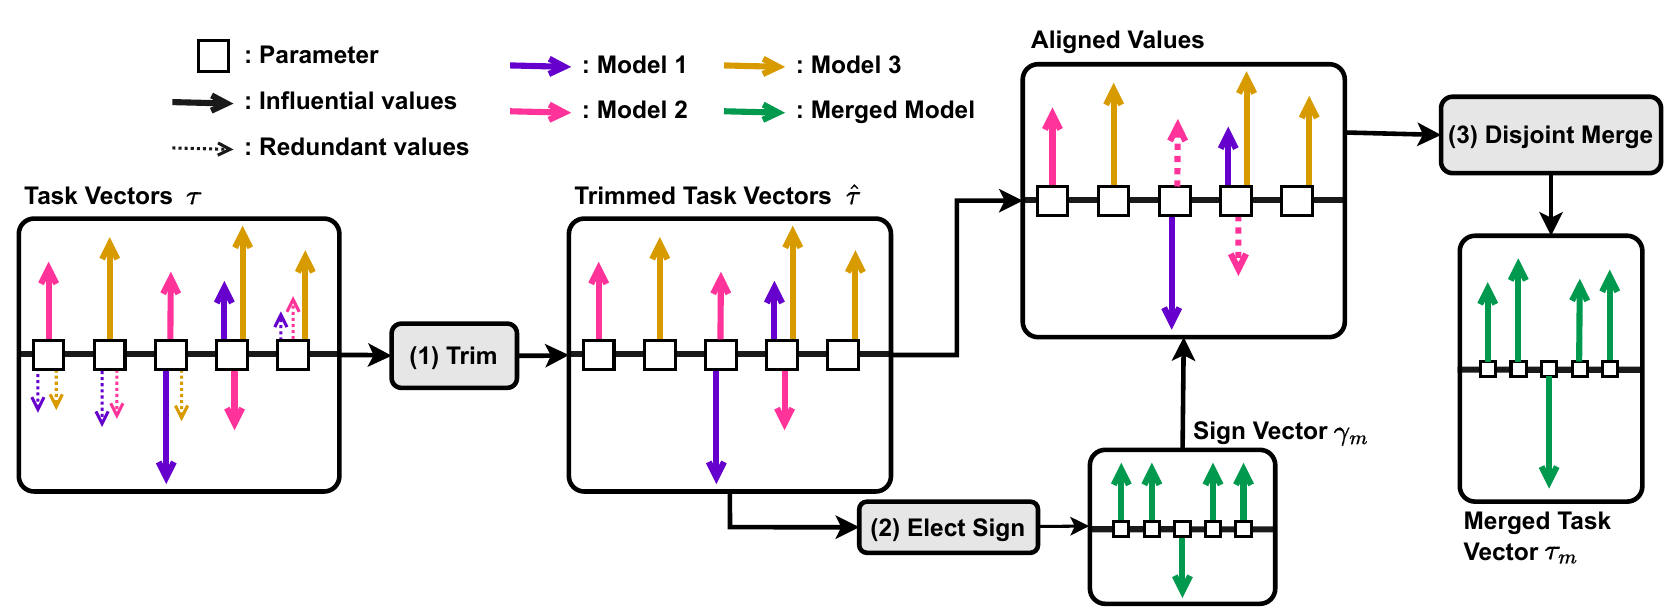
TIES の名は Trim、Elect Sign、Disjoint Merge の三段階から来る。まずタスクベクトルを符号 と大きさ に分け、 とする。
- 刈り込み(Trim):各ベクトルの絶対値上位 だけを残し、他を 0 にして を得る。
- 符号選出(Elect):各パラメータ の値を全タスクで足し、その総和の符号を最終方向にする。
正と負の「総量」を比較し、大きい側に従う操作だ。
- 同符号だけの平均(Disjoint Merge):選ばれた方向に一致する値だけを平均する。刈り込んで 0 になった値は数えない。
最後に係数を掛けて戻す。 だ。
Trim がゼロにするのは差分で、対応する微調整重みは初期値へ戻る。基底パラメータは残る。Disjoint Merge の分母は、そのマスに実際に残り、方向も一致するメンバー数だ。一タスクだけが を残し、他の十タスクがゼロなら、結果も 。十一で割ると、除きたかった希釈を戻してしまう。分母はマスごとに異なりうる。
手計算してみる
三タスク、六パラメータの例で、各タスクの絶対値上位半分を残す。数値は説明用に作っている。
import numpy as np

tau = np.array([[ 0.8, -0.1,  0.5,   0.02, -0.6, 0.3 ],   # 任務 A
                [-0.7,  0.4,  0.6,  -0.03,  0.1, 0.05],   # 任務 B
                [ 0.9, -0.2, -0.05,  0.01, -0.5, 0.4 ]])  # 任務 C

print("直接平均:", tau.mean(0).round(3))

# 1. Trim:每個任務只留絕對值最大的一半
k = tau.shape[1] // 2
cut = np.sort(np.abs(tau), axis=1)[:, -k][:, None]
trimmed = np.where(np.abs(tau) >= cut, tau, 0.0)
print(trimmed)

# 2. Elect:每個參數用剩下數值的總和投票,決定正負號
sign = np.sign(trimmed.sum(0))

# 3. Merge:只平均和投票結果同號的值
agree = (np.sign(trimmed) == sign) & (trimmed != 0)
ties = (trimmed * agree).sum(0) / np.maximum(agree.sum(0), 1)
print("TIES    :", ties.round(3))
直接平均: [ 0.333  0.033  0.35   0.    -0.333  0.25 ]
[[ 0.8  0.   0.5  0.  -0.6  0. ]
 [-0.7  0.4  0.6  0.   0.   0. ]
 [ 0.9  0.   0.   0.  -0.5  0.4]]
TIES    : [ 0.85  0.4   0.55  0.   -0.55  0.4 ]
0 番は符号の衝突だ。A、C は増加、B は減少を求め、直接平均は 0.333 になる。選ばれた符号は正なので、A と C だけを平均して 0.85 を得る。
1 番は冗長性だ。大きく変えたのは B だけで、A、C の −0.1、−0.2 は小さなノイズになる。直接平均は 0.033 に打ち消されるが、ノイズを刈れば B の 0.4 を保てる。
3 番は三タスクとも小数点以下の小さな変更だけなので、刈ってゼロにし、変更しない。
第 2 段階は人数の多数決ではなく、総和で決める。0 番は二つが正、一つが負なので人数でも正だが、+0.9 が一つと −0.1 が二つでも総和は正になる。大きな変更が方向を決める。
全値を刈ったマスは 0 のままにする。この例では正負の総量がちょうど相殺するマスも 0 にし、空集合による除算を避ける。しきい値で top-k を選ぶと、同じ大きさの値がまとめて残ることもあり、境界の同値をどう扱うか決める必要がある。こうした分岐は少数でも、二つの実装が同じ重みを再現できるかに影響する。
TIES の とタスク算術の は、そのまま共用できない。前者はマスごとに平均し、後者はベクトルを加算する。刈り込みと符号選別を除いても、 タスクの総和は平均の 倍だ。固定配合の TIES の 1 と、タスク算術の 0.4 は、それぞれの推奨設定であり、同じ尺度の対照実験ではない。
議論
実験設定
三つの設定で調べる。
- パラメータ効率のよい微調整:T0-3B に (IA) を使い、文補完、自然言語推論、共参照解決、語義曖昧性解消など十一タスクを微調整する。
- 言語モデルの全パラメータ微調整:T5-base、T5-large の七タスク。
- 画像モデルの全パラメータ微調整:CLIP ViT-B/32、ViT-L/14 の八画像分類タスク。
単純平均、Fisher Merging、RegMean、タスク算術と比較する。
Fisher と RegMean はデータ由来の統計量も使い、それぞれパラメータ重要度と線形層入力の内積を推定する。TIES のマージ三段階は重みだけを読む。ただし と を選ぶなら評価データが必要なので、論文は検証集合あり・なしを分けている。
主な結果
検証集合で TIES の と 、タスク算術の などを調整できる場合は、
| 手法 | (IA) | T5-base | T5-large | ViT-B/32 | ViT-L/14 |
|---|---|---|---|---|---|
| 個別微調整の専門モデル | 71.4 | 82.8 | 88.8 | 90.5 | 94.2 |
| マルチタスク共同訓練 | 73.1 | 83.6 | 88.1 | 88.9 | 93.5 |
| Fisher Merging | 62.2 | 68.9 | 64.6 | 68.3 | 82.2 |
| RegMean | 58.0 | 71.2 | 73.2 | 71.8 | 83.7 |
| タスク算術 | 63.9 | 73.2 | 73.3 | 70.1 | 84.5 |
| TIES-Merging | 66.4 | 73.9 | 76.9 | 73.6 | 86.0 |
タスクの平均性能。原論文 Table 1 より整理。
TIES は五設定すべてでマージ法の最良となり、次点より 0.7~3.6 ポイント高い。ただし上の二行との差は大きい。ViT-B/32 の専門モデル平均は 90.5、TIES は 73.6 だ。
検証集合なしの固定配合 、 も試す。パラメータ効率のよい設定で選び、全パラメータ微調整へ適用したものだ。タスク算術の推奨 と比べ、ViT-B/32 は 72.4 対 60.4、ViT-L/14 は 86.0 対 83.3、T5-large は 74.4 対 73.5。一方 T5-base は 69.7 対 73.2 で、TIES が負ける。
タスク数も重要だ。2 個から増やすほど、TIES のタスク算術に対する差が広がる。モデルが多いほど符号衝突が増えるという観察に合う。
この解析は T5-large の七タスクで、タスク数ごとに最大十部分集合を抽出する。各タスクのスコアを専門モデルで割り、今回マージしたタスク上で平均する。二タスクでは両法とも 1 に近く、増やすと両方下がるが TIES は緩やかだ。常に全八タスクで測る Task Arithmetic の図とは平均対象が異なり、曲線の向きも異なる。
未知のタスクでは?
七タスクをマージした T5 を、微調整に使わない六データセットでも測る。Cosmos QA、Social IQA、QuAIL の質問応答、WiC の語義、COPA と H-SWAG の文補完だ。T5-base では最強の比較法 RegMean の 34.3 に対し TIES は 35.3、T5-large では 36.0 に対し 40.4 になる。これは六つの保留タスクへの汎化で、マージ対象タスクの 70 点台とは別の問題だ。
同じタスクの checkpoint 同士も干渉する。Hugging Face からタスクごとに十の BERT モデルを取り、RTE では TIES 72.2、タスク算術 71.8、MRPC は 86.8 対 86.0、WNLI は 58.8 対 59.2 だった。多くでは TIES がよいが、順位が逆転する設定もある。
各段階は必要か
構成要素を一つずつ外す。係数調整を外して にする場合と、同符号だけの平均を外す場合の影響が大きい。T5-base はそれぞれ 2.5、1.9 ポイント、(IA) は 5.2、3.2 ポイント下がる。刈り込みや符号選出を外しても下がるが、影響は小さめだ。
このアブレーションは検証スコアで、完全版は T5-base 74.5、(IA) 70.7。主表のテスト平均とは分けて読む。Elect を外しても刈った 0 は除き、正負の値を一緒に平均する。Disjoint Mean を外すと、符号選別は残すが 0 を分母に含める。これにより方向の相殺とゼロによる希釈の損失を区別する。
方向の重要性も直接試す。絶対値上位 20% または 30% の値の符号を確率 で反転すると、性能は とともに単調に下がる。残りの小さな 70%~80% を反転してもほぼ影響しない。大きい値の方向を誤ると、タスクが壊れる。
符号をすべて正しく選べたら
各パラメータの符号を正しく選べれば、どこまでマージできるのだろう。
十一の (IA) タスクで別途マルチタスクモデルを訓練し、その符号を「正解」として使い、選出を省く。すると 72.0% に達し、マルチタスクモデルの 73.1% との差は 1.1 ポイントだけになる。TIES 自身の選出では 66.4% だ。
正しい方向が得られれば、マージはほぼマルチタスク訓練へ追いつく、というのが著者らの結論だ。付録では少量のデータで符号を推定する方法も試す。
ただし oracle はすでにマルチタスクの訓練結果を見ており、改善の余地を測るためのものだ。各タスク 32 標本で推定する付録の方法は、最初から訓練すると 66.5、平均モデルから初期化すると 67.7 で、完全な oracle の 72.0 に届かない。少量データから方向を確実に選ぶ問題は残っている。
結論
TIES-Merging は安価な三段階でタスク加算の干渉を扱う。小さい変更を捨て、総量で方向を選び、同じ側の値だけを平均する。固定配合なら互換性のある微調整重みと共通の基底だけでよい。よりよい配合を選ぶなら、検証評価のコストも含めたい。
境界も明確だ。マージ法同士の差は数ポイントでも、専門モデルとの差は十数ポイントになることが多い。
一年余り後、Yadav と Google の共同研究者は 640 億パラメータへ規模を広げ、モデルが大きくなると手法の差が小さくなることを見いだした。