原論文
The Role of Permutation Invariance in Linear Mode Connectivity of Neural Networks
- 発表先
- ICLR 2022国際会議
- arXiv への初回投稿
- arXiv:2110.06296
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingpermutationinvariance2021,
  title = {{The Role of Permutation Invariance in Linear Mode Connectivity of Neural Networks}},
  author = {Rahim Entezari and Hanie Sedghi and Olga Saukh and Behnam Neyshabur},
  year = {2021},
  eprint = {2110.06296},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2110.06296}
}
損失地形の研究は、2018 年前後に奇妙なことを教えてくれた。
異なるランダム初期化から訓練した二つのネットワークの間には、曲がった低損失経路が見つかる。ところが直線で結ぶと、損失はやはり中ほどで跳ね上がる。曲がった道なら通れるのに、直線では通れない。
TU Graz と Google の Entezari、Sedghi、Saukh、Neyshabur は、考えられる原因を一つ思いついた。ニューラルネットワークの隠れユニットには固定の順序がない。同じ層のニューロンの位置を入れ替えても、ネットワークが計算する関数はまったく同じだが、パラメータベクトルは別の点になる。二つのネットワークが直線上で壁にぶつかるのは、ニューロンが「間違った位置に並んでいる」からにすぎないのかもしれない。
彼らはこの考えを予想としてまとめ、それが大胆であることを率直に認めている。
問題の定義
障壁をどう測るか
をあるパラメータでのネットワークの損失(例えば訓練誤差)とする。二組のパラメータ 、 の間の線形補間の障壁を次のように定義する。
第一項は補間モデルの損失、第二項は両端の損失の線形補間だ。その差は「直線から見込まれる値より余分に出た分」を測る。
これは Frankle らの定義と少し異なる。Frankle は両端の損失の平均 を基準にする。両端の損失が等しければ二つの定義は一致し、等しくない場合、この定義は「損失が一端から他端へ線形に変わる」分を障壁に数えない。
のとき、二つのネットワークは線形モード連結(linear mode connectivity、LMC)であるという。著者らは実験で、 で一度だけ測った値と経路全体の上限との差が 未満であることを確かめ、以降の図では中点の値だけを報告している。
まず障壁が何に関係するかを見る
予想を示す前に、著者らはまず網羅的な調査を行った。アーキテクチャは単層 MLP、二層畳み込みの Shallow CNN、VGG、ResNet、データセットは MNIST、SVHN、CIFAR-10、CIFAR-100 だ。各設定でシードの異なるモデルを 10 個訓練し、ランダムな 5 組のペアで訓練誤差の障壁を測る。
- 幅:障壁は幅とともにまず上がり、ある幅を境に下がり始める。形は double descent によく似ている。著者らがテスト誤差と照らし合わせると、障壁のピークはモデルが訓練データにちょうど適合できる幅のあたりにあった。簡単なデータセット(MNIST、SVHN)は CIFAR より早く下がり始める。
- 深さ:MLP と Shallow CNN で各層の幅を に固定すると、一層増やすごとに障壁ははっきり高くなる。VGG と ResNet の障壁はずっと高いところにとどまり、幅によって変わらない。
- タスクの難しさ:MLP の障壁は MNIST でわずか 0.0174、CIFAR-100 では 0.7965。Shallow CNN では 0.0161 から 0.4861 になる。浅いネットワークの障壁はテスト誤差と強い正の相関を持つ。ResNet18 と VGG16 は四つのデータセットのいずれでも 0.84~0.99 で、テスト誤差は低いのに障壁は高い。
調査の結論は、幅は障壁を下げ、深さは障壁を上げるというものだ。これらの現象には説明が要る。
問題を解く
二つの不変性
ネットワークにある変換を施しても表す関数が変わらないとき、ネットワークはその変換に対して不変性を持つという。よく知られたものが二つある。
一つ目は ReLU の正の斉次性だ。あるニューロンの入力の重みに を掛け、出力の重みを で割っても、関数は変わらない。著者らはこの不変性は重要ではないと考える。SGD の暗黙のバイアスによって各層の重みの大きさが釣り合う方向へ向かい、特定のスケーリングに収束するからだ。
二つ目は置換不変性だ。第 層の隠れユニットを並べ替えると、パラメータは次のようになる。
ここで は置換行列で、入力層と出力層は置換しない。 はこの層の出力の順序を入れ替え、 は前の層の置換を打ち消す。SGD にとってはどの置換も同じ確率で現れるので、置換が損失地形に与える影響は真剣に見る価値がある。
単一隠れ層のネットワークで確かめよう。隠れ層には 個のユニットがある。第一層の重みの行、バイアス、第二層の重みの列を、同じ置換で一緒に並べ替える。
def permute(params, p):
    W1, b1, W2, b2 = params        # W1: [h, d], b1: [h], W2: [10, h], b2: [10]
    return [W1[p], b1[p], W2[:, p], b2]
本稿の後半の小実験では、幅 16、64、256 のネットワークにそれぞれ一度ランダムな置換を施し、torch.allclose で置換前後のデータセット全体での出力を比べたところ、三回とも True が返った。関数はまったく同じだが、パラメータ空間では遠く離れた二つの点だ。
幅 の一層だけで 通りの並べ方がある。同じ関数が、パラメータ空間に天文学的な数の分身を持つ。
予想
著者らの予想を平たく言えば、次のようになる。
大多数の SGD の解は一つの集合 に属する。 の要素に適切な置換を施せば、どの二つの要素の間の線形補間にも障壁はない。
正式な版には幅の条件が加わる。ある幅 が存在し、ネットワークが十分広ければ、解の集合 と置換を指定する関数 が存在して、 のどの二つの解も置換後の障壁がほぼゼロになり、しかも SGD の解は高い確率で に入る。
予想が正しければ、損失地形で互いに隔てられて見える多くの盆地は、実は同じ盆地が置換によって複製された分身にすぎない。
理論:証明できたのは最も単純な場合だけ
著者らが証明したのは、かなり限定された版だ。単一隠れ層、ReLU の全結合ネットワーク について、ランダム初期化時、つまり重みを指定の一様分布から抽出したとき、高い確率である置換が存在し、二つのネットワークを補間したものの出力と、両端の出力の補間との誤差は、わずか次の程度になる。
は隠れユニット数、 は入力次元だ。十分広ければ誤差はゼロに近づく。
この定理が扱うのは初期化だけで、訓練後のネットワークは扱わない。指数の からも、入力次元が高いほど必要な幅が急激に増えることがわかる。著者ら自身、より複雑な証明なら NTK の領域まで拡張できるかもしれないが、今後の課題だと述べている。
実験:置換の空間が大きすぎるので、別の方法で検証する
直接検証するには置換を探索する必要があるが、置換の数は幅の階乗で増える。著者らは総当たり探索を試したが、単一隠れ層 MLP で扱えたのはニューロン 16 個までで、それですでに 通りの置換になる。
より賢い探索アルゴリズムを使っても、失敗したときに、アルゴリズムが弱いのか、そもそもそんな置換が存在しないのかを区別できない。
著者らは視点を変えた。SGD の解 が与えられたとき、そのすべての置換を集めて次の集合を作る。
は必ず予想を満たす。中の要素はすべて の分身なので、置換を元に戻せば障壁はゼロになる。論文は を「我々のモデル」、本当の SGD 解の集合 を「現実世界」と呼ぶ。
あとは と の振る舞いが同じかを調べればよい。独立に訓練した解 と の間の障壁が、 と「 のランダムな置換」の間の障壁と、さまざまな幅、深さ、データセットでほぼ同じなら、「 は実は のある置換に小さな摂動を加えたものだ」というのが妥当な説明になる。
自分で一度走らせてみる
この論証は、ごく小さな規模で再現できる。
下の図は本稿で別に行った小実験で、論文の結果ではない。データは sklearn 組み込みの 8×8 手書き数字(1,797 枚)、モデルは単一隠れ層の ReLU MLP だ。異なるシードで二つのモデル A と B を訓練し、訓練損失はどちらも 0.001 前後になる。次に三種類の線形補間を比べる。A から B、A から「ランダムに置換した A」、A から「整列した B」だ。
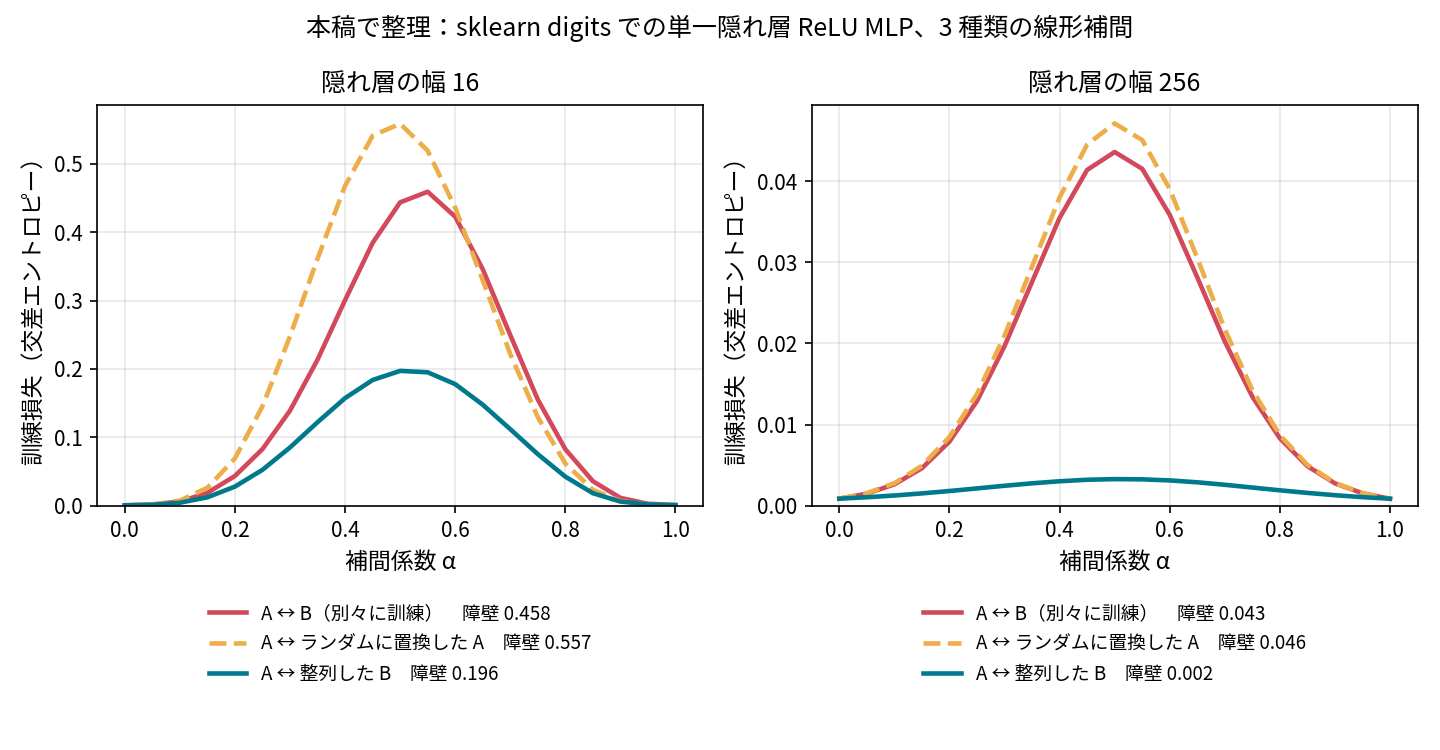
まず赤とオレンジの線を見る。A と B は別々に訓練したモデルで、A と置換後の A は同じ関数なのに、二つの曲線の山はほぼ同じ高さだ。独立な訓練による障壁と、「席を入れ替えただけ」で生じる障壁の高さが近い。これが論文の中心的な観察である。
青緑の線は別に加えたものだ。B の隠れユニットを活性値の相関に基づき、ハンガリー法で A に一対一で割り当ててから補間する。幅 16 では障壁が 0.458 から 0.196 に、幅 256 では 0.043 から 0.002 に下がる。この整列法は後続研究によるもので、この論文が使った探索法とは別物だ。ここに載せたのは、「正しい位置に並べる」ことで実際にどこまでできるかを見てもらうためである。
なお、幅 64 では三つの障壁はそれぞれ 0.094、0.070、0.006 だった。幅が大きいほど障壁は低く、整列後はゼロにより近づく。論文の調査の傾向と一致する。
論文の証拠
論文に戻ろう。著者らが MLP と Shallow CNN で と を比べると、さまざまな幅、深さ、データセットで両者の障壁の曲線はほぼ重なった。
次に探索を加える。著者らは焼きなまし法(simulated annealing)で置換を探す。巡回セールスマン問題でよく使われる近似アルゴリズムだ。二つの版がある。
- SA1:五つの解のすべての組の平均障壁を直接最小化する。
- SA2:まず置換後の解を平均して一つのモデルにし、その平均モデルの訓練誤差を最小化する。
両者の効果はほぼ同じで、SA2 のほうがずっと安いため、以降は SA2 だけを使う。ただし、五つの解を同時に整列する設定では、障壁をほとんど下げられない。
そこで著者らは探索空間を狭め、解を二つだけ取り、 を固定して だけを置換する。すると MNIST と SVHN の MLP と Shallow CNN では障壁がはっきり下がり、MNIST の単層 MLP ではすべての幅でゼロまで下がった。さらに重要なのは、探索の前後で と の障壁がやはりほぼ同じだったことだ。 で探索が成功したところでは でも成功し、 で失敗したところでは でも失敗する。
全実験で訓練したネットワークは三千を超える。著者らがそれを一枚の密度図にまとめると、「現実世界」と「我々のモデル」の障壁はおおむね対角線に沿って分布している。
議論
この論文の論証の仕方は面白い。予想を証明するのではなく、「予想が誤りなら差が見えるはずだ」という一連の実験を設計し、結果として差は見えなかった。著者らの言葉づかいも慎重で、これらの試みは予想を「反証できなかった」と述べている。
ただし、証拠の強さは分けて見る必要がある。
最も説得力があるのは浅いネットワークだ。MLP と Shallow CNN では、 と は探索の前後ともよく似ており、簡単なデータセットでは探索で実際に障壁をゼロまで下げられた。
深いネットワークの証拠は弱い。VGG と ResNet の障壁は でも でも高く、焼きなまし法はどちらでも障壁を下げる置換を見つけられない。「両方とも失敗」は予想と矛盾しないが、探索アルゴリズムが弱すぎるのか、深いネットワークにはそもそも別の障壁があるのかは区別できない。著者らも、探索空間の大きさがこの論文最大の制限であり、実験がすべて画像認識だけであることを認めている。
の論証自体にも暗黙の前提がある。 と が「直接補間の障壁」と「探索後の障壁」で似ていても、「最良の置換のもとでの障壁」まで似ているとは限らない。予想が本当に述べているのは後者だ。
深いネットワークの部分は後続研究が補った。Git Re-Basin は重み照合を使い、幅を何倍にも広げた ResNet で、CIFAR-10 上の独立に訓練した二つのモデルを初めて障壁ゼロでつないだ。SGD の解ではない反例も構成し、予想の「SGD の解」という限定を省けないことを示している。次に見る REPAIR は、深いネットワークで整列後も障壁が残るもう一つの原因を見つけた。問題は補間後の活性値の分散にある。
結論
この論文が示したのは、損失地形上で異なって見える多くの盆地は、同じ盆地の置換による分身にすぎないかもしれない、という単純な考えだ。
理論がカバーするのは単一隠れ層でランダム初期化の場合だけだ。実験は「一つの解の置換で、独立に訓練した解を模擬する」という巧みな代替を使い、浅いネットワークでかなり一貫した支持を得た。
これを自分の手で実感するのに、大きなモデルは要らない。小さな MLP を二つ訓練し、一方の隠れユニットを適当にシャッフルして元の自分と補間すれば、二つの独立なモデルの間とほぼ同じ高さの山が見えるはずだ。