原論文
Loss Surfaces, Mode Connectivity, and Fast Ensembling of DNNs
- 発表先
- NeurIPS 2018国際会議
- arXiv への初回投稿
- arXiv:1802.10026
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingmodeconnectivity2018,
  title = {{Loss Surfaces, Mode Connectivity, and Fast Ensembling of DNNs}},
  author = {Timur Garipov and Pavel Izmailov and Dmitrii Podoprikhin and Dmitry Vetrov and Andrew Gordon Wilson},
  year = {2018},
  eprint = {1802.10026},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1802.10026}
}
同じネットワークを異なる二つの乱数シードで訓練すると、まったく異なる重みが得られる。それでも精度はほぼ同じになる。
この二組の重みは、パラメータ空間の二つの点に対応する。直線で結び、途中の点をいくつか評価すると、中間の誤り率が驚くほど高くなることが多い。論文の例では、CIFAR-10 の VGG-16 は線分の中点でテスト誤り率が 90% に達する。10 クラスなので、当てずっぽうと同程度だ。
そこで、解はそれぞれ孤立した谷にあり、谷の間を高い山が隔てている、と考えたくなる。
Samsung モスクワ AI センター、Skoltech、Cornell、モスクワの高等経済学院大学に所属する Garipov、Izmailov、Podoprikhin、Vetrov、Wilson は、問いを変えた。直線で通れないなら、曲がった道はどうだろう。
問題の定義
独立に訓練した二つのネットワークの重みを 、、訓練損失を とする。直線で結ぶと、
著者らが探すのは、両端を と に固定し、途中の曲がり方をパラメータ で決める曲線 だ。曲線全体で損失が低くなければならない。
見つかれば、「解は孤立した谷にある」という見方を改める必要がある。見つからない場合も、曲線の形が制限されすぎているのか、最適化に失敗したのか、二点を結ぶこと自体が難しいのかを分けて考える必要がある。一度の探索の失敗だけで、ほかの経路まで排除することはできない。
問題を解く
曲線そのものを学習する
曲線上の各点はネットワークの重み一式なので、ネットワークに代入すれば損失を計算できる。目的は、曲線全体の平均損失を小さくすることだ。
この期待値の勾配はサンプリングで推定できる。各ステップで から を一つランダムに選び、曲線上のその点の重みを計算する。ミニバッチで損失を求め、 を一度、勾配降下で更新する。端点 、 は固定し、曲線の形を決める だけを学習する。
二種類の曲線
著者らは二つの単純なパラメータ化を使った。一つ目は、一度だけ折れ曲がる折れ線で、折れ点が になる。
二つ目は二次ベジェ曲線で、 は制御点だ。
どちらも と で二つの端点に一致する。 の形はネットワークの重み一式と同じなので、学習するパラメータ数はネットワーク一つ分になる。
ベジェ曲線の中点を計算してみよう。 では、両端がそれぞれ 、制御点が を占める。制御点をある方向に 1 単位動かすと、中点の重みは同じ方向に半単位動く。逆伝播でも、制御点に対する損失の勾配は、その時点の重みに対する勾配に を掛けた値になる。端点の重みをオプティマイザに登録しないので、訓練中も元の二つのモデルは変化しない。
折れ線も同様だが、更新の倍率は前半と後半で変わる。このため、曲線の訓練には通常のネットワークの順伝播と逆伝播を使え、主に増えるのは重みの線形結合だ。ただし、訓練データ、追加の最適化、制御点一つ分の保存領域が必要になる。低損失の経路を探す処理には、こうしたコストがかかる。
小さなネットワークで試す
小さなネットワークでも効果を確認できる。scikit-learn に付属する 1,797 枚の 8×8 手書き数字を使い、各隠れ層が 200 ユニットの 2 層 MLP を用意する。同じ 1,200 枚の訓練データから、初期重みを変えて二つの端点を訓練し、直線の中点からベジェ曲線を学習する。
import torch
import torch.nn as nn
from torch.func import functional_call
from sklearn.datasets import load_digits

X, y = load_digits(return_X_y=True)
X = torch.tensor(X / 16.0, dtype=torch.float32)
y = torch.tensor(y)
perm = torch.randperm(len(X), generator=torch.Generator().manual_seed(0))
idx_train, idx_test = perm[:1200], perm[1200:]

def make(seed):
    torch.manual_seed(seed)
    return nn.Sequential(nn.Linear(64, 200), nn.ReLU(),
                         nn.Linear(200, 200), nn.ReLU(),
                         nn.Linear(200, 10))

def train(model, seed, steps=480):
    opt = torch.optim.SGD(model.parameters(), lr=0.1)
    g = torch.Generator().manual_seed(seed)
    for _ in range(steps):
        b = idx_train[torch.randint(len(idx_train), (50,), generator=g)]
        loss = nn.functional.cross_entropy(model(X[b]), y[b])
        opt.zero_grad(); loss.backward(); opt.step()
    return {k: v.detach() for k, v in model.state_dict().items()}

w1 = train(make(1), seed=10)                 # 兩個端點:同樣的資料,不同的初始權重
w2 = train(make(2), seed=20)
net = make(0)

@torch.no_grad()
def evaluate(w):
    loss = nn.functional.cross_entropy(functional_call(net, w, (X[idx_train],)), y[idx_train]).item()
    acc = (functional_call(net, w, (X[idx_test],)).argmax(1) == y[idx_test]).float().mean().item()
    return f"loss {loss:.3f}, 測試 {acc:.1%}"

def line(t):
    return {k: (1 - t) * w1[k] + t * w2[k] for k in w1}

theta = {k: v.clone().requires_grad_(True) for k, v in line(0.5).items()}   # 彎點從直線中點出發

def bezier(t):
    return {k: (1 - t) ** 2 * w1[k] + 2 * t * (1 - t) * theta[k] + t ** 2 * w2[k] for k in w1}

opt = torch.optim.SGD(theta.values(), lr=0.1)
g = torch.Generator().manual_seed(0)
for _ in range(1200):
    t = torch.rand((), generator=g).item()   # 每一步隨機抽一個 t
    b = idx_train[torch.randint(len(idx_train), (50,), generator=g)]
    loss = nn.functional.cross_entropy(functional_call(net, bezier(t), (X[b],)), y[b])
    opt.zero_grad(); loss.backward(); opt.step()   # 只更新彎點 theta,端點不動

for t in [0, 0.25, 0.5, 0.75, 1]:
    print(f"t={t:<4}  直線: {evaluate(line(t))}  |  曲線: {evaluate(bezier(t))}")
t=0     直線: loss 0.119, 測試 95.5%  |  曲線: loss 0.119, 測試 95.5%
t=0.25  直線: loss 0.415, 測試 93.6%  |  曲線: loss 0.142, 測試 95.5%
t=0.5   直線: loss 0.949, 測試 88.9%  |  曲線: loss 0.156, 測試 95.3%
t=0.75  直線: loss 0.420, 測試 95.0%  |  曲線: loss 0.140, 測試 95.3%
t=1     直線: loss 0.119, 測試 94.8%  |  曲線: loss 0.119, 測試 94.8%
functional_call を使うと、同じネットワーク構造に外部から重み一式を渡して計算できる。曲線上の各点も、この方法で評価できる。両端の損失はどちらも 0.119 だ。直線の中間では 0.949 まで上がるが、学習した曲線では 0.156 にとどまり、テスト精度も 95% 前後を保つ。
このネットワークは小さく、直線上の壁もそれほど高くない。論文のネットワークはもっと大きく、壁ももっと高い。
議論
大きなネットワークの曲線
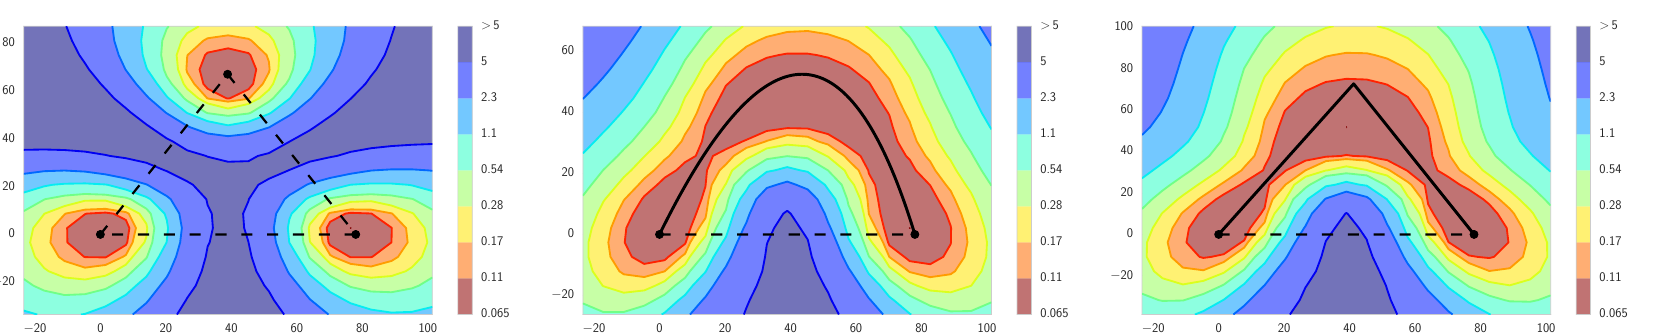
この図は、CIFAR-100 における ResNet-164 の訓練損失を示している。各図はパラメータ空間の二次元断面で、横軸は二つの解を通るように固定している。赤は低損失、青は高損失の領域だ。
左は独立に訓練した三つの解で断面を決めている。それぞれに赤い領域があり、間は青く、「孤立した谷」という直感に合う。中央と右では、学習した曲線が平面に乗るよう断面を変えている。すると下側の二つの解が赤い通路でつながる。一方、二点間の直線の破線は、引き続き青い領域を横切る。
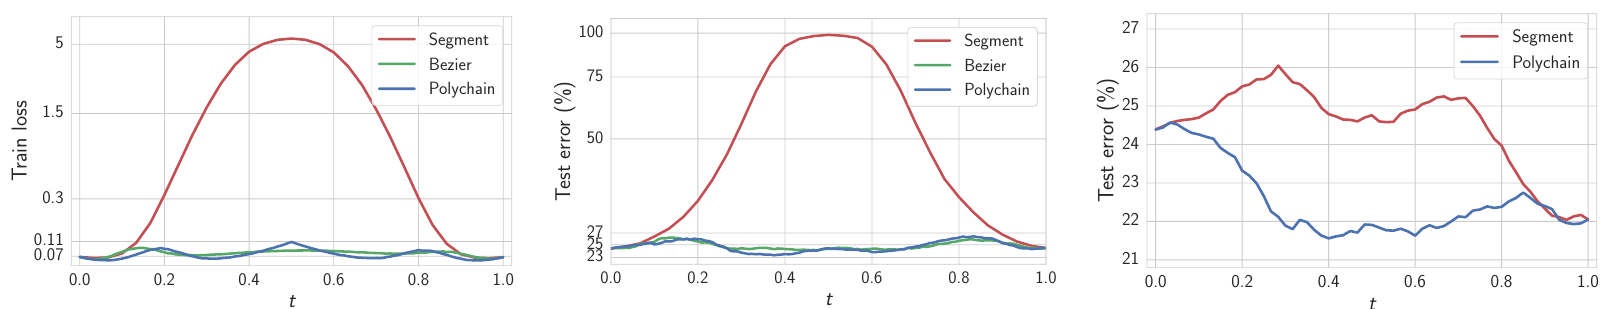
Figure 2 は同じ実験を曲線として描いたものだ。左と中央の赤線が直線補間で、中間の訓練損失とテスト誤り率がともに跳ね上がる。緑のベジェ曲線と青の折れ線は、ほぼ平らになっている。
直線上の壁の高さはアーキテクチャによって変わる。CIFAR-10 では、VGG-16 の中点のテスト誤り率は 90%。ResNet-158 と Wide ResNet-28-10 は低めで、最大でもそれぞれ 80% と 66% だった。著者らは、残差ネットワークの損失地形は VGG のような古典的モデルより規則的だという、先行研究の観察に対応すると考えている。
曲線は一意でもない。同じ二つの端点を使い、異なるシードで二つの折れ線を学習すると、VGG-16 では二つの折れ点の距離が 29.6、端点間の距離は 50 だった。
曲線上の点には、それぞれの予測がある
曲線全体の損失が低いなら、各点は同じモデルを別の形で書いただけなのだろうか。
右の図がこの問いに答える。端点 と曲線上の一点 で二モデルのアンサンブルを作り、出力を平均する。折れ線上を進むと、 からアンサンブルの誤り率が下がり始め、 では、独立に訓練した二つの端点のアンサンブルと同じ程度になる。少し進むだけで、精度を保ちながら、予測が明確に異なるモデルを得られる。
ReLU の前後の重みを互いにスケーリングする場合など、曲線上の点が同じ関数の別のパラメータ表現にすぎなければ、アンサンブルの利点は生まれない。著者らは付録で、そうした役に立たない接続曲線の作り方も示している。
曲線からアンサンブルへ
この観察から、論文の二つ目の貢献、Fast Geometric Ensembling(FGE)が生まれる。
ある解の近くを少し歩くだけで、異なる予測をする十分よいモデルが得られるなら、曲線を学習する手順を省ける。FGE は通常の学習率スケジュールで総予算の約 80% まで訓練し、その後は 1 周期が 2~4 エポックの短い循環学習率に切り替える。学習率が高いときに外へ進み、低いときに谷底へ戻る。低点に来るたび重みを保存し、最後にそれらのモデルをアンサンブルする。
先行する Snapshot Ensembles との違いは、歩幅だ。Snapshot Ensembles は 1 周期が 20~40 エポックで、最初から最後まで使う。FGE は最終段階だけで短周期を使う。CIFAR-100 の Preactivation-ResNet-164 では、連続する FGE の保存点間の重みのユークリッド距離は約 7、Snapshot Ensembles は約 40 だった。
ImageNet の結果がわかりやすい。top-1 誤り率 23.87% の訓練済み ResNet-50 に、周期 2 エポックの FGE をさらに 5 エポック適用した。元のモデルを含む 4 モデルのアンサンブルで、誤り率は 23.31% となり、0.56 ポイント下がった。
FGE はアンサンブルなので、推論時には各モデルを一度ずつ実行する。
周期の動きと保存のタイミング
原図の左半分は、上から学習率、テスト誤り率、起点からのパラメータ距離を示し、黒丸が保存のタイミングを表す。右半分は同じ訓練予算での成績だ。×印は個々のスナップショット、線で結ばれたひし形がアンサンブルになる。
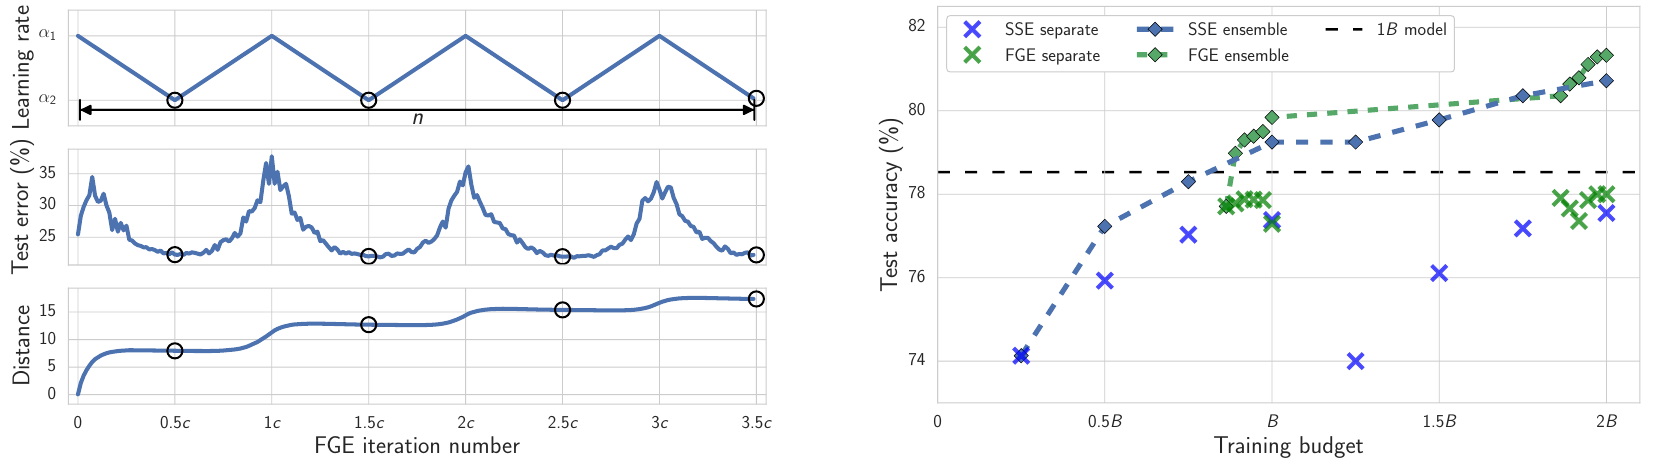
FGE の学習率は三角形を描く。1 周期のミニバッチ更新数を偶数 、周期内の位置を 、上限と下限を とすると、
高い学習率から低点まで下げ、再び上げる。保存は周期の中間、つまり 、学習率が の時点で行う。高点付近ではモデルの誤り率が一時的に上がるため、残すのは低誤り領域へ戻った後の重みだ。
CIFAR の実験では、VGG は 1 周期 2 エポック、、。ResNet と WRN は 4 エポックで、、 を使う。例えば ResNet の標準予算 epochs では、通常のスケジュールを 125 エポック目まで実行し、126~147 エポックの間に 6 モデルを集める。これらのスナップショットは前半の訓練経路を共有し、最初から訓練し直す時間を節約する。
曲線探索と FGE の役割も分かれる。論文の前半は、二つの端点を固定して折れ点を学び、低損失の通路が存在するかを検証する。FGE は一つのモデルから短い周期で近くの複数の解を探す。FGE の実行に、二つ目の端点の訓練やベジェ曲線の学習は必要ない。
同じ予算で、どこまで精度が上がるか
アンサンブルを比較するときは、訓練予算と推論時のモデル数を分けて見る。論文の は、通常の方法で一つのモデルを収束まで訓練するエポック数で、 はその 2 倍の訓練量だ。下表は CIFAR-100、 の結果で、指標は小さいほどよいテスト誤り率。
| アーキテクチャ | 独立訓練 Ind | Snapshot Ensembles | FGE |
|---|---|---|---|
| VGG-16、 | 27.4 ± 0.1 | 26.4 ± 0.1 | 25.7 ± 0.1 |
| Preactivation ResNet-164、 | 21.5 ± 0.4 | 20.9 ± 0.2 | 20.2 ± 0.1 |
| WRN-28-10、 | 19.2 ± 0.2 | 17.9 ± 0.2 | 17.7 ± 0.2 |
テスト誤り率(%)。原論文 Table 1 より整理。同じ行は訓練予算が等しく、推論時のモデル数は手法によって異なる。
三つとも Snapshot Ensembles を上回り、VGG と ResNet はそれぞれ 0.7 ポイント下がった。 の CIFAR-100 の WRN では、Ind 17.48%、SSE 17.30%、FGE 16.95%。ただし、CIFAR-10、WRN、 では Ind が 3.31%、FGE は 3.52% だった。アンサンブル手法の優位性は、データセット、アーキテクチャ、予算によって変わる。
予測の多様性も測っている。CIFAR-100 の ResNet-164 では、独立した二つのモデルはテスト画像の 19.97% で異なるクラスを予測するが、同じ FGE 実行から得た二つのスナップショットでは 14.57% だった。個々の FGE スナップショットも少し弱く、精度は約 78.0%、完全に独立した訓練では約 78.5%。FGE の利点は、同じ時間で有用なスナップショットを多く集められ、個々のモデルの精度と多様性の差を補えることにある。
最後に BatchNorm もある。曲線上で重みが変われば、中間活性値の分布も変わる。付録では BatchNorm を持つネットワークの統計量を推定し直してから、曲線上の損失を測っている。端点の running mean と variance を流用すると、統計量の不整合も高い壁に混ざりうる。地形を見る前に、各点のネットワークが正しく推論できる状態を整える必要がある。
結論
この論文は、素朴な訓練方法で、独立に訓練した二つの解を一度だけ曲がる線で結んだ。曲線上では損失がほぼ変わらず、直線上には高い壁がある。
「各解は孤立した谷にある」という図は、「解の間には低損失の通路があるが、まっすぐではない」という図に変わった。独立に訓練したネットワークをそのまま平均すると壊れる理由も、平均が直線上を通ることから理解できる。
FGE には、推論コストという課題が残った。2 週間後、同じ著者グループは SWA を発表する。保存した重みをアンサンブルに使う代わりに、そのまま平均して一つのモデルにする方法だ。