原論文
Editing Models with Task Arithmetic
- 発表先
- ICLR 2023国際会議
- arXiv への初回投稿
- arXiv:2212.04089
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingtaskarithmetic2022,
  title = {{Editing Models with Task Arithmetic}},
  author = {Gabriel Ilharco and Marco Tulio Ribeiro and Mitchell Wortsman and Suchin Gururangan and Ludwig Schmidt and Hannaneh Hajishirzi and Ali Farhadi},
  year = {2022},
  eprint = {2212.04089},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.04089}
}
事前訓練モデルを手に入れても、たいていは修正が要る。あるタスクを得意にする、有害な発言を減らす、新しいデータに対応させる。論文はこれらを「編集」と呼ぶ。
一般的なのは微調整だ。一度行うたびにモデルが増える。二つの能力を同時に持たせたいなら、二つのデータをまとめてマルチタスク訓練することが多く、能力を増やすたびデータと訓練工程を調整し直す。
ワシントン大学、Microsoft Research、AI2 の Ilharco、Ribeiro、Wortsman らは、WiSE-FT と Model Soups で重みの線形混合を研究していた。今度は「微調整で何が変わったか」を取り出し、ベクトルとして操作する。
問題の定義
事前訓練重みを 、タスク で微調整した重みを とし、差をタスクベクトル(task vector)と定義する。
モデル全体と同じ大きさのベクトルで、タスク のために各重みがどちらへ、どれほど動いたかを記録する。
重み にタスクベクトルを戻す際は、係数 でスケーリングできる。
、 なら微調整後のモデルに戻る。 は確保した検証データで選ぶ。
前提もある。重みごとに差を取るため、構造は同じで、微調整時に新しいパラメータを追加できない。著者らは二種類の「オープンな」モデルを選ぶ。一つは CLIP のような開放語彙画像分類器で、タスクが変わってもクラス名を変え、テキストエンコーダで分類ヘッドを作れる。もう一つは T5、GPT-2 のような text-to-text 言語モデルだ。
これらのベクトルを数のように足したり引いたりすると、モデルの振る舞いも対応して変わるだろうか。
問題を解く
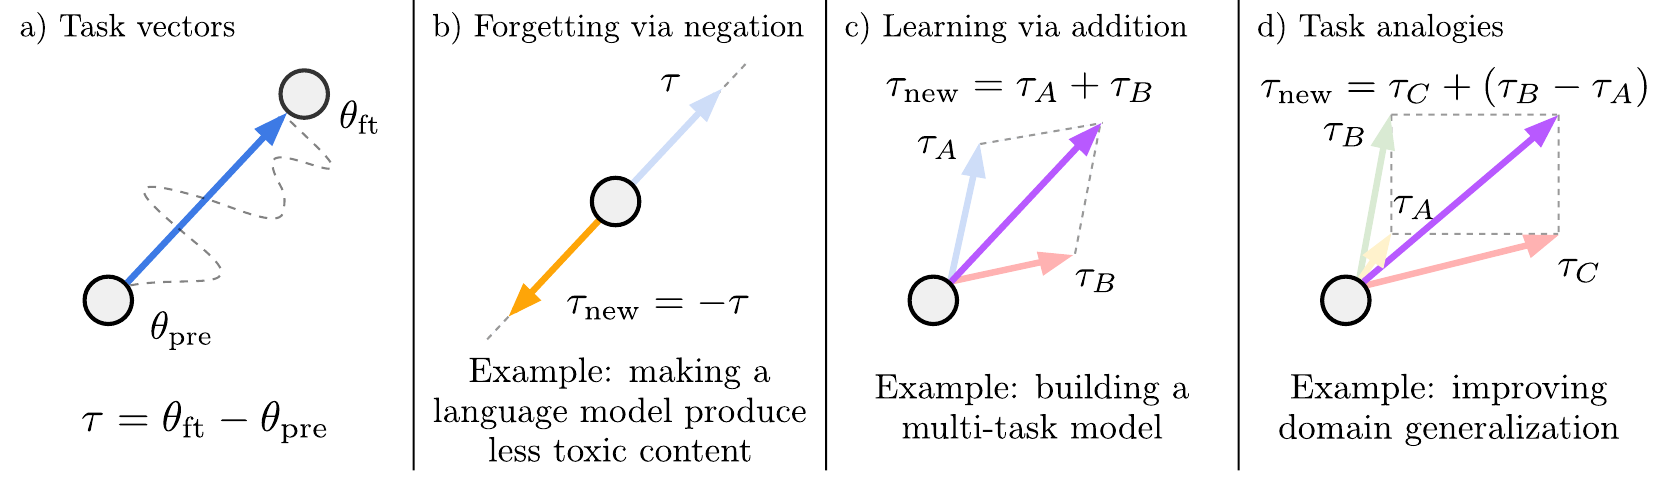
研究する演算は三つで、すべて重みごとに行う。
- 符号反転(忘却):。事前訓練重みから微調整と逆へ進み、対象タスクの性能を下げ、他タスクへの影響を抑える。
- 加算(学習):。複数タスクのベクトルを加え、それらを同時に処理するモデルを得る。
- 類推:「A 対 B が C 対 D に対応する」四タスクでは、 で、データがほとんどない D を改善する。
最後はすべて になる。編集自体はベクトル演算だけで、推論のメモリと計算量は元のモデルと同じだ。
タスクの加算と二つの微調整モデルの平均は混同しやすい。、 とすると、
直接平均はタスク算術の に相当し、 は二つの微調整の変更量をそのまま保つ。基底が 、各タスクが と なら、平均は 、タスク加算は 。大きなネットワークでは 2 倍の尺度差が成績を変えるため、係数選択も方法の一部だ。
類推は論文の例で見るとわかりやすい。Yelp レビューの感情分類をしたいが、感情ラベルは Amazon にしかなく、Yelp はラベルなしテキストだけある場合、次のように組み合わせる。
は Amazon の感情分類から得る。括弧内は Yelp と Amazon のテキストで言語モデルを訓練したベクトルで、ラベルは不要だ。その差は、おおまかに Amazon から Yelp への領域移動の方向を表す。
議論
符号反転で一つのタスクを忘れる
画像分類には CLIP を使う。対象は車種(Cars)、テクスチャ(DTD)、衛星画像(EuroSAT、RESISC45)、道路標識(GTSRB)、手書き数字(MNIST)、場面(SUN397)、住所の数字(SVHN)の八データセット。対照の ImageNet で他能力の劣化を確認する。
ViT-L/14 からタスクベクトルを引くと、八タスクの平均精度は 64.8% から 19.0% へ、45.8 ポイント下がる。ImageNet は 75.5% から 72.9% で、低下は 2.6 ポイントだ。対象タスクで損失を増やす勾配上昇でも対象は悪くなるが、ImageNet も 16.3% に落ちる。同じ大きさのランダムベクトルを加えても、対象への効果は小さい。
テキスト生成では、Civil Comments の毒性スコアが 0.8 を超えるコメントで GPT-2 Large を微調整し、有害な発言のタスクベクトルを得てから引く。有害と判定される生成の割合は 4.8% から 0.8%、WikiText-103 の perplexity は 16.4 から 16.9 になる。勾配上昇でも毒性は下がるが、perplexity が実用にならないほど悪化する。
固定の論争的な書き出しから 1,000 テキストを生成し、Detoxify 分類器で評価する。 は perplexity の悪化が 0.5 以内という条件で最大の値を選ぶ。「無害なコメントで直接微調整」の対照は毒性 1.8%、perplexity 17.2 で、反転ベクトルのほうがこの取捨に優れる。付録は他のプロンプト、RealToxicityPrompts、異なる規模の GPT-2 も調べているが、難しいプロンプトの毒性には改善の余地がある。
ここでの「忘却」は、指定のタスクとプロンプトの出力で測る行動上の性能低下だ。特定の訓練データを削除したか、情報を取り出せなくなったかという検証は行っていない。
加算で複数の仕事をする
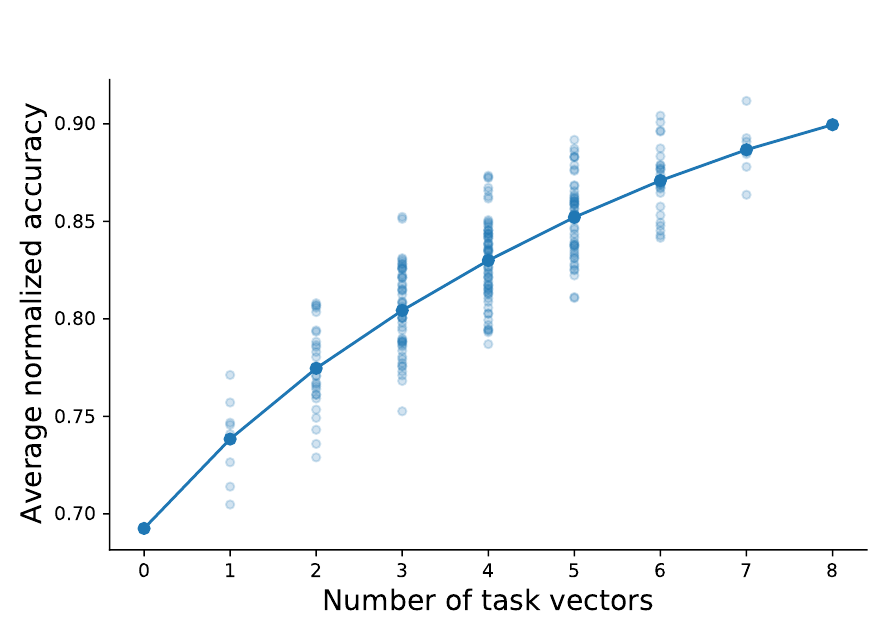
タスクの難易度が異なるため、各タスクのマージ精度を単独微調整の専門モデルの精度で割る、正規化精度を使う。100% は各専門モデルと同程度だ。
二つずつ加えると、その二タスクでは専門モデルの精度の平均 98.9% を保つ。上図は別の測り方で、点はベクトルの部分集合だが、成績は常に全八タスクで平均する。 部分集合を調べ、0 個のゼロショットモデルは約 69%。カバーするタスクが増えると全体平均も上がる。八つのベクトルから選べるとき、最良のマルチタスクモデルは正規化精度 91.2% に達する。
一つで八つの仕事をして、八専門モデルとの差は一割未満だ。ただしマージによる損失はあり、タスクが多いほど完全には保ちにくい。
正規化はタスクごとに割ってから平均する。専門モデルが 80%、100%、マージ後が 72%、95% なら、保持率は 。元の平均精度は 83.5% で、用途が異なる。論文の 91.2% は専門モデルをどれだけ保ったかを測る値だ。
係数は検証データで 0~1 を 0.05 刻みに探索し、加算する全ベクトルで一つの を共有する。タスク別に選んだ際の組合せ爆発を避けるためだ。付録では 0.3~0.5 が多くの組合せでよいが、最適値は部分集合によって大きく異なる。使えるベクトルが増えても、すべてを入れるのが最良とは限らない。
強い基準もある。八タスクの全データで直接マルチタスク微調整すると正規化精度は 99.4% で、タスク算術の最良の 91.2% より高い。タスク算術の利点はモジュール性、各訓練データを再取得せずに済むこと、マージ時に訓練不要なことだ。データを集めて再訓練できるなら、マルチタスク微調整も優先して比較したい。
自然言語では、四つの GLUE タスクで T5-base を微調整し、Hugging Face の互換性ある公開 427 モデルのタスクベクトルを一つずつ加え、検証集合で最良のものと係数を選ぶ。他者のタスクのベクトルが、単純な微調整より対象タスクを改善する場合がある。
四タスクの平均は 78.1 から 78.6、MRPC は 88.5 から 89.3、残りは約 0.2~0.7 改善する。多くの候補を探し、有用なベクトルを選んだ結果だ。付録では公開 T5 checkpoint 六つのペアもマージし、質問応答、要約、感情、テキスト生成を扱う。指標は accuracy、exact match、ROUGE-2 と異なり、一つの精度で全テキストタスクをまとめられない。
類推で、対象ラベルなしでも学ぶ
Yelp と Amazon の例は、複数サイズの T5 で Amazon の感情データだけの微調整よりよく、対象データで直接微調整した結果に近づいた。感情分類ベクトルを大きく重みづけするとよいため、独立した二係数を使っている。
例えば Amazon を対象にする T5-base は、Yelp の感情ラベルだけの微調整が 90.8%、領域類推を加えると 92.7%、Amazon のラベルで直接微調整すると 93.2%。二つの言語モデルベクトルには、対象と補助の領域のラベルなしテキストが必要だ。対象ラベルがなくても、対象領域のデータは使っている。ラベルなしテキストから領域移動を推定し、学んだ感情分類方向を接続する方法だ。
別の実験では ImageNet と手描きスケッチで共通する 125 クラスを使い、「写真/スケッチ」×「二つのクラス群」の四群に分ける。「ライオンのスケッチ」のような群を改善するなら、
平均で事前訓練モデルより 3.4 ポイント高く、対象群の訓練標本を約百枚追加収集してラベルを付けるのと同程度の効果になった。
なぜ足せるのか
CLIP の九タスクのタスクベクトル間のコサイン類似度は、多くが 0.01~0.03 で、ほぼ直交する。高いのは意味的に近いタスクだ。数字を読む MNIST と SVHN は 0.18。数字の認識も必要な GTSRB は、この二つと 0.06。衛星画像の EuroSAT と RESISC45 は 0.05 になる。
著者らは、ほぼ直交することで加算時の干渉が少なくなると推測する。観察に基づく推測であり、後に Ortiz-Jimenez らは重みの「分離性」が重要だと解析し、事前訓練による性質で、ランダム初期化では得られないと論じた。
実装に役立つ観察も二つある。第一に、学習率が高いほど加算結果の劣化が速く、単一の微調整モデルより敏感だ。著者らはタスクベクトル用の微調整では控えめな学習率を勧める。第二に、ベクトルは微調整初期に最終方向へ収束し、数百ステップの中間ベクトルを加えるだけでも精度はほぼ飽和した。
制限
タスクベクトルは同じ構造でのみ使える。実験もすべて同じ事前訓練重みから始めている。
ただし、実用上の制約はそこまで厳しくないとも指摘する。執筆時点で、Hugging Face には同じ BERT-base の微調整モデルが三千以上、同じ T5-small 由来も八百以上あった。
結論
タスク算術は微調整結果をベクトルで表し、加算、減算、類推ができ、モデルの振る舞いもおおむね対応すると示した。
訓練には通常の微調整を使う。新しいのは、その結果の捉え方だ。後の TIES-Merging と DARE はこの枠組みから、加算時の干渉をそれぞれ扱う。
次に Hugging Face で、なじみのある基底から微調整したモデルを見つけたら、まず基底との差を取り、どんなベクトルになるか見てみよう。