原論文
Evolutionary Optimization of Model Merging Recipes
- arXiv への初回投稿
- arXiv:2403.13187
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingevolutionarymodelmerge2024,
  title = {{Evolutionary Optimization of Model Merging Recipes}},
  author = {Takuya Akiba and Makoto Shing and Yujin Tang and Qi Sun and David Ha},
  year = {2024},
  eprint = {2403.13187},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.13187}
}
2024 年初め、モデルマージはオープンソース界隈で大人気だった。Hugging Face の Open LLM Leaderboard 上位には、複数の微調整モデルを混ぜた版が並び、mergekit のような道具で CPU 上で新モデルを作れるようになった。
少し前の Stable Diffusion コミュニティも、同じ道を通った。論文によれば、愛好家が複数の画風モデルを混ぜた版は、一時コミュニティで最も人気のある選択肢になったという。
東京の Sakana AI の Takuya Akiba、Makoto Shing、Yujin Tang、Qi Sun、David Ha は、その熱気に一つの問題を指摘した。マージは「黒魔術や錬金術」と見られがちで、モデル選択、層ごとの比率、手法が作り手の直感に任されている。調整先も、たいていランキングの決まった評価項目だった。
そこで、配合を進化的アルゴリズムに任せようとした。
問題の定義
マージを互いに独立した二空間に分ける。
パラメータ空間(PS):各層の重みをどう混ぜるか。通常のモデルマージで、全ソースモデルの構造が同じである必要がある。
データフロー空間(DFS):各層の重みはそのままに、データが通る層を変える。例えば A の第 層を通った token を、次に B の第 層へ入れる。コミュニティの frankenmerge の積層に似ているが、推論経路全体を探索する。
どちらも巨大な空間だ。進化的探索で手作業よりよい組合せを見つけられるかを調べる。特に日本語と英語数学のような領域横断のマージでは、人にも調整方法がわかりにくい。
問題を解く
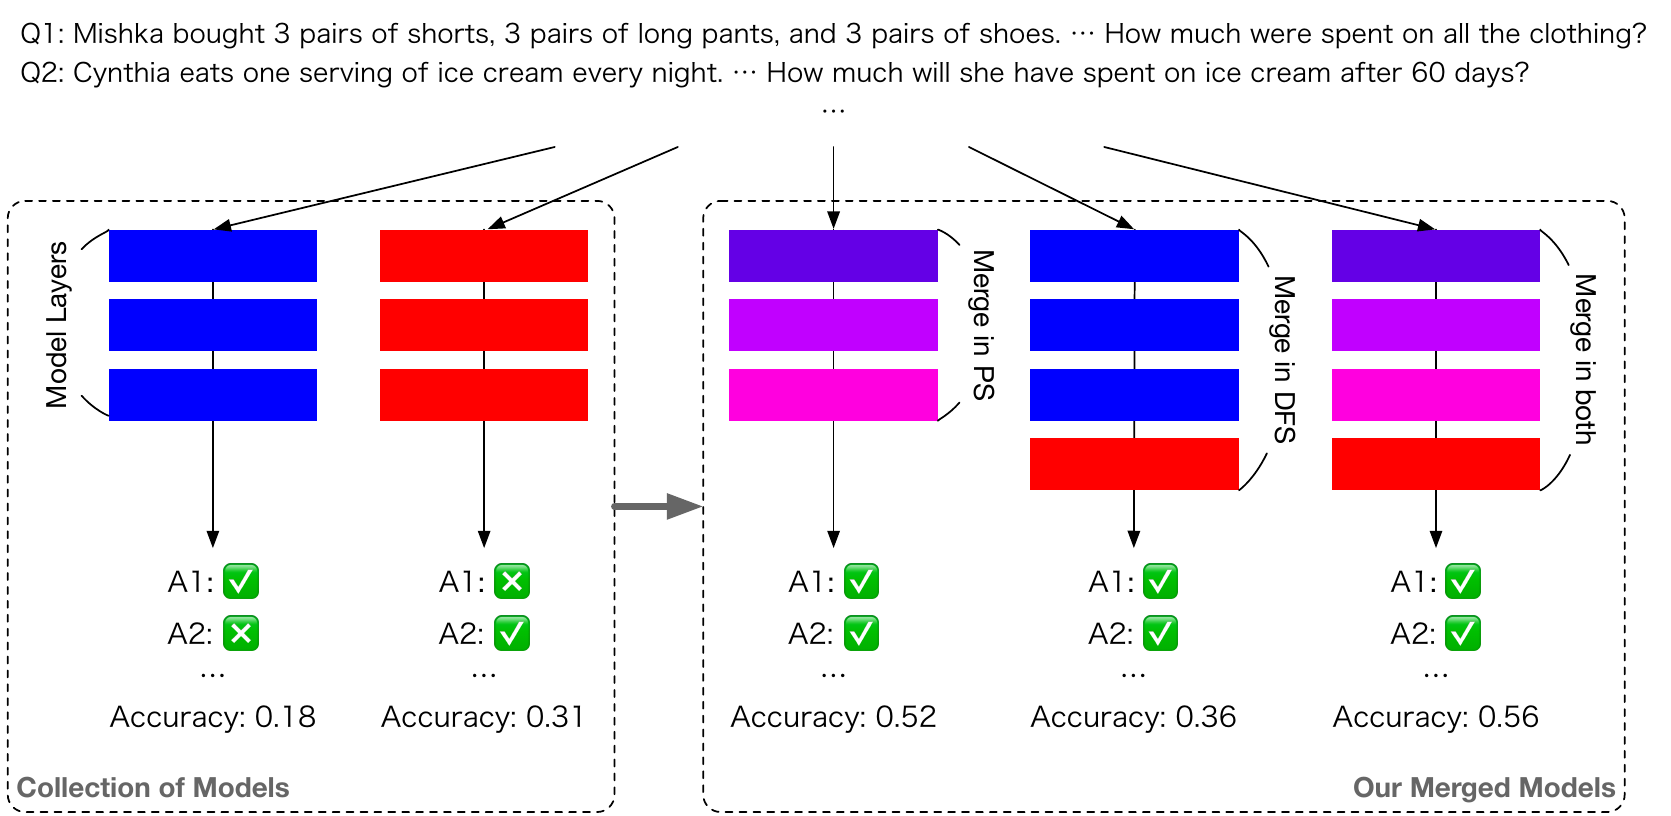
色のたとえがわかりやすい。PS は絵の具のように青と赤を紫へ混ぜる。DFS はブロックのように色を保ち、順番を並べ直す。
パラメータ空間で係数を選ぶ
PS は TIES-Merging と DARE を使い、入力・出力の埋め込み層と各 Transformer ブロックに、それぞれ疎化率と混合重みを持たせる。CMA-ES 進化戦略で調整し、数学の正答率など、対象タスクのスコアを適応度にする。
これは枠組みが許す細粒度の設定だ。主結果の配合はより単純で、ソースモデルごとに density と weight を一組だけ持ち、三モデルで計 6 変数を探索する。さらに細かい層分割も試したが、探索データ量の制約から明確な改善がなく、最も複雑な設定は主結果にしなかった。
density は DARE 後に残すタスク差分の割合、weight はマージへの寄与を制御する。見つかった三つの weight は近い値だが、和は 2 に近い。有効な解にはタスク変更量の拡大も含まれる。係数和を 1 に制限しないため、通常の凸結合を超えている。
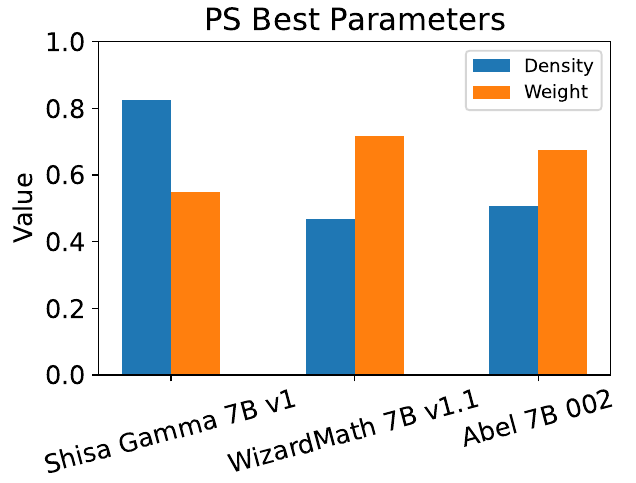
横軸が三ソース、青が保持率、橙が混合重みだ。日本語モデルは青が高く、差分をより多く残す必要がある。橙はどのソースもゼロ近くに抑えておらず、両方の専門性を利用している。
CMA-ES は探索分布から各ラウンドに複数の配合を引き、スコア順に並べ、分布の中心、尺度、方向を更新する。各候補は重みを混ぜた後、指定データで回答を生成して採点し、マージ後に勾配更新はしない。「答えの数字が正しく、かつ日本語」という離散指標でも直接探索できる。
データフロー空間で経路を選ぶ
DFS はさらに難しい。二モデルが各 32 層なら計 層。経路長 の各ステップで任意の層かスキップを選ぶと、空間は になり、探索しきれない。
予備実験では、前のほうの層の反復や順序変更は性能を落としやすかった。そこで全層を元の順序で並べ、それを 回反復した長さ の列を用意し、指示配列 で各位置を使うか決める。空間は となり、まだ巨大だが進化的探索で扱える。
別モデルの層から来る入力は、訓練時と分布が異なる。予備研究では隣接二層の交換だけでも性能が下がった。対策として第 層から第 層へ移るたびに入力へ尺度 を掛け、この行列も一緒に進化させる。
例えば A の 32 層と B の 32 層をつなぎ、3 回繰り返すと 192 候補位置になる。指示値が 0 より大きい位置だけを残す。同じ元の層を別の反復区間でも使える。最終経路は固定で、すべての token が同じ道を通り、入力ごとに専門家を選ぶ router はない。
A の tokenizer、入力・出力埋め込みを固定し、経路も A の最初の Transformer 層から始め、最後の層で終え、埋め込み空間との接続を保つ。同一モデル内で元々隣り合う層の尺度は 1 に固定し、モデル横断や層の飛び越しだけで調整する。hidden size などの接続面は一致する必要があり、DFS は層数と経路を自由にするが、接続面の互換性は必要だ。
下図は探索の初期、中期、終了時を並べる。横軸が実行ステップ、縦軸が元の層、青と赤が二ソースで、濃淡が尺度を表す。
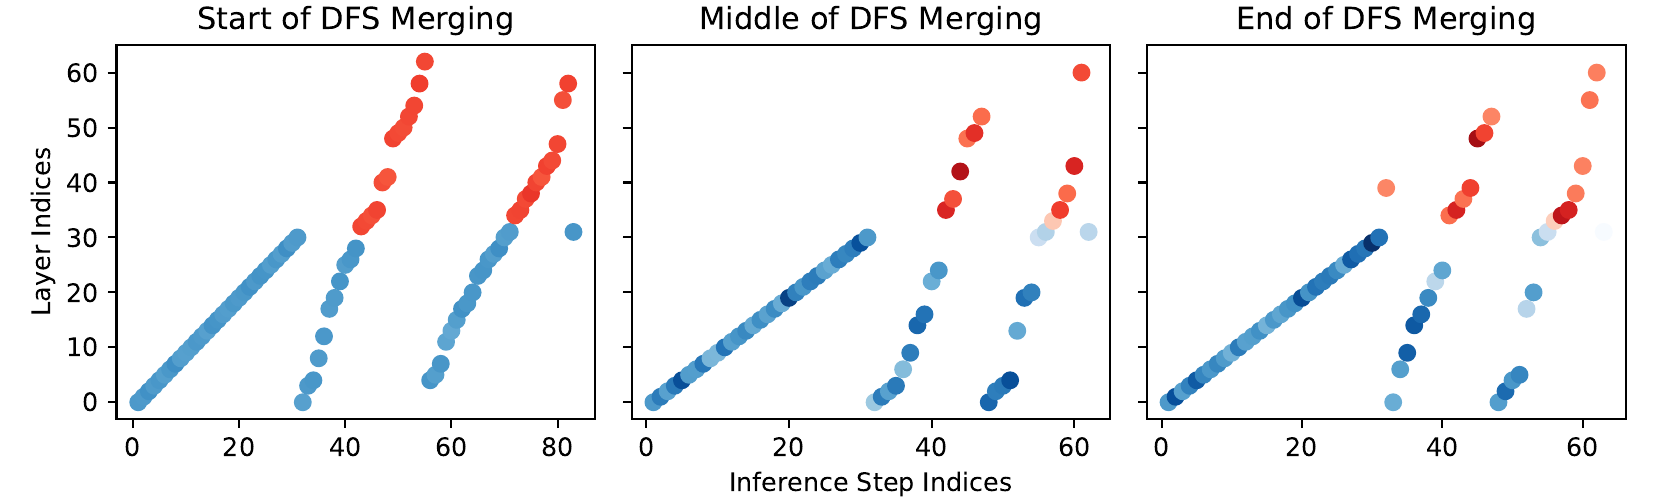
右の前半はほぼ青の連続層を使い、その後に赤と飛び越しが入る。これは PS マージモデルと日本語モデルをソースにした経路で、最終的に長い 10B ネットワークとなり、デプロイする構造自体が変わる。
両方を使う
PS で作ったモデルを候補集合へ戻し、続けて DFS を行えば、二種類を組み合わせられる。
議論
日本語の数学モデル
主実験は日本語で数学を解くモデルだ。ソースはすべて Mistral-7B-v0.1 由来で、日本語の Shisa Gamma 7B v1 と、英語数学の WizardMath 7B v1.1、Abel 7B 002 を使う。
MGSM 日本語テストの 250 問は、GSM8K テストの最初の 250 問の翻訳だ。最終数値が正しく、推論過程も日本語であることが正解の条件になる。探索には別途翻訳した GSM8K テストの ID 250~1318 の 1,069 問を使う(ID は 0 始まり)。最終評価とは重ならない。公開の数学モデルが訓練に使った GSM8K 訓練集合は、評価が不正確になるため翻訳しなかった。
| モデル | サイズ | MGSM-JA | JP-LMEH |
|---|---|---|---|
| Shisa Gamma 7B v1(日本語) | 7B | 9.6 | 66.1 |
| WizardMath 7B v1.1(英語数学) | 7B | 18.4 | 60.1 |
| Abel 7B 002(英語数学) | 7B | 30.0 | 56.5 |
| マージ:PS | 7B | 52.0 | 70.5 |
| マージ:DFS | 10B | 36.4 | 53.2 |
| マージ:両方 | 10B | 55.2 | 66.2 |
| Llama 2 70B | 70B | 18.0 | 64.5 |
| Japanese StableLM 70B | 70B | 17.2 | 68.3 |
| Swallow 70B | 70B | 13.6 | 71.5 |
| GPT-3.5 | – | 50.4 | – |
| GPT-4 | – | 78.8 | – |
原論文 Table 1 より整理。MGSM-JA は日本語数学の精度、JP-LMEH は日本語能力評価の平均スコア。
三ソースはいずれも不十分だ。日本語モデルは数学が弱く、数学モデルは日本語が弱いため、MGSM-JA はすべて 30 以下になる。
PS は 7B のまま 52.0 に達する。DFS も改善するが 36.4 で、10B に増える。両方なら最良の 55.2 で GPT-3.5 の 50.4 を少し上回るが、GPT-4 の 78.8 とは遠い。
総合日本語能力 JP-LMEH は PS が 70.5 で、Japanese StableLM 70B の 68.3、Llama 2 70B の 64.5 より高いが、Swallow 70B の 71.5 より低い。「以前の一部の 70B 日本語モデルを超える」は、この列の話だ。
問題別の正答も描いている。マージモデルはソースの解ける問題を保ち、三ソースすべてが誤る問題も一部解いた。付録には日本文化の知識と数学を同時に要する例がある。英語へ翻訳して英語数学モデルへ渡しても、背景を知らず誤る可能性があると著者らは考える。
手調整や微調整との比較
進化的探索の効果を見るため、同じソースから mergekit の三基準を作る。最適化せず、Maxime Labonne の Hugging Face ブログのよく知られた解説の設定を使った。
| 手法 | MGSM-JA | JP-LMEH |
|---|---|---|
| TIES-Merging(解説の既定値) | 4.4 | 63.7 |
| DARE-TIES(解説の既定値) | 35.2 | 66.3 |
| Frankenmerge 積層(解説の既定値) | 0.0 | 16.1 |
| 進化的マージ:PS | 52.0 | 70.5 |
| 進化的マージ:両方 | 55.2 | 66.2 |
| 同じ 1,069 問の LoRA/全パラメータ微調整の最良 | 43.2 | 55.9 |
原論文 Table 3 より整理。
既定値の TIES は数学能力をほぼ失い、積層版は一問も解けない。DARE-TIES は少しよいがソースをわずかに上回る程度だ。同じモデルと手法でも、配合次第で数十点違う。
微調整も届かない。探索と同じ 1,069 問で三ソースに LoRA と全パラメータ微調整を行い、最良でも 43.2。総合日本語能力も大きく落ちがちで、微調整には多くのデータが必要で、忘却もしやすいと著者らは考える。
無関係なモデルを候補へ加える実験もある。8 モデルを加えると PS の MGSM-JA は 50.0 から 40.8 に下がるが、全ソースより高い。
この実験は weight normalization を追加しているため、起点は 50.0 で主結果 52.0 とは分けて比べる。最大十一モデルのプールで選択負担が増えても使える結果を得る一方、手作業のモデル選びも重要だとわかる。
LoRA と全パラメータ微調整の比較はデータ量を固定し、三学習率を探し、3 epochs 実行する。1,069 問だけをどう使うとよいかには答えるが、各ソースの全訓練データを集め直した訓練との比較はない。その多くは非公開だ。探索も多くの評価を行うため、総計算量は一度の微調整と分けて考える必要がある。
なぜマージできるのか
三ソースが同じ Mistral-7B-v0.1 から始まる前提は見落としやすい。PS はやはりタスクベクトルの加算で、進化はその配合係数を探索する。
難しい点もある。Shisa Gamma 7B v1 の基底は 1,000 億の日本語 token で継続事前訓練され、元の Mistral との差が通常の微調整より大きく、疎化しにくい。delta が大きいほど破棄で干渉を減らしにくい、という DARE の観察と合う。
日本語の視覚言語モデル
同じ方法を VLM にも適用する。画像を視覚エンコーダへ入れ、射影ネットワークで言語モデルの表現へ変換し、言語モデルが回答する。前の二部品を固定し、LLaVA-1.6-Mistral-7B の言語モデル部分だけを Shisa Gamma とマージして EvoVLM-JP を作る。Mistral 基底を共有し、視覚エンコーダ自体は平均しない。
探索は Japanese Visual Genome の別の部分集合を使い、テストは一般 VQA の 500 問と、著者らが整理して人手で選別した日本文化の 42 画像・50 問に分ける。指標は日本語 ROUGE-L で、日本語以外の回答は原則 0。ただし参照回答自体が UFO のような一般的な外語略語を使う場合は例外がある。
| モデル | サイズ | JA-VG-VQA-500 | 日本文化場面 |
|---|---|---|---|
| LLaVA-1.6-Mistral-7B | 8B | 14.3 | 41.1 |
| Japanese Stable VLM | 8B | – | 40.5 |
| EvoVLM、PS | 8B | 19.7 | 51.2 |
| EvoVLM、DFS | 12B | 16.8 | 46.5 |
| EvoVLM、PS+DFS | 11B | 20.4 | 47.6 |
高いほどよい ROUGE-L。原論文 Table 5 より整理。Japanese Stable VLM は Japanese Visual Genome を訓練に使っているため、その列は評価しない。
一般 VQA の最良は PS+DFS、文化場面は PS だ。有利な深さや組合せはテストによって変わる。ROUGE-L は参照回答との文字列の重なりに言語条件を加えた指標で、文化理解の全側面を測るものではない。付録の鯉のぼりや信号の色の呼び方の例も見ると、どの回答が改善したかを補える。
経路と尺度の役割
Llama-2-13B の日本語・数学専門モデルにも適用する。ソースの MGSM-JA は 13.2%、8.0%、PS は 31.2%、PS+DFS は 34.0% で、後者は 21B になる。ソースよりよいが Mistral の 7B/10B より低く、元の能力の重要性がわかる。
DFS の初期順序も効く。13B で二ソースの順を逆にすると、テスト成績は 23.2% から 12.8% になる。最初に A の元の経路を残しやすく初期化すると、開始直後から乱れた文を出す候補を減らせるが、順序への偏りが生じる。空間を狭めた代償だ。
PS+DFS の層間尺度を外すと MGSM-JA は 26.4%、完全版は 34.0%。見つかったサイズも 19B と 21B で異なる。尺度整列の有用性を支えるが、全差を固定構造の一つの尺度の効果とはみなせない。ソースの微調整が長すぎ、表現差が大きいと、一つの尺度でも接続しきれないことを観察している。
コストと制限
訓練済みモデルを使い、能力を学び直す勾配訓練を省く。比較先の japanese-stablelm-base-gamma-7b は 1,000 億 token の日本語継続事前訓練に推定一万 GPU 時間以上を使うが、探索実測と同じハードウェアのコスト比較はしていない。
PS は 1,000 配合を試し、毎回全 1,069 問で適応度を求める。DFS は 128 候補、100 世代で、訓練部分集合の最後の 200 問を検証に残し、探索では各バッチ 200 問を評価する。前者は混合後に評価し、後者はソース層の保持と長い経路の実行も必要で、GPU メモリが増える。無関係モデルの DFS 実験は、この要件のため実施していない。大量の候補の生成と採点が高コストなのだ。
欠点も明記する。マージはソースの弱点を引き継ぎ、回答に論理的一貫性が欠けることがある。この研究では指示微調整やアラインメントも行わず、事実誤りのある出力も生じうる。
結論
直感で調整していた配合を、進化的アルゴリズムで探索する論文だ。PS は TIES と DARE を使い、主結果ではソースごとの density と weight だけを探索する。DFS は推論経路を組み直す。日本語数学では、単独では不十分な三つの 7B を混ぜ、GPT-3.5 を超えた。
コストも正確に見たい。マージ自体は訓練不要でも、探索には候補の反復評価が要る。PS は 1,000 試行で、毎回千問以上を採点する。タスクを変えれば探索もやり直す。
試すならソースを少数に絞り、モデル全体の density と weight から始め、探索に一切使わないテストデータを残そう。そこで利得が出てから、層別の自由度や DFS を増やせば、評価の追加コストで何を得たかが見えやすい。