原論文
Communication-Efficient Learning of Deep Networks from Decentralized Data
- 発表先
- AISTATS 2017国際会議
- arXiv への初回投稿
- arXiv:1602.05629
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingfedavg2016,
  title = {{Communication-Efficient Learning of Deep Networks from Decentralized Data}},
  author = {H. Brendan McMahan and Eider Moore and Daniel Ramage and Seth Hampson and Blaise Agüera y Arcas},
  year = {2016},
  eprint = {1602.05629},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1602.05629}
}
スマートフォンのキーボードで次の単語を予測するなら、最良の訓練データはユーザーが毎日打っている文字だ。
問題は、そこにメッセージや URL、さらにはパスワードまで含まれることだ。すべてをデータセンターへアップロードしてから訓練すれば、プライバシーのリスクは大きい。しかもチャットの言葉づかいは Wikipedia とはかなり違うので、公開コーパスで代用しても、ユーザーの実際の入力の癖は学べない。
2016 年、Google の McMahan、Moore、Ramage らは、データをスマートフォンに残したまま、各スマートフォンが「モデルをどう直すべきか」だけをサーバーへ送り返す方法を提案した。この訓練方式を連合学習(Federated Learning)と名づけ、FederatedAveraging という素朴なアルゴリズムを示した。後に略して FedAvg と呼ばれるものだ。
この論文はモデルマージの文脈でも重要だ。FedAvg は毎ラウンド同じことをしている。それぞれ訓練した多数の重みを、そのまま平均するのだ。論文には、これがなぜニューラルネットワークで成り立つのかを説明する小さな図があり、後のモデルマージ研究は何度もこの条件に立ち返る。
問題の定義
個のクライアント(client、例えばスマートフォン)があり、 番目のクライアントが 件のデータを持ち、合計 件とする。全データ上の平均損失を最小化したい。
はクライアント 自身のデータ上の平均損失だ。データをランダムにシャッフルして割り当てれば、各 の期待値は に等しい。これが通常の分散訓練の前提とする IID の状況である。
著者らは、連合学習がデータセンターと異なる点を四つ挙げる。
- Non-IID:各スマートフォンのデータは一人のユーザーに由来し、分布が全体と大きく異なる。
- 不均衡:毎日数千字打つ人もいれば、月に一度しか使わない人もいる。
- 大規模分散:参加するクライアントの数が、クライアントあたりの平均データ件数より多いこともある。
- 通信の制約:スマートフォンはよくオフラインになり、アップロード帯域は通常 1 MB/s に満たない。しかも充電中で従量課金のない Wi-Fi に接続しているときしか参加しないため、一日に参加できるのはせいぜい数ラウンドだ。
最後の点が、論文全体の測り方を決めている。スマートフォン上の計算は比較的安く、高くつくのは通信ラウンド数だ。そのため手法を比べる際に見るのは、目標精度に達するまでに何ラウンドの通信が必要かである。
目標は明確で、ローカルの計算を少し増やす代わりに通信ラウンドを減らすことだ。だがここに大きな問題がある。ニューラルネットワークの損失は非凸で、別々に訓練した二組の重みをそのまま平均すれば、理論上はひどいモデルになりうる。なぜ平均してよいのか。
問題を解く
FedSGD から始める
著者らはまず基準を定める。毎ラウンド、割合 のクライアントをランダムに選ぶ。選ばれた各クライアントは自分の全データ上の勾配 を計算し、サーバーは勾配をデータ量で加重平均して更新する。
これは大バッチの同期 SGD で、論文は FederatedSGD(FedSGD)と呼ぶ。 は毎ラウンドのグローバルなバッチサイズを決め、 ならフルバッチの勾配降下になる。
続いて著者らは、同じ更新を別の形で書く。各クライアントがまず自分の勾配で一歩進み、サーバーが重みを平均する。
二つの書き方は数学的に等価だ。どのクライアントも同じ から出発するので、重みの平均は勾配の平均に等しい。
二つ目の形にすると、次の一手は自然に出てくる。クライアントがすでにローカルで一歩進んでいるなら、何歩か多く進んでから報告してもよいのではないか。
FedAvg
FedAvg では、各クライアントがローカルで SGD を何周も回してから、重みをサーバーへ送り返して平均する。計算量は三つのパラメータで制御する。
- :毎ラウンド参加するクライアントの割合。
- :各クライアントがローカルデータ上で回すエポック数。
- :ローカルのミニバッチサイズ。 はローカルデータ全体を一つのバッチとして扱うことを表す。
件のデータを持つクライアントは、毎ラウンド 回のローカル更新を行う。、 なら、FedAvg は FedSGD に戻る。
サーバー側の流れをコードにすると、おおよそ次のようになる。
def fedavg_round(w, clients, C, E, B, lr):
    m = max(int(C * len(clients)), 1)
    selected = random.sample(clients, m)
    total = sum(c.num_examples for c in selected)

    new_w = zeros_like(w)
    for c in selected:
        w_k = client_update(c, w, E, B, lr)          # 同じ w から出発し、ローカルで E エポック回す
        new_w += (c.num_examples / total) * w_k      # 今ラウンドの参加者のデータ量で重みづけ
    return new_w
加重平均の分母は、今ラウンドに選ばれたクライアントのデータ総量 だ。このラウンドで三台が選ばれ、それぞれ 600、300、100 件のデータを持つなら、重みは 0.6、0.3、0.1 になる。データの多いクライアントほど、新しいモデルへの影響も大きい。
なぜ平均してよいのか
先ほどの疑問に戻ろう。著者らは小さな実験で答える。
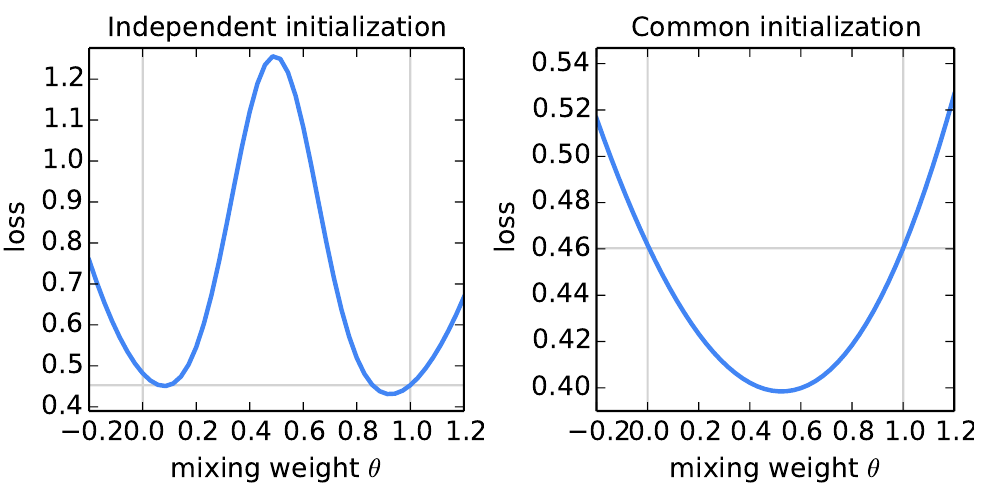
実験の設定は小さい。二つの多層パーセプトロン と を、それぞれ MNIST の互いに重ならない 600 件のデータで、学習率 0.1、バッチ 50 で 240 ステップ(20 エポック相当)訓練する。ローカルデータへの過学習が始まるくらいまで訓練した状態だ。次に、 の訓練集合全体での損失を、 を −0.2 から 1.2 まで動かして計算する。
まず左図。二つのモデルは異なる乱数シードで初期化され、両端の損失はどちらも 0.45 付近だが、中間の平均モデルは 1.2 以上に跳ね上がり、どちらよりも悪い。
次に右図。二つのモデルが同じランダム初期化から出発すると、曲線はお椀形になる。 の損失は約 0.40 で、二つの親モデルのそれぞれ約 0.46 より明らかに低い。二つの図は縦軸の目盛りが異なり、右図は曲線全体が低いことに注意したい。
FedAvg では毎ラウンド、すべてのクライアントが同じ から出発するので、ちょうど右図の状況に当たる。著者らはこれがあらゆるネットワークで成り立つとは証明していない。当時の過剰パラメータ化ネットワークの損失地形に関する観察を引用し、この図で直感を示しただけだ。
「共通の出発点を持つ重みはそのまま平均できる」という考えは、後に SWA、Model Soups、タスク算術などのモデルマージ研究に繰り返し現れ、条件も同じく出発点の共有である。
議論
実験設定
著者らは五種類のモデル、四つのデータセットで、二千を超えるモデルを訓練した。
- MNIST 2NN:各 200 ユニットの二層からなる多層パーセプトロン、パラメータ 199,210 個。
- MNIST CNN:5×5 畳み込み二層と 512 ユニットの全結合一層、パラメータ 1,663,370 個。
- Shakespeare LSTM:文字レベルの二層 LSTM、パラメータ 866,578 個。
- CIFAR-10:TensorFlow チュートリアルの小型 CNN、パラメータ約 個。
- 大規模な次単語予測 LSTM:語彙 10,000 語、パラメータ 4,950,544 個。
この論文の要はデータの分割方法だ。MNIST の IID 版はシャッフルして 100 クライアントに 600 件ずつ配る。Non-IID 版はまず数字ラベルで並べ替え、300 件ずつ 200 個に切り分けて、各クライアントが二つずつ受け取る。多くのクライアントは二種類の数字しか見ない。著者らが意図的に設計した極端な状況だ。
Shakespeare は現実に近い。著者らはシェイクスピア全集の各戯曲の各登場人物を一つのクライアントとし、全部で 1,146 個になる。台詞の多い人物と数行しかない人物の差は大きく、もともと不均衡かつ非 IID だ。
どの設定も学習率のグリッドを探索して最良の学習率を選び、学習曲線が目標精度を越えた時点のラウンド数を計算する。
並列度:何人集めるか
最初の実験では を固定し、毎ラウンドの参加割合 を変える。2NN、 の場合、IID データでは毎ラウンド 1 クライアントから (10 クライアント)にすると、97% の精度に達するまでのラウンド数が 316 から 87 に減る。非 IID データでは 3,275 から 664 になる。
では、 を増やす効果はずっと小さい。著者らは最終的に を以降の実験の既定値とし、計算効率と収束速度の釣り合う点だと考えた。
ローカルで多めに回す
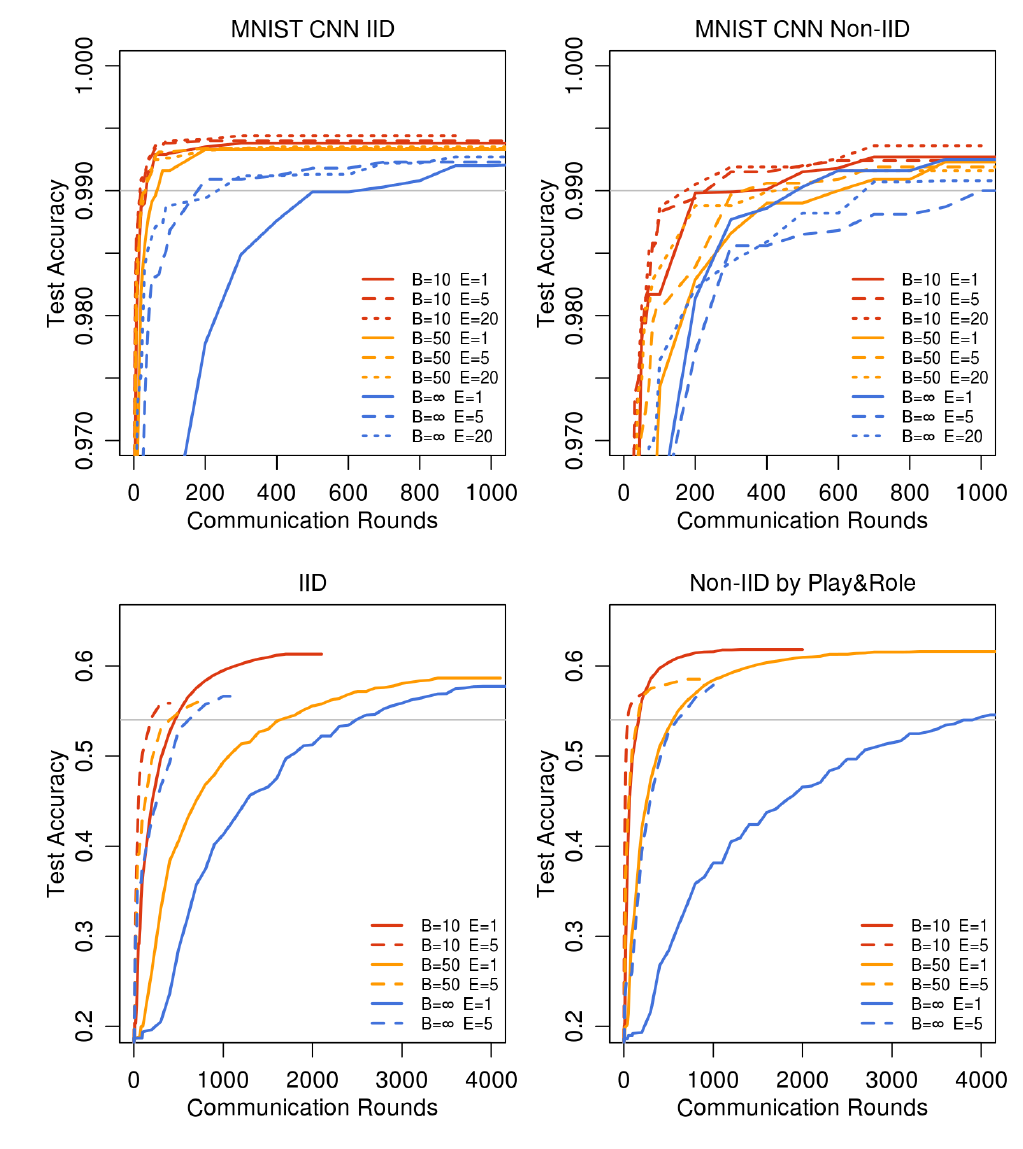
この図で見るべきは、青の実線と赤い線の距離だ。青の実線は 、、つまり FedSGD で、赤い線は 、毎ラウンドのローカル更新回数が最も多い。四つの図のどれでも、赤い線は青の実線よりずっと早く灰色の目標線を越える。
目標精度に達するまでの通信ラウンド数に換算すると、四つの設定のいずれでも FedAvg は何倍も速い。
- MNIST CNN、IID:FedSGD は 99% に達するまで 626 ラウンド、、 ならわずか 18 ラウンドで、34.8 倍速い。
- MNIST CNN、病的な非 IID:FedSGD は 483 ラウンド、最良の設定は 173 ラウンドで、2.8 倍速い。
- Shakespeare、IID:FedSGD は 54% に達するまで 2,488 ラウンド、、 では 192 ラウンドで、13.0 倍速い。
- Shakespeare、登場人物で分割:FedSGD は 3,906 ラウンド、同じ設定ならわずか 41 ラウンドで、95.3 倍速い。
二つ目は立ち止まって見る価値がある。各クライアントには二種類の数字しかなく、別々に訓練したモデルは大きく異なるのに、平均してもなお FedSGD より速い。著者ら自身も、平均が発散せずに何らかの利益をもたらすこと自体が驚きだと述べている。ただし高速化は 2.8 倍ほどにとどまり、表には FedSGD より遅い設定もある。例えば 、 は非 IID で 1,000 ラウンドかかる。
四つ目は逆方向の驚きだ。登場人物で分割したデータのほうが、IID 版より高速化が大きい。著者らは、一部の人物の台詞が多いため、ローカルで多めに訓練する価値が特に高いのだろうと推測する。あくまで推測で、論文はそれ以上検証していない。
ラウンド数だけでなく、FedAvg は最終的な精度も高い。MNIST CNN の FedSGD は 1,200 ラウンドで 99.22% に達し、6,000 ラウンドまで回してもそれ以上伸びない。、 の FedAvg は 300 ラウンドで 99.44% に届く。著者らはモデル平均に dropout に似た正則化効果があると推測するが、これも検証実験は示していない。
ローカルで計算しすぎるとどうなるか
が大きいほど、ローカルモデルはそれぞれのデータの最適解に近づく。問題が凸なら、 では出発点が関係なくなり、何ラウンド平均してもそれ以上は改善しない。
著者らは Shakespeare LSTM でも を大きく(最大 200 まで)した。 が大きすぎると、訓練損失は停滞し、発散することさえある。MNIST CNN では目立った劣化はなく、大規模な次単語予測タスクでは のほうが よりわずかによい。そこで著者らは、訓練の後半には学習率を減衰させるのと同じように、毎ラウンドのローカル計算量を減らすことを勧める。
ここが FedAvg で最もよく突っ込まれる点だ。クライアントはそれぞれ別の方向へ進み、遠くへ進むほど、平均した結果がグローバルな目的から外れやすくなる。
CIFAR-10 と実規模
CIFAR-10 では、50,000 枚の訓練画像を 100 クライアントに均等に配る。均衡した IID 設定だ。もう一つの基準として、データを分割せずにバッチ 100 で通常の SGD も行う。
80% の精度に達するまでの回数で見ると、SGD は 18,000 回の更新(連合設定ではそれぞれが一回の通信ラウンドに当たる)、FedSGD は 3,750 ラウンド、FedAvg はわずか 280 ラウンドだ。目標 85% では、SGD は 99,000 回、FedAvg は 2,000 ラウンドで、FedSGD は実験時間内に達しなかった。
最後は実規模の次単語予測だ。SNS の公開投稿 1,000 万件を投稿者ごとにまとめ、50 万を超えるクライアントを得る。毎ラウンド 200 クライアントが参加し、FedAvg は 、 を使う。FedSGD は 10.5% の精度に達するまで 820 ラウンドかかるが、FedAvg はわずか 35 ラウンドで、23 分の 1 になる。FedAvg は評価ラウンド間の精度のばらつきも小さい。
この論文がまだ答えていないこと
これらの実験はすべてシミュレーションだ。クライアント集合は固定、毎ラウンド同期、切断も悪意ある更新もない。著者らは最初から、こうした実務上の問題を範囲外としている。指標は通信ラウンド数で、実時間(wall-clock time)やスマートフォンの消費電力は直接測っていない。
収束性にも実験による証拠しかない。病的な非 IID では高速化が明らかに小さく、後続研究がこの問題をより細かく切り分けた。Zhao らの Federated Learning with Non-IID Data は、各クライアントが一クラスしか持たない極端な分割では精度が最大 55% 落ちることを見つけ、その原因をローカルの重みとグローバルな重みの乖離に帰した。SCAFFOLD は同じ現象を client drift と呼び、制御変量でローカル更新を補正する。Li らの収束解析は、強凸かつ平滑という仮定のもとで、非 IID では学習率の減衰が必要だと示した。
プライバシーについて論文が主張するのは、「データは端末から出ない」ことと「必要最小限の更新だけを送る」ことだ。差分プライバシーやセキュア集約(secure aggregation)の形式的な保証は与えておらず、著者らはこの二つを今後の課題としている。
結論
FedAvg のアルゴリズムは半ページに収まる。クライアントは同じ重みから出発し、ローカルで SGD を多めに回し、サーバーはデータ量で加重平均する。それで得られるのは、一~二桁少ない通信ラウンド数と、非 IID データでも訓練できるという実験的な証拠だ。
Google は後に、実際にこれを Gboard の次単語予測に使っている。
モデルマージの観点から振り返ると、やはり一番味わい深いのは、二組の重みを混ぜたあの小さな実験だ。独立に初期化した二つのモデルは平均したとたんに壊れ、同じ出発点から出たモデルは平均するとむしろよくなる。この条件は、その後何年もの重み平均研究にずっと付いて回る。
自分で試すなら、論文の勧めどおりまず を調整しよう。バッチがスマートフォンの並列演算を使い切れているうちは、小さくしても計算時間はほとんど増えない。 は欲張らないこと。ローカルで長く回しすぎると、どのスマートフォンもモデルを自分のデータのほうへ引っ張ってしまう。