原論文
Linear Mode Connectivity and the Lottery Ticket Hypothesis
- 発表先
- ICML 2020国際会議
- arXiv への初回投稿
- arXiv:1912.05671
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmerginglinearmodeconnectivity2019,
  title = {{Linear Mode Connectivity and the Lottery Ticket Hypothesis}},
  author = {Jonathan Frankle and Gintare Karolina Dziugaite and Daniel M. Roy and Michael Carbin},
  year = {2019},
  eprint = {1912.05671},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1912.05671}
}
初期重みとハイパーパラメータを固定して二度訓練しても、結果は異なる。各エポックのデータ順序や、データ拡張で選ぶ切り抜き、反転が変わるからだ。論文はこのランダム性をまとめて SGD ノイズと呼ぶ。
MIT の Jonathan Frankle、Element AI の Gintare Karolina Dziugaite、トロント大学と Vector Institute の Daniel Roy、MIT の Michael Carbin は、このノイズが何をどこまで変えるのかを調べた。二度の訓練結果は同じ解の二つの近似なのか、それとも異なる谷に入るのか。
Frankle と Carbin は 2018 年に宝くじ仮説(lottery ticket hypothesis)を提案し、小さなネットワークでは、初期化時点から単独で訓練して元と同じ精度に達する、非常に疎な部分ネットワークを見つけた。しかし ImageNet 規模では見つからなかった。論文の後半は、同じ道具でこの現象を説明する。
問題の定義
提案する道具は、不安定性解析(instability analysis)だ。
ネットワーク のある状態 を取る。ランダム初期化 でも、 ステップ訓練した でもよい。それを二つに複製し、異なる SGD ノイズで最後まで訓練して と を得る。そして、この二組の重みを関数で比較する。
比較には、両者の直線補間を使う。
は誤り率だ。直線上の最大誤り率から、両端の誤り率の平均を引いたものを、「誤りの障壁の高さ」とする。
高さが 0 に近ければ、両者は線形モード連結性(linear mode connectivity)を持ち、その状態は SGD ノイズに対して安定だとする。著者らは誤り率の差のしきい値を 2 ポイントとし、 は等間隔の 30 点で評価する。各設定で三つの初期化、それぞれ三つのデータ順序を試し、計九組を平均する。
例えば終点の誤り率が 8% と 10%、直線上の最大値が 45% なら、障壁は ポイントだ。最大値が 10% なら障壁は 1 ポイントで、安定のしきい値内に入る。この定義には端点自体の誤り率も入る。中点の高さだけでなく、両端のよさも見る必要がある。
また、30 点は実験での離散近似だ。測っているのは分類誤り率で、交差エントロピーの損失障壁とは関連するが、別の指標になる。予測クラスが同じでも、確信度は異なりうる。以下の「安定」は、この測定としきい値に従う。
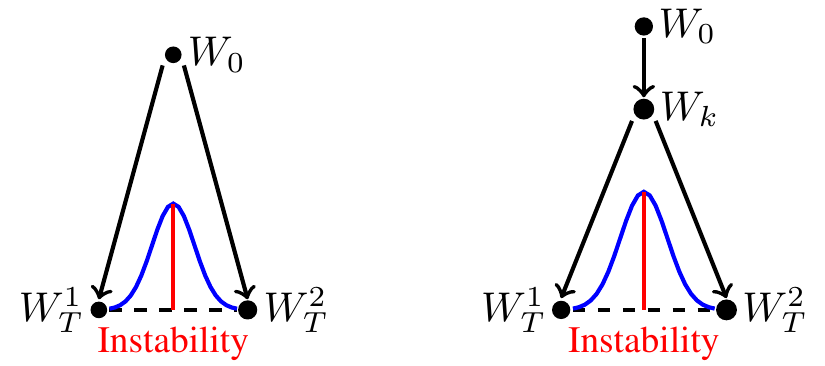
左は初期化直後に分岐し、右は ステップを共有してから分岐する。 を 0 から順に増やせば、ネットワークがいつ「落ち着く」のかがわかる。
問題を解く
初期化直後に分岐する
MNIST の LeNet、CIFAR-10 の ResNet-20 と VGG-16、ImageNet の ResNet-50 と Inception-v3、計五つを調べる。CIFAR の二つには、低学習率とウォームアップ付きの変種もある。
で複製すると、LeNet 以外はすべて不安定だった。二つの訓練結果を直線補間すると、訓練とテストの誤り率はいずれもランダム予測の水準まで上がる。LeNet も上がるが、1 ポイント未満だった。
同じ初期化でも、データ順序と拡張が異なるだけで、直線ではつながらない二つの谷へ入る。少し大きなネットワークでは、初期重みの一致だけでは足りない。
k を変えて調べる
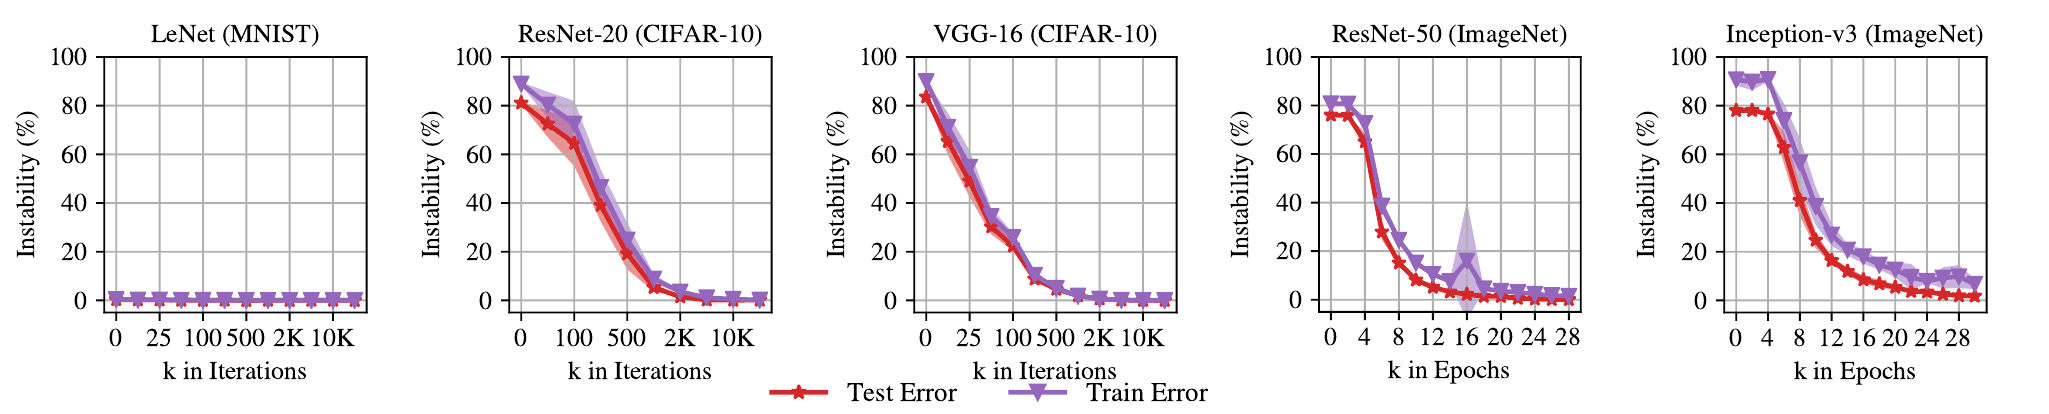
各図の横軸は複製前に訓練したステップ数、縦軸はテスト集合上の不安定性だ。LeNet 以外は高い値から下がり、0 付近で落ち着く。
しきい値を下回る時点はどれも早い。ResNet-20 は 2,000 反復、VGG-16 は 1,000 反復で、全訓練のそれぞれ 3% と 1.5% にすぎない。ImageNet では少し遅く、ResNet-50 は 18 エポック目(全体の 20%)、Inception-v3 は 28 エポック目(16%)になる。
この時点を過ぎると、実験で選んだ異なるデータ順序と拡張は、モデルを線形につながる領域へ導く。これは複数の訓練からの観察で、時点はアーキテクチャ、スケジュール、測定データによって変わる。
| 完全なネットワーク | 訓練の総長 | テスト不安定性が 2 ポイント未満になる開始点 |
|---|---|---|
| LeNet/MNIST | 24,000 回更新 | 初期化時から安定 |
| ResNet-20/CIFAR-10 | 63,000 回更新 | 約 2,000 回目、3% |
| VGG-16/CIFAR-10 | 63,000 回更新 | 約 1,000 回目、1.5% |
| ResNet-50/ImageNet | 90 epochs | 約 18 エポック目、20% |
| Inception-v3/ImageNet | 171 epochs | 約 28 エポック目、16% |
原論文 Figure 3 と訓練設定より整理。標準設定のみを示し、低学習率や warmup の変種は含めていない。
ImageNet にはもう一つ細部がある。テスト集合の障壁がしきい値内に入っても、訓練集合の障壁は少し高いことがある。ResNet-50 の訓練安定性はもっと遅く、Inception-v3 は調べた範囲では訓練安定性に達していない。「18 エポック目に落ち着く」には、テスト誤り率で測った、という条件が付く。
時間が短いだけか、本当に落ち着いたのか
一つの交絡が考えられる。 が大きいほど、複製後の残りステップ は短くなり、二つの結果が遠くまで離れる機会も減る。不安定性の低下は、訓練時間が短いせいなのだろうか。
著者らは複製後も必ず丸ごと ステップ訓練し、学習率スケジュールも最初から実行する対照実験を行った。ResNet-20 と VGG-16 では、両方の不安定性曲線がほぼ重なる。安定化は、残り時間の短縮では説明できない。
分岐時に学習が完了していた可能性も調べた。ResNet-20 の 2,000 回更新時のテスト誤り率は約 25% で、最終的に 8.3% まで下がる。VGG-16 は 1,000 回時点で約 20%、最終的には 6.3%。パラメータ空間でも、最終重みより初期化に近い。訓練はまだ長く続き、精度も改善する。安定性が表すのは、この後どの線形連結領域へ入るかだ。
議論
疎な部分ネットワークの成否
後半は宝くじ仮説に戻る。
証拠に使うのは反復的な重みの大きさに基づく枝刈り(iterative magnitude pruning、IMP)だ。ネットワークを訓練し、絶対値の小さい重みを刈り、残った重みを初期値に戻して訓練し直す。目標の疎性になるまで繰り返す。ImageNet の二つのネットワークは計算節約のため、一度で目標まで刈る。この部分ネットワークが完全なネットワークと同じ精度に達すれば、「matching」と呼ぶ。
LeNet では IMP の部分ネットワークが matching になるが、標準設定の ResNet-20、VGG-16 と ImageNet ではならない。ResNet-50 で重みを 30% だけ残すと、完全なネットワークは 76.1%、初期値へ戻した IMP の部分ネットワークは 73.7% で、ランダムな枝刈りとほぼ同じだった。
部分ネットワークを不安定性解析で調べると、二つの性質がよく対応する。初期化から matching になるものは、初期化から安定している。matching にならないものは、初期化からは不安定だ。
完全なネットワークが少し訓練してから安定するなら、枝刈り後に初期値でなく第 ステップへ戻してはどうか。すると、元は matching でなかった部分ネットワークが、少し後へ戻すだけで matching になった。その開始時点も、部分ネットワークが安定する時点とほぼ重なる。ResNet-50 と Inception-v3 の IMP 部分ネットワークは、それぞれ 5、6 エポック目で安定し、完全なネットワークの 18、28 エポック目よりずっと早かった。
宝くじ仮説の観察を ImageNet にまで広げられたが、「当たりくじ」が見つかるのは初期化時でなく、訓練の初期になる。
どの重みへ巻き戻すのか
操作として書くとわかりやすい。完全なネットワークの第 ステップの を保存し、残すパラメータを二値マスク で表す。毎回 から最後まで訓練し、訓練後の重みの絶対値で を更新する。現在生き残っているパラメータの最小 20% を刈り、同じ へ戻す。2 回後に残るのは で、毎回の 20% 削減の対象は、その時点で生き残るパラメータだ。
マスクは訓練の終点を見てから見つけるので、実験には複数回の訓練がかかる。早期の重みによい部分ネットワークが存在することは示せるが、実際の訓練時間を減らすには、マスク探索コストと疎な計算をハードウェアで高速化できるかを扱う必要がある。
対照群も有用だ。一つは IMP の層別残存率を保ったランダム枝刈り。もう一つは IMP のマスクを使い、残存重みだけを再ランダム初期化する。これで接続構造と対応する重みの役割を分けて調べられる。選んだ極端な疎性では、この種のランダム部分ネットワークの多くは、戻す時点を遅らせても不安定で、精度も低いままだった。
例えば標準 ResNet-20 は重みを 16.8% 残すと、IMP 部分ネットワークが約 500 回更新で安定する。VGG-16 は 1.5% を残し、約 1,000 回で安定する。ImageNet の二つはともに 30% を残し、安定開始は先ほどの 5、6 エポック目になる。疎な部分ネットワークが完全なものより早く安定することもあり、パラメータ数と安定性に単純な単調関係はない。
安定しても、小さすぎることはある
さらに CIFAR-10 で疎性を高めている。ResNet-20 は約 80.0%~13.4%、VGG-16 は約 16.8%~1.2% の重みを残す範囲で、完全なネットワークの精度に達する IMP 部分ネットワークが見つかる。それより減らすと、調べた巻き戻し時点では IMP でも matching が見つからない。
この疎性をまたぐ解析では、matching に約 0.2 ポイントの精度低下を許容する。極端に疎でも、安定化とともに誤り率は下がるが、容量が足りず完全なネットワークには追いつかない。安定性と訓練成功の関係は強いものの、すべての部分ネットワークが目標に達する十分条件としては使えない。
付録では 距離、コサイン距離、予測の不一致、標本ごとの損失差でも二つの終点を比較している。完全なネットワークのパラメータ距離は分岐時点とともに滑らかに下がり、安定点で突然ゼロにはならない。同じ領域の終点でも遠く離れうる。線形補間でわかるのは、間のパラメータ全体も使えるかどうかであり、二点の距離だけでは答えられない。
モデルマージへの示唆
この論文はモデルマージを扱ってはいないが、二つのモデルをいつ直接平均できるかという基本条件に触れている。
実験では二つの複製に同じデータとハイパーパラメータを使い、SGD ノイズだけを変える。訓練初期の一定期間を共有すれば、直線補間に障壁がなくなり、足して 2 で割っても高損失領域へ落ちない。
後の事前訓練と微調整は、共有する訓練経路を長くし、マージを研究するよい起点を与えた。ただし、微調整ではデータも目的も異なり、SGD ノイズだけを変えるこの実験の範囲を超える。足せるかどうかは、後続研究と実際の補間曲線で確かめる必要がある。
結論
この論文は「二度の訓練が同じ谷に入るか」を測れる問いにした。結果は、ごく小さなネットワークを除き、初期化からでは入らない。訓練の最初の 1.5%~20% を共有すると、その後は入るようになる。
同じ道具で宝くじ仮説も補強された。よい部分ネットワークが見つからない設定でも、訓練初期の重みへ巻き戻すと、見つかるようになった。
二つのモデルの重みを直接平均するなら、最後に同じ道を歩いたのはいつなのか、まず考えてみよう。