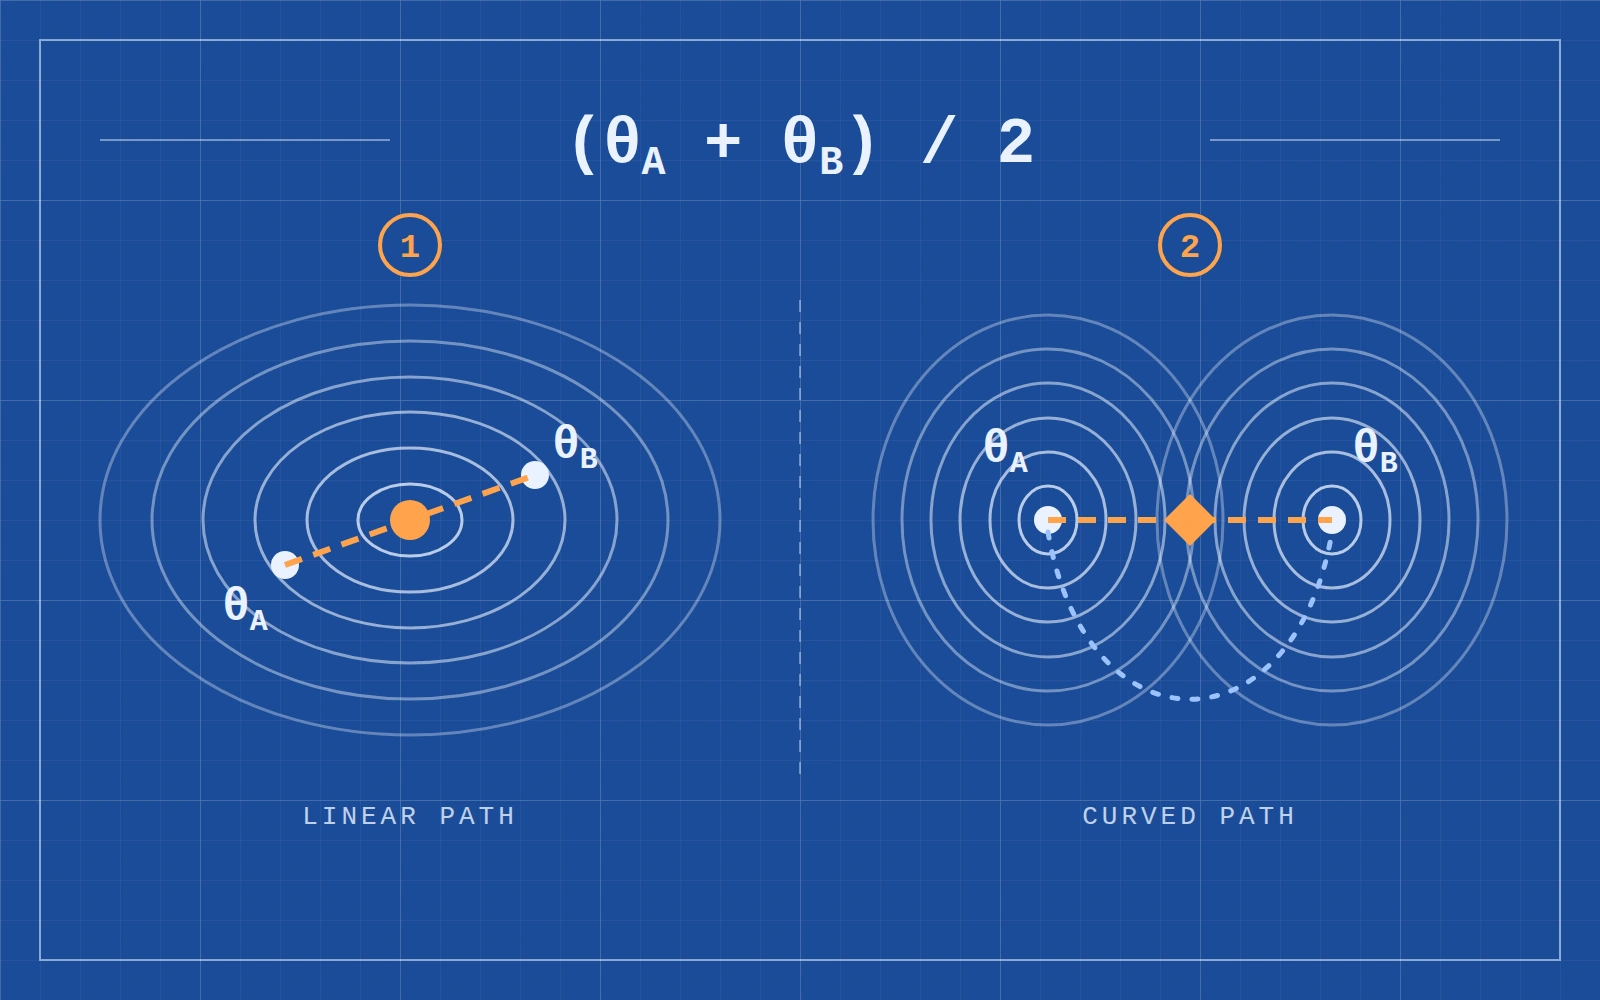
2016 年 2 月,Google 的 Brendan McMahan 等人把一篇论文放上 arXiv,提出后来称为 FedAvg 的联邦学习算法。每台设备用自己的数据训练模型,服务器只负责把收回来的权重平均。
这个做法有个明显的疑虑。神经网络的损失函数不是凸的,作者自己也写,在参数空间里平均两个模型,结果可能坏到任何程度。
于是他们先做了一个小实验。两个有两层隐藏层的 MNIST 分类器,各拿 600 张互不重叠的手写数字训练 240 步,再把两组权重按比例混合,看混出来的模型在整个训练集上的损失。
两个模型的初始权重若用不同的随机种子,混到一半,损失就冲得老高。改用同一个种子,平均出来的模型,损失反而比两个父模型都低。FedAvg Figure 1
先看作者实际量到的曲线。横轴是两组权重的混合比例,纵轴是在整个 MNIST 训练集上的损失;左右两张图的纵轴刻度不同。左图的中间鼓起一座山,右图的中间却低于两个端点。
这个观察只占论文第二节的一张小图。
八年后,Hugging Face 的 Open LLM Leaderboard 前排挤满了合并出来的模型。社群的教学文章说,合并是做新模型的便宜方法,「不需要 GPU」;到了 2024 年 3 月,排行榜团队已经把合并模型默认隐藏起来。
再过一年,Cohere 用加权平均把六个专家并成 1,110 亿参数的 Command A,和各自的专家相比,平均只掉了 1.8%。2026 年 4 月,DeepSeek-V4 也先训练一群专家,最后却选择用蒸馏把它们教进同一个模型;技术报告特别提到,这样可以避开权重合并常见的性能衰退。
这篇从那张小图出发。我们先在笔记本电脑上把两个模型平均一次,看它怎么坏、怎么修,再沿着时间往后走,看「相加除以二」怎么从联邦学习的一个小实验,变成排行榜上的炼金术,又怎么走进各家的训练流程。
前半段讲原理,看不同起点为什么不能平均,对齐与共同起点又各自怎么解决。
后半段讲应用,从微调模型的汤、任务向量,一路看到排行榜与各家的训练流程。
先在笔记本电脑上平均一次
我们照 FedAvg 的设置重做一次。MNIST 换成 scikit-learn 内置的 digits,1,797 张 8×8 的手写数字,不用另外下载。模型、学习率、批量大小与步数都照论文设置,两层各 200 个单元的隐藏层、学习率 0.1、批量 50,训练 240 步。
import torch
import torch.nn as nn
from sklearn.datasets import load_digits

X, y = load_digits(return_X_y=True)                    # 1,797 張 8×8 的手寫數字
X = torch.tensor(X / 16.0, dtype=torch.float32)
y = torch.tensor(y)
perm = torch.randperm(len(X), generator=torch.Generator().manual_seed(0))
idx_a, idx_b, idx_test = perm[:600], perm[600:1200], perm[1200:]

def make(seed):
    torch.manual_seed(seed)                            # 種子決定初始權重
    return nn.Sequential(nn.Linear(64, 200), nn.ReLU(),
                         nn.Linear(200, 200), nn.ReLU(),
                         nn.Linear(200, 10))

def train(model, idx, seed):
    opt = torch.optim.SGD(model.parameters(), lr=0.1)
    g = torch.Generator().manual_seed(seed)            # 種子決定資料順序
    for epoch in range(20):                            # 600 張、批次 50,共 240 步
        order = idx[torch.randperm(len(idx), generator=g)]
        for b in order.split(50):
            loss = nn.functional.cross_entropy(model(X[b]), y[b])
            opt.zero_grad()
            loss.backward()
            opt.step()
    return model
make 的种子决定初始权重,train 的种子决定数据顺序。两份训练数据各 600 张,互不重叠,剩下的 597 张留着测试。
接着写两个小工具。mix 按比例 混合两组权重:
就是相加除以二。evaluate 返回两份训练数据合起来的损失,以及测试集的准确率。
def mix(m1, m2, t):
    sd1, sd2 = m1.state_dict(), m2.state_dict()
    merged = make(0)
    merged.load_state_dict({k: t * sd1[k] + (1 - t) * sd2[k] for k in sd1})
    return merged

@torch.no_grad()
def evaluate(model):
    seen = torch.cat([idx_a, idx_b])                   # 兩份訓練資料合起來
    loss = nn.functional.cross_entropy(model(X[seen]), y[seen]).item()
    acc = (model(X[idx_test]).argmax(1) == y[idx_test]).float().mean().item()
    return f"loss {loss:.3f}, 測試 {acc:.1%}"

for name, seed_a, seed_b in [("不同起點", 1, 2), ("同一起點", 1, 1)]:
    A = train(make(seed_a), idx_a, seed=10)
    B = train(make(seed_b), idx_b, seed=20)
    print(name)
    print("  A   :", evaluate(A))
    print("  B   :", evaluate(B))
    print("  平均:", evaluate(mix(A, B, 0.5)))
不同起點
  A   : loss 0.264, 測試 92.1%
  B   : loss 0.270, 測試 93.0%
  平均: loss 1.277, 測試 83.4%
同一起點
  A   : loss 0.264, 測試 92.1%
  B   : loss 0.266, 測試 93.3%
  平均: loss 0.252, 測試 93.6%
不同起点的两个模型,测试准确率各有九成二、九成三,平均之后掉到 83.4%,损失从 0.27 左右跳到 1.277。
同一起点的那组,平均出来的模型损失 0.252,比 A 的 0.264 和 B 的 0.266 都低;测试准确率 93.6%,也比两个父模型高。两个模型各自只看过一半的数据,平均之后,在两份合起来的训练数据上比它们都好。我们在小数据上重现了 FedAvg 那张图右半边的趋势。
不过这里只做一次分开训练、一次平均。完整 FedAvg 会把平均后的模型再送回设备,各自更新几步,再收回来依数据量加权,反复进行。这个小实验用等量数据,所以相加除以二就够;设备数据量不同时,权重比例也要跟着变。先把这一轮算懂,再看多轮联邦训练会比较清楚。
把 从 0 扫到 1,画成曲线更清楚:
换五组种子重做,结论都一样。五组平均起来,父模型的测试准确率是 92.9%;不同起点直接平均,掉到 80.2%;同一起点平均,是 93.6%。换一台机器或另一个 PyTorch 版本,小数点后的数字可能略有不同。
同一个网络,换个顺序
不同起点为什么不能平均?先看一个更极端的例子。
隐藏层里的 200 个单元没有固定的顺序。把第 3 号和第 7 号单元对调,只要下一层读取输入的位置也跟着对调,整个网络算出来的东西完全一样。权重矩阵的行换了位置,函数没有变。
这种排列的对称性,1990 年 Hecht-Nielsen 就讨论过。Git Re-Basin §1
我们的网络有两层、各 200 个单元,光是这样换位,就有 种写法,大约是 ,每一种都是同一个模型。
那就拿模型 A 和「打乱顺序的 A」来平均:
def permute(model, p1, p2):
    sd = {k: v.clone() for k, v in model.state_dict().items()}
    sd["0.weight"], sd["0.bias"] = sd["0.weight"][p1], sd["0.bias"][p1]  # 第一層的 200 個單元換位
    sd["2.weight"] = sd["2.weight"][:, p1]                              # 下一層讀輸入的順序跟著換
    sd["2.weight"], sd["2.bias"] = sd["2.weight"][p2], sd["2.bias"][p2]  # 第二層的 200 個單元換位
    sd["4.weight"] = sd["4.weight"][:, p2]
    out = make(0)
    out.load_state_dict(sd)
    return out

A = train(make(1), idx_a, seed=10)
g = torch.Generator().manual_seed(100)
A2 = permute(A, torch.randperm(200, generator=g), torch.randperm(200, generator=g))

print(torch.allclose(A(X), A2(X), atol=1e-5))         # 每一張圖的輸出都一樣嗎?
print("A   :", evaluate(A))
print("A2  :", evaluate(A2))
print("平均:", evaluate(mix(A, A2, 0.5)))
True
A   : loss 0.264, 測試 92.1%
A2  : loss 0.264, 測試 92.1%
平均: loss 1.215, 測試 84.3%
True 表示 1,797 张图的输出都相同,误差在十万分之一以内,两者的准确率也都是 92.1%。可是相加除以二,就掉到 84.3%。
同一个模型跟自己平均也会坏,问题出在对位。平均是逐个位置做的,A 的第 3 号单元,会和 A2 排在第 3 号的单元平均;后者其实是 A 的另一个单元,负责的是另一种特征。两个不相干的特征检测器各取一半,得到的检测器往往两边都不像。
不同种子训练出来的两个模型,情况差不多。它们可能学到了相似的特征,只是摆在不同的位置。
先对齐,再平均
既然是顺序的问题,就先把顺序排好。2021 年,Entezari 等人提出一个大胆的猜想,只要把所有换位的可能都考虑进去,SGD 找到的解之间,沿直线混合多半不会遇到障碍。Entezari 等人
2022 年的 Git Re-Basin 提出了找排列的方法,其中最简单的一种叫权重匹配(weight matching),不需要任何数据。对每一层,计算 A 和 B 每一对单元有多像,再解一个线性指派问题(经典解法是匈牙利算法),找出总相似度最高的一对一配对。比较的是单元的输入权重、偏置,以及它送往下一层的权重。两层的排列互相牵动,所以来回多做几轮。
from scipy.optimize import linear_sum_assignment

def match(ref, other, iters=20):
    a, b = ref.state_dict(), other.state_dict()
    p1, p2 = torch.arange(200), torch.arange(200)
    for _ in range(iters):
        # 第一層:比對每個單元的輸入權重、偏差,以及它送往下一層的權重
        s1 = (a["0.weight"] @ b["0.weight"].T
              + torch.outer(a["0.bias"], b["0.bias"])
              + a["2.weight"].T @ b["2.weight"][p2])
        p1 = torch.as_tensor(linear_sum_assignment(s1.numpy(), maximize=True)[1])
        # 第二層:同樣的比對,輸入端改用剛排好的 p1
        s2 = (a["2.weight"] @ b["2.weight"][:, p1].T
              + torch.outer(a["2.bias"], b["2.bias"])
              + a["4.weight"].T @ b["4.weight"])
        p2 = torch.as_tensor(linear_sum_assignment(s2.numpy(), maximize=True)[1])
    return permute(other, p1, p2)

A = train(make(1), idx_a, seed=10)
B = train(make(2), idx_b, seed=20)
B2 = match(A, B)
print(torch.allclose(B(X), B2(X), atol=1e-5))         # 換位不改變 B 的功能
print("直接平均  :", evaluate(mix(A, B, 0.5)))
print("對齊後平均:", evaluate(mix(A, B2, 0.5)))
True
直接平均  : loss 1.277, 測試 83.4%
對齊後平均: loss 0.383, 測試 91.6%
换位之后,B2 的输出和 B 完全一样;拿去跟 A 平均,测试准确率从 83.4% 回到 91.6%,损失从 1.277 降到 0.383。前面那张图里的浅蓝线就是这一组,中间的山矮了很多。
五组种子的平均,是从 80.2% 回到 92.2%。对齐救回了大部分,但还差同一起点的 93.6% 一点,损失也没有低过两个父模型。
Git Re-Basin 在更大的模型上看到类似的趋势。CIFAR-10 上,把 ResNet-20 加宽到 32 倍,两个独立训练的模型对齐后可以做到零障碍,作者说这是他们所知的第一次;ImageNet 上标准宽度的 ResNet-50,障碍降了 67%,没有归零。网络越宽,对齐之后越容易连通。Git Re-Basin
这组插值曲线把成功和限制放在同一排。灰色是直接混合,绿色是 weight matching;第三张加宽的 ResNet-20 几乎拉平,最右边标准宽度的 ResNet-50 仍留下隆起。实线量训练损失,虚线量测试损失,不能只看其中一条。
CIFAR 那组还把归一化换成 LayerNorm;ImageNet 保留 BatchNorm,插值后重新估计统计量。对齐时得一起处理偏置、归一化与残差分支,单纯把每层的行排序完,还不算完成。刚才的 MLP 没有这些组件,才适合用几十行程序走完。
这条路走得通,但每一层都要解一次配对问题,网络还得够宽。
从同一个起点出发
另一条路省下了先找排列的步骤,让两个模型共用一段训练路径。
FedAvg 用的就是同一组初始权重。2019 年,Frankle 等人把这件事做成系统化的测试。同一个网络复制两份,用不同的数据顺序和数据增强继续训练,再看两个结果之间沿直线有没有障碍。他们发现,只有最小的 MNIST 网络从初始化开始就没有障碍;其他网络要先一起训练一小段,CIFAR-10 上的 ResNet-20 大约是全程的 3%,ImageNet 上的 ResNet-50 是 20%。过了那个点,在抽样的多组训练里,终点会落进线性连通的区域。Frankle 等人 §1
他们量的「稳定」是两个终点之间的最高错误率,扣掉两端平均,低于 2 个百分点。ResNet-20 刚达到这个条件时,测试错误率还约 25%,最终可以降到 8.3%。网络还没有学完,只是后续训练的终点已经比较容易直接混合。共享初始化、共享一段已训练的路径,两者的效果要分开看。
把复制的时间点沿横轴往后推,就得到下面五张图。纵轴是不稳定度,红线看测试集、紫线看训练集;MNIST 的 LeNet 一开始就贴近零,其他模型要先共享一段训练。前三张用 iteration,后两张用 epoch,时间单位也要一起读。
我们的小 MLP 大概也属于最小的那一类;前面的实验里,同一个种子就够了。
不同的谷之间也未必隔绝。2018 年,Garipov 等人和 Draxler 等人分别发现,独立训练的两个解之间,可以找到一条损失几乎不变的弯曲路径;只是走直线,中间就会撞上高墙,就像上图右边那条虚线。Garipov 等人、Draxler 等人
原图里的色阶才是实际量到的损失。左边三个独立解之间,直线会穿过高损失区;中间的 Bezier 曲线和右边的折线,则沿着低损失区把两端接起来。这里多出来的是一条训练得到的路径,两端中点的位置没有跟着移动。
同一年,Garipov 的共同作者 Izmailov 等人提出 SWA。他们平均的是同一次训练里的多个时间点。学习率保持在较高的常数或循环变动,让 SGD 在谷底附近来回走,再把走过的权重等权平均。论文提到,沿着 SGD 轨迹维持权重平均的想法,可以追溯到 Ruppert 1988 年的工作。ImageNet 上的 ResNet-50,从训练好的模型再用 SWA 多跑 10 个 epoch,top-1 从 76.15% 升到 76.97%;作者认为,平均点落在更平坦的区域,泛化因此比较好。SWA Table 2
下面的 CIFAR-100/ResNet-164 切面让这个解释具体一些。左图的三个叉号是 FGE 样本,平均点落在中间;中图看测试错误率,右图看训练损失。SGD 和 SWA 在两张图里的相对表现不同,训练损失最低的位置,未必也是测试错误率最低的位置。
这三件事其实分工不同。模式连通告诉我们能绕着走,找弯曲路径仍然要训练;线性模式连通要求两点之间那条直线也走得通,才直接关系到权重平均;SWA 则沿同一条轨迹收集近邻,把部署模型收成一份。若中间只是有一条弯曲通道,取两端的平均仍然可能掉到通道外。
SWA 还给了一个「平均为什么像集成」的局部解释。令几个 checkpoint 的平均为 ,每个偏移是 ,因此 。在平均附近展开网络输出:
中间的一次项刚好相消,输出集成与平均权重的差,剩下二阶项。这就是近邻 checkpoint 有机会用单一模型近似集成的原因。点离得太远、附近非线性太强时,二阶项就不能忽略;BatchNorm 的统计量也得对应平均后的模型重新估计。先确认近、确认沿线好用,这个推导才接得上实现。
让「同一个起点」变得随处可得的,是预训练模型。2020 年,Neyshabur 等人观察到,从同一个预训练权重出发微调的多个模型,会留在损失地形的同一个盆地里,特征相似,参数也靠得很近;从随机初始化训练的模型就没有这个性质。Neyshabur 等人
大家都从同一个 CLIP、同一个 Llama 出发,微调出来的模型自然是同一个起点的兄弟。模型合并的主战场,从这里开始转向微调。
一锅汤
训练模型的标准流程,是用不同的超参数训练一批,挑验证集上最好的一个,其余的丢掉。
2021 年的 WiSE-FT 先做了一个简单的版本。CLIP 的零样本模型在各种分布偏移下都还算稳;微调之后,ImageNet 变强了,遇到偏移的数据却变差。WiSE-FT 把零样本与微调后的两组权重线性混合,在 ImageNet 衍生的五个分布偏移数据集上,比先前的方法高 4 到 6 个百分点,ImageNet 本身也多了 1.6 个百分点,推理成本不变。WiSE-FT
六个数据集的系数曲线可以直接看。横轴 是零样本模型, 是微调模型,粉红线是两组权重之间的模型;水平点线标出两端较好的成绩。好几个数据集的最佳位置落在中间,但位置各不相同,没有一个系数能自动包办所有分布。
2022 年的 Model Soups 把对象换成「被丢掉的那一批」。作者用随机搜索的超参数,把 CLIP ViT-B/32 在 ImageNet 上微调了 72 次,结果如下:
- 最好的单一模型:80.38%
- 72 个全部平均(uniform soup):79.97%,比最好的那个还差
- 贪婪汤(greedy soup):81.03%
- 72 个模型的输出集成:81.19%,但推理要跑 72 次
这几个数字在原表的 ImageNet 列。右边的 Dist. shifts 是五个分布偏移数据集的平均,uniform soup 在那一列反而高于 greedy soup。挑模型用哪份验证数据,会改变最后比较擅长哪一种测试。
贪婪汤的做法很朴素。先把模型按验证集准确率排好,从最好的开始,一个一个试着加进锅里,验证集变好就留下,变差就跳过。有些超参数(例如太大的学习率)会让模型跑到别的盆地,全部平均就会被拖累,贪婪汤会把它们挡在锅外。
这锅 CLIP 最后留下 5 个成员。汤里已有 个模型时,新候选是 ,逐次各取一半会让越晚进来的模型权重越大。配方在从 ImageNet 训练集留出的约 2% 数据上挑选,官方 validation 仍留作测试。每次尝试都要评一个新候选,只是不用再做反向传播。
贪婪汤保证的是这份选模数据上不退步,测试集仍要另外量。输出集成还有概率校准较好的优势,模型汤在论文的校准实验里没有同样收益。因此只需要一个模型、重视分类准确率时,汤很吸引人;若要用输出概率决定拒答或人工复核,也要把校准列入比较。
在 JFT-3B 预训练的 ViT-G/14 上,贪婪汤从 58 个微调模型里挑了 14 个,ImageNet 达到 90.94%,超过当时最好的 CoAtNet-7(90.88%),推理的计算量还少了 25%。Model Soups Table 1、Table 3
这一锅汤里,每个模型做的是同一个任务。下一步,是把不同任务的模型放进同一锅。
任务向量
2022 年底,Ilharco 等人把微调看成一个方向。预训练权重是 ,在任务 A 上微调后是 ,两者相减:
叫任务向量(task vector),记录为了任务 A,每个权重往哪里移、移了多少。有了它,就可以做算术:
几个任务的向量加起来,尝试让一个模型同时处理这些任务;把某个向量取负号再加,则测试能否降低对应能力、同时保留其他行为。系数 用保留的验证数据来挑。
论文用 CLIP 在八个图像分类数据集上做实验,从汽车型号、纹理、卫星图像到门牌数字都有。两个任务的向量相加,在这两个任务上平均保留专家 98.9% 的准确率;八个向量都可供选择时,找到的最佳多任务模型是 91.2%。直接用八个任务的数据做多任务微调则是 99.4%,合并省下重新训练与取得原始数据的需求,也留下了能力差距。Task Arithmetic §4、附录 D
这张 ViT-L/14 图的纵轴,是把八个任务各自除以单任务专家的准确率,再取平均;淡点是不同向量子集,深色折线是同一数量下的平均。加入更多任务向量,整体能力往上走,但距离每个任务都由专家自己处理的 1.0,还有一段距离。
减法也有效。把 GPT-2 Large 在有毒留言上微调的任务向量减掉,固定提示下的 1,000 段生成中,被毒性分类器判定为有毒的比例从 4.8% 降到 0.8%,WikiText-103 困惑度从 16.4 到 16.9。这是在指定评测中改变行为,若要确认某笔信息已从模型移除,还需要另一套验证。Task Arithmetic §3
加法为什么行得通?2023 年,Ortiz-Jimenez 等人认为关键在权重的「解耦」,也就是不同任务的向量,影响的是输入空间里互不重叠的区域,加在一起才不会互相干扰。他们把同样的实验搬到随机初始化的 ViT 上,任务向量加起来,多任务的准确率和乱猜差不多。这组对照支持预训练为任务解耦提供了结构。Ortiz-Jimenez 等人 §6.2
所以任务算术的前提和 FedAvg 那张图一样,大家得从同一个起点出发,而且这个起点最好是预训练过的。
相同起点提供共同坐标,任务向量仍会在各个位置重叠。原论文量到,多数 CLIP 任务向量的余弦相似度只有 0.01 到 0.03,MNIST 与 SVHN 这种相近任务则较高,约 0.18。接近正交有助理解干扰为何可以较小,却还要看每个改动如何影响实际输出。后面的 TIES 正是在处理整体任务向量接近正交、局部参数仍冲突的情况。
参数打架
前面的 91.2% 是相对专家的保留率。再看另一组较小的模型设置,TIES-Merging 论文的 CLIP ViT-B/32,在八个任务上各自微调,平均准确率是 90.5%;用任务算术合成一个模型,就算用验证集挑系数,也只有 70.1%。这组原始准确率显示,同时保住八种能力仍有很大难度。TIES-Merging Table 1
先沿着原表的 ViT-B/32 列往下读。90.5 是专家各自上场,70.1 是有验证集的任务算术,TIES 到 73.6。上半与下半的 Validation 列不同,70.1 和上半的 60.4 来自不同的选系数条件,不能混成同一条比较线。
TIES-Merging 的作者 Yadav 等人认为,损失来自两种干扰。第一种是冗余,微调时很多参数只动了一点点,这些小变化对任务几乎没有贡献,加总时却会稀释别人的大变化。第二种是正负号冲突,同一个参数,任务 A 要它变大,任务 B 要它变小,直接相加就互相抵消。他们统计过,只合并两个模型就会有冲突,模型越多,冲突的参数越多。TIES-Merging §3
拿三个任务、六个参数的小例子算一次,数字是为了示范编的:
import numpy as np

tau = np.array([[ 0.8, -0.1,  0.5,   0.02, -0.6, 0.3 ],   # 任務 A
                [-0.7,  0.4,  0.6,  -0.03,  0.1, 0.05],   # 任務 B
                [ 0.9, -0.2, -0.05,  0.01, -0.5, 0.4 ]])  # 任務 C

print("直接平均:", tau.mean(0).round(3))

# 1. Trim:每個任務只留絕對值最大的一半
k = tau.shape[1] // 2
cut = np.sort(np.abs(tau), axis=1)[:, -k][:, None]
trimmed = np.where(np.abs(tau) >= cut, tau, 0.0)
print(trimmed)

# 2. Elect:每個參數用剩下數值的總和投票,決定正負號
sign = np.sign(trimmed.sum(0))

# 3. Merge:只平均和投票結果同號的值
agree = (np.sign(trimmed) == sign) & (trimmed != 0)
ties = (trimmed * agree).sum(0) / np.maximum(agree.sum(0), 1)
print("TIES    :", ties.round(3))
直接平均: [ 0.333  0.033  0.35   0.    -0.333  0.25 ]
[[ 0.8  0.   0.5  0.  -0.6  0. ]
 [-0.7  0.4  0.6  0.   0.   0. ]
 [ 0.9  0.   0.   0.  -0.5  0.4]]
TIES    : [ 0.85  0.4   0.55  0.   -0.55  0.4 ]
先看第 0 个参数。A 和 C 都要它变大(+0.8、+0.9),B 要它变小(−0.7),直接平均只剩 0.333。TIES 先让三个任务投票,总和是正的,就只平均同号的 A 和 C,得到 0.85。
第 1 个参数是冗余的例子。只有 B 认真改了它(+0.4),A 和 C 只动了 −0.1、−0.2,平均后被抵消成 0.033。把这些小值修剪掉,B 的 0.4 就留了下来。第 3 个参数,三个任务都只动了零点零几,修剪后干脆归零。
方法的名字就来自这三步,修剪(Trim)、选出正负号(Elect sign)、只合并同号的值(Merge)。论文里每个任务保留绝对值最大的 20%,作者事先确认过,只留两成的任务向量,单一任务的表现和全部保留差不多。合并完一样乘上系数 ,再加回预训练权重。
第 2 步看的是正负总量, 遇到两个 ,仍然选正。最后也只除以这一格留下的同号成员数,被修剪成 0 的成员不算。原论文用来支持「留两成就够」的是 T0-3B 的参数高效微调实验,再把这个配方拿去测全参数的 T5 与 CLIP;自己的任务最好仍扫一次保留比例。
ViT-B/32 的八个任务上,有验证集时,TIES 是 73.6%,比任务算术的 70.1% 高;没有验证集时是 72.4%,任务算术只有 60.4%。离各自微调的 90.5%,仍然差了一大截。
作者还做了一个上限实验,从已训练的多任务模型取出符号,代替 TIES 的总量投票。十一个参数高效微调任务上,这样合并是 72.0%,多任务模型是 73.1%,原本 TIES 是 66.4%。方向选得更好,确实有很大的改善空间;只是这个 oracle 已经用过完整多任务训练,实际部署时不能免费取得。
丢掉九成
2023 年 11 月的 DARE 走得更远。它把每个微调模型和预训练模型的差值(论文叫 delta 参数)随机丢掉比例 ,剩下的乘上 。
为什么要乘回去?每个值被保留的概率是 ,保留后放大 倍,期望值刚好等于原本的值:
丢掉的比例可以非常大。作者观察到,语言模型经过监督式微调,delta 参数大多在 0.002 以内,冗余极高,丢掉 90% 甚至 99% 都不太影响能力;模型越大,能容忍的 越高,到了 700 亿参数,丢掉 99% 的影响也很小。DARE 只负责丢,丢完再交给任务算术或 TIES 合并。DARE §1
左图把这个规模差别画得很清楚。横轴是丢弃率,纵轴是 GSM8K 准确率,7B 到 0.99 时急跌,70B 仍然接近原分数。右图则换成合并后的三种评测,语言、数学、编程能力的保留要分开看。
delta 一大就不行,论文也写得很清楚。经过持续预训练的模型,delta 会到 0.03 左右,DARE 就失效。WizardCoder-Python-13B 是从 CodeLlama-13b-Python 微调来的,相对它的 delta 在 0.0002 以内,相对 Llama 2 却常常超过 0.01;拿 Llama 2 当基底来丢,就会出问题。
这组失败很剧烈,只丢 10%,HumanEval 和 MBPP 的 pass@1 就从 63.41、55.4 掉到 0。前面的期望值等式依然成立,但单次抽样的方差是 ;delta 大了,高丢弃率再把少数残值放大,就很难保住输出。0.002 是论文观察到的尺度,还得配合各层与数据分布来看,不能拿来当所有模型通用的门槛。
当合并前处理时,DARE 也有输有赢。两个 13B 指令与数学专家用任务算术合并,GSM8K 原本是 66.34%,加 DARE 是 66.26%;改用 TIES,DARE 则把 15.77% 拉回 36.16%。三个专家一起合的任务算术,GSM8K 又从 58.45% 降到 56.48%。TIES 解决方向与平均时的干扰,DARE 减少差值的重叠,两者修的是不同环节,搭配后仍要实测。
还有一件容易看错。丢掉的是 delta,基底的完整权重一直留着,最后重建的仍是同样大小的 dense 模型。保留 1% 改动,推理量没有自动变成 1%;它帮忙的是合并和差值的稀疏化,部署加速要另外处理。
DARE 论文最后还用这套方法合并出一个 7B 模型,登上 Open LLM Leaderboard 7B 级的第一名,全程只用 CPU。
差不多同一时间,社群已经玩得很起劲。
不用 GPU 的炼金术
2023 年 11 月 5 日,Hugging Face 上出现一个叫 Goliath-120B 的模型。作者把两个 Llama 2 70B 的微调版本 Xwin 与 Euryale 分段取出,交错叠成一个更深的模型,合并时没有再做梯度训练。Goliath-120B 模型卡 这种拼法在社群叫 frankenmerge,名字取自科学怪人,意思是用不同模型的零件拼出一个新模型。严格说来,它一个权重都没有平均。
拼装用的工具是 Charles Goddard 写的 mergekit。线性平均、SLERP、任务算术、TIES、DARE,以及直接叠层的 passthrough,都只要写一份配置文件就能跑,内存不够时用 CPU 也能合并。2024 年 3 月的论文说,它已经促成了上千个模型的合并。Upstage 的 SOLAR-10.7B 也用了同一种叠层当第一步,之后再接着做持续预训练。MergeKit
「不用 GPU」说的是把来源张量读出、混合、写成一个新 checkpoint 的步骤。模型本来的训练已经付过计算成本,合并后要评测或提供推理,还是得负担完整模型的运算。Goliath 把层叠深后,推理的路径和权重存储也跟着变大;它省下了额外梯度训练,没有省掉 120B 级模型的部署需求。
这也让「合并」这个名字包了不同操作。固定层数的权重插值维持原架构;passthrough 直接改变串接的层数;SOLAR 在叠层后再训练,还多了一个学习阶段。要比较是否便宜,至少得分开模型产生、评测与部署三个阶段。
为什么要走弧线
SLERP 全名是球面线性插值,出自 Ken Shoemake 1985 年一篇电脑动画的论文,原本用来在两个旋转之间平滑过渡。2024 年初,它是社群最流行的合并法,只是一次只能合并两个模型。
它想处理的事情,两个向量就能看懂。两个长度为 1、互相垂直的向量 和 ,直接平均得到 ,长度只剩 。SLERP 沿着圆弧走,中点是 ,长度维持 1:
社群的说法是,高维空间里的直线混合会让权重向量变短,权重方向的变化也往往比长度更有意义。Labonne,2024-01-09 上面的长度比较用的是等长单位向量;实际模型每一层的范数与夹角还要量。若两个微调模型相对共同基底的改动很小、彼此夹角也很小,,公式的两个系数就会接近 和 ,SLERP 因而接近线性插值。这是公式的小角度近似,单靠 DARE 报告的某个 delta 绝对值,还推不出整个模型的夹角。后面会看到,Cohere 在 1,110 亿参数模型上试过 SLERP,没有看到明显的好处。
排行榜
2024 年 1 月 9 日,Maxime Labonne 在 Hugging Face 博客写了一篇 mergekit 教学,开头说,合并是做新模型的便宜方法(不需要 GPU),在 Open LLM Leaderboard 上产生了不少顶尖模型。他自己用 SLERP 合并的 Marcoro14-7B-slerp,在 1 月初成为排行榜上最好的 7B 模型。同一篇文章里,他也直接写道,合并最好的模型,也会把它们的污染一起合进来,「可以放心假设 Marcoro14-7B-slerp 被污染了」。Labonne,2024-01-09
污染(contamination)指评测题目混进了训练数据。排行榜的题目是公开的,有人会拿题目训练模型;合并模型的问题在于很难查,一个合并模型的父母可能也是合并来的,每一代又各自做过微调。
2024 年 3 月,Sakana AI 发表演化式模型合并。论文开头写着,Open LLM Leaderboard 现在被合并模型占据,合并也被很多人看成一种「黑魔法或炼金术」,靠的是作者的直觉。他们的解法是让演化算法去搜索合并配方,并搜索数据在不同模型的层之间怎么流动。合并出来的日文数学模型 EvoLLM-JP 只有 7B,在日文数学评测 MGSM-JA 上拿到 52.0,在几项日文评测上也胜过先前几个 70B 的日文模型。Akiba 等人
后续版本把这组设置交代得更完整。来源是三个 Mistral-7B 系列的日文、数学模型,主结果每个来源只搜索 density 和 weight,没有必要逐层加满自由度;搜索用另外翻译的 1,069 道题,最终 MGSM-JA 的 250 题保留不动。参数空间合并是 52.0%,再接数据流搜索可到 55.2%,模型也从 7B 增成 10B。配方由测试任务以外的数据决定,这才有空间检查能力是否真的迁移。Akiba 等人 §3.1
原图用层的颜色区分这几种操作。PS 把来源张量混成新张量,DFS 选来源层与经过次序,两者一起做时,才同时改张量内容与数据流。三种搜索最后得到的模型大小与前向路径,也可能不同。
这时候,排行榜已经把合并模型默认隐藏起来。3 月 11 日,一位合并模型的作者开了讨论串抗议。他的模型多次拿到第一名,却因为带着 merge 标签被藏起来,和被标记、被删除的模型放在一起,形同被贴上负面标签。
Hugging Face 的 Clémentine Fourrier 回复,根本原因是几乎不可能看清楚模型的血统。微调一个 Llama,你知道基底模型和微调数据;合并模型却有「合并的合并的合并、还有已删除的模型」,数据内容难以追溯,很容易不小心被污染。经过几轮合并、微调、再合并、DPO 之后,这些模型的学术分数往往无法转换成实际使用的表现。「所以它们默认被隐藏。」Open LLM Leaderboard 讨论 #629
这场争议同时牵涉来源透明度与评测选择。把一份评测分数当成挑父模型、挑系数的依据,做过很多次之后,那份评测就已参与配方搜索;是否碰过原始测试题,还要另外查数据血统。对合并模型的判断,最好保留一份未参与选配方的测试,再看实际用途的输出。讨论串提出了污染疑虑与管理理由,没有逐一证实每个合并模型都受污染。
走进训练流程
排行榜之外,合并也在各家自己的训练流程里普及了。
公开技术报告里最常见的,是把同一套配方跑出来的几个结果平均:
- Llama 3(2024 年 7 月):奖励模型、SFT、DPO 每个阶段,都把用不同版本的数据或超参数跑出来的模型平均。Llama 3 §4.1.5 图像能力的 SFT 先扫一轮超参数,按表现排序,平均前 K 名;作者写道,平均后的模型一致比网格搜索找到的最好单一模型好,对超参数也比较不敏感。Llama 3 §7.5.2
- Gemma 2(2024 年 7 月):把同一套后训练流程用不同超参数跑出的模型平均,引用的是 Google DeepMind 的 WARP。Gemma 2 §4
- OLMo 2(2024 年 12 月):7B 模型的 mid-training,同一份 50B tokens 的数据用三种顺序各跑一次再平均。六种数据配方都试过,平均后等于或优于其中最好的一份。OLMo 2 Table 14
- Tülu 3(2024 年 11 月):试过把不同种子的 SFT 模型做成汤,发现最好的单一种子和最好的汤差不多,最后为了一致,直接用最好的那一次。Tülu 3 Table 14
Tülu 3 那一条值得留意,平均也有没帮上忙的时候。
预训练也开始用。字节跳动 Seed 团队的 PMA,在固定学习率下平均检查点,从 4.11 亿参数的稠密模型一路试到 2,000 亿参数的 MoE;平均出来的模型表现更好,也能提早预测学习率退火之后的表现。蚂蚁集团的 WSM 更进一步,用检查点合并取代学习率的衰减阶段。PMA、WSM
这几种做法平均的对象也有差别。SWA 与固定学习率的 checkpoint averaging 收的是同一条轨迹的时间点;Model Soups 与不同数据顺序的实验,则从共同 checkpoint 分岔,再各自训练。前者需要决定从哪里开始收样、收多长;后者需要决定哪些分支能进汤。共同的工程条件,是保持兼容的参数坐标,并在平均后重新检查任务表现。
六个专家,两锅汤
Cohere 在 2025 年 4 月发表的 Command A 技术报告,把合并放在流程的正中央。
1,110 亿参数的 Command A 先训练一个基本的指令模型。从这个模型出发,分头训练编程、安全、RAG、数学、多语言与长上下文通用能力六个专家。六个 SFT 专家合并成一个「SFT 汤」,再从汤出发做各领域的偏好优化与强化学习,得到报告所称的六个 RL 专家,再合并一次,最后打磨。Command A §3
合并用的是最简单的线性加权平均,权重靠经验法则加上暴力搜索。报告写道,他们试过 SLERP 和任务向量这些更复杂的方法,没有明显的进步,复杂度却增加了。线性合并在工程上还有一个好处,合并的合并仍然可以写成一次合并,整条流程比较好追踪。
但系数要一路保留下来。先平均 A、B,再和 C 各取一半,得到的是 ;它能摊平成一次线性合并,和三个模型等权平均的 却有不同配方。共同起点之外,记录每层来源、每步系数与途中是否再训练,才能知道最后的模型是怎么来的。
结果,合并后的模型和各领域最好的专家相比,平均只掉了 1.8%,大多数指标都在 2.5% 以内,掉最多的是编程。在这个规模下,就算大幅调动专家的权重,对应领域的表现也只变动 2% 到 3%。合并完再用低学习率做少量 SFT,很多指标就能回到、甚至超过专家。Command A §4.9
这里可以直接看合并掉了哪些分数。左图把指标按「合并分数减去专家分数」分组,右图再按领域平均,误差线是标准差。编程那一列下降较多,RAG 比较接近零;整体平均很小,仍可能掩盖某一类工作比较明显的损失。
报告里几条经验,读起来很像当年那张图的延伸:
- 共同的起点:所有专家都从同一个通用的指令模型出发。工具调用用的特殊 token 也一样,大家从同一个起点出发、照常合并,效果比只从训练过这些 token 的专家挑出来合并好得多。
- 留一法:每次拿掉一个专家再合并,找出拖累其他能力的专家。为了减少这种冲突,每个专家的训练数据都掺一点其他领域的数据;连共同数据的风格或格式有些微差异,都会造成冲突。
- 合并很便宜,评测很贵:最后的模型参考了 500 个评测指标,每个合并候选都要花大量的推理算力评估。
让模型少想一点
推理模型兴起之后,合并也被拿来缩短模型的思考。
Kimi k1.5 的报告(2025 年 1 月)把长思考链模型和短思考链模型的权重直接平均,改善了 token 效率。不过在他们的比较里,平均并不是最好的;专门设计的 long2short 强化学习,token 效率最高。Kimi k1.5 §2.4、§3.4
这里要同时看答题表现与生成长度。只把模型弄得更不会推理,也会让回答变短,却失去原本要保留的能力。Kimi 把不同方法放在成绩与 token 数的关系里比较;权重平均是免额外训练的候选,rejection sampling、DPO、long2short RL 则利用额外学习换取更好的长度与正确率取舍。合并最便宜的那一步,仍然需要和训练方法放在同一张取舍图上看。
德国的 TNG Technology Consulting 在 2025 年 4 月做了一个更大的。他们把 DeepSeek-V3-0324 和 DeepSeek-R1 这两个 6,710 亿参数的 MoE 模型组成 R1T Chimera。注意力层与共享专家沿用 V3-0324,路由专家的权重则整组取自 R1。依他们自己的评测,Chimera 保留了 R1 的推理表现,输出的 token 少了约 40%。报告还提到,他们用不同比例插值出的一系列中间模型,几乎没有一个是坏的。Assembly of Experts
成绩单
这几年,研究端也累积了不少系统性的比较,结论比各篇方法论文保守。
Yang 等人的综述在 2025 年底的版本里,用统一的设置重跑了一轮。ViT-B/32 合并八个图像任务,各自微调的上限是 90.3%,直接平均只有 66.5%,加权与子空间类的方法能缩小一部分差距。换到 Llama-3.1-8B 合并五个领域专家,所有方法都落在预训练模型和专家之间,最好的也只有专家的 84.8%;更复杂的子空间或加权方法,有时还不如最基本的任务算术。Yang 等人 §3.2
Yadav 等人在 2024 年把规模拉到 640 亿参数,用不同大小的 PaLM-2 训练专家再合并。他们把两种基底、四种大小、四种方法、2/4/6/8 个专家放进同一个矩阵。大模型和指令微调过的基底通常更好合,64B 的 IT 基底合并八个专家时,四种方法的 held-in 都是约 0.93。换到 24B,相同设置的平均权重是 0.77、任务算术是 0.92,方法的差距仍然很明显。Yadav 等人
这里 held-in 除以各自专家的成绩,held-out 则除以基底。64B 的八专家任务算术,在新任务上的比值是 1.09,优于多任务训练的 1.05;但学过任务的 0.93 又低于多任务模型的 0.99。它支持的是一种取舍,合并保留了可用的专家能力,也可能让新任务的泛化更好,两项指标要一起看。
64B 的四种方法在这两张柱状图里几乎重叠。左边的 1.0 是单任务专家,右边的 1.0 是 PaLM-2-IT 基底;相同的高度在两张图里有不同的分母。合并八个专家时,右边超过基底,左边仍未回到专家水准。
TMLR 在 2026 年 3 月刊出的一篇研究,看的是更接近实际的情况。每个基底模型找来 12 个 Hugging Face 上公开的微调版本,它们的训练目标可能重叠,甚至互相冲突;四个模型、16 项评测、六类合并方法比下来,简单的任务算术最稳定,进步幅度有限。TIES 与 Model Stock 大致靠近基底,TSV-Merge、Iso-C 则随版本增加而退步,TA 加 Subspace Boosting 仍接近 TA 自己的趋势。Hitit 等人
尤其要注意这份研究的 normalization 开着, 的任务算术实际取各差值的平均;若直接加总十二份差值,尺度会放大十二倍。附录关掉 normalization 后,成绩对 明显敏感。这也是合并配方常被低估的一部分,同样写「TA」或「TIES」,还有归一化、保留比例与尺度要对齐。
把原图上下放在一起看,少抄一个 normalization 设置的差别就很大。两图的横轴都是 、纵轴都是平均准确率,颜色是四种基底。上图打开 normalization,在一般系数范围内大致平稳;下图关闭后,系数往上加,表现便快速下滑。上图最右还多测了 10,横轴显示的是列出的系数位置。
这份研究也分开问「是否超过基底」和「是否超过整个模型池最好的微调版本」。前者做到,后者仍可能失败。Llama 3.1 8B 就有一个很强的现成版本,合并始终没超过它。合并产生了新 checkpoint,价值还是得和原本可选的模型比较。
然后是 DeepSeek-V4。2026 年 4 月的技术报告里,DeepSeek 同样先为数学、编程、agent、指令遵循等领域各训练一个专家,每个专家都做过 SFT 和 GRPO 强化学习。整合的方式却是多教师的同策略蒸馏(on-policy distillation),让学生模型自己生成回答,再向十多个专家老师学习它们在这些回答上的输出分布。报告写道,专家的知识因此在 logit 的层次对齐到同一组参数里,「实际上避开了传统权重合并或混合强化学习常见的性能衰退」。DeepSeek-V4 §5.1
Cohere 和 DeepSeek 都先培养领域专家,差别在整合的空间。Command A 直接组合兼容的权重;V4 让学生在自己生成的路径上,学习老师给出的概率分布。前者省掉整合时的梯度训练,后者花额外训练,把不同老师的行为教进学生。两份报告的模型、数据、目标都不同,这两个案例没有构成合并与蒸馏谁普遍更好的对照实验。
再把常一起出现的 MoE 放进来,几个选项就清楚了:
| 整合方式 | 最后保留什么 | 推理时怎么跑 | 主要要确认的条件 |
|---|---|---|---|
| 权重平均/任务向量 | 一份同架构模型 | 原架构的一次前向 | 基底、张量语意与能力是否兼容 |
| 固定路径叠层 | 选出的来源层 | 每次走同一条新路径 | 表示衔接、深度与推理成本 |
| MoE | 多组内部专家与路由 | 每个 token 选部分专家 | 路由、负载与存储的专家权重 |
| 多教师蒸馏 | 学生模型 | 学生自己的架构 | 老师评分、训练数据与学生容量 |
本文依前面的模型与流程整理。这些操作可以搭配,例如把多个完整领域模型蒸馏到一个本身采用 MoE 架构的学生。
Command A 的「六个专家」是六个完整 checkpoint,和 MoE 层内的专家模块是不同层次。V4 选用蒸馏,也仍然可以保留 MoE 的稀疏推理架构;Chimera 则直接替换既有 MoE 里的一组参数。先分清楚整合的对象与部署路径,才知道各自省的是哪一段。
合得快,怎么还要测这么久
到这里,评测成本已经出现好几次。贪婪汤每试一个成员,就要跑一次选模数据;演化合并做上千个候选;大型研究把不同基底、规模、任务子集交叉展开。逐参数相加只是读写张量,真正要知道「这一份能不能用」,还得让完整模型处理各种输入。
如果自己要做一轮比较,可以先固定数据与提示,保留基底、最好单一模型、线性平均三个参考,再把方法参数放进小范围搜索。选配方的验证数据与最后测试分开,测试同时看要增加的能力、不能丢的能力,以及回答长度或拒答等行为。像 Command A 的留一法,还能指出某个来源加进去究竟改善了什么、牺牲了什么。
这些比较会决定哪种方法值得留下。若线性平均已经足够,没有必要先加上更复杂的投影;若重要能力持续掉分,可以再比合并后的少量训练、重新安排专家数据,或蒸馏。评测数据若只剩排行榜那几项,配方很容易只学会迎合那几项。
所以,相加除以二有没有用?
回到标题,答案要看你平均的是什么:
- 同一个起点、同一个任务:不同种子、不同超参数、同一次训练的不同时间点。这是最稳的一种,从 SWA、Model Soups 到 Llama 3、OLMo 2,已经写进不少公开的训练流程;偶尔也会像 Tülu 3 那样,平均了也没有比较好。
- 同一个起点、不同的能力:任务算术、TIES、DARE,还有 Command A 的专家合并。有用,但通常比不上各自的专家。在大模型上,简单的线性合并常常就够;专家之间保持一致,比各自冲到最高分重要。DeepSeek-V4 在这一步改用了蒸馏。
- 不同的起点:要先处理神经元的排列,网络还要够宽,才有机会接近零障碍。大型语言模型几乎都绕过了这一题,因为大家都从同一个预训练模型出发。
如果你手上刚好有几个从同一个基底微调出来的模型,先试最笨的线性平均,系数用验证集挑;模型一多,可以学 Cohere 做一下留一法,看看是谁在扯后腿。评测集够不够完整,对结果的影响可能比挑哪一种合并方法更大。
十年前,FedAvg 的作者担心平均两个模型会得到任意糟糕的结果。后来的研究逐步找到比较可靠的条件,共享训练路径、兼容的参数坐标、受控制的微调改动,以及真的能检查退化的评测。要把不同的本事放进同一组权重,每一项都得留心。
合并只要相加除以二。
麻烦的是除完之后,还有 500 个评测等着跑。