原始论文
Gemma 2: Improving Open Language Models at a Practical Size
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2408.00118
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{transformersgemma22024,
  title = {{Gemma 2: Improving Open Language Models at a Practical Size}},
  author = {Gemma Team and Morgane Riviere and Shreya Pathak and Pier Giuseppe Sessa and Cassidy Hardin and Surya Bhupatiraju and Léonard Hussenot and Thomas Mesnard and Bobak Shahriari and Alexandre Ramé and Johan Ferret and Peter Liu and Pouya Tafti and Abe Friesen and Michelle Casbon and Sabela Ramos and Ravin Kumar and Charline Le Lan and Sammy Jerome and Anton Tsitsulin and Nino Vieillard and Piotr Stanczyk and Sertan Girgin and Nikola Momchev and Matt Hoffman and Shantanu Thakoor and Jean-Bastien Grill and Behnam Neyshabur and Olivier Bachem and Alanna Walton and Aliaksei Severyn and Alicia Parrish and Aliya Ahmad and Allen Hutchison and Alvin Abdagic and Amanda Carl and Amy Shen and Andy Brock and Andy Coenen and Anthony Laforge and Antonia Paterson and Ben Bastian and Bilal Piot and Bo Wu and Brandon Royal and Charlie Chen and Chintu Kumar and Chris Perry and Chris Welty and Christopher A. Choquette-Choo and Danila Sinopalnikov and David Weinberger and Dimple Vijaykumar and Dominika Rogozińska and Dustin Herbison and Elisa Bandy and Emma Wang and Eric Noland and Erica Moreira and Evan Senter and Evgenii Eltyshev and Francesco Visin and Gabriel Rasskin and Gary Wei and Glenn Cameron and Gus Martins and Hadi Hashemi and Hanna Klimczak-Plucińska and Harleen Batra and Harsh Dhand and Ivan Nardini and Jacinda Mein and Jack Zhou and James Svensson and Jeff Stanway and Jetha Chan and Jin Peng Zhou and Joana Carrasqueira and Joana Iljazi and Jocelyn Becker and Joe Fernandez and Joost van Amersfoort and Josh Gordon and Josh Lipschultz and Josh Newlan and Ju-yeong Ji and Kareem Mohamed and Kartikeya Badola and Kat Black and Katie Millican and Keelin McDonell and Kelvin Nguyen and Kiranbir Sodhia and Kish Greene and Lars Lowe Sjoesund and Lauren Usui and Laurent Sifre and Lena Heuermann and Leticia Lago and Lilly McNealus and Livio Baldini Soares and Logan Kilpatrick and Lucas Dixon and Luciano Martins and Machel Reid and Manvinder Singh and Mark Iverson and Martin Görner and Mat Velloso and Mateo Wirth and Matt Davidow and Matt Miller and Matthew Rahtz and Matthew Watson and Meg Risdal and Mehran Kazemi and Michael Moynihan and Ming Zhang and Minsuk Kahng and Minwoo Park and Mofi Rahman and Mohit Khatwani and Natalie Dao and Nenshad Bardoliwalla and Nesh Devanathan and Neta Dumai and Nilay Chauhan and Oscar Wahltinez and Pankil Botarda and Parker Barnes and Paul Barham and Paul Michel and Pengchong Jin and Petko Georgiev and Phil Culliton and Pradeep Kuppala and Ramona Comanescu and Ramona Merhej and Reena Jana and Reza Ardeshir Rokni and Rishabh Agarwal and Ryan Mullins and Samaneh Saadat and Sara Mc Carthy and Sarah Cogan and Sarah Perrin and Sébastien M. R. Arnold and Sebastian Krause and Shengyang Dai and Shruti Garg and Shruti Sheth and Sue Ronstrom and Susan Chan and Timothy Jordan and Ting Yu and Tom Eccles and Tom Hennigan and Tomas Kocisky and Tulsee Doshi and Vihan Jain and Vikas Yadav and Vilobh Meshram and Vishal Dharmadhikari and Warren Barkley and Wei Wei and Wenming Ye and Woohyun Han and Woosuk Kwon and Xiang Xu and Zhe Shen and Zhitao Gong and Zichuan Wei and Victor Cotruta and Phoebe Kirk and Anand Rao and Minh Giang and Ludovic Peran and Tris Warkentin and Eli Collins and Joelle Barral and Zoubin Ghahramani and Raia Hadsell and D. Sculley and Jeanine Banks and Anca Dragan and Slav Petrov and Oriol Vinyals and Jeff Dean and Demis Hassabis and Koray Kavukcuoglu and Clement Farabet and Elena Buchatskaya and Sebastian Borgeaud and Noah Fiedel and Armand Joulin and Kathleen Kenealy and Robert Dadashi and Alek Andreev},
  year = {2024},
  eprint = {2408.00118},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2408.00118}
}
小模型要变强,最常见的做法是多喂数据。
Llama 3 的 8B 模型看了 15T 个 token,远远超过缩放律建议的量。这招有效,但效益越来越差。报告开头就点出,依照 Chinchilla 的缩放律,表现大致只随数据量的对数增长;最新的小模型多花了大把数据,在多数基准上只换到 1 到 2 个百分点。
这也说明小模型还没训练够。问题是数据总有用完的一天,而且每多一倍数据,训练成本也多一倍。
Google DeepMind 的 Gemma 团队在 2024 年 6 月发布 Gemma 2,换了一个方向。与其让小模型看更多 token,不如让它在每个 token 上学到更多东西。做法是知识蒸馏,用大模型的预测分布取代原本的标准答案。
Gemma 2 有 2B、9B、27B 三种大小。2B 和 9B 用蒸馏训练,27B 从头训练。
定义问题
一般的语言模型训练,每个位置只告诉模型一件事:下一个 token 是什么。
举个例子。「我今天想喝__」,训练数据里下一个词是「咖啡」,目标就是一个只有「咖啡」为 1、其他全为 0 的 one-hot 向量。但「茶」和「水」其实也很合理,one-hot 目标完全没有提到它们。
如果有一个已经训练好的大模型,它可能会说「咖啡 0.6、茶 0.3、水 0.1」。把这整个分布当作目标,小模型在同一个位置上就多学到「茶也说得通」这件事。作者把蒸馏的目的说得很明白,用蒸馏来「模拟超过可用 token 数量的训练」。
蒸馏的损失函数是老师分布 与学生分布 之间的交叉熵:
是上下文,求和遍及整个词表。老师分布换成 one-hot,这个式子就退回一般的下一个 token 预测。
这个想法并不新,Gemini 1.5 也用过蒸馏。这篇报告要回答的是,把蒸馏用在大规模预训练、让小模型看远超过最优量的 token,效果如何?
解决问题
架构
Gemma 2 和第一代一样是纯解码器的 Transformer,上下文长度 8,192,使用 RoPE 与近似的 GeGLU。新的设计有四个:
- 局部与全局注意力交替。每隔一层换一次,局部层用 4,096 个 token 的滑动窗口,全局层看完整的 8,192 个 token。
- Logit soft-capping。注意力层与最后的输出层,logit 都要经过 ,注意力层的上限设为 50,输出层设为 30。
- 前后都做归一化。每个子层的输入和输出都用 RMSNorm,目的是让训练更稳定。
- 分组查询注意力(GQA),分组数为 2。
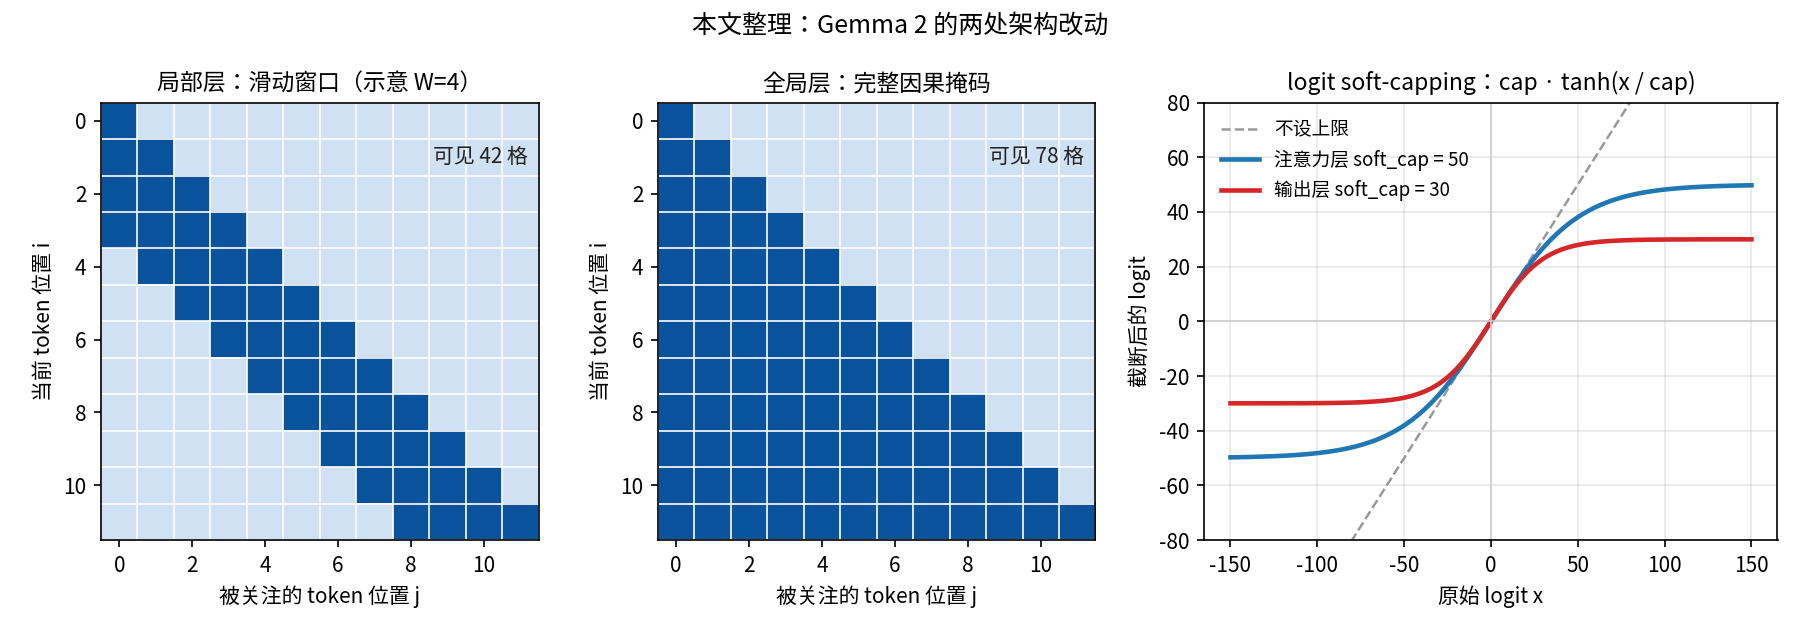
左边两张掩码说明局部层省了什么。全局层的每个 token 能看到前面所有 token,计算量随长度平方增长;局部层每个 token 最多只看窗口内的 token,量级固定。交替使用,就让一半的层省下计算,又保留每隔一层看一次全局的能力。
右图是 soft-capping。logit 小的时候几乎不受影响,tanh 在 0 附近接近直线;logit 很大的时候会被压在上限附近,避免某个值大到让 softmax 变成几乎只看一个位置。这个设计对训练稳定性有帮助,但后面会看到,它也在推理端惹了一点麻烦。
三种模型的配置如下(取自报告 Table 1):
| 2B | 9B | 27B | |
|---|---|---|---|
| 隐藏维度 | 2,304 | 3,584 | 4,608 |
| 层数 | 26 | 42 | 46 |
| 前馈层维度 | 18,432 | 28,672 | 73,728 |
| 注意力头 / KV 头 | 8 / 4 | 16 / 8 | 32 / 16 |
| 词汇表 | 256,128 | 256,128 | 256,128 |
词汇表沿用 Gemini 的 256K 个 token,原本是为了支持大量语言设计的,所以嵌入层的参数很多。2B 模型约有 5.9 亿个参数在嵌入层,非嵌入参数约 20 亿。
预训练数据与硬件
27B 用 13T 个 token 训练,9B 用 8T,2B 用 2T,数据以英文为主,包含网页、代码与科学文章。Gemma 2 不是多模态模型,也没有特别针对多语言能力训练。
2B 和 9B 的数据量都远超过缩放律建议的量。以常见的「每个参数约 20 个 token」粗估,2B 的最优量约 40B token,实际用了 2T,是 50 倍;9B 约 180B token,实际用了 8T,也有四十多倍。
训练用的是 Google 自家的 TPU:2B 用 512 颗 TPUv5e,9B 用 4,096 颗 TPUv4,27B 用 6,144 颗 TPUv5p。报告估计整个 Gemma 2 预训练的碳排放约 1,248 吨二氧化碳当量。
后训练:最后一步是平均
后训练分成三步:
- SFT:用合成与真实的提示词,回答主要由更大的老师模型生成;另外也在学生自己的输出分布上做蒸馏。
- RLHF:奖励模型比策略模型大一个数量级,而且更偏重多轮对话。提示词部分使用了 LMSYS-Chat-1M,但只取提示词,不取里面的回答。
- 模型合并:把用不同超参数跑完整个流程得到的模型平均起来。
第三步引用的是同团队 Ramé 等人的 WARP。报告只用了一句话带过,没有给出合并前后的比较。
讨论
蒸馏到底有多大帮助
报告的消融不多,但每一个都对准一个设计决定。最重要的是蒸馏:
| 2B 模型,训练 500B token | 从头训练 | 从 7B 老师蒸馏 |
|---|---|---|
| 三个基准平均 | 60.3 | 67.7 |
500B token 已经是 2B 模型最优量的 10 倍,蒸馏仍然高出 7.4 分。这里用 7B 当老师,是为了模拟「27B 教 9B」的大小比例。
蒸馏的好处会不会随模型变大而消失?作者固定 7B 老师,训练 200M、400M、1B 三种学生:
| 验证集困惑度 | 200M | 400M | 1B |
|---|---|---|---|
| 从头训练 | 23 | 19 | 17 |
| 蒸馏 | 21 | 17 | 15 |
三种大小都稳定低了 2,差距没有缩小。
正式模型的比较也一样。Gemma 2 的 2B 用 2T token,第一代 2B 用 3T token,数据更少,但新模型在各基准上明显更好;9B 在部分基准上比第一代的 7B 高了约 10%。作者把这归功于蒸馏。
不过要注意,第一代与第二代之间除了蒸馏,架构、数据与后训练也都变了,这个比较无法把功劳单独归给蒸馏。真正干净的证据是上面两张消融表,而它们都是在比正式模型小得多的设置下做的。
其他架构消融
- GQA 与多头注意力:9B 模型在四个基准的平均,多头注意力是 50.3,GQA 是 50.8,差异很小。作者选 GQA,是因为参数更少、推理更快。
- 深与宽:参数量相同的 9B,较深的版本平均 52.0,较宽的 50.8。差距小但一致,因此 Gemma 2 比第一代更深。
- 推理时缩小滑动窗口:9B 模型的窗口从 4,096 缩到 2,048、1,024,困惑度只从 1.63 变成 1.63、1.64。需要的话,可以用缩小窗口换一点推理速度。
- 格式稳定性:12 种提示与评估格式的组合下,MMLU 分数的标准差,Gemma 2 的 9B 是 0.9、27B 是 1.0;Mistral 7B 是 6.9。
成绩
预训练版本的 27B,在 Hugging Face 的评测组合上和 Llama 3 70B 相比:MMLU 75.2 对 79.2、GSM8K 74.0 对 76.9、HellaSwag 86.4 对 88.0。模型小 2.5 倍,训练数据 13T 个 token 也比 Llama 3 的 15T 少,只落后几分。作者也坦白说,从头训练的模型表现大致只随大小对数增长,27B 可能就落在 Llama 3 的同一条帕累托曲线上。
后训练版本在 LMSYS Chatbot Arena 上的成绩最受关注。27B 的 Elo 是 1218,高于 Llama 3 70B 的 1206;9B 是 1187,和 GPT-4-0314 的 1186 相当;2B(严格说是 2.6B)是 1126,高于 GPT-3.5-Turbo-0613 的 1116。
这些比较都以总参数量计算。作者特别说明,这是因为在一般设备上使用开源模型时,限制通常是总内存占用,而不是激活参数。
人工评测与记忆
除了 Arena,作者另外做了两组人工评测。单轮提示词上,和 GPT-4o 比较安全与指令遵循;多轮方面,评审在 500 个多轮对话情境中,对整体满意度与目标达成度打 1 到 5 分。和第一代 Gemma 1.1 7B 相比,Gemma 2 的三个大小在两个指标上都更好,例如 27B 的用户满意度从 3.32 升到 4.20。
报告也量了模型对训练数据的逐字记忆。给模型一段训练数据的前 50 个 token,看它会不会逐字吐出后 50 个 token。Gemma 2 的逐字记忆率低于 0.1%,明显低于同级的其他模型;以 10% 编辑距离为门槛的近似记忆率虽然较高,仍比第一代 Gemma 的逐字记忆还低。分数据来源来看,代码、维基百科与科学文章被记住得比较多。
Soft-capping 的实际代价
Soft-capping 在论文里只占两行,在社区里却引起不少麻烦。
Gemma 2 发布时,主流的 FlashAttention 实现都不支持在注意力分数上做 soft-capping。Hugging Face 在发布说明中提醒,要么放弃 FlashAttention 的加速,要么牺牲表现。llama.cpp 在加入 soft-capping 的修正时,加载 Gemma 2 会直接关掉 FlashAttention,已经转好的 GGUF 文件也得重新生成。发布初期,Hugging Face 上也有用户反馈 27B 的输出出现错字与幻觉,讨论帖里指向的修正,就是在推理端补上这一步。
一个看起来无害的稳定性技巧,让整个推理生态花了几个星期才跟上。
这份报告没说的事
报告没有交代预训练数据的具体组成,也没有说明 2B 与 9B 各自的老师是哪一个模型;从消融的说法看,作者以「27B 教 9B」为目标比例,但正式的老师身份没有写出来。后训练的数据、超参数与模型合并的细节同样只有几句话。
结论
Gemma 2 想说的事情不复杂。小模型与其多看数据,不如让每个 token 带有更多信息。用大模型的概率分布当训练目标,2B 和 9B 用远超最优量的数据蒸馏,换来同级最好的成绩。
架构上的几个改动,局部全局交替、soft-capping、前后归一化,都不是新发明,却组合得很实用。
部署 Gemma 2 之前,记得先确认推理框架有没有实现 soft-capping。少了那一个 tanh,模型就会开始写错字。