原始论文
Arcee's MergeKit: A Toolkit for Merging Large Language Models
- arXiv 首次提交
- arXiv:2403.13257
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingmergekit2024,
  title = {{Arcee's MergeKit: A Toolkit for Merging Large Language Models}},
  author = {Charles Goddard and Shamane Siriwardhana and Malikeh Ehghaghi and Luke Meyers and Vlad Karpukhin and Brian Benedict and Mark McQuade and Jacob Solawetz},
  year = {2024},
  eprint = {2403.13257},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.13257}
}
Hugging Face 上曾经冒出一大批名字很长的模型,时间大约在 2023 年底到 2024 年初。
它们的名字常常带着 slerp、ties、dare 这类字样,或者干脆把两三个模型的名字串在一起。这些模型没有经过新的训练,作者只是把几个现成的微调模型权重混在一起,就上传了;其中不少还一度爬上 Open LLM Leaderboard 的前列。
背后的工具多半是同一个,Arcee 的 Charles Goddard 等人开发的开源库 MergeKit。这篇论文是它的正式介绍,篇幅不长,主要在讲工具怎么设计、支持哪些方法,再附上一组医学领域的合并实验。
读这篇的价值,在于看清楚「模型合并」从论文走到社群日常时,实际长成什么样子。
定义问题
模型合并的研究已经积累了好几年,从权重平均、Model Soups、任务算术,到 TIES-Merging 与 DARE。但每篇论文的代码各写各的,大多针对特定模型与数据集,要拿来合并两个 70B 的语言模型,会遇到很实际的问题:
- 内存:两个 70B 模型以 16 位存放就是两三百 GB,一般机器装不下,更别说同时放好几个。
- 架构差异:Llama、Mistral、Qwen 的权重命名与层结构不同,每种都要单独处理。
- 配方难以复现:哪个模型给多少权重、哪几层用什么方法,写在临时脚本里,别人很难照做。
作者想做的,是一个让不会写代码的人也能合并模型、让研究者能方便加入新方法的共用工具。
解决问题
论文怎么分类合并方法
作者先给合并方法做了一个分类,也标出 MergeKit 支持到哪里。
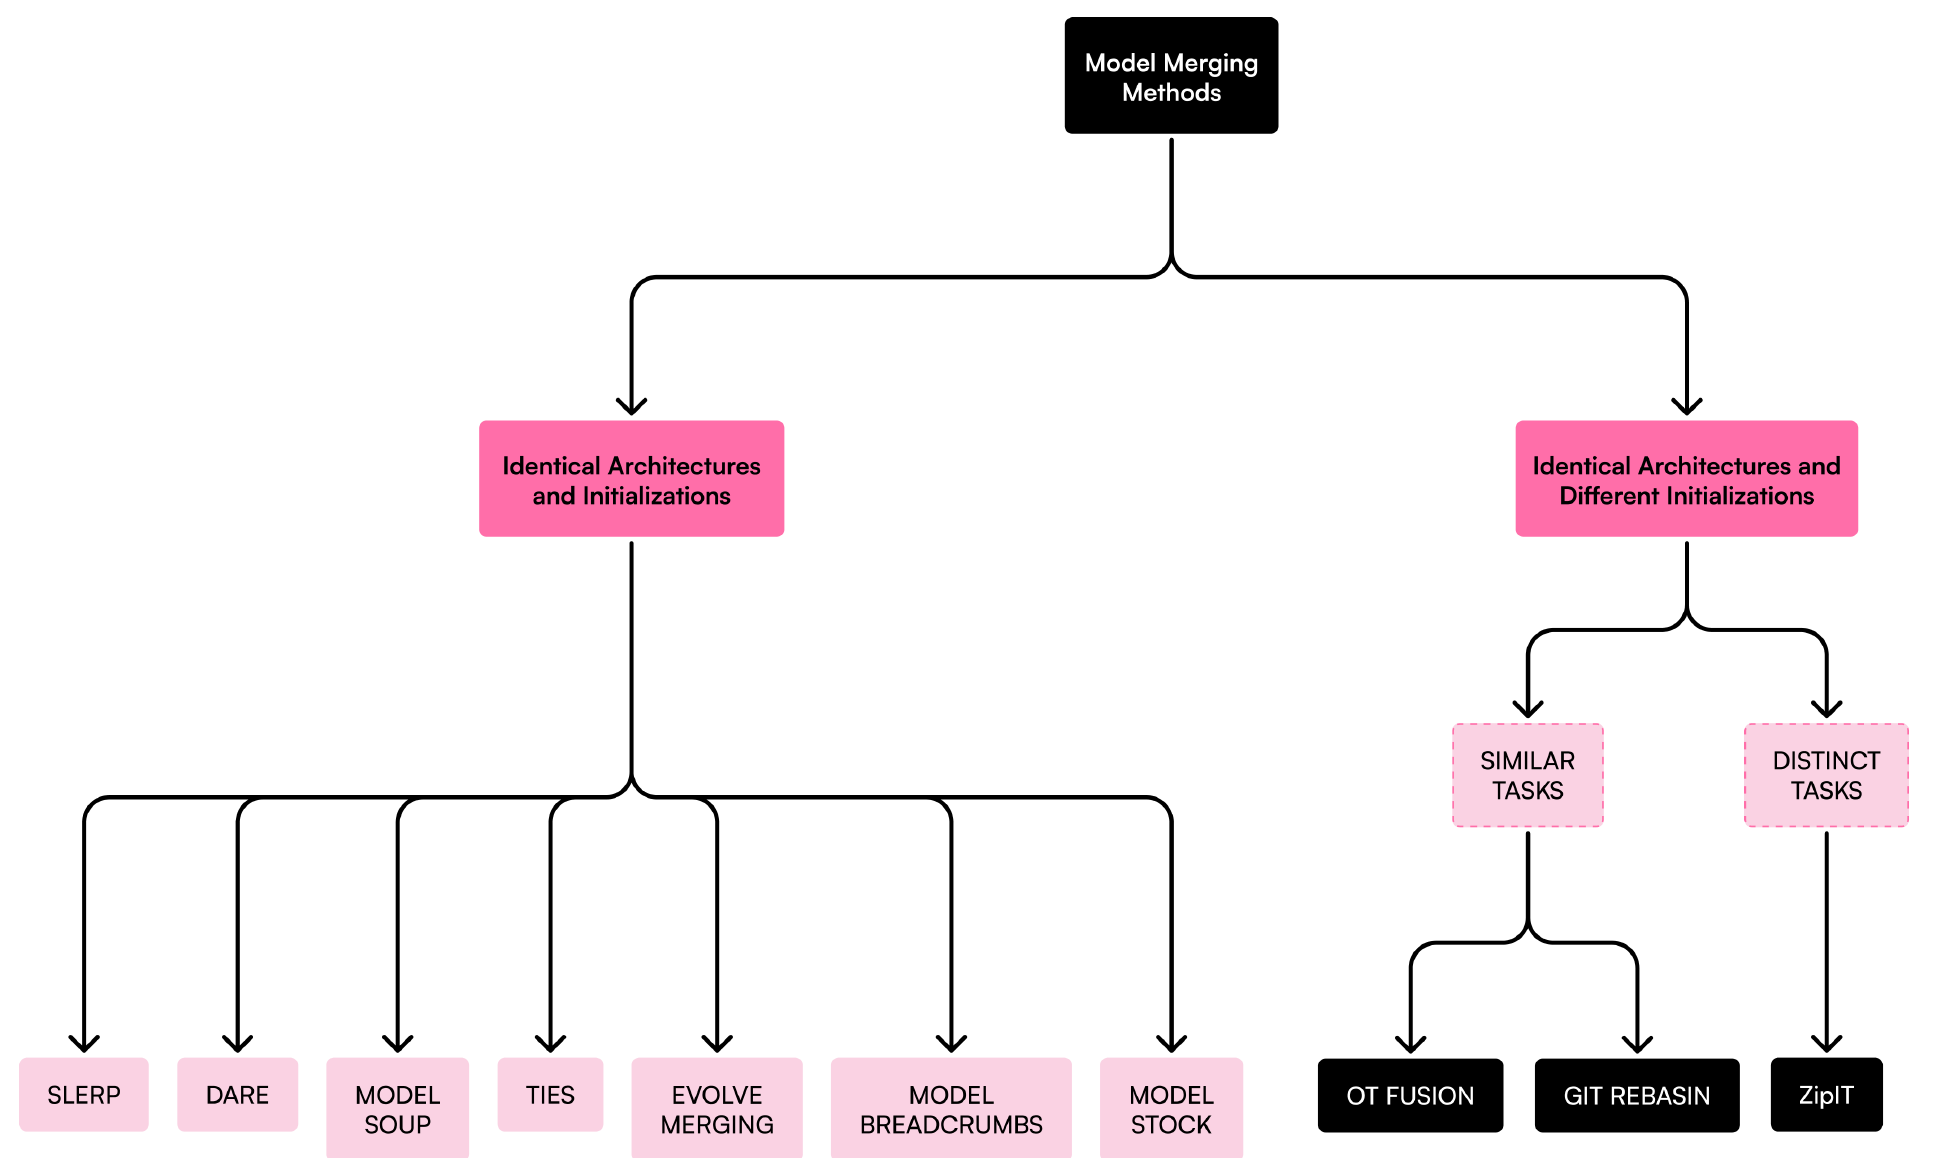
分类的依据是两件事:模型的架构是否相同,以及是否来自同一个初始化。
左边那一支是 MergeKit 实际支持的范围,全部要求「架构相同、从同一个基底模型出发」。这正是线性模式连通与任务算术成立的条件。右边那一支处理独立训练的模型,需要先做神经元对齐,论文写作时还没支持。作者也坦白说,右边这些方法目前还没有左边那样的广泛使用。
架构完全不同的模型,例如 CALM 用交叉注意力把两个模型接起来、FuseLLM 对齐两个模型的输出分布,都需要额外训练,作者把它们列为「融合」而不是合并。
合并配方就是一份 YAML
MergeKit 的主要接口是 YAML 配置文件。配置文件里写明合并方法、输入模型,以及方法需要的参数,运行时只要一行命令:
mergekit-yaml path/to/your/config.yml ./output-model-directory
一份 TIES 合并的配置,可以写成这样(取自官方 examples/ties.yml):
models:
  - model: psmathur/orca_mini_v3_13b
    parameters:
      density: [1, 0.7, 0.1] # density gradient
      weight: 1.0
  - model: garage-bAInd/Platypus2-13B
    parameters:
      density: 0.5
      weight: [0, 0.3, 0.7, 1] # weight gradient
  - model: WizardLM/WizardMath-13B-V1.0
    parameters:
      density: 0.33
      weight:
        - filter: mlp
          value: 0.5
        - value: 0
merge_method: ties
base_model: TheBloke/Llama-2-13B-fp16
parameters:
  normalize: true
  int8_mask: true
dtype: float16
三个 13B 模型都是从同一个 Llama-2-13B 微调出来的,base_model 指定这个共同基底,任务向量就是各模型和它的差。density 是 TIES 修剪后保留的比例,weight 是每个任务向量的权重。
这份配置文件还用到两个功能。
第一,参数可以写成列表。density: [1, 0.7, 0.1] 会沿着层的深度插值成一条「梯度」,浅层保留全部、越深层保留越少。
第二,参数可以用 filter 指定作用范围。WizardMath 的配置是 MLP 层给 0.5 的权重,其他张量给 0,也就是只取它 MLP 层的改动。
配置文件的好处,是合并配方变成可以分享、复现、改写的文本。社群里很多合并模型的模型卡,直接附上了这样一份 YAML。
SLERP 为什么常见
MergeKit 支持的方法中,社群最常用的之一是 SLERP(spherical linear interpolation,球面线性插值)。它来自 1985 年的计算机动画研究,原本用来平滑插值旋转。
两个张量 、 之间,一般的线性插值是 。SLERP 则先算出两者归一化后的夹角 ,再沿着球面走:
两者差在哪里?取两个长度为 1、夹角 90 度的向量,线性插值的中点长度只剩 ;SLERP 的中点长度仍是 1。夹角越大,线性插值把权重「缩短」得越多。
但从同一个基底微调出来的语言模型,权重之间的夹角通常很小。夹角只有 2 度时,线性插值的中点长度是 ,两种方法几乎没有差别。MergeKit 的实现也考虑到这点,当两个张量的归一化内积超过 0.9995 时,直接退回一般的线性插值。
论文说 SLERP 的成功显示「球面路径常常比直线有更低的损失障碍」,这是作者的说法,论文里没有提供对应的障碍测量。
另外,SLERP 一次只能合并两个模型,所以前面的示例改用 TIES。官方 gradient-slerp.yml 示例则演示了 SLERP 的另一种用法,让 attention 和 MLP 用不同的插值系数,而且系数沿层深度变化,例如 attention 从 渐变到 ,MLP 反过来。
不做加减的两种合并
MergeKit 还有两种方法完全不在参数空间做运算。
Passthrough,社群叫它「FrankenMerging」,把不同模型的层直接拼接起来,做出一个层数不寻常的新模型。热门的 Goliath-120B 把 Xwin 与 Euryale 两个 Llama-2 70B 微调模型的层段,每段 16 层左右、前后部分重叠地交错接起来。SOLAR-10.7B 的 Depth Up-Scaling 第一步也是这样,把同一个 32 层模型复制两份,一份去掉最后 8 层、一份去掉最前 8 层,接成 48 层,之后再继续预训练。
mergekit-moe,社群叫「FrankenMoE」,把几个稠密模型当成专家,组成一个混合专家(MoE)模型。路由器可以用提示词的隐藏状态做语义路由,也可以随机初始化,之后再训练。
这两种方法都不涉及任何对齐或插值的理论,拼出来能不能用,只能靠评测说话。
在笔记本电脑上合并 70B 模型
MergeKit 的效率来自「out-of-core」的设计。它不会一次把整个模型加载进内存,而是只加载当前这个运算需要的张量。
一次合并在内部被表示成一张有向无环图(DAG),每个节点是一个运算。调度器按照这张图决定执行顺序,让同一时间需要放在内存里的数据越少越好,用不到的中间结果也会自动释放。作者说这让 MergeKit 可以从研究集群一路缩到没有 GPU、内存有限的笔记本电脑上运行。
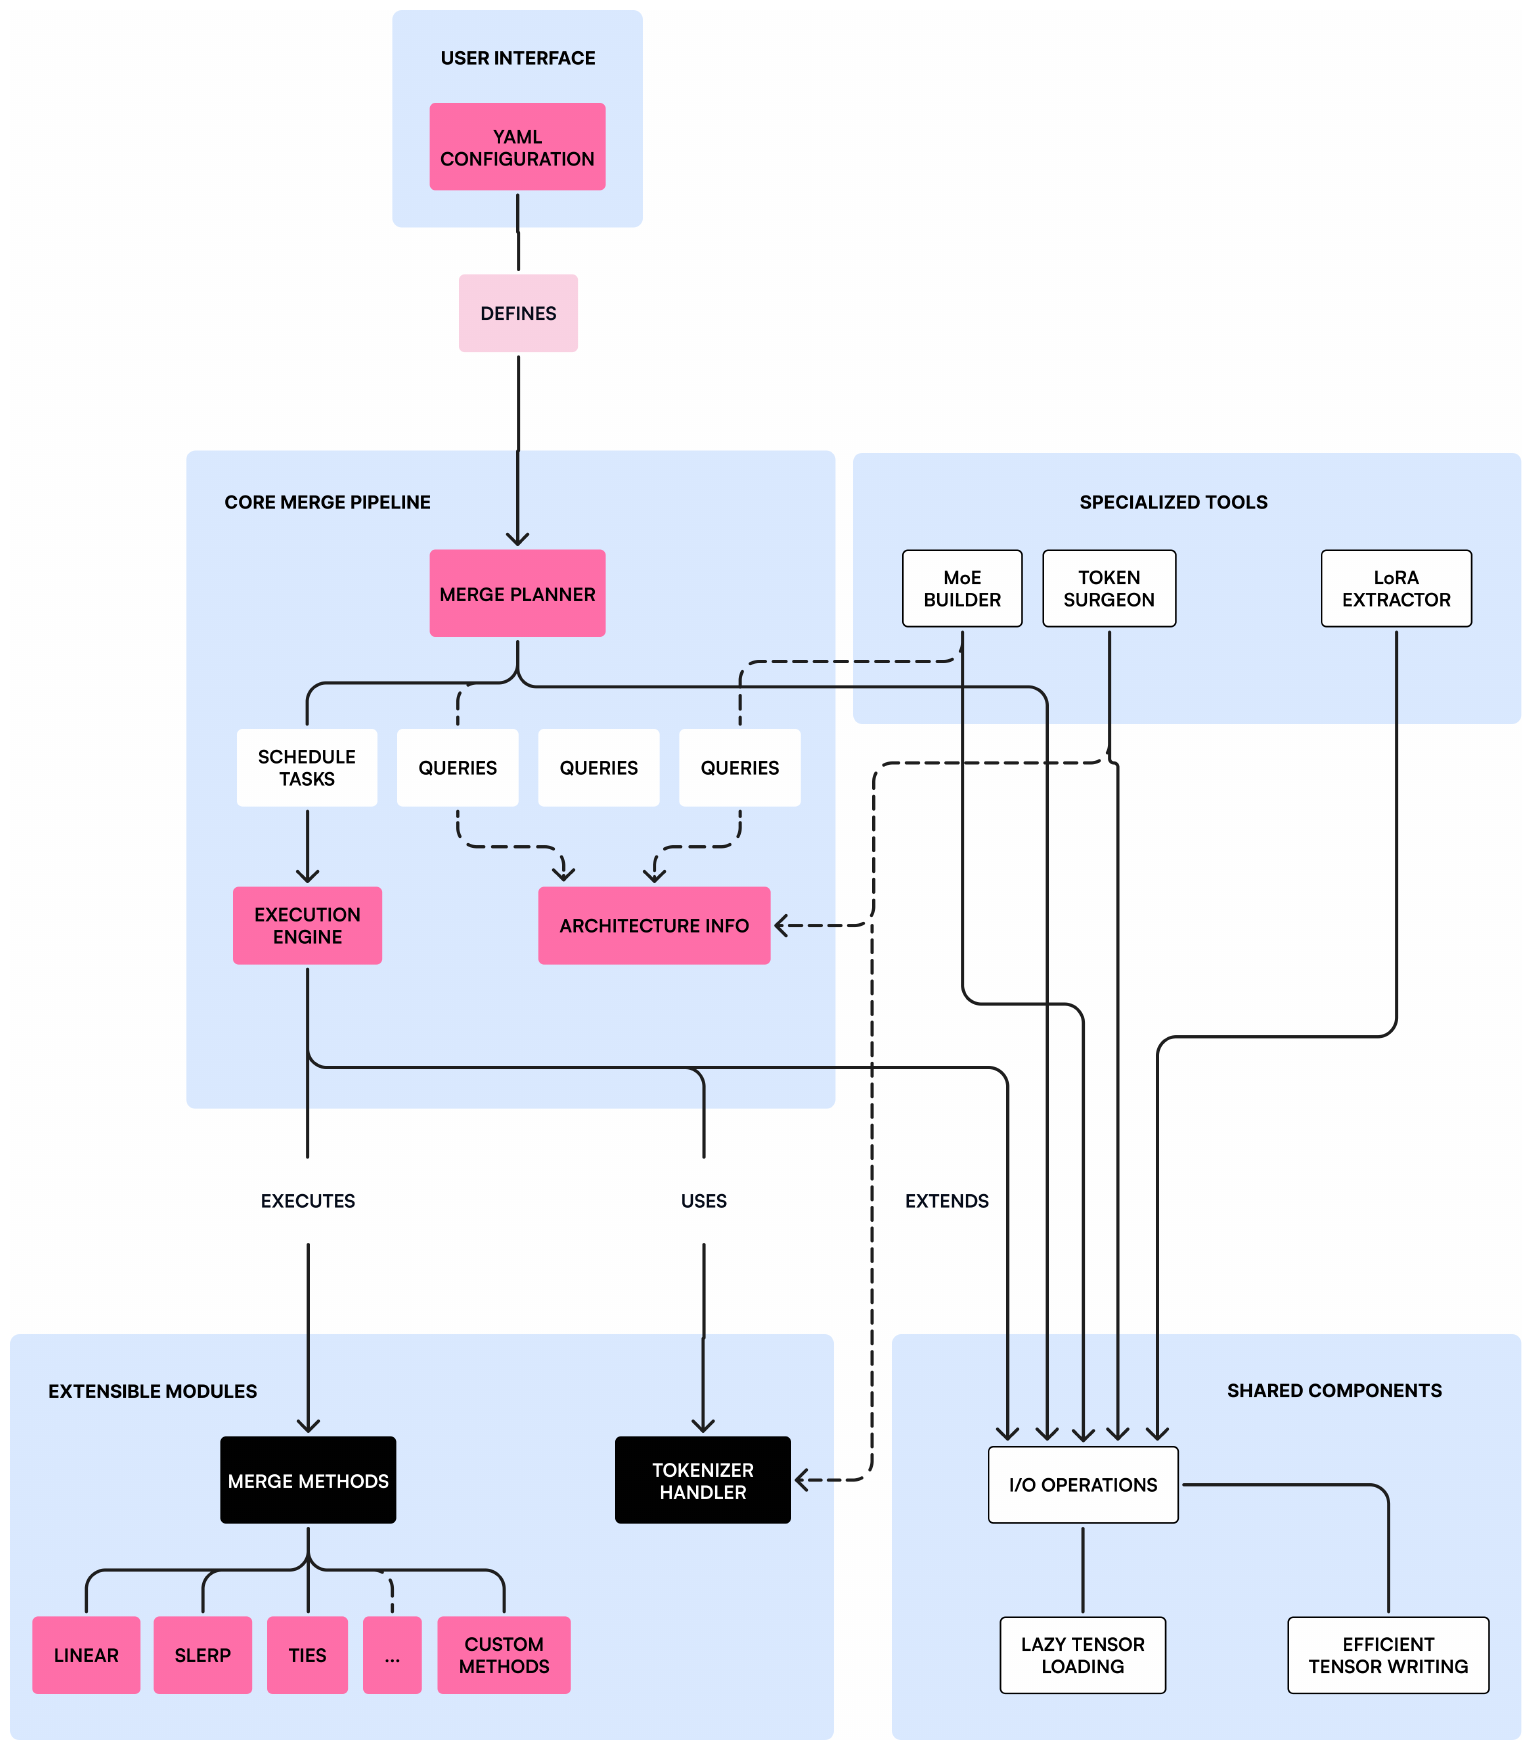
这张架构图对想加入新方法的人最有用。作者列出几个要先熟悉的模块:merge_methods/base.py 定义新方法要实现的接口,graph.py 负责调度与数据搬移,plan.py 建立运算图,architecture.py 描述各种模型的结构,大多数架构只用一个简单的 JSON 文件定义。
讨论
一组医学实验
论文唯一的实验,是把医学模型 Meditron-7B 和 Llama2-7B-Chat 合并。两者都从 Llama2-7B 基底出发,Meditron 另外在大量医学语料上继续预训练。
| 模型 | USMLE | MedMCQA | PubMedQA | ARC-C | HellaSwag | MMLU |
|---|---|---|---|---|---|---|
| Llama2-7B-Chat | 35.90 | 35.45 | 73.40 | 44.20 | 55.40 | 46.37 |
| Meditron-7B | 38.40 | 24.07 | 71.40 | 40.20 | 54.50 | 33.06 |
| LERP | 39.10 | 36.65 | 75.60 | 46.76 | 58.66 | 48.44 |
| SLERP | 39.20 | 36.91 | 75.60 | 46.84 | 58.67 | 47.97 |
| DARE-TIES | 36.37 | 27.56 | 72.20 | 42.92 | 54.79 | 41.17 |
| TIES | 38.73 | 32.27 | 75.60 | 45.05 | 58.23 | 45.03 |
前三列是医学考题与问答,后三列是一般能力。
除了 DARE-TIES 在 USMLE 上低于 Meditron-7B(36.37 对 38.40),合并模型在三项医学题上都比 Meditron-7B 好;LERP 和 SLERP 在一般能力上也超过 Llama2-7B-Chat。作者据此认为医学领域上 SLERP 最好。
但读这张表要小心几件事。第一,LERP 和 SLERP 的差距大多在 0.5 个百分点以内,MMLU 甚至是 LERP 比较高,这和前面算的「夹角很小时两者几乎一样」一致。第二,表中没有交代合并系数、评测的提示格式与重复次数,也没有方差,无法判断这些差距是否稳定。第三,只有一组模型、一个领域。这组实验比较像使用示例,不足以拿来比较方法的优劣。
排行榜上的合并热潮
论文说 MergeKit「促成了数千个模型的合并」。这股热潮也带来问题。
2024 年 3 月,有用户在 Open LLM Leaderboard 的讨论区抱怨,排行榜默认隐藏带有「merge」标签的模型,让他们的合并模型失去曝光。维护排行榜的 Hugging Face 人员回复,隐藏的原因是合并模型的血缘几乎无法追溯,一层层合并下来,很难知道里面混进了哪些数据,很容易意外污染评测集;而且这类模型的分数,常常无法转化成实际使用上的能力(讨论帖)。
这不是 MergeKit 本身的错,但它说明了一件事。合并让产生新模型的成本趋近于零,评测的可信度却没有跟着提高。把一堆在排行榜上分数高的模型合在一起,分数也许会更高,但那可能只是把每个模型各自沾到的考题加在一起。
许可证的转折
MergeKit 一开始以 LGPL v3 发布。2025 年 2 月,Arcee 在发布 v0.1 时改用 Business Source License,理由是要支撑长期开发;同年 10 月 31 日又宣布改回 LGPL v3,以 BSL 发布的旧版本保留在版本历史中。如果你的项目固定在某个旧版本,可以先确认那个版本适用哪一种许可证。
结论
MergeKit 这篇论文没有提出新的合并理论,它的贡献是工程上的。把各篇论文的方法收进同一个框架,用 YAML 让合并配方可以分享,用延迟加载让大模型可以在小机器上合并。
正因为它太好用,模型合并才会在 2024 年从论文变成社群的日常。后来的 Llama 3、Tülu 3 等模型的技术报告里,也都可以看到合并被写进正式的训练流程。
自己动手前,先记得一件事。MergeKit 让合并只剩一份 YAML 的工夫,评测可不会跟着变简单。