原始论文
Editing Models with Task Arithmetic
- 发表版本
- ICLR 2023会议
- arXiv 首次提交
- arXiv:2212.04089
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingtaskarithmetic2022,
  title = {{Editing Models with Task Arithmetic}},
  author = {Gabriel Ilharco and Marco Tulio Ribeiro and Mitchell Wortsman and Suchin Gururangan and Ludwig Schmidt and Hannaneh Hajishirzi and Ali Farhadi},
  year = {2022},
  eprint = {2212.04089},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.04089}
}
预训练模型拿到手,通常还要改一改。让它在某个任务上更好、让它少说一些有毒的话、让它跟上新的数据,这些都属于论文说的「编辑」。
最常见的编辑方法是微调。微调一次,就多一个模型;想要模型同时会两件事,常见做法是把两份数据凑在一起做多任务训练。每增加一种能力,数据与训练流程又得调整一轮。
华盛顿大学、Microsoft Research 与 AI2 的 Ilharco、Ribeiro、Wortsman 等人,之前刚做完 WiSE-FT 和 Model Soups,都在研究权重的线性混合。这次他们换一个角度,把「微调改了什么」单独拿出来,当成一个向量来操作。
定义问题
令 是预训练权重, 是在任务 上微调后的权重。任务向量(task vector)定义为两者的差:
这是一个和整个模型一样大的向量,记录为了任务 ,每个权重往哪个方向移、移了多少。
把任务向量加回某组权重 ,可以带一个缩放系数 :
、 时,就刚好回到微调后的模型。 由保留的验证数据决定。
这里有一个前提。任务向量是逐个权重相减,所以必须是同一个架构,而且微调时不能多出新的参数。作者因此选了两类「开放式」的模型,一类是开放词汇的图像分类器(如 CLIP,换任务只要换类别名称,用文本编码器生出分类头),一类是 text-to-text 的语言模型(如 T5、GPT-2)。
这些向量能不能像数字一样相加、相减,让模型的行为也跟着照做?
解决问题
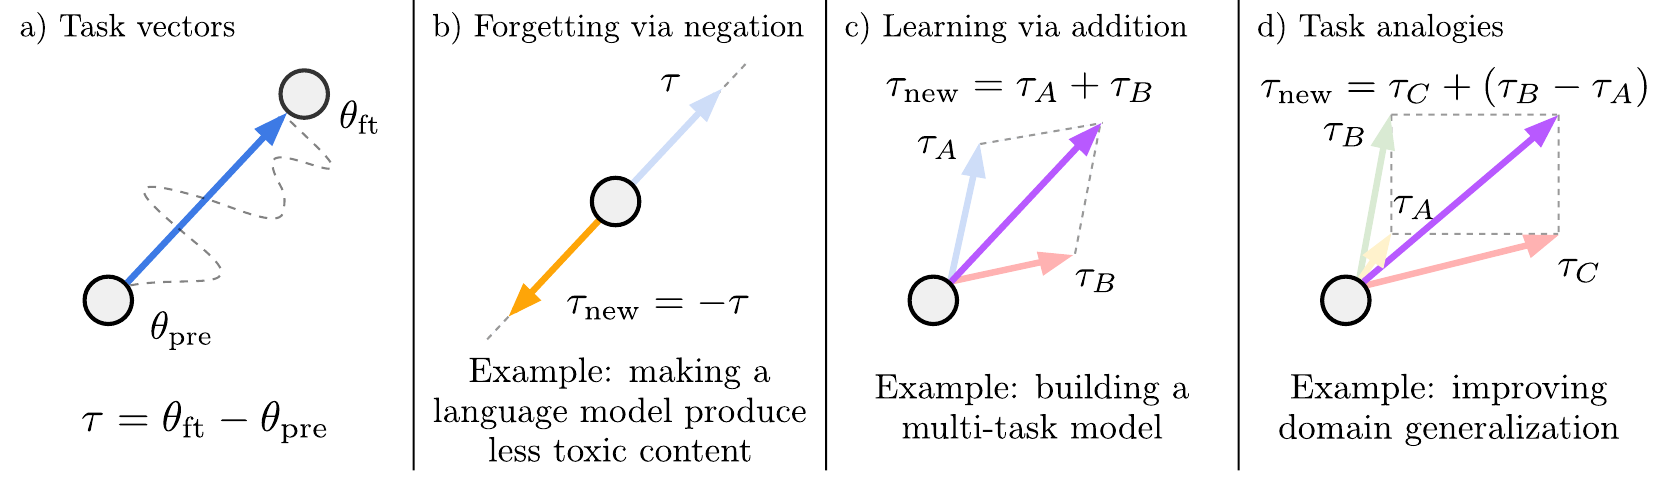
作者研究三种运算,全都是逐个权重做的:
- 取负号(遗忘):。从预训练权重往微调的反方向走,模型在那个任务上变差,其他任务尽量不受影响。
- 相加(学习):。把几个任务的向量加起来,得到一个同时处理这些任务的模型。
- 类比:如果四个任务满足「A 之于 B,如同 C 之于 D」,就用 去改善 D,即使 D 几乎没有数据。
三种运算最后都是 。整个编辑只是向量运算,推理时的内存和计算量都和原本的模型一样。
这里很容易把「任务相加」和「平均两个微调模型」混在一起。设 、,我们有
直接平均等于任务算术取 ;取 则保留两个完整的微调改动。例如基底参数是 ,两个任务分别改成 和 ,平均得到 ,任务相加得到 。对大网络而言,尺度差一倍足以改变成绩,所以系数选择是方法的一部分。
类比听起来最抽象,举论文的例子比较好懂。想做 Yelp 评论的情感分类,手上却只有 Amazon 评论的情感标注,Yelp 只有没标注的文本。作者这样组:
是在 Amazon 上做情感分类学到的;括号里两个向量,是分别在 Yelp 和 Amazon 的文本上做语言模型训练学到的,不需要标注。括号的差,大致就是「从 Amazon 换到 Yelp」这个领域变化的方向。
讨论
取负号:忘掉一个任务
图像分类用 CLIP,目标任务有八个数据集,汽车型号(Cars)、纹理(DTD)、卫星图像(EuroSAT、RESISC45)、交通标志(GTSRB)、手写数字(MNIST)、场景(SUN397)、门牌数字(SVHN)。对照任务是 ImageNet,用来确认其他能力没被弄坏。
ViT-L/14 减去任务向量之后,八个目标任务的平均准确率从 64.8% 降到 19.0%,掉了 45.8 个百分点;控制任务 ImageNet 从 75.5% 降到 72.9%,代价是 2.6 个百分点。作为对照,改成在目标任务上做梯度上升(把损失往上推),目标任务也会变差,但 ImageNet 跟着严重退步到 16.3%;加一个大小相同的随机向量,则对目标任务效果很小。
文本生成上,作者在 Civil Comments 毒性分数高于 0.8 的留言上微调 GPT-2 Large,得到「说有毒的话」的任务向量,再把它减掉。生成内容被判定为有毒的比例从 4.8% 降到 0.8%,WikiText-103 的困惑度从 16.4 变成 16.9。梯度上升同样能降毒性,但困惑度坏到不能用。
这组实验用固定的争议性前缀产生 1,000 段文本,再用 Detoxify 分类器评分; 是在困惑度恶化不超过 0.5 的条件下挑出的最大值。对照的「直接用无毒留言微调」得到 1.8% 毒性比例、17.2 困惑度,取反向量在这组取舍上更好。附录换过其他提示与 RealToxicityPrompts,也量了不同大小的 GPT-2;困难提示上的毒性仍有改善空间。
因此这里的「遗忘」是可测量的行为退化,证据是指定任务与提示下的输出。若目的是移除某笔训练数据或保证特定信息无法被取出,这篇没有提供那种形式的验证。
相加:一个模型做好几件事
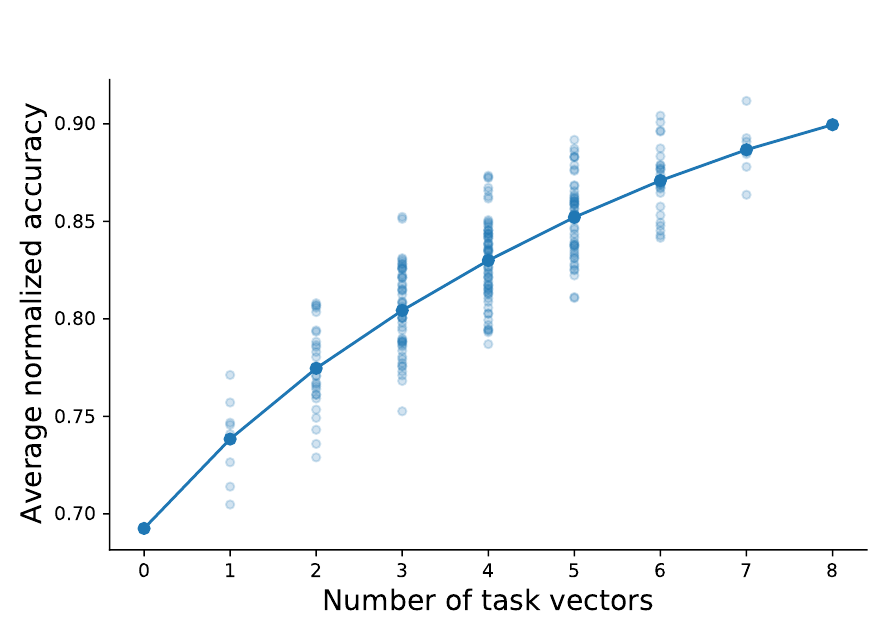
各任务的难度不同,作者用归一化准确率来比,也就是把合并模型在每个任务上的准确率,除以该任务单独微调的模型的准确率。100% 代表和各自的专家一样好。
两两相加,在那两个对应任务上平均保留了专家 98.9% 的准确率。上图换了一个量法,每个点是一种向量子集,但成绩一律平均在全部八个任务上。作者扫过 种子集;0 个向量就是零样本的预训练模型,大约 69%,任务覆盖增加后,整体平均也提高。八个任务向量都可供选择时,找到的最佳多任务模型达到 91.2% 归一化准确率。
一个模型做八件事,和八个专家各自上场相比,差不到一成。但要注意,这也代表合并确实有损失,任务越多,越难完全保住。
归一化要先逐任务相除,再取平均。例如专家在两个任务分别是 80% 和 100%,合并后是 72% 和 95%,保留率是 ;原始平均准确率则是 83.5%,两者用途不同。论文的 91.2% 用来衡量保留各专家的程度。
系数用验证数据从 0 到 1、每次增加 0.05 搜索,所有相加向量共用一个 ,避免每个任务独立调系数导致组合爆炸。附录发现 0.3 到 0.5 是不少组合的好区域,但不同子集的最佳值差异仍大;可用向量越多,也未必全部放进去最好。
还有一个强基准不能漏。用全部八个任务数据直接做多任务微调,归一化准确率是 99.4%,高于任务算术最佳的 91.2%。任务算术换到的是模块化、不必重新取得各任务训练数据,以及合并时免训练的便利。数据可以集中、愿意再训练一次时,多任务微调仍值得优先比较。
自然语言方面,作者先在四个 GLUE 任务上微调 T5-base,再从 Hugging Face 上找了 427 个兼容的公开模型,把它们的任务向量一个一个加到自己的模型上,用验证集挑最好的那一个和系数。加上别人任务的向量,有时能让目标任务比单纯微调更好。
这次四个任务的平均分数从 78.1 到 78.6,MRPC 从 88.5 到 89.3,其余增幅约 0.2 到 0.7。它是「搜索很多候选,再选有帮助的向量」的结果。附录另外合并六个公开 T5 checkpoint 的成对组合,涵盖问答、摘要、情绪与文本生成,依任务使用 accuracy、exact match 或 ROUGE-2;不能拿同一个准确率数字概括全部文本任务。
类比:没有目标标注也能学
前面的 Yelp 与 Amazon 例子,在多种大小的 T5 上都比只用 Amazon 情感数据微调好,接近直接在目标数据上微调的表现。作者发现情感分类的向量要给比较大的权重,所以用了两个独立的系数。
例如以 Amazon 为目标的 T5-base,只用 Yelp 的情绪标注微调是 90.8%,加入领域类比后是 92.7%,直接在 Amazon 标注上微调是 93.2%。两个语言模型向量要有目标与辅助领域的无标注文本;「没有目标标注」仍然用到了目标领域数据。类比的作用,是用这些无标注文本估计领域移动,再把已学到的情绪分类方向接过去。
另一组实验用 ImageNet 和手绘素描数据集共有的 125 个类别,切成「照片/素描」×「两组类别」四个子群体。要改善「素描的狮子」这一类,就用
平均下来,比预训练模型高 3.4 个百分点,效果大约相当于替目标子群体多搜集并标注一百张左右的训练样本。
为什么加得起来
作者量了 CLIP 在九个任务上的任务向量,两两之间的余弦相似度。大多数组合只有 0.01 到 0.03,几乎互相垂直。比较高的都是语义相近的任务。MNIST 和 SVHN 都是认数字,是 0.18;GTSRB 的交通标志也要认数字,和这两者是 0.06;EuroSAT 和 RESISC45 都是卫星图像,是 0.05。
作者推测,正是这种接近垂直的关系,让向量相加时互相干扰很少。这只是观察上的推测;后来 Ortiz-Jimenez 等人进一步分析,认为关键在权重的「解耦」,而且这种性质是预训练带来的,在随机初始化的模型上做不到。
另外两个观察对实现很有用。第一,学习率越大,相加的效果退化得越快,比单一微调模型更敏感;作者建议用任务向量时,微调的学习率要保守一点。第二,任务向量在微调早期就朝最终的方向收敛,只微调几百步、拿中间的任务向量来加,准确率就差不多饱和了。
限制
作者自己列的限制很直接。任务向量只能用在同一个架构上;所有实验也都是从同一个预训练权重出发的模型。
他们也注意到,这个限制在实务上没那么严格。写论文的时候,Hugging Face 上已经有三千多个从同一个 BERT-base 微调出来的模型,从同一个 T5-small 出发的也有八百多个。
结论
任务算术把微调的结果写成一个向量,然后告诉我们,这些向量可以加、可以减、可以做类比,模型的行为大致也跟着照做。
它没有发明新的训练方法,用的仍然是一般的微调;新的是看待微调结果的方式。之后的 TIES-Merging、DARE 都从这个框架出发,各自处理向量相加时的干扰。
下次在 Hugging Face 上看到一个从你熟悉的基底微调出来的模型,可以先把它和基底相减,看看那个向量长什么样子。