原始论文
Git Re-Basin: Merging Models modulo Permutation Symmetries
- 发表版本
- ICLR 2023会议
- arXiv 首次提交
- arXiv:2209.04836
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmerginggitrebasin2022,
  title = {{Git Re-Basin: Merging Models modulo Permutation Symmetries}},
  author = {Samuel K. Ainsworth and Jonathan Hayase and Siddhartha Srinivasa},
  year = {2022},
  eprint = {2209.04836},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2209.04836}
}
隐藏层里的单元没有固定的顺序。把第 3 号和第 7 号单元对调,只要下一层读取输入的位置也跟着对调,网络算出来的东西一模一样。
这种排列的对称性,Hecht-Nielsen 在 1990 年就讨论过。它意味着同一个函数有大量不同的权重写法。论文算了几个常见架构的数量:
| 架构 | 隐藏单元的排列方式 |
|---|---|
| 三层 MLP,宽度 512 | |
| VGG16 | |
| ResNet50 | |
| 可观测宇宙的原子数上限 |
整理自原论文 Table 1。
两个从不同随机初始化训练出来的网络,直线混合时中间会冒出一道高墙,这件事大家早就知道。2021 年,Entezari 等人提出一个大胆的猜想,如果把排列的可能都考虑进去,SGD 找到的解之间,大多数沿直线混合都不会有障碍。换句话说,损失地形在「不计排列」的意义下,可能只有一个盆地。
华盛顿大学的 Samuel Ainsworth、Jonathan Hayase 与 Siddhartha Srinivasa 想把这个猜想变成能用的工具。给定两个独立训练的模型,能不能找到一个排列,把其中一个「搬」进另一个的盆地,再直接平均?
定义问题
衡量的方式沿用 Frankle 等人的损失障碍(loss barrier):
沿线最高的损失,减去两端损失的平均。等于 0,代表这条直线上没有隆起。
目标是找一个保持功能不变的排列 ,让 和 之间的障碍尽量小。对第 层,排列用一个置换矩阵 表示,模型 B 的权重换成
调换第 层输出单元的顺序, 让这一层读取输入的顺序,跟着上一层的换位一起变。
输入与输出的位置有语义,所以两端固定。图像的 RGB 通道、分类器的类别顺序,都不能为了让权重接近就任意交换。可动的是网络内部的隐藏维度,而且同一维度经过的偏置、归一化参数、分支连接都要一起换。残差相加的两条路径必须使用兼容的排列,不能逐层各自乱排。
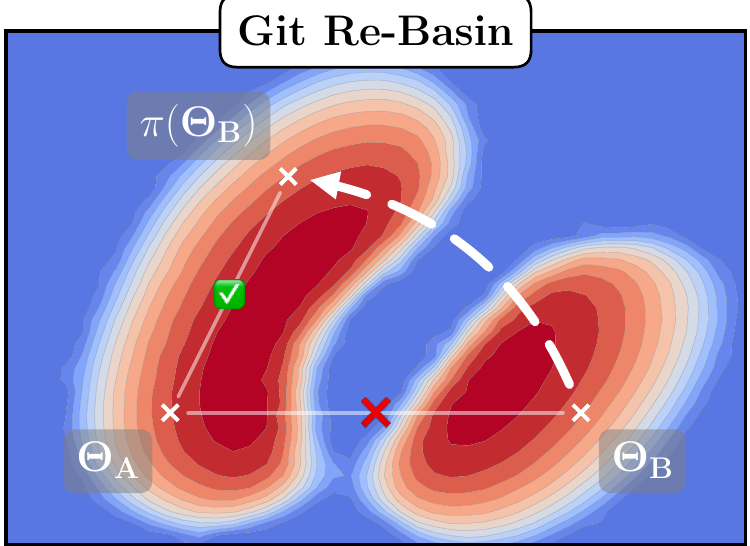
这张示意图就是整篇的目标。 和 在不同的谷里,直线中点掉出谷外;把 换成功能完全相同的 ,它就跑到 所在的谷,两者的中点也落在谷里。
解决问题
作者提出三种找排列的方法。
比对激活值
第一种最直觉。两个模型要解同一个任务,大概会学到相似的特征,只是位置不同。把训练数据喂进两个模型,收集第 层的激活值 ,找一个置换矩阵让两者最接近:
右边这个形式是经典的线性指派问题(linear assignment problem),有多项式时间的解法,例如匈牙利算法。每一层各自独立解,跑一遍数据就够。
比对权重
第二种完全不看数据,只看权重本身。
第一层权重的每一行,就是一个单元在看什么。如果 A 的第 行和 B 的第 行很像,这两个单元大概在算同一个特征。拿三个单元、四个输入的小例子算一次:
import numpy as np
from scipy.optimize import linear_sum_assignment

# 模型 A 第一層的三個單元,各有 4 個輸入權重
W_A = np.array([[ 1.0, -0.5,  0.2,  0.0],
                [ 0.1,  0.9, -0.8,  0.3],
                [-0.6,  0.0,  0.4,  1.1]])

# 模型 B 學到差不多的三個單元,只是順序換成 (A 的第 2, 0, 1 個),數值也略有不同
W_B = np.array([[-0.5,  0.1,  0.5,  1.0],
                [ 0.9, -0.4,  0.1, -0.1],
                [ 0.2,  1.0, -0.7,  0.2]])

S = W_A @ W_B.T                       # S[i, j]:A 的單元 i 和 B 的單元 j 有多像
print(S.round(2))
rows, cols = linear_sum_assignment(S, maximize=True)
print("A 的單元 i 配到 B 的單元", cols)
[[-0.45  1.12 -0.44]
 [-0.06 -0.38  1.54]
 [ 1.6  -0.61 -0.18]]
A 的單元 i 配到 B 的單元 [1 2 0]
相似度矩阵每一行最大的值,刚好指向正确的对应。A 的第 0 个单元配到 B 的第 1 个,第 1 个配到第 2 个,第 2 个配到第 0 个。这个例子的答案一眼就看得出来;真实网络有几百个单元,相似度也没有这么分明,就交给指派算法一次找出总和最大的配对。
找到排列后,还要把它套对。接一个输出层,检查模型 B 换位前后算出的值:
W_out = np.array([[1., -2., 0.5], [0.3, 0.4, -0.7]])
x = np.array([0.2, -0.1, 0.5, 1.0])
before = W_out @ np.maximum(W_B @ x, 0)
W_B_aligned = W_B[cols, :]       # 隱藏層換列
W_out_aligned = W_out[:, cols]  # 下一層的輸入換欄
after = W_out_aligned @ np.maximum(W_B_aligned @ x, 0)
print("換位前後功能相同:", np.allclose(before, after))
換位前後功能相同: True
这一步还没平均模型,只把 B 换成等价写法。对齐本身应保持 B 的输出;接下来和 A 平均,才会改变网络的函数。分开检查这两步,可以避免把排列套错和平均效果不好混为一谈。
麻烦在于层与层会互相牵动。一个隐藏单元的身份,既由它的输入权重决定,也由它送往下一层的权重决定;改了第 层的排列,第 层的输入顺序也得跟着改。把所有层合起来,目标是
作者证明这个「双线性指派之和」是 NP-hard,三层以上连常数倍的近似都没有多项式时间的方法。
他们的折衷是坐标下降。固定其他层,只看 ,问题就退化成一个普通的线性指派问题:
括号里第一项比的是输入端(已经照上一层排好),第二项比的是输出端(已经照下一层排好)。以随机顺序轮流更新每一层,直到排列不再改变。作者说实际上几秒到几分钟就收敛。
每次只接受让整体内积提高的排列,可选的排列又只有有限多个,因此过程会停止。但目标是让权重接近,没有直接最小化数据上的损失,而且停止点只是坐标更新找不到改进的位置。作者在 ImageNet 的对照中特别限制只扫一遍,合并模型的 top-1 准确率约只有 7%;反复扫到收敛则是 51.01%。前一层排好就再也不回头,会漏掉后面各层提供的信息。
用直通估计器学排列
第三种直接把排列当成可学的东西,最小化 和投影后的 平均之后的损失。投影到最近的排列这一步不可微分,就用直通估计器(straight-through estimator)处理,前向传播用投影后的权重,反向传播时当作没有投影。
这个方法效果最好,但要跑一整个训练循环,成本高得多。
更精确地说,优化器保存一份可自由改动的 。每次前向,先从 B 的所有等价排列中找最接近它的 ,再算 的训练损失。投影仍沿用权重匹配;反向时把投影近似成恒等映射,让梯度能回到 。最后交付的是原模型 B 的某个排列,所以 B 端点的函数依然不变。
| 对齐法 | 用到数据吗? | 优化什么? | 主要代价 |
|---|---|---|---|
| Activation matching | 要,收集中间表示 | 各层激活值的匹配程度 | 前向数据与各层指派 |
| Weight matching | 不用 | 全网络权重内积 | 重复解逐层指派 |
| STE matching | 要,计算合并损失 | 中点模型的训练损失 | 训练循环加上反复投影 |
数据相同、架构兼容时,可以选 activation 或 STE;原训练数据无法取得时,weight matching 仍能运作。代价最小的选项,也是论文后面拿来合并分开训练模型的工具。
讨论
排好之后,直线就通了
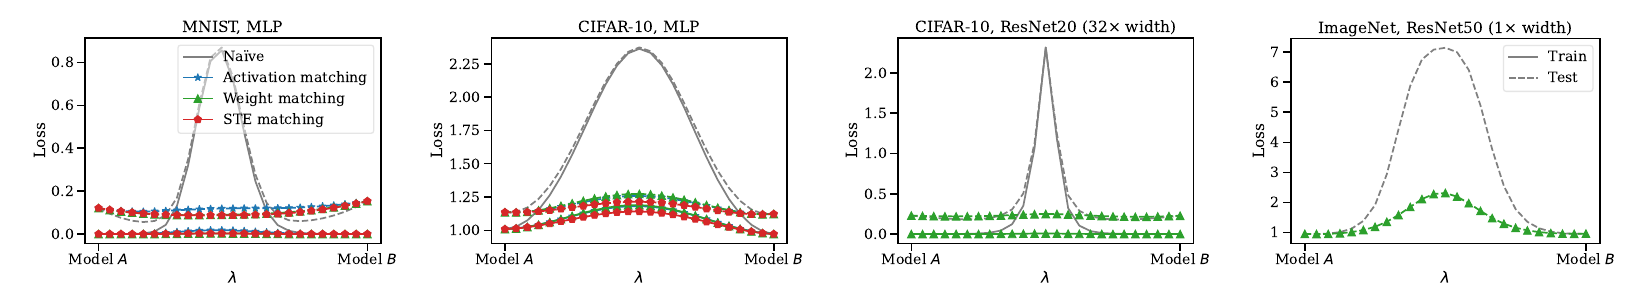
四张图从左到右,数据与模型越来越难。灰线是直接插值,每张图的中间都有一座山;三种排列方法都把山压低了。
MNIST 上,三种方法都做到零障碍;用权重匹配和直通估计器时,测试损失的曲线甚至变成凸的,中间的混合模型比 A、B 都好。CIFAR-10 上,把 ResNet20 加宽到 32 倍后也是零障碍,作者说这是他们所知第一次在 ResNet 上做到。ImageNet 上的 ResNet50 还有一个小山丘,障碍比直接插值少了 67%,没有归零。
三种方法的差距不大。直通估计器最好但最贵;权重匹配完全不用数据,只花几秒,却和需要数据的激活比对差不多。作者认为它在成本和效果之间取得了很好的平衡。
这几组实验还有容易漏看的架构差异。MLP 有三个各 512 单元的隐藏层、ReLU、没有归一化;CIFAR 的 VGG 与 ResNet20 则把归一化换成 LayerNorm,加上裁切、旋转与翻转,用 momentum SGD 训练。ImageNet 的 ResNet50 才保留标准 BatchNorm,而且每个插值模型都重算 BatchNorm 统计量。直接拿标准 BatchNorm 的 CIFAR 模型照做,量到的曲线可能会不同。
67% 是损失障碍的相对降幅,和准确率增加 67 个百分点是两回事。前面提到 ImageNet 合并中点的 51.01% top-1,也显示障碍大幅降低后,中间模型仍可能远弱于两个端点。这里的主要成果,是说明哪些条件下能找到低障碍排列,尚未把独立 ImageNet 模型的无损合并解完。
越宽越好连
为什么 ImageNet 没有归零?作者怀疑是宽度不够。
他们在 CIFAR-10 上把 VGG-16 和 ResNet20 的宽度逐步加大,再做权重匹配。标准宽度的模型看不到线性连通;宽度一加大,障碍一路降到 0。作者的假设是,模型需要足够的容量(特别是宽度)去容纳数据的复杂度,线性连通才会出现。
这也表示,窄的模型要么是排列找得不够好,要么还有排列以外的对称性没被考虑,例如跨层的缩放。作者在讨论里把排列对称性定位成「必要、但不完整」的一块。
训练出来的,不是一开始就有
另一个观察是,线性连通是训练过程中慢慢出现的。作者在 MNIST 和 CIFAR-10 的 MLP 上,每个 epoch 都做一次比对再量障碍,训练初期障碍很高,之后才逐渐下降。
他们也构造了一个反例。有一些不是用 SGD 找到的解,不管怎么排列,都无法和其他解线性连通。这不违反 Entezari 的猜想,猜想本来就只谈 SGD 的解;但它暗示,能找到线性连通,部分要归功于 SGD 本身的偏好。
反例只有两维输入、两个各含两单元的隐藏层。两个模型都完美解出同一个分类问题,但把「判断第一维」和「判断第二维」放在不同层;只在各层内换单元,无法把跨层的分工搬过去。小网络的全部排列都能枚举,作者逐一检查后仍有障碍。这比单纯搜索没找到排列更有力,也说明可用的对称性不只单元换位。
分开训练,合在一起
最后一个实验最接近实际用途。作者把 CIFAR-100 切成两半,数据集 A 包含 0 到 49 类样本的 20% 和 50 到 99 类样本的 80%,数据集 B 反过来,各训练一个 ResNet20。
用权重匹配合并两者,合并模型在整个测试集上的损失比 A、B 都低,内存和计算量只有集成的一半,概率估计的校准也比两个原始模型好。它仍然比不上用全部数据训练的模型,也比不上两个模型的集成;直接插值则差得多。
这两份训练数据互不重叠,但两个模型都看得到全部 100 个类别,只是比例相反。分类头的输出语义因此能保持一致。结果改善的是交叉熵与概率校准,分类准确率没有同时超过两个原始模型。若把实验简化成「不同数据各练一个,合起来全面更好」,就会遗失这项取舍。
附录另做了多模型版本。每次把一个模型对齐到其余模型的平均,轮流更新,再取全体平均;32 个各看一半 MNIST 数据的 MLP,合并后校准接近输出集成,推理只保留一个。这提供了双模型以外的示例,规模与数据难度仍和现代大型语言模型有一段距离。
结论
Git Re-Basin 把「不同初始化的模型不能平均」这件事,改写成「先排好座位,再平均」。权重匹配不需要任何数据,几秒就能跑完,在够宽的网络上可以把障碍压到零。
它也划出了边界。网络要够宽,ImageNet 上的标准 ResNet50 还做不到零障碍。后来的 REPAIR 发现,对齐后的平均模型,激活值的方差会塌缩,重新缩放之后,ImageNet 上的障碍又能再降一截。
后来常见的大型语言模型合并,多从同一份预训练 checkpoint 的微调版本出发,先沿用共同的参数坐标。若手上是独立训练的模型,就得先处理这篇提出的对齐问题,再检查合并后的功能能保留多少。