原始论文
Task Arithmetic in the Tangent Space: Improved Editing of Pre-Trained Models
- 发表版本
- NeurIPS 2023会议
- arXiv 首次提交
- arXiv:2305.12827
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingtangenttaskarithmetic2023,
  title = {{Task Arithmetic in the Tangent Space: Improved Editing of Pre-Trained Models}},
  author = {Guillermo Ortiz-Jimenez and Alessandro Favero and Pascal Frossard},
  year = {2023},
  eprint = {2305.12827},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.12827}
}
任务算术告诉我们,把微调前后的权重相减得到「任务向量」,这些向量可以加、可以减。加上两个任务的向量,模型两件事都会做;减掉一个,模型就忘了那件事。
效果很好,但原因一直不太清楚。
当时比较流行的解释是这样的。大型预训练模型微调时,权重只移动一点点,网络在这个小范围内大致是线性的;既然是线性的,权重相加,输出当然也跟着相加。
EPFL 的 Ortiz-Jimenez、Favero 与 Frossard 决定认真检查这个说法。结果他们发现这个解释是错的,但顺着错误的方向走下去,反而得到一个更好的方法。
定义问题
任务算术要成立,需要什么
先把「任务算术成立」写清楚。令 是预训练权重,任务 微调后是 ,任务向量 。每个任务有自己的输入范围 ,例如 EuroSAT 的卫星图像、SVHN 的门牌数字,而且不同任务的输入范围互不重叠。
作者把任务算术写成一个性质:
通俗地说,把好几个任务向量同时加上去之后,看到卫星图像时,模型的行为要和「只加了卫星图像那个向量」一样;看到不属于任何任务的输入时,要和预训练模型一样。每个向量只改自己那一块,不打扰别人。
线性的假说
神经网络在 附近可以做一阶泰勒展开:
右边对 是线性的,等价于一个核方法,核函数就是神经正切核(neural tangent kernel, NTK)。
如果微调真的发生在这个线性范围里,加上 时,输出的变化就是两个任务各自变化的总和,任务算术看起来就会自动成立。
那么,CLIP 微调时到底是不是线性的?
解决问题
检查一:微调不是线性的
如果微调是线性的,把微调后的任务向量 套到线性近似上,结果应该和原本的微调模型差不多。作者把这叫做事后线性化(post-hoc linearization):
实验沿用任务算术原论文的设置,CLIP 的 ViT-B/32、ViT-B/16、ViT-L/14,在 Cars、DTD、SUN397、EuroSAT、GTSRB、MNIST、SVHN、RESISC45 八个数据集上微调。
结果是事后线性化的单任务准确率明显低于原本的微调模型,三种大小的 ViT 都一样。作者称这个落差为「非线性优势」。微调并没有留在线性范围内。
还有一种可能是,非线性的部分虽然对单一任务重要,但任务算术只用到线性的部分。作者也检查了这一点。拿非线性微调的任务向量,在事后线性化的模型上做八个任务相加:
| 模型 | ViT-B/32 | ViT-B/16 | ViT-L/14 |
|---|---|---|---|
| 预训练(零样本) | 48.4 | 55.2 | 64.4 |
| 非线性微调 | 71.4 | 75.5 | 85.1 |
| 事后线性化 | 57.1 | 65.0 | 75.2 |
表中是八个任务的平均绝对准确率(%)。事后线性化掉了 10 个百分点以上,任务算术显然也用到了非线性的部分。线性假说不成立。
但表格里还藏着一个奇怪的地方。若改看归一化准确率,也就是除以各自单任务微调的准确率,事后线性化反而比较高。ViT-B/32 上非线性微调是 76.5%,事后线性化是 81.9%。任务遗忘也一样,事后线性化忘得更干净。
线性化的模型虽然每个任务都做得比较差,「相加之后保留多少」却做得比较好。
权重解耦
作者认为任务算术需要的条件是权重解耦(weight disentanglement):
其中 只在 上不为零, 只在所有任务范围之外不为零。模型的输出可以拆成几块互不重叠的局部函数,每一块只由自己的任务向量控制。
这个条件和前面的任务算术性质是等价的,而且它不要求线性, 对参数可以是任何形状的函数。作者还特别提醒,权重解耦说的是「互不干扰」,和每个任务做得好不好是两件事。
要测量解耦程度,作者定义两个任务之间的解耦误差:
意思是在任务 的数据上,「只加自己的向量」和「两个都加」预测不一样的比例。误差越小,两个向量越互不干扰。
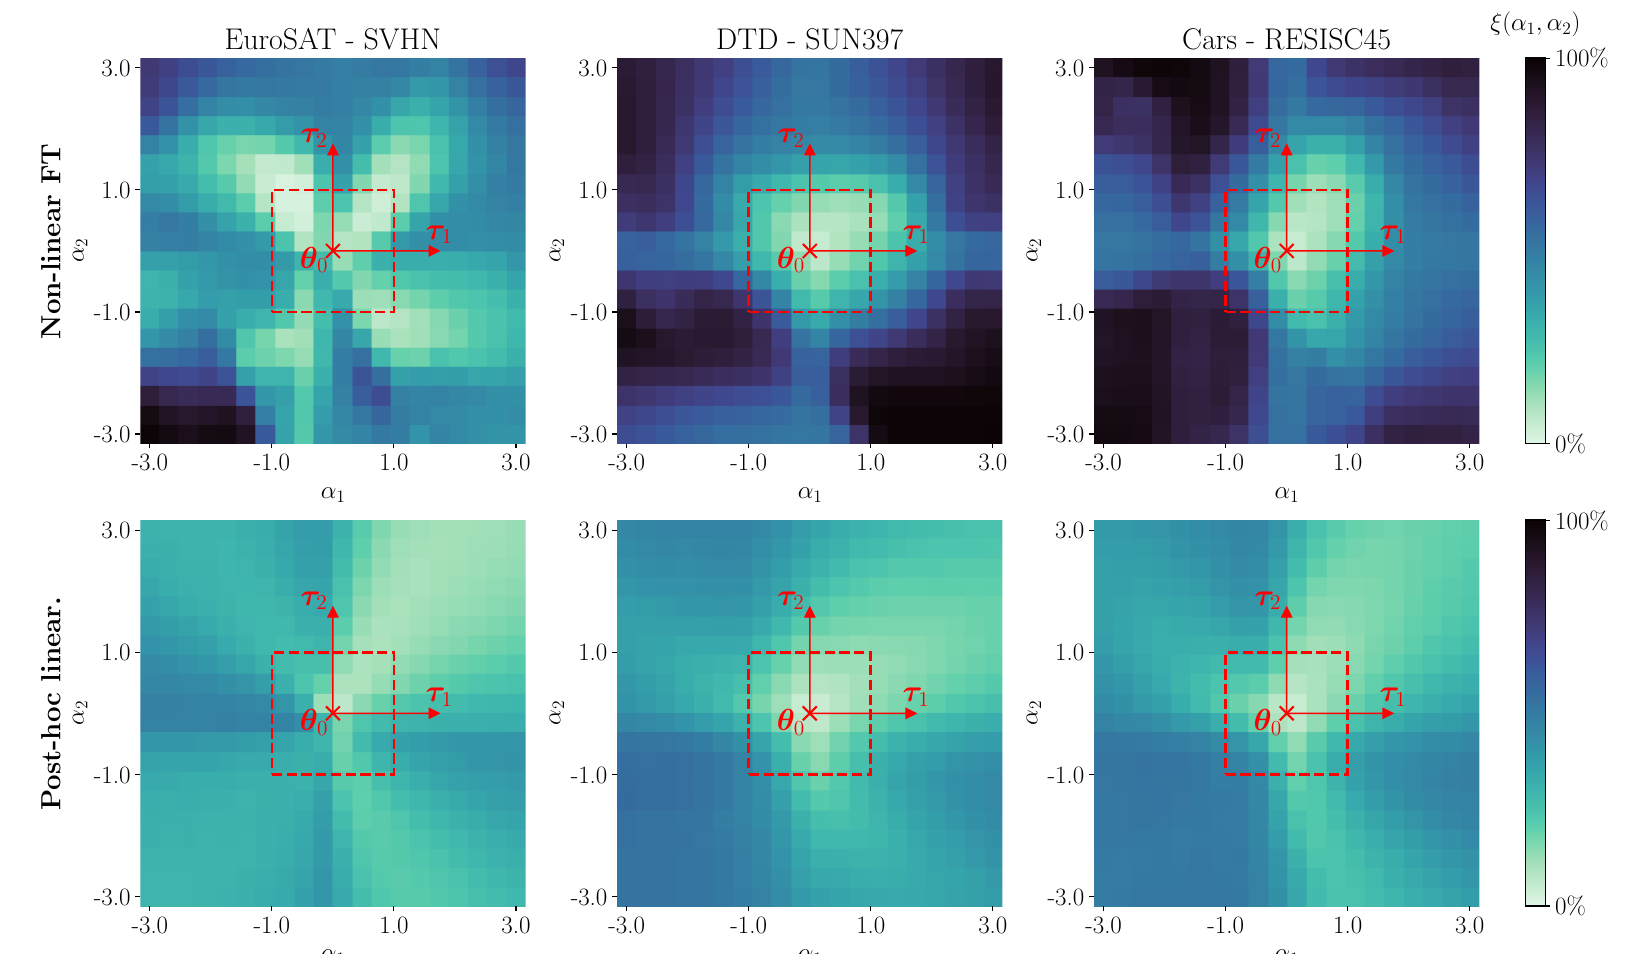
每张图的中心是预训练权重 ,两个红色箭头是两个任务向量。上排的非线性模型只在原点附近一小块是浅色的, 超过 1 之后误差就快速上升。这解释了任务算术原论文的两个经验观察:最佳系数通常小于 1,而且微调时学习率要小、步数要少。
下排的事后线性化模型,浅色区域大了很多。线性化让任务向量之间更互不干扰,这就是它归一化准确率较高的原因。
问题变得很清楚。线性化的模型解耦得好,但单任务太弱;非线性模型单任务强,但解耦较差。能不能两边都要?
直接在切空间里微调
作者的做法是不要事后才线性化,而是一开始就用线性化的模型来微调。
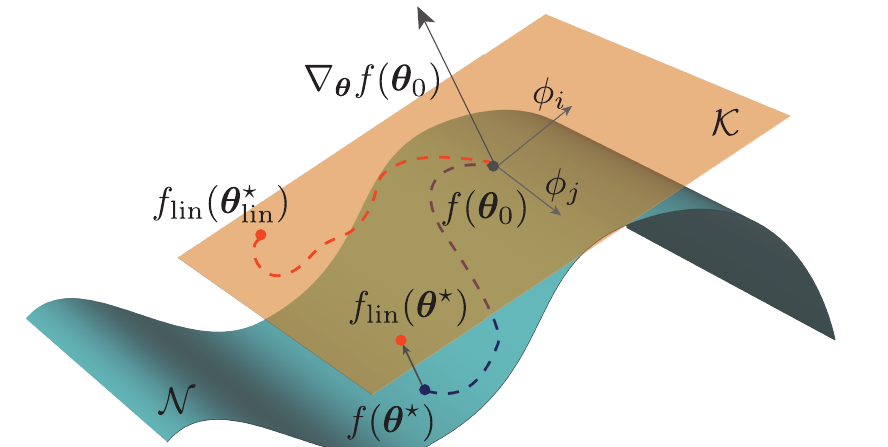
这张图把三种做法放在一起。弯曲的曲面 是所有网络函数,平面 是在 处的切空间。一般微调沿着曲面走到 ;事后线性化是把这个终点投影到平面上,所以会掉准确率;线性化微调则从头到尾都在平面上走,优化的目标就是平面上的最佳点 。
两种线性模型的核函数相同,但任务向量 是直接针对线性模型优化出来的,所以单任务表现好很多。
实现上,线性化模型就是一个「固定 、训练位移量」的网络。PyTorch 的 torch.func.jvp 可以在一次前向传播中同时算出 和 Jacobian 乘上位移的结果。用一个小 MLP 看看线性近似什么时候准:
import torch
from torch.func import functional_call, jvp

torch.manual_seed(0)
net = torch.nn.Sequential(torch.nn.Linear(4, 16), torch.nn.Tanh(), torch.nn.Linear(16, 2))
theta0 = {k: v.detach().clone() for k, v in net.named_parameters()}
x = torch.randn(8, 4)

def f(params):
    return functional_call(net, params, (x,))

def f_lin(params):
    delta = {k: params[k] - theta0[k] for k in params}
    out, dp = jvp(f, (theta0,), (delta,))     # f(θ0) 与 J·(θ − θ0),一次前向就算完
    return out + dp

direction = {k: torch.randn_like(v) for k, v in theta0.items()}
for scale in [0.01, 0.1, 1.0]:
    theta = {k: theta0[k] + scale * direction[k] for k in theta0}
    gap = (f(theta) - f_lin(theta)).abs().max().item()
    print(f"位移倍率 {scale:<4}  原模型与线性化模型的最大差距 {gap:.5f}")
位移倍率 0.01  原模型与线性化模型的最大差距 0.00152
位移倍率 0.1   原模型与线性化模型的最大差距 0.13638
位移倍率 1.0   原模型与线性化模型的最大差距 8.19715
位移小的时候两者几乎一样,位移一大,差距就快速拉开。一般微调走到哪里,线性模型管不着;线性化微调则把模型绑在切空间里,不管走多远,权重和输出的关系都是线性的。
在论文的实验中,作者只线性化 CLIP 的图像编码器,文本编码器本来就冻结。训练设置和一般微调完全相同,2,000 步、批量 128、学习率 、AdamW 搭配 cosine 调度,也没有另外调超参数。
讨论
加法与减法都变好了
最后一行是线性化微调的结果:
| 任务相加(绝对/归一化 %) | ViT-B/32 | ViT-B/16 | ViT-L/14 |
|---|---|---|---|
| 非线性微调 | 71.4/76.5 | 75.5/80.0 | 85.1/88.8 |
| 线性化微调 | 76.5/85.4 | 81.3/86.0 | 88.5/93.5 |
八个任务相加的平均绝对准确率,三种模型分别提升 5.1、5.8、3.4 个百分点。
任务遗忘的评估方式,是减掉某个任务向量后,在控制任务 ImageNet 至少保留 95% 预训练准确率的条件下,看目标任务能降到多低。非线性微调在 ViT-B/32 上把目标任务降到 24.0%,线性化微调降到 10.9%,多忘掉 13.1 个百分点;ViT-L/14 从 18.0% 降到 7.9%。控制任务的准确率几乎一样。
系数的选法和原论文一致,所有任务共用一个 ,在 0 到 1 之间以 0.05 为间隔,用一小部分训练数据挑最好的值。
线性化的好处在小模型上最大,模型越大,差距越小。附录也发现越大的模型本身就越解耦。
代价
线性化不是免费的。附录说明,推理时每一步运算都要多算一次导数,大约是原模型的二到三倍时间;训练时梯度的计算量与内存也大约加倍。作者把这写成「只有常数倍的增加」,但对大型模型来说,两三倍的推理成本会直接反映在部署上。
后来的研究也是从这里切入。像 Partial Linearization 只线性化 LoRA 的 adapter,把成本压在一小部分参数上。
为什么会解耦
作者最后从核方法的角度给了一个解释。核函数可以分解成一组特征函数 。如果每个任务只用到「只在自己输入范围内不为零」的那些特征函数,不同任务之间就不会互相干扰。
他们在 ViT-B/32 上实际检查。在 RESISC45 上做线性化微调,对它的 NTK 做特征分解,再计算每个输入点上特征函数的能量总和。RESISC45 的数据点能量明显较高,当作对照的 Cars 数据点则很低。用来表示 RESISC45 的特征函数,确实集中在 RESISC45 的数据上。
作者也说明,这种局部化不是任务算术的必要条件,特征函数在其他区域也可能互相抵消;只在特征函数于各区域内线性独立时,它才变成必要条件。
解耦是预训练学来的
最后一个实验把预训练拿掉。从随机初始化的 ViT 出发,各自在八个任务上微调得到任务向量,再相加。
结果任务算术完全失效。ViT-B/32 随机初始化后非线性微调的单任务平均是 48.5%,八个向量相加之后只剩 5.5%,和随机初始化、还没微调的模型(5.3%)差不多;线性化微调也一样。
所以权重解耦是在预训练时出现的。预训练不只学出把语义分开的特征,也让控制这些语义区域的权重方向彼此分开。
证据的范围
主要实验都在 CLIP ViT 与八个图像分类数据集上,附录另外做了 T5 与卷积网络。任务之间「输入范围互不重叠」是整套定义的前提,这在八个数据集上大致成立;当两个任务的输入本来就重叠,例如同一份文本的两种标注,这套分析不能直接套用。
结论
这篇论文先推翻了「任务算术来自线性微调」的说法,再把任务算术需要的条件写成权重解耦,也就是不同的任务向量各自只影响自己的输入范围。
线性化的模型解耦得比较好,只是单任务太弱。把微调直接搬到切空间做,两边的好处就能一起拿到,代价是推理多花两三倍的时间。
如果你的部署预算吃得下这个倍数,又常常需要把一堆任务向量加在一起,线性化微调值得一试,官方代码把线性化模型包成一般的 nn.Module,训练脚本几乎不用改。
预算吃不下也没关系,把系数压在 1 以内就好。超过 1,任务向量就开始互相打架了。