原始论文
2 OLMo 2 Furious
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2501.00656
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{transformersolmo22024,
  title = {{2 OLMo 2 Furious}},
  author = {Team OLMo and Pete Walsh and Luca Soldaini and Dirk Groeneveld and Kyle Lo and Shane Arora and Akshita Bhagia and Yuling Gu and Shengyi Huang and Matt Jordan and Nathan Lambert and Dustin Schwenk and Oyvind Tafjord and Taira Anderson and David Atkinson and Faeze Brahman and Christopher Clark and Pradeep Dasigi and Nouha Dziri and Allyson Ettinger and Michal Guerquin and David Heineman and Hamish Ivison and Pang Wei Koh and Jiacheng Liu and Saumya Malik and William Merrill and Lester James V. Miranda and Jacob Morrison and Tyler Murray and Crystal Nam and Jake Poznanski and Valentina Pyatkin and Aman Rangapur and Michael Schmitz and Sam Skjonsberg and David Wadden and Christopher Wilhelm and Michael Wilson and Luke Zettlemoyer and Ali Farhadi and Noah A. Smith and Hannaneh Hajishirzi},
  year = {2024},
  eprint = {2501.00656},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2501.00656}
}
这篇报告的标题是个玩笑,模仿电影《速度与激情 2》的英文片名「2 Fast 2 Furious」。
内容倒是很认真。OLMo 是艾伦人工智能研究所(AI2)的「完全开放」语言模型系列,不只公开权重,连预训练数据、训练代码、中间 checkpoint、训练日志都公开。这类模型对研究很重要,想研究训练动态、数据与记忆之间的关系,只有完全开放的模型能用;但它们的表现一直落后只公开权重的模型一截。
OLMo 2 想缩小这段差距。它有 7B、13B、32B 三种大小,最多训练到 6.6T 个 token,后训练直接套用同团队的 Tülu 3 配方。报告把重点放在四件事:预训练的稳定性、中期训练(mid-training)的配方、后训练,以及基础设施。
这篇笔记主要看前两件。第一件是 OLMo 2 能长大的前提;第二件则用到了模型合并。
定义问题
前一版 OLMo-0424 的表现在预期范围内,但训练过程很不安稳。
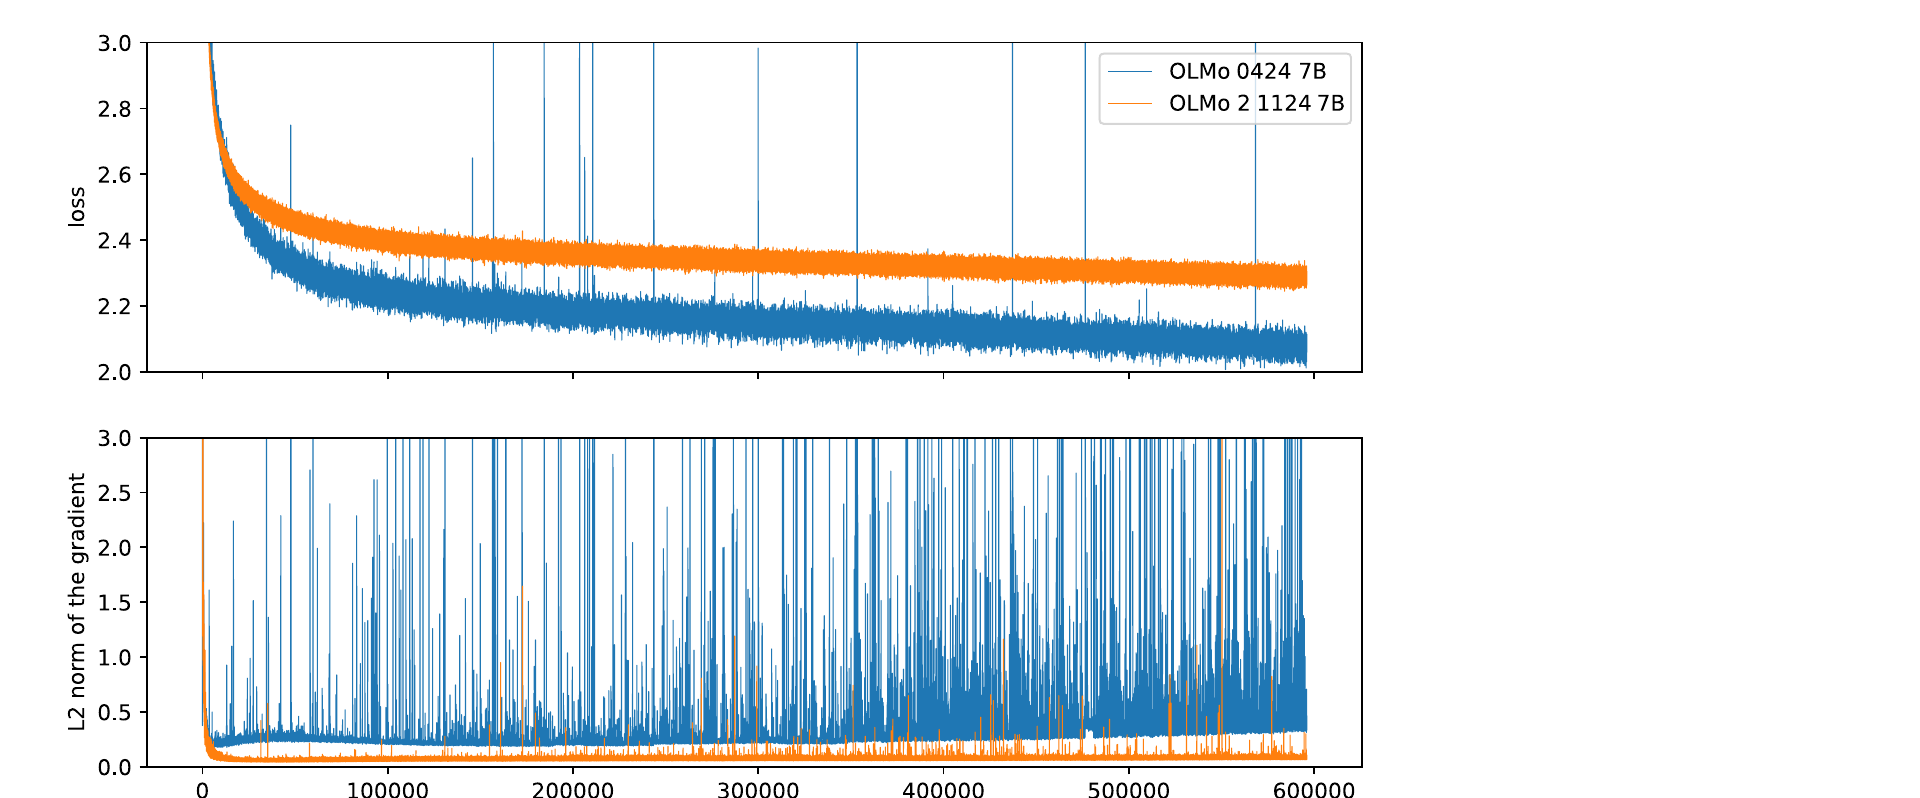
蓝色是 OLMo-0424,问题有两个。第一是损失与梯度范数的突然尖峰,而且梯度的尖峰常常出现在损失尖峰之前。第二是梯度范数的基准线在整个训练过程中慢慢变大,尖峰也随之越来越频繁。作者发现模型越大,尖峰越多,两者加起来最终会让训练发散,根本没办法扩大规模。
橙色是 OLMo 2,梯度几乎贴在底部。上图的橙色损失看起来比较高,是因为两次训练用的数据不同,不能直接比。
那么,哪些改动把蓝线变成了橙线?
解决问题
稳定性的七个改动
作者一共做了七个改动,有的动数据,有的动架构,有的只是改一个超参数。
1. 过滤重复的 n-gram。 作者检查发生尖峰的 batch,常常看到像 g400g400g400g400... 或一长串 255, 255, 255, ... 这种重复片段。关系并不确定,同样的片段在大模型上会引发尖峰,在小模型上却不会;换个数据顺序也可能就没事。但整体而言,去掉这类数据能降低尖峰的频率。
做法是在数据整理时,删除含有 32 次以上重复 n-gram 的文档(n 从 1 到 13 个 token);训练代码在加载数据时也会再检查一次,把漏网之鱼的损失屏蔽掉。这能明显减少梯度尖峰,但对梯度范数慢慢上升的问题没有帮助。
2. 初始化。 OLMo-0424 用的是缩放初始化,越深的层初始值越小。OLMo 2 改回最简单的做法,所有参数都从均值 0、标准差 0.02 的正态分布采样。作者测量了随机初始化的模型中,激活值与梯度从第一层到最后一层的放大或缩小程度,新的初始化在不同深度与宽度下都比较能保持尺度不变。
3. RMSNorm。 把不带参数的 LayerNorm 换成 RMSNorm。
4. 归一化的位置。 这是一个比较少见的选择。一般的 Pre-LN 是先归一化输入,再送进注意力或前馈层;OLMo 2 改成归一化子层的输出:
这个做法来自 Swin Transformer V2。残差主干 本身没有被归一化,但每一层加上去的增量都先被压到固定尺度,不会有某一层突然加入很大的值。
5. QK-norm。 在计算注意力之前,先对 query 和 key 做 RMSNorm,避免注意力的 logit 变得太大。
6. Z-loss。 在损失中加上 , 是输出层 softmax 的分母。只要 logit 整体一路变大, 就跟着变大,这一项会把它拉回来。
这一项还有个插曲。FlashAttention 库的交叉熵实现内置 z-loss,作者另外用 PyTorch 写了一个版本备用。两者前向传播的结果相同,反向传播却不一样,作者怀疑是数值精度的差异。虽然训练损失与下游表现都看不出影响,作者还是决定丢掉换过实现的那段训练,回到分歧点用原本的实现重跑。训练进行到一半,他们尽量不换任何实现。
7. 两个优化器设置。 嵌入层不再做权重衰减;AdamW 的 从 降到 。后者让训练初期的梯度范数更低、更稳定。
这七个改动,没有一个是新发明。作者的贡献在于一个一个做实验、量出它们在 OLMo 这个设置下的效果,再全部放进同一个配方。
两阶段预训练
OLMo 2 的预训练分成两个阶段。
第一阶段占训练计算量的九成以上,使用约 3.9T token 的 OLMo 2 Mix 1124,其中超过 95% 是网页数据(主要来自 DCLM),其余是代码(StarCoder)、论文(peS2o、arXiv)、数学网页与维基百科。代码数据只保留 GitHub 星数至少 2 的仓库;最常出现的一个词超过全文 30% 的文档也会被删掉,以去除二进制或几乎全是数字的内容。
第二阶段作者称为中期训练,占计算量的 5% 到 10%。学习率在这个阶段线性降到 0,数据换成精选的 Dolmino Mix 1124:质量分类器挑出的前 7% 网页、去污染的 FLAN 指令数据、论文、维基百科、Stack Exchange 问答,再加上专门补数学能力的合成数据。
效果很大。7B 模型经过中期训练后,开发评测的平均分数提升了 10.6 分,超过了只做完第一阶段的 13B。GSM8K 从 24.1 升到 67.5,MMLU 从 59.8 升到 63.7,DROP 从 40.7 升到 60.8。
用小退火筛数据
中期训练的数据要怎么选?完整跑一次 50B token 的退火太贵,作者发明了一个便宜的方法,叫做 microanneal。
- 挑出想评估的一个或一小组数学数据来源。
- 从通用数据中取等量的 token,组成一半数学、一半通用数据的小混合。
- 把这个小混合当成退火来训练,学习率依照它的长度线性降到 0。
一共跑了 19 次 microanneal,总共 130B token,比三次完整的 50B 退火还少,而且通常训练不到 10B token 就看得出差异。这个想法和 Llama 3 用退火评估小数据集很像,只是做得更系统。
中期训练的模型汤
接下来是本笔记最关心的一步。中期训练结束时,作者没有只跑一次,而是用同一份数据、不同的数据顺序跑好几次,再把结果平均。
为了验证这么做有用,作者在 7B 上比较了六种中期训练配比,每种都用三个不同的数据顺序各跑 50B token,比较「三次中最好的一个」与「三个平均起来」:
| 配比 | 评测 | 最好的单一模型 | 三个平均 |
|---|---|---|---|
| A | OLMES | 75.6 | 77.0 |
| B | OLMES | 75.3 | 77.3 |
| C | OLMES | 76.3 | 76.8 |
| A | MMLU | 61.2 | 62.0 |
| B | MMLU | 61.5 | 62.7 |
| C | MMLU | 62.8 | 63.5 |
六种配比、四类评测共二十四组比较,有二十三组平均后不比最好的单一模型差,多数更好,例如配比 B 的 OLMES 多了 2 分。例外是配比 E 的 GSM*,平均后从 60.5 掉到 43.0。
所以最终的 OLMo 2 都是「汤」。7B 平均了三个各跑 50B token 的模型;13B 与 32B 平均了四个,三个各跑 100B token,另一个跑 300B token,作者发现这比只平均三个 100B 的效果更好。
这里值得和 Tülu 3 对照一下。同一个团队在 SFT 阶段平均不同种子的模型,发现没有比最好的单一模型好;在中期训练平均不同数据顺序的模型,却几乎每一组都有效。两者的差别在于,中期训练的每个模型都看了 50B 以上的 token,又都从同一个预训练 checkpoint 出发、把学习率降到 0,条件很接近 Model Soups 与 PMA 研究的情境。论文没有正面比较这两种结果,这只是本文的推测。
后训练
后训练基本照搬 Tülu 3:SFT、长度归一化的 DPO、RLVR。改动有两个。偏好数据改用许可宽松的模型生成回答;RLVR 分成多个阶段进行,以取得最佳表现。
讨论
计算量与表现的帕累托前沿
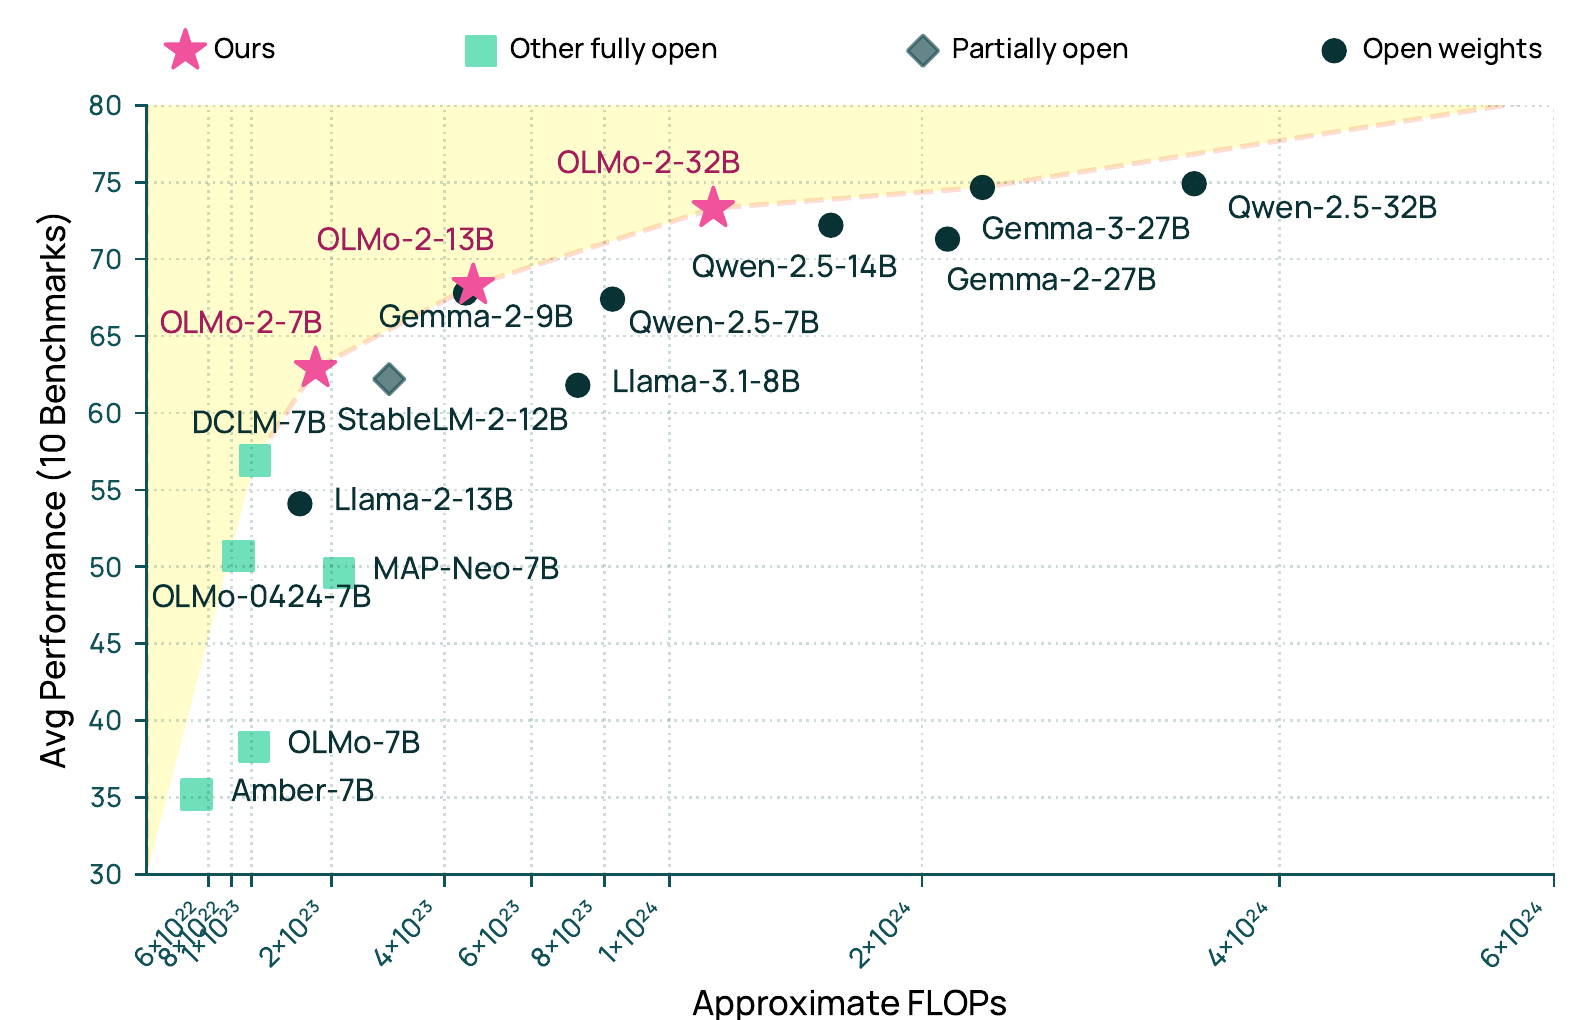
横轴是预训练计算量,纵轴是基底模型在 10 个基准上的平均。粉红星星落在左上方的虚线上,说明同样的计算量,OLMo 2 的表现比较好;或同样的表现,它用的计算量比较少。例如 OLMo 2 13B 和 Gemma 2 9B 的分数相近,Qwen 2.5 7B 则用了更多计算才达到差不多的位置。
绿色方块是其他完全开放的模型,大多落在左下方,OLMo 2 和它们拉开了一大段距离。
后训练版本的比较,取自报告 Table 7 的平均分数:
| 模型 | 平均 | 预训练 FLOPs() |
|---|---|---|
| OLMo 2 7B Instruct | 56.5 | 1.8 |
| Llama 3.1 8B Instruct | 59.1 | 7.2 |
| Qwen 2.5 7B Instruct | 61.6 | 8.2 |
| OLMo 2 13B Instruct | 63.5 | 4.6 |
| OLMo 2 32B Instruct | 68.8 | 13.0 |
| Qwen 2.5 32B Instruct | 68.1 | 35.0 |
| GPT-4o mini | 65.7 | — |
7B 仍落后 Llama 3.1 8B 与 Qwen 2.5 7B,但预训练计算量只有它们的四分之一左右。32B 则以不到 Qwen 2.5 32B 四成的计算量,取得略高的平均分数,也超过 GPT-4o mini。
读这份报告要注意的事
- 稳定性的证据多半是单一设置下的训练曲线比较,七个改动是一起放进去的,个别贡献只有部分消融。
- GSM8K 的处理。作者在发现预训练后的数学能力很差时,从 GSM8K 的 1,319 题中抽了 200 题当中期训练的开发集,所以 GSM8K 不完全是未见过的评测。报告的最终成绩只用剩下的 1,119 题,作者在脚注中明确交代了这件事。
- 模型汤的证据来自 7B 上 50B token 的中期训练,13B 与 32B 的四模型组合只说「实验上较好」,没有完整的表格。
结论
OLMo 2 是一份很实在的工程报告。它没有新的架构,而是把稳定性、数据配比、评估方法一件一件做扎实,让一个完全开放的模型第一次站上计算效率的前沿。
对模型合并来说,它提供了一个干净的正面案例:同一个起点、同一份数据、不同的数据顺序,退火完平均起来,几乎不会比最好的那一个差。
手上有多余算力的话,不必只押一个数据顺序。多跑两次中期训练,平均起来,比挑出最好的那一次更划算。