原始论文
Model Merging in Pre-training of Large Language Models
- 发表版本
- NeurIPS 2025会议
- arXiv 首次提交
- arXiv:2505.12082
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingpretrainingmerging2025,
  title = {{Model Merging in Pre-training of Large Language Models}},
  author = {Yunshui Li and Yiyuan Ma and Shen Yan and Chaoyi Zhang and Jing Liu and Jianqiao Lu and Ziwen Xu and Mengzhao Chen and Minrui Wang and Shiyi Zhan and Jin Ma and Xunhao Lai and Deyi Liu and Yao Luo and Xingyan Bin and Hongbin Ren and Mingji Han and Wenhao Hao and Bairen Yi and LingJun Liu and Bole Ma and Xiaoying Jia and Xun Zhou and Siyuan Qiao and Liang Xiang and Yonghui Wu},
  year = {2025},
  eprint = {2505.12082},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2505.12082}
}
预训练一个大型语言模型,最难熬的是不知道它最后会有多好。
现在常用的学习率调度叫 WSD(Warmup-Stable-Decay)。先短暂预热,接着用固定的学习率训练很长一段时间,最后再把学习率降下来「退火」。问题是固定学习率阶段的 checkpoint 分数总是偏低,要等退火完,才看得到模型最后的水平;想知道训练方向对不对,就得另外拉一条分支去退火,每次都要再花上几百亿到上千亿个 token。
模型合并的研究大多在微调之后,把几个不同任务的模型合在一起。预训练阶段的合并则是另一回事,合的是同一条训练轨迹上的 checkpoint。Llama 3 和 DeepSeek-V3 的技术报告都提到用了这类技巧,但没有交代细节;一般研究者也拿不到大规模预训练的中间 checkpoint,很难自己研究。
ByteDance Seed 的这篇论文从头训练了一系列稠密与 MoE 模型,最大到 200B 总参数,把预训练中的 checkpoint 合并拿出来仔细测量。他们把这个做法叫做 PMA(Pre-trained Model Average)。
定义问题
合并的对象是同一条训练轨迹上依次存下的 个 checkpoint ,合并后的模型是加权和:
相邻两个 checkpoint 之间相隔固定的训练量 ,以 token 数计。例如 、,就是取最近 80B token 内、每隔 8B 存一次的 10 个 checkpoint。
权重 的分法,论文比较三种常见做法:
- SMA(简单移动平均):每个 checkpoint 一样重,。
- EMA(指数移动平均):递归计算 ,越新的 checkpoint 权重越大, 越大越偏重最新的。
- WMA(加权移动平均):权重线性增加,例如 ,再除以总和归一化。
以 为例,SMA 的权重是 ,WMA 是 。
作者把研究拆成六个问题:合并对性能有什么影响、哪种合并方法比较好、间隔与数量怎么选、合并后的模型当作下一阶段的起点有没有帮助、能不能提升训练稳定性,以及合并为什么有效。
实验用的是内部语料与内部架构。MoE 模型从 0.7B/7B(激活参数/总参数)到 20B/200B,稠密模型从 411M 到 70B。评测涵盖 MMLU、BBH、GSM8K、HumanEval 等十六个公开基准,多数图表报的是它们的加权平均分。
解决问题
固定学习率阶段:直接平均就变好
第一个实验最简单,在固定学习率阶段训练一段时间后,把 checkpoint 平均起来,和最新的 checkpoint 比。
四种大小的 MoE 模型都有明显进步。Seed-MoE-1.3B/13B 的 HumanEval 从 31.1 升到 36.6,Seed-MoE-10B/100B 从 54.3 升到 61.6。大模型在 BBH 这类接近饱和的基准上进步较小。附录的稠密模型也一样,Seed-Dense-70B 的 HumanEval 从 50.6 升到 57.9,GSM8K 从 85.9 升到 91.3,而且模型越大,进步幅度没有变小。
这和 2018 年的 SWA 是同一个直觉。学习率固定且偏大时,模型在谷底附近来回晃动,每个 checkpoint 都停在谷壁的不同位置;平均起来,就比较接近谷底的中心。
退火阶段:早期平均就追上终点
第二个实验在退火阶段做合并。学习率按 cosine 曲线往下降,模型分数也一路上升。
有意思的是,在退火刚开始时合并 checkpoint,得到的分数已经和退火结束时差不多;较大的模型甚至有时候超过自然退火完的结果。
这引出一个更大胆的问题。如果合并可以达到退火的效果,能不能干脆不退火?
不退火,只合并
作者从 Seed-MoE-1.3B/13B 在 1.4T token 处分出两条训练:一条维持固定学习率,一条开始退火,各自再训练 250B token。然后拿固定学习率那条的 checkpoint 来合并。
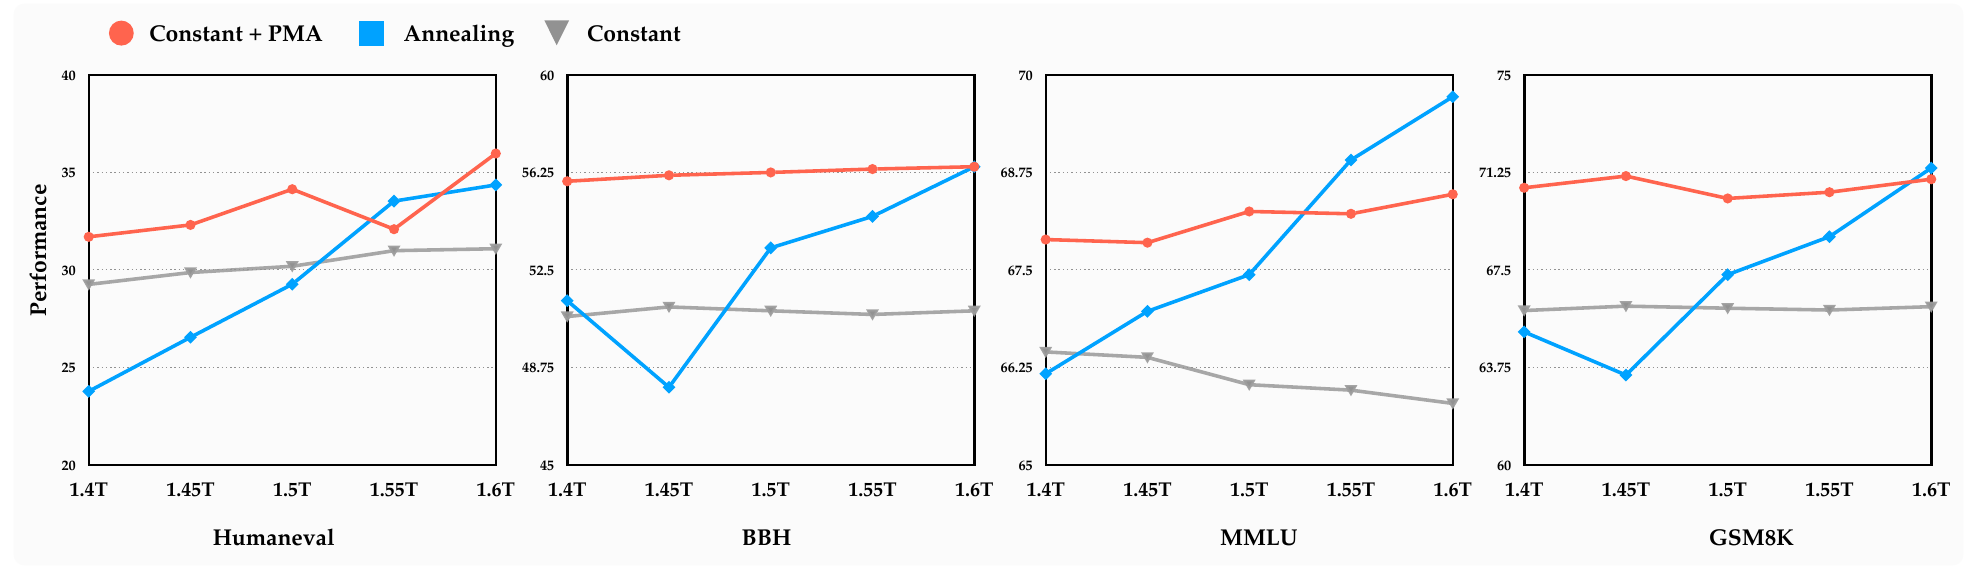
先看灰线和红线。同样是固定学习率,不合并的灰线几乎没有进步,MMLU 甚至一路下滑;合并后的红线一开始就高出一截。
再看蓝线。退火初期分数通常比较低,BBH 和 MMLU 甚至先掉下去,之后才一路上升。到了 1.6T,HumanEval、BBH、GSM8K 上红蓝两线已经差不多,MMLU 则是退火明显比较高,大约高出两分。
作者的结论是,固定学习率加上合并,在训练过程的任何时间点都能大致预测退火后的表现,用来做快速验证很划算。这个结论在三个基准上成立,MMLU 则是一个例外,读图时要记得。
怎么合:方法、间隔、数量
方法。在 Seed-MoE-1.3B/13B 上,训练到 204B token 时,三种方法都比合并前好,WMA 最好, 的 EMA 也胜过 。训练早期权重变化很大,越新的 checkpoint 越值得多给权重。训练到后期,三种方法的差距就几乎消失了。作者之后都用最简单的 SMA。
间隔 。固定 ,比较 为 4B、8B、16B、32B token。训练早期(204B token)时,16B 和 32B 的间隔反而比不合并还差,因为往回取太远,混进了训练初期还很不稳定的权重。训练越久,不同间隔的差距越小。
作者归纳出一个随模型大小缩放的经验值:0.7B/7B 模型约 4B token,1.3B/13B 约 8B,10B/100B 约 80B。大模型通常用更大的批量,checkpoint 之间的间隔也跟着拉长。
数量 。固定 ,比较 3、6、10、15 个 checkpoint。训练早期取太多一样会混进不稳定的权重;训练后期则是越多越好, 比 高了将近 1 分。作者折中取 。
合并后当作下一阶段的起点
预训练之后通常还有继续训练(continued training, CT)、SFT 和强化学习。作者把合并后的权重当作下一阶段的起点,称为 PMA-init。
CT 阶段。在 Seed-MoE-0.7B/7B 上,用约 1T token 训练后合并,再接着做 CT。PMA-init 的初始损失稍低,MMLU 在早期也比较好;但训练到后面,两边的损失收敛到差不多的位置,整体分数也持平。换了几种学习率调度,结论都一样。
SFT 阶段。在 Seed-MoE-15B/150B 上,用合并后的权重做 220M token 的 SFT。同样的学习率下,PMA-init 的 MMLU 从 86.8 变成 87.1,LiveBench 从 50.5 变成 52.0,AMC-2023 从 61.0 变成 64.0;内部评测的 OOD 与指令遵循各多两分以上。
但作者也诚实写了,这种幅度的进步在其他大小的模型上没能重现。PMA-init 不会伤害下游表现,有时有帮助,不保证每次都有。
救回损失尖峰
PMA-init 还有一个比较意外的用途。
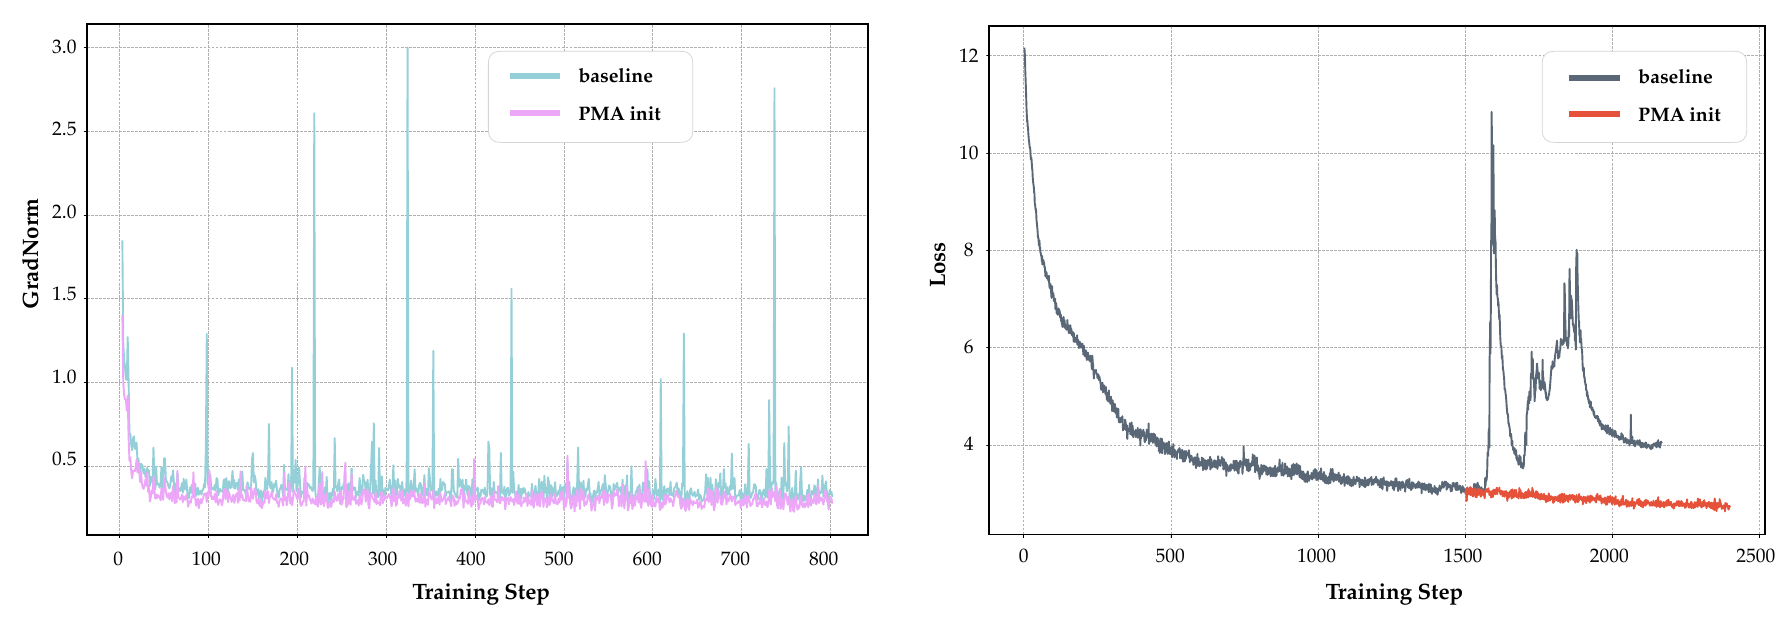
左图是 SFT 时的梯度范数,PMA-init 那条明显平稳,损失尖峰也比较少。
右图是作者刻意制造的不稳定训练。在大模型上直接研究损失尖峰太贵,他们用一个 330M/3.3B 的小 MoE 模型,配上 6e-3 这种特别大的学习率,重现大模型常见的尖峰。原始训练在尖峰后再也回不到原本的轨迹。作者取尖峰前存下的三个 checkpoint 合并,从那里重新开始,训练就稳稳地走过了原本出事的位置。
这给大规模训练一个实用的选项。遇到救不回来的损失尖峰,不必退回很早的 checkpoint 或整个重来,先把尖峰前的几个 checkpoint 平均一下再接着训练。
讨论
为什么平均会更好
作者用损失在最优点 附近的二阶展开解释。令每个 checkpoint 和最优点的偏差为 ,海森矩阵为 ,梯度在最优点为零,于是
平均后的模型偏差是 。把两边展开比较,合并模型的损失低于各个模型平均损失的条件是
右边在 正定时一定是正的。左边的交叉项如果多半是负的,也就是各个 checkpoint 相对于最优点往「互补」的方向偏,这个条件就很容易成立。
用两个 checkpoint 试一下最极端的情况。若 ,两个点刚好在最优点两侧,平均后正好落在 ,损失就是最低的 。若 ,两点重合,平均没有任何好处。
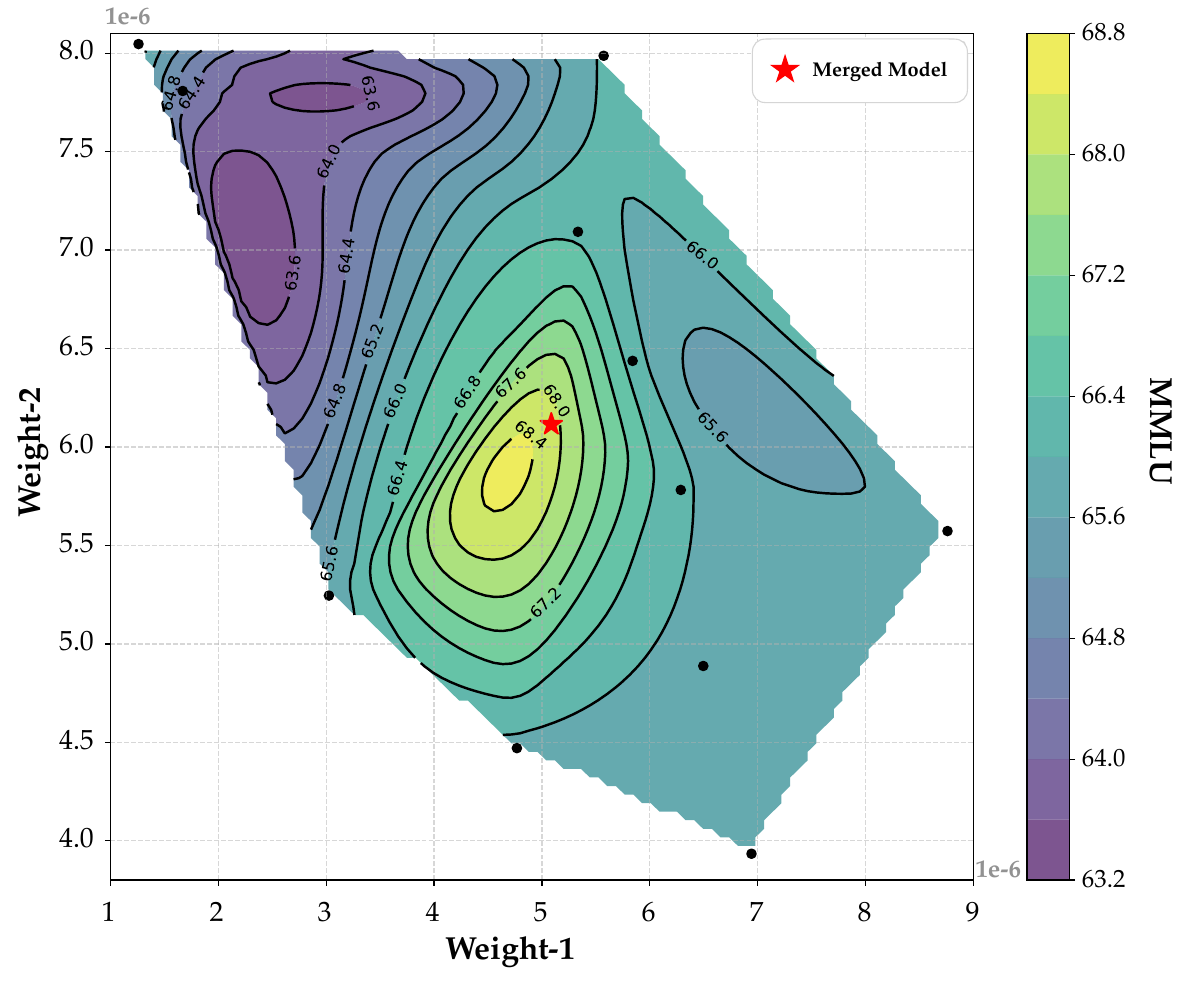
作者也从 Seed-MoE-1.3B/13B 某一层挑了两个参数画图。各 checkpoint 散在高分区的周围,平均后的红星更靠近中心。
这也解释了为什么退火完的 checkpoint 合并效果有限。学习率降得很低时,checkpoint 都已经挤在同一个小谷底里,偏差的方向不再互补,平均也就跳不出去了。
不过这个分析有不少假设。它假设 checkpoint 都在同一个最优点附近、二阶近似成立、海森矩阵正定;在非凸的预训练过程中,这些都只是近似。两个参数的等高线图,则是一个极高维空间的小切面,作者自己也只用它做直观说明。
读这篇时要注意的事
所有模型、架构与语料都是内部的,无法复现。主要指标是十六个基准的加权平均,权重没有公开。间隔的经验值来自三种大小的 MoE 模型,换成不同的批量大小或数据配比,数字未必适用。
另一方面,这篇的实验规模在公开文献里很少见。从几亿参数到两千亿总参数都做了消融,对想在自己的预训练流程中加入 checkpoint 平均的团队,是一份很具体的参考。
几个月后的 WSM 沿着同一个方向走得更远,直接把学习率衰减整个换成 checkpoint 合并。
结论
这篇论文把「预训练时平均 checkpoint」从技术报告里的一句话,变成有系统消融的实验结果。
固定学习率阶段平均最近的 checkpoint,分数就会明显提高,而且大致能预测退火之后的表现。SMA 就够用,间隔随模型大小放大,训练后期 checkpoint 多一点更好。PMA-init 在 CT 与 SFT 上不伤表现,还能把一次救不回来的损失尖峰拉回正轨。
预训练跑到一半想偷看成绩的话,可以先把最近十个 checkpoint 平均一下。退火要花的那几千亿 token,晚点再花也不迟。