原始论文
Robust fine-tuning of zero-shot models
- 发表版本
- CVPR 2022会议
- arXiv 首次提交
- arXiv:2109.01903
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingwiseft2021,
  title = {{Robust fine-tuning of zero-shot models}},
  author = {Mitchell Wortsman and Gabriel Ilharco and Jong Wook Kim and Mike Li and Simon Kornblith and Rebecca Roelofs and Raphael Gontijo-Lopes and Hannaneh Hajishirzi and Ali Farhadi and Hongseok Namkoong and Ludwig Schmidt},
  year = {2021},
  eprint = {2109.01903},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2109.01903}
}
CLIP 刚出来的时候,大家最惊讶的一点是它的稳。
它还没用 ImageNet 的标签做任务微调,就能靠图文预训练学到的表示,把「a photo of a {类别}」的文本向量当成分类器,做零样本分类。更特别的是,换到 ImageNet 的各种变体上,例如重新搜集的 ImageNetV2、素描版的 ImageNet-Sketch、艺术风格的 ImageNet-R,它的准确率掉得比一般 ImageNet 模型少很多。
这份稳定,一微调就不见了。CLIP 原论文和 BASIC 的实验都发现,在 ImageNet 上微调之后,ImageNet 本身的准确率大幅提升,好几个分布偏移数据集上的准确率却比零样本模型还低。
华盛顿大学、OpenAI、Columbia、Google 与 AI2 等单位的 Wortsman、Ilharco 等人,想要两者兼得。
定义问题
论文先引入一个量法,叫有效鲁棒性(effective robustness)。
把一堆在 ImageNet 上训练的一般模型画成散点图,横轴是 ImageNet 准确率,纵轴是分布偏移数据集的平均准确率。这些点大致落在一条直线上(坐标轴做过 logit 缩放)。有效鲁棒性就是一个模型高出这条线的距离:
是那条一般模型的趋势线。零样本 CLIP 落在另一条更高的线上,有效鲁棒性很大;微调之后,点往右移(ImageNet 变高),却往下掉向一般模型那条线。
作者在微调时还观察到两个麻烦。第一,超参数稍微一变,偏移数据上的准确率就差很多,例如两个学习率在 ImageNet 上只差 0.3 个百分点,偏移数据上却差到 8 个百分点,而且光看 ImageNet 的表现挑不出来。第二,微调得越用力,例如学习率越大,ImageNet 进步越多,鲁棒性也掉得越多。
解决问题
两步
WiSE-FT(weight-space ensembles for fine-tuning)只有两步:
- 照一般方式微调零样本模型。
- 把零样本模型和微调后的模型,在权重空间线性混合:
是零样本模型, 是微调后的模型,中间的值不需要再训练,混出来就是一个模型,推理成本和原本一样。
分类头怎么办?
要混合,两个模型的每一组权重都得对得上。CLIP 的零样本分类器其实就是一个线性层 ,每一列是一个类别描述「a photo of a {类别}」的文本向量;输出是图像特征和每一列的内积。
端到端微调时,作者用这个零样本分类器初始化最后的分类层,再连同图像编码器一起训练。两个模型的结构和参数形状完全相同,起点也相同,逐个权重混合就没有问题。
实验的分类头还包含 CLIP 学到的温度尺度,类别文本则用多种 prompt 的向量平均来建构,ImageNet 使用原作者提供的 80 种模板。做合并时,类别顺序、特征归一化与尺度都得沿用同一套定义。只确认矩阵都是 ,还没确认第 列是否仍然代表同一个类别。
把 LC 的情况摊开来算,固定图像表示 后:
等号右边就是两组 logits 的加权平均。例如某张图的两类分数分别是 和 , 时得到 ;把两个分类头先平均,会得到同样的分数。先对各自 logits 做 softmax 再平均概率,则是另一个运算。
端到端微调会改变 ,上面那个分配律就不能把整个网络拆成两个输出。因此论文分开量权重平均与输出集成。两种方法都能改善鲁棒性,端到端的权重平均在比较中更有利,且只跑一个编码器;输出集成需要两次图像编码。LC 则可共用固定特征,差别主要在分类头的计算。
讨论
散点图上的曲线
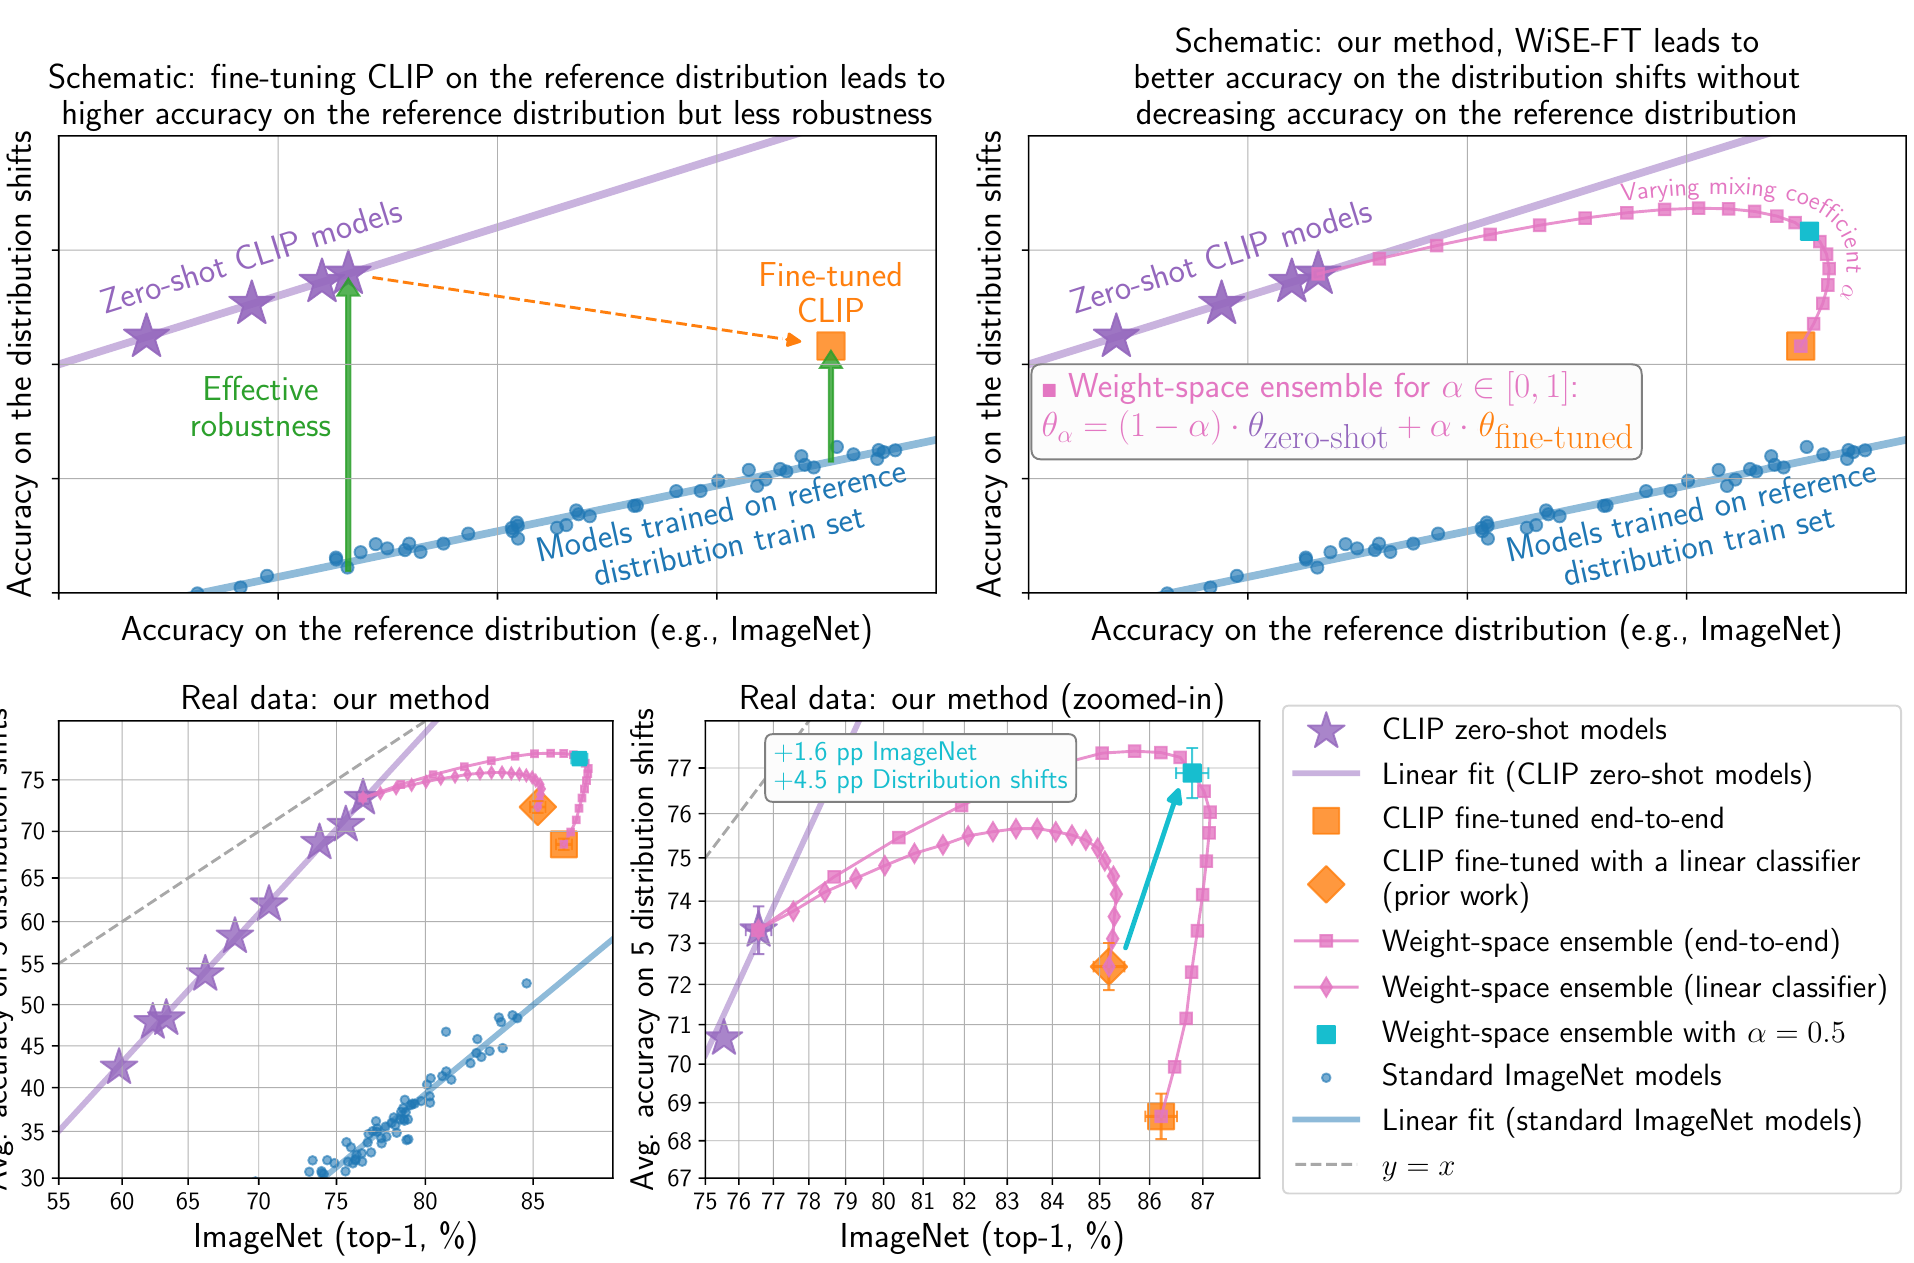
上排是示意。左图里,零样本 CLIP(紫色星号)在一般模型的趋势线上方,绿色箭头的长度就是有效鲁棒性;微调后的 CLIP(橘色方块)往右移,却往下掉。右图是 WiSE-FT, 从 0 调到 1,粉红色的点画出一条往右上拱起的曲线,中间有一段同时比两端更右、更高。
下排换成真实数据,ViT-L/14@336px。右下的放大图里,粉红色方块是端到端微调的混合,从零样本的紫色星号出发,往右上拱,最后才落回微调模型的橘色方块。
数字
作者主要使用的 CLIP ViT-L/14@336px,在 ImageNet 与五个衍生的分布偏移数据集上:
| 模型 | ImageNet | 五个偏移数据集平均 |
|---|---|---|
| 零样本(PyTorch 重现) | 76.6 | 73.4 |
| 微调线性分类器 | 85.2 | 72.6 |
| 端到端微调 | 86.2 | 68.6 |
| WiSE-FT,端到端, | 86.8 | 76.9 |
| WiSE-FT,端到端,每列最佳的 | 87.1 | 77.4 |
准确率(%),整理自原论文 Table 1。最后一行的 各列分别挑选。
端到端微调让 ImageNet 从 76.6% 升到 86.2%,五个偏移数据集的平均却从 73.4% 掉到 68.6%。WiSE-FT 取 ,ImageNet 是 86.8%,比端到端微调还高一点;偏移数据平均 76.9%,比零样本模型也高。对照 CLIP 原论文的线性分类器微调,偏移数据集上高出 4 到 6 个百分点。
五个偏移数据集考的是不同变化。ImageNetV2 重新搜集相近分布的照片;ImageNet-R 换成雕塑、绘画等呈现,只有 200 个类别;Sketch 换成素描;ObjectNet 测不同背景与视角,和 ImageNet 重叠 113 类;ImageNet-A 则挑出一组原本会被 ResNet-50 误判的自然图像,也涵盖 200 类。评测要限制在各自对应的类别集合,不能把它们当成同一个一千类测试集。
| 数据集 | 零样本 | 端到端微调 | WiSE-FT, |
|---|---|---|---|
| ImageNetV2 | 70.5 | 76.8 | 79.5 |
| ImageNet-R | 89.0 | 79.8 | 89.4 |
| ImageNet-Sketch | 60.9 | 57.9 | 64.7 |
| ObjectNet | 69.1 | 63.3 | 71.1 |
| ImageNet-A | 77.7 | 65.4 | 79.9 |
准确率(%),同一个 ViT-L/14@336px,整理自原论文 Table 1。
ImageNetV2 的微调本来就有帮助,混合后再进步;ImageNet-R 和 ImageNet-A 则先因微调掉了许多,再由混合拉回。只报五个数据集平均,会把这两种情况混在一起。也别把每列各选最佳 的一行当成同一个模型的成绩,那一行包含各自对不同目标最有利的选择。
结果不只在 CLIP 成立。作者在 ALIGN、BASIC 与 JFT 预训练的 ViT 上看到类似的趋势;另外六个分布偏移(WILDS 的卫星图像与野生动物相机、CIFAR-10.1 与 10.2、视频帧的扰动),以及七个一般的迁移学习数据集,WiSE-FT 也都有帮助,后者相对错误率降低 4% 到 49%。
超参数变简单了
我们把散点图改成直接对 画准确率。六张图的横轴都从零样本的 0 走到微调后的 1,粉红线是权重插值;斜虚线是把端点准确率线性混合的基准,水平虚线是两端较好的那一个。
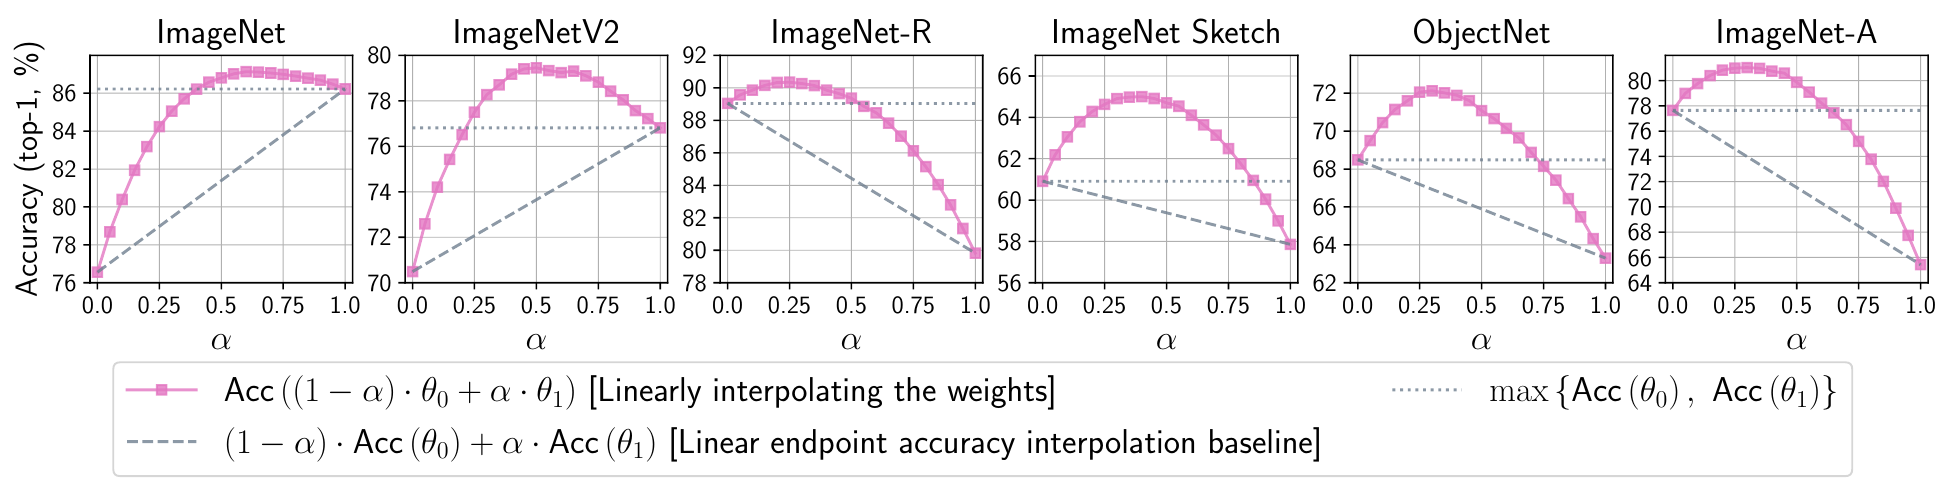
粉红线在中间拱起,六个数据集各有一段超过两个端点,最佳位置却不完全一样。它让我们看到取舍曲线,也提醒我们单一最佳系数取决于要服务的数据。
回到前面的第一个麻烦。超参数变一点,偏移数据上的表现就差很多,而且从 ImageNet 看不出来。
WiSE-FT 把这个问题换成只调一个 。作者发现,即使用一个让微调模型鲁棒性很差的学习率,套上 WiSE-FT 调整 ,也能在 ImageNet 与偏移数据之间拿回好的取舍;而且调 不需要重新训练。在他们的实验里,能达到这条最佳曲线的方法,只有平均权重这一类,WiSE-FT 或对所有迭代点取指数移动平均。
不过 是好用的起点,副标题里的「一半」也从这里来,没有推导要求它永远最好。附录比较过固定一半和各设置的最佳值,在 ImageNet 与五个偏移数据的综合平均上,差距约 0 到 0.4 个百分点。若已有代表部署情境的验证集,就沿插值线扫系数;每个候选仍要做前向评测,省下的是重新微调的时间。
互补究竟发生在哪里
作者先在固定特征的 LC 设置分析两个分类器。除了计算预测分歧,也看分歧时哪个分类器决定集成结果。在 ImageNet 上,微调分类器较常占上风;在多数偏移数据上,零样本分类器较常占上风,ImageNetV2 是例外。
这和分数的置信度尺度有关。作者用最高与次高 logit 的差距当 margin,发现微调模型在参考分布上 margin 较大,零样本模型在偏移数据上较大。当两者对不同样本各有擅长之处,加权的 logits 就有机会保留这种互补。这是 LC 的实验分析,端到端微调还牵涉表示的变化,作者把后者留在误差地形的经验观察。
其他基线也有认真比。作者扫过学习率、训练长度、提早停止,以及向零样本权重的 正则化;在 LC 设置还比过向零样本输出蒸馏、label smoothing、 与 weight decay。这些方法有的能取回部分鲁棒性,仍要重新训练或选正则化强度。WiSE-FT 的实用处,是先把微调做完,再用便宜的权重插值调整取舍。
它处理的范围也很具体。主结果针对自然分布偏移,没有把对抗攻击或所有未知分布都涵盖进来;权重混合要求兼容架构与类别语义。若两个模型连编码器都不同,就只能改比输出层的集成,不能照抄这一行权重平均。
结论
WiSE-FT 的做法用一行公式就写得完。微调完,往回走一半。
在这篇的设置里,零样本 CLIP 和微调后的 CLIP 共享预训练权重,分类头也从同一个零样本分类器出发;沿线的实验确认中间有好用的区域。拿自己的模型试时,先保留微调前的 checkpoint,再用验证数据把那条线走一遍,通常比再猜一轮正则化系数省事。
同一组作者半年后又往前走了一步。被丢掉的那些不同超参数的微调模型,能不能也一起加进来平均?那篇论文叫 Model Soups。