原始论文
Tulu 3: Pushing Frontiers in Open Language Model Post-Training
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2411.15124
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{transformerstulu32024,
  title = {{Tulu 3: Pushing Frontiers in Open Language Model Post-Training}},
  author = {Nathan Lambert and Jacob Morrison and Valentina Pyatkin and Shengyi Huang and Hamish Ivison and Faeze Brahman and Lester James V. Miranda and Alisa Liu and Nouha Dziri and Shane Lyu and Yuling Gu and Saumya Malik and Victoria Graf and Jena D. Hwang and Jiangjiang Yang and Ronan Le Bras and Oyvind Tafjord and Chris Wilhelm and Luca Soldaini and Noah A. Smith and Yizhong Wang and Pradeep Dasigi and Hannaneh Hajishirzi},
  year = {2024},
  eprint = {2411.15124},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2411.15124}
}
预训练模型的权重越来越常公开,后训练却多半是一团雾。
Llama 3 的技术报告写了 SFT、拒绝采样、DPO 跑了六轮,但用了什么数据、怎么筛,外人看不到。Tülu 3 报告的脚注提到一个统计,2024 年 11 月时,LMSYS Chatbot Arena 排名前 50 的模型,没有一个公开了后训练数据。
开源社区自己的后训练配方,例如 Tülu 2 和 Zephyr-β,在聊天类评测上还行,但在数学(MATH、GSM8K)和精确的指令遵循(IFEval)上明显落后。
艾伦人工智能研究所(AI2)与华盛顿大学的 Lambert 等人在 2024 年 11 月发表 Tülu 3,想把这一段补起来。Tülu 是单峰骆驼与双峰骆驼的混种,作者把这个名字沿用到第三代。这次除了模型权重,连训练数据、数据生成流程、训练代码、评测工具与中间 checkpoint 都一起公开。
这篇笔记跟着它的三段式配方走:SFT、DPO,以及作者新提出的 RLVR。
定义问题
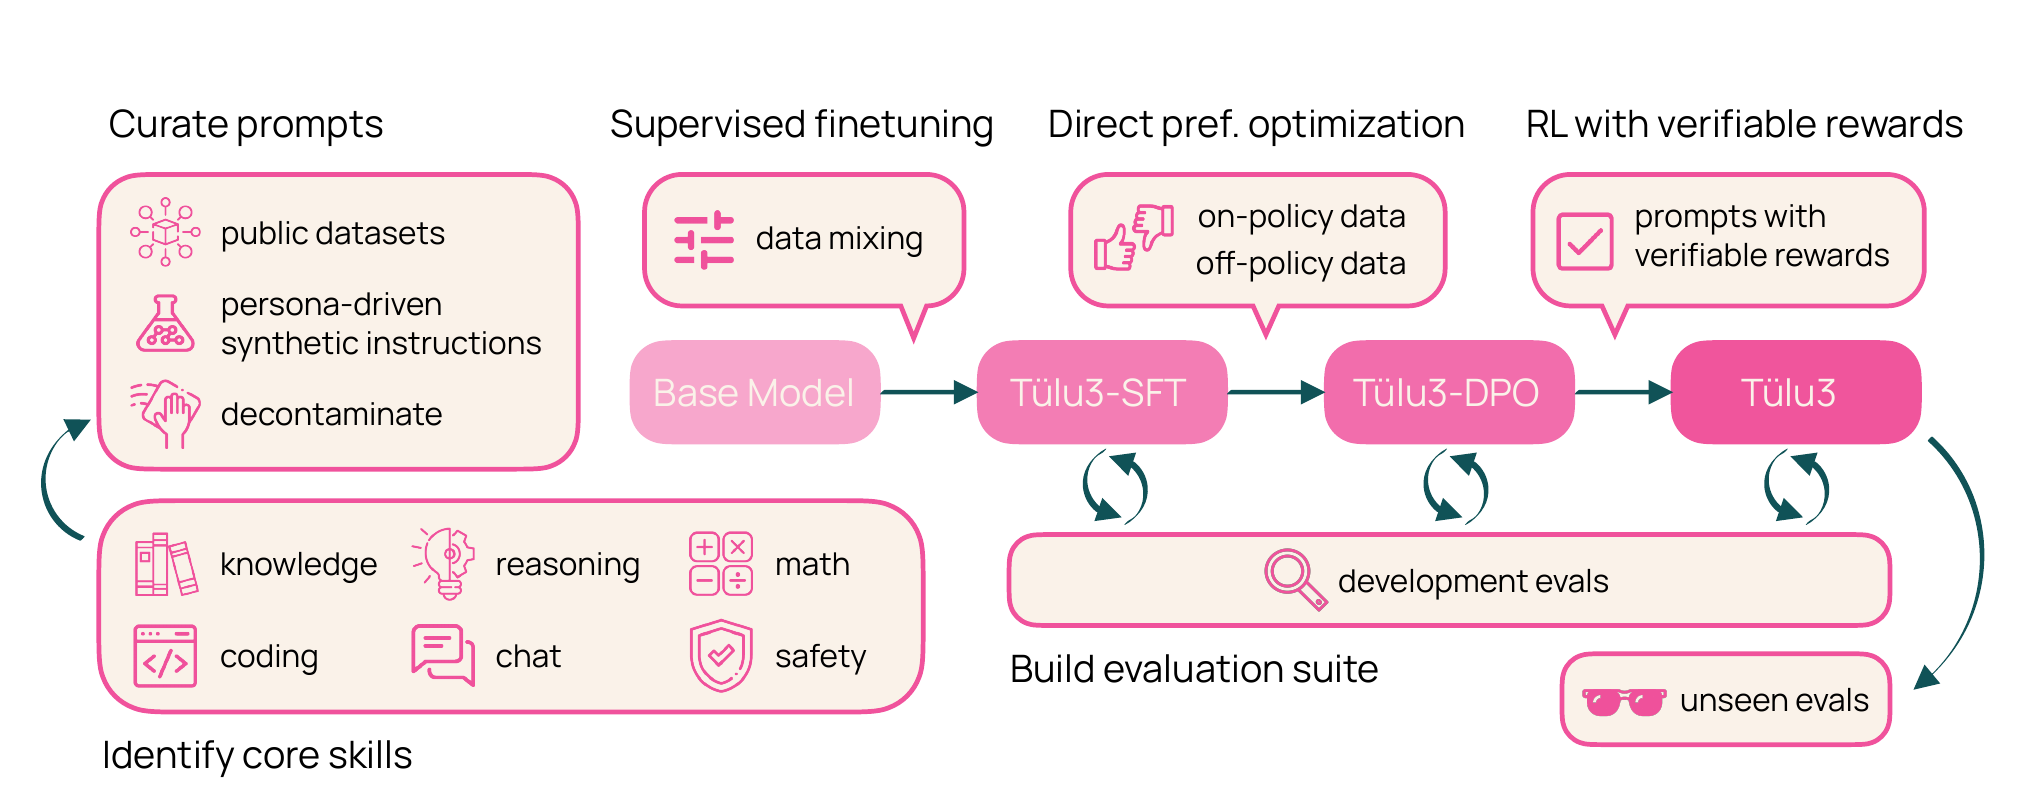
这张图要从左下角开始看。作者先定出一组要加强的核心能力:知识、推理、数学、编程、指令遵循与聊天、安全。每项能力都对应几个评测。
评测分成两组。开发组在整个研发过程中反复使用,用来挑数据、调超参数;未见组只在最后评估一次,用来确认模型没有过度贴合开发组。例如知识类的开发评测是 MMLU、PopQA、TruthfulQA,未见评测是 MMLU-Pro 与 GPQA;指令遵循的开发评测是 IFEval 与 AlpacaEval 2,未见评测是 IFEval-OOD 与 HREF。
基底模型是 Llama 3.1 的 8B 与 70B,后来又补上 405B。整个配方要回答的是,只用公开或可公开的数据,能不能做出和 Llama 3.1 Instruct 同级、甚至更好的后训练模型?
解决问题
数据:先把考题捞出来
提示词的来源有两类。一类是现成的公开数据集,例如 WildChat 的真实用户对话;另一类是合成的。合成数据用了一个有意思的方法,先准备大量「人物设定」(persona),再请 GPT-4o 扮演这些人去出题,用来增加题目的多样性。数学与代码各合成了约 22 万与 3.5 万条。
公开数据集最大的风险,是里面混着评测的考题。作者为此做了一套去污染流程:
- 只比对提示词。训练数据的回答常常是重新生成的,比对回答没有意义。
- 用 8-gram 比对。对评测中的每个 token,只要它所在的某个 8-gram 也出现在某条训练数据里,就算这个 token 被匹配到。如果一道评测题里超过 50% 的 token 都和同一条训练数据匹配,就认定两者重叠。作者试过全字符串比对与嵌入向量比对,前者太严,后者很难区分「改写」和「只是主题相似」,8-gram 能抓到「只换了数字的数学题」这类情况。
- 整个数据集是否保留。某个训练数据集只要和任何一个评测有超过 2% 的题目重叠,就算受污染。和未见组重叠的,整个数据集删掉;和开发组重叠的,若删掉整个数据集不影响表现就整个删,否则只删重叠的那些。
这套流程真的抓到不少东西。例如常用的 NuminaMath-TIR 数学数据,有 11.3% 的题目和 MATH 评测重叠,被删除后重新发布。
SFT:数据配比与一个损失函数的陷阱
SFT 的重点是配比。作者从 Tülu 2 的配比出发,一轮轮加入新数据、做消融,再经过几轮去污染,得到最终的 Tülu 3 SFT 配比。去污染会让开发组的分数小幅下降,这是预期中的代价。
训练设置是 2 个 epoch、批量 128、最长 4,096 个 token;8B 的学习率 ,70B 是 。8B 在 32 张 GPU 上训练 6 小时,70B 在 64 张 GPU 上训练 50 小时。
这一节有两个和模型合并相关、也和工程实现相关的发现。
Model Soups 没有赢过最好的单一模型。 作者用不同的随机种子训练多个 SFT 模型,再用 MergeKit 做线性平均。8B 的五个种子,平均分数在 59.8 到 60.1 之间,最好的 soup(两个种子平均)是 60.2;70B 的三个种子是 71.8、70.0、72.6,最好的 soup 是 72.5。种子之间的差距不小,70B 差了 2.6 分,但 soup 并没有稳定胜过最好的种子。作者最后直接用最好的单一 SFT 模型。
这和 Model Soups 在图像分类上的结论不同,也和 Llama 3、Gemma 2 把平均写进正式流程的做法不同。可能的原因是这里只平均了不同种子,没有平均不同的数据或超参数,模型之间的差异太小;但论文没有进一步分析。
损失的平均方式会偷偷改变权重。 训练初期,作者发现同一份数据在自己的框架和 TPU 上训练出来的模型表现不同。追到最后,是 Transformers 库在梯度累积时计算损失的方式有问题。
用一个例子算一次。一个 batch 有两条数据,第一条有 10 个有效 token,总损失 20;第二条有 90 个有效 token,总损失 90。
- 两条一起送进前向传播,库把全部有效 token 一起平均,。每个 token 权重相同。
- 用梯度累积分两次送,每次各自平均再取平均,。每条样本权重相同,短样本的 token 被放大了 9 倍。
只是改了梯度累积的步数,训练目标就跟着变了。作者的解法是改用求和的损失,不再除以 token 数,并重新调整学习率;这等于让每个 token 的权重都相同,实验中也表现较好。这个问题在 2024 年秋天被社区广泛讨论,论文引用了 Unsloth 等人的说明。
偏好微调:on-policy 数据与长度归一化的 DPO
偏好数据的生成,改良自 UltraFeedback 的流程:
- 选提示词,包括 SFT 用过的、同来源但 SFT 没用的,以及新的提示词。
- 从 22 个模型组成的模型池里随机挑四个各自回答。这是 off-policy 数据。另外加入 Tülu 3 SFT 模型自己的回答,这是 on-policy 数据,让偏好数据更贴近正在训练的模型会产生的输出。
- 请 GPT-4o 从有用性、指令遵循、真实性、诚实四个维度,各给 1 到 5 分。平均分最高的回答当作「选中」,再从分数较低的回答中随机挑一个当作「未选中」。
消融阶段,8B 用了 96,911 条 off-policy 与 19,444 条 on-policy 数据;最终的偏好数据超过 27 万条。作者也发现,偏好数据中不重复提示词的数量越多,表现越好,单纯重复使用同样的提示词效果有限。
算法上,作者比较了 DPO、SimPO、PPO 等方法,最后选择长度归一化的 DPO:
和原本的 DPO 只差在把两个对数概率比各自除以回答的长度 、。人类和模型评审都偏好长回答,不做归一化时,模型很容易学到「写长一点就好」。作者选它,也是因为它比 PPO 简单、跑得快,方便反复调整数据配比。
RLVR:答对才给分
第三阶段是作者提出的 RLVR(Reinforcement Learning with Verifiable Rewards,基于可验证奖励的强化学习)。
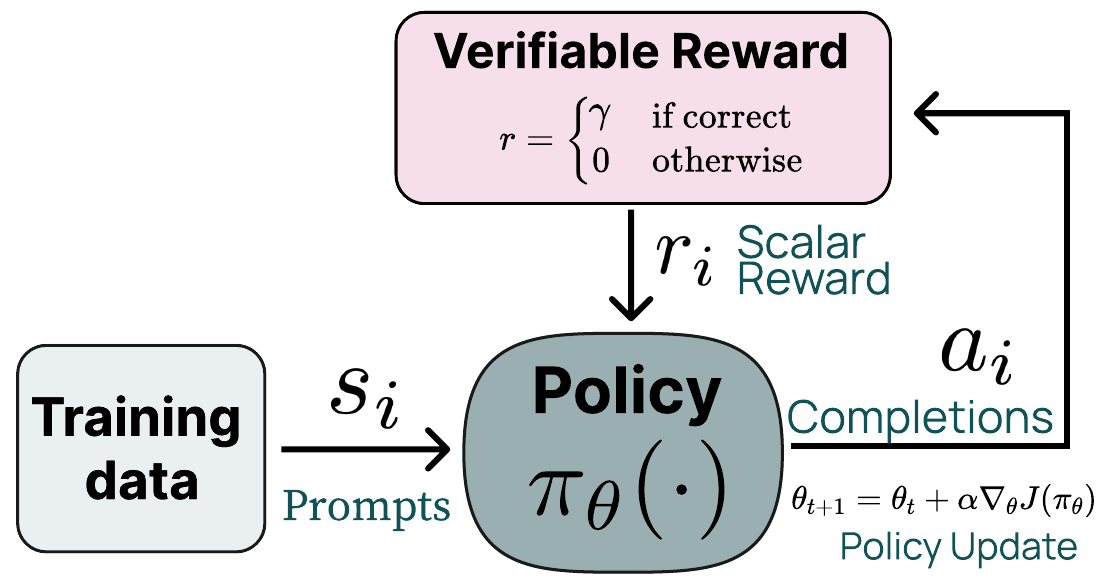
一般的 RLHF 用奖励模型打分。RLVR 把奖励模型换成一个确定性的检查函数:
正文里的奖励写作 ,图上写成 ,指的是同一个值,作者根据初步实验设为 10,没有再调。
检查函数只用在三种容易验证的任务上:GSM8K 与 MATH 的训练集,抽出最后的答案和标准答案比对;以及从 Tülu 2 的 SFT 数据抽出指令、加上 IFEval 式的格式限制(例如「回答不超过 100 字」),用程序检查是否遵守。总共约 3 万个提示词。
优化用 PPO,作者也列了几个让 PPO 稳定的实现细节:价值模型从一般的奖励模型初始化、训练时关掉 dropout、回答没有正常结束就扣 10 分、优势值做标准化。基础设施上,生成回答用专门的 GPU 跑 vLLM,训练用另一批 GPU,两者异步进行,策略总是用倒数第二新的生成数据训练,在效率与可复现性之间取得平衡。
讨论
RLVR 带来多少提升
从最好的 DPO 模型开始做 RLVR,论文 Table 23 的结果:
| 8B DPO | 8B RLVR | 70B DPO | 70B RLVR | |
|---|---|---|---|---|
| 平均 | 64.4 | 64.8 | 75.9 | 76.0 |
| MATH | 42.0 | 43.7 | 62.3 | 63.0 |
| GSM8K | 84.3 | 87.6 | 93.5 | 93.5 |
| IFEval | 81.1 | 82.4 | 82.6 | 83.2 |
| 安全 | 87.2 | 85.5 | 89.0 | 88.3 |
8B 上三个目标任务都有进步,GSM8K 多了 3.3 分;但安全分数掉了 1.7 分,整体平均只多 0.4。70B 的提升更小,GSM8K 已经接近饱和。作者也坦白说,有些 8B 的实验可以把 GSM8K 拉到 89.4、IFEval 拉到 84.8,但其他指标会变差,整体平均反而下降。
训练曲线显示,RLVR 确实能让训练集上的正确率持续上升,但 KL 散度越大,平均分数往往越低。也就是说,模型离起点越远,过度优化的风险越高。
405B 的做法不太一样。GSM8K 在 SFT 与 DPO 后已经饱和,IFEval 的数据在初期实验中也帮助不大,所以只用 MATH 训练集。只跑 25 步,MATH 就提升了超过 5 分;因为算力限制只跑到 75 步,曲线还没饱和。405B 用 256 张 GPU,16 张跑 vLLM 生成,240 张训练;每一轮生成约 550 秒、同步权重约 25 秒、训练约 1,500 秒。为了省算力,价值模型只用了 8B。
整体成绩
在作者整理的评测组合上,Tülu 3 8B 的平均分数是 65.1,高于 Llama 3.1 8B Instruct 的 62.9,但略低于 Qwen 2.5 7B Instruct 的 66.5;Tülu 3 70B 是 76.2,高于 Llama 3.1 70B Instruct 的 74.1、Qwen 2.5 72B Instruct 的 72.8,也高于 GPT-4o mini 的 69.6 与 Claude 3.5 Haiku 的 75.3。405B 版本不计安全项目的平均是 80.0,DeepSeek-V3 是 79.0,GPT-4o 是 80.5,落在同一个区间。
要注意,这些评测大多是作者自己挑的开发组,也是整个研发过程反复优化的目标;未见组的设计就是为了对冲这个风险。
没成功的尝试
作者专门写了一节「没有结果的尝试」,这在技术报告里不常见:
- Online DPO:每一步从当前的策略采样两个回答,用奖励模型标出偏好再更新。在数学上 GSM8K 几乎没有进步,MATH 反而退步。
- 拒绝采样:Llama 3 用得很重的方法,在这里投入的算力换到的提升很有限。作者观察到,评审模型要够强才挑得出好回答,而把原本的回答也放进候选,效果比只从新生成的回答中挑好得多。
局限
训练数据以短对话为主,平均只有 2.4 轮,多数样本不到 2,048 个 token,长上下文与多轮对话是明确的缺口。偏好数据与部分合成数据由 GPT-4o 生成或评分,「完全开源」指的是数据与流程都公开,数据本身仍依赖闭源模型。
结论
Tülu 3 的价值,一半在模型,一半在那份完整的食谱。去污染的门槛、SFT 的配比、损失怎么求和、偏好数据怎么生成、PPO 要注意哪些细节,都写得清清楚楚,连失败的尝试也一起交代。
RLVR 本身很朴素,答对给分、答错不给分,在数学和格式遵循上能带来稳定但不大的进步。几个月后,DeepSeek-R1 用规则判定的奖励把推理能力推得更远,「可验证的奖励」也成了强化学习后训练的常见做法。
如果你只打算从这份报告带走一件事,回头检查一下自己的训练代码在梯度累积时,损失是怎么平均的。