原始论文
Language Models are Super Mario: Absorbing Abilities from Homologous Models as a Free Lunch
- 发表版本
- ICML 2024会议
- arXiv 首次提交
- arXiv:2311.03099
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingdare2023,
  title = {{Language Models are Super Mario: Absorbing Abilities from Homologous Models as a Free Lunch}},
  author = {Le Yu and Bowen Yu and Haiyang Yu and Fei Huang and Yongbin Li},
  year = {2023},
  eprint = {2311.03099},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2311.03099}
}
2023 年下半年,Hugging Face 上已经有大量从同一个 Llama 2 微调出来的模型。WizardLM 擅长遵循指令,WizardMath 擅长数学,还有各种写程序的版本。
想要一个同时会这些事的模型,最直接的办法是把数据凑在一起重新微调。可是很多模型只公开权重,训练数据拿不到;就算拿得到,13B、70B 的模型重新训练也不便宜。
阿里巴巴的 Le Yu、Bowen Yu、Haiyang Yu、Fei Huang 与 Yongbin Li 把这件事比喻成超级玛利欧吃道具。模型能不能直接「吸收」同源模型的能力,不用重新训练,连 GPU 都不用?
这篇论文先回答了一个更基本的问题,微调到底改了多少权重。
定义问题
令 是预训练权重, 是在任务 上做监督式微调(SFT)后的权重,两者的差称为 delta 参数:
这就是任务算术里的任务向量。合并多个模型时,TIES-Merging 已经指出,很多 delta 参数是冗余的,会稀释其他模型的重要变化;它的做法是依绝对值修剪,只留最大的 20%。
作者的观察更激进。他们量了好几个语言模型的 delta 参数,SFT 前后的差值大多在 0.002 以内,冗余得非常厉害。如果把绝大部分直接丢掉,模型还能不能用?
解决问题
丢掉,再放大
DARE 的名字就是做法,Drop And REscale。
每个 delta 参数以概率 被归零,留下来的乘上 。最后 。
这里的丢弃是随机的,不看大小。这一点和 TIES 或一般剪枝都不同。
为什么要放大
看一个线性层。输入是 ,预训练权重 、偏置 ,delta 是 、。第 个输出是
DARE 只动 delta 的部分。每个 有 的概率被留下并乘上 ,有 的概率变成 0,所以 delta 那一项的期望值是
取 ,期望值就回到原本的 。这个等式针对固定输入的单一线性层;网络后面还有非线性,而且前层的随机改动也会影响下一层的输入,整个模型需要另外量测。
作者把这段推导称为「粗略的证明」。期望值不变,不保证单次抽样的误差小;实际能丢多少,还得看实验。
用两个 delta 值看一次就知道。下面把 的四种等概率掩码全部列出,没有真的训练网络:
import numpy as np
from itertools import product

delta = np.array([0.001, 0.002])
x = np.array([1., 2.])
p = 0.5
outputs = []
for dropped in product([0, 1], repeat=2):
    kept_delta = (1 - np.array(dropped)) * delta / (1 - p)
    outputs.append(float(kept_delta @ x))
print("各遮罩的 delta 輸出:", np.round(outputs, 6).tolist())
print(f"原本: {delta @ x:.6f}, 遮罩平均: {np.mean(outputs):.6f}")
各遮罩的 delta 輸出: [0.01, 0.002, 0.008, 0.0]
原本: 0.005000, 遮罩平均: 0.005000
四种结果平均起来正确,单独挑一种却可能是 0,也可能是原来的两倍。DARE 在产生模型时只抽一次掩码,部署后不会每次重新抽、更不会把四个模型全部跑完。因此要解释能否保住能力,还得看随机扰动的大小。
沿这个例子再推一小步。对某个固定 delta 值 ,DARE 后的方差是
这是对伯努利掩码的直接计算。 时倍率是 9, 时是 99;delta 越大、丢弃率越高,单次扰动越难压低。对输入固定、掩码独立的线性层,输出扰动的方差会累加各项 。这个计算有助理解后面的失败案例,模型大小与可容忍 的关系仍要由实验决定。
当成合并的前处理
DARE 本身不负责合并。它像一个插件,先把每个要合并的模型都 DARE 一次,再交给现有的合并方法。以任务算术为例:
想法是,每个模型只剩一小部分非零的 delta,彼此重叠的位置变少,合并时的干扰也就少了。
若两个模型的掩码独立,每一格同时保留下来的概率是 。 时,原本两个 delta 都可能修改的坐标,只剩约 1% 会一起存活。这说明稀疏化如何减少直接重叠;留下的值同时被放大十倍,所以合并质量仍要把重叠、尺度与来源模型能力一起看。
讨论
能丢多少
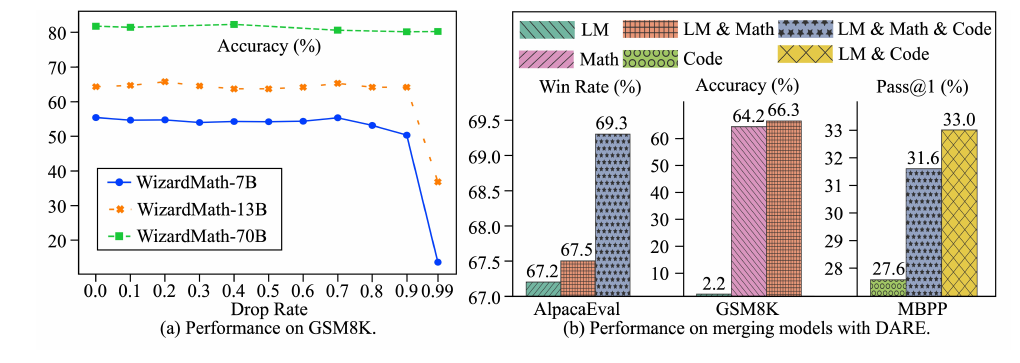
左图是丢弃率对 WizardMath 的影响。三个大小的模型,丢到 90% 都还几乎没变;丢到 99%,7B 和 13B 撑不住了,70B 仍然维持。
作者由此归纳出两点。SFT 模型的 delta 参数冗余到可以丢掉 90% 甚至 99%;模型越大,能容忍的丢弃率越高。encoder 类的 BERT、RoBERTa 在 GLUE 上也看得到同样的趋势,丢到 0.9 之后才明显下滑。
作者扫的是 。Decoder 的指令遵循用 AlpacaEval win rate,数学用 GSM8K、MATH 准确率,编程用 HumanEval、MBPP 的 pass@1;生成用 greedy decoding。Encoder 则是 BERT-base 与 RoBERTa-base 的八个 GLUE 任务,依任务分别量准确率、F1、相关系数等。各张图的「维持表现」要对应自己的指标,WizardMath-70B 在 GSM8K 的高容忍度也不能直接搬到所有专家上。
GLUE 的原始训练集另切 10% 做验证,官方 validation 当测试。这使 drop rate 可以用保留数据选;最极端的 99% 是展示可达到的案例,使用时可以先从较低丢弃率开始扫。
合并三个 13B 模型
作者合并了三个都从 Llama-2-13b 微调出来的模型,WizardLM-13B(LM,指令遵循)、WizardMath-13B(Math,数学)与 llama-2-13b-code-alpaca(Code,编程)。WizardCoder-Python-13B 没有选,因为它是从 CodeLlama-13b-Python 微调的,基底不同。
| 模型 | DARE | AlpacaEval | GSM8K | HumanEval | MBPP |
|---|---|---|---|---|---|
| LM | – | 67.20 | 2.20 | 36.59 | 34.00 |
| Math | – | – | 64.22 | – | – |
| 任务算术:LM + Math | 否 | 67.04 | 66.34 | 28.66 | 30.60 |
| 任务算术:LM + Math | 是 | 67.45 | 66.26 | 26.83 | 32.40 |
| TIES:LM + Math | 否 | 68.63 | 15.77 | 37.80 | 35.60 |
| TIES:LM + Math | 是 | 68.70 | 36.16 | 36.59 | 37.00 |
| 任务算术:LM + Math + Code | 否 | 69.03 | 58.45 | 18.29 | 29.80 |
| 任务算术:LM + Math + Code | 是 | 69.28 | 56.48 | 23.17 | 31.60 |
部分数字整理自原论文 Table 1。「–」表示该模型不评这一项。
最醒目的是第一行到第三行。WizardLM 在 GSM8K 上只有 2.20,和 WizardMath 用任务算术合并之后是 66.34,比 WizardMath 本身的 64.22 还高。这个合并其实不靠 DARE 也做得到;加上 DARE,GSM8K 是 66.26,差不多。
DARE 帮得最明显的是 TIES。TIES 先依绝对值修剪,在这组模型上反而把数学能力剪坏了,GSM8K 只剩 15.77;先 DARE 再 TIES,回到 36.16。作者的解释是,DARE 之后大部分 delta 已经是 0,TIES 修剪时剪掉的就只是这些 0,不会再伤到有用的值。
这组 TIES 也和原始论文的固定配方不同。DARE 论文在 decoder 实验的保留比例搜索 0.5、0.7、0.9,缩放系数在 0.5、1.0 里选,然后比较有无 DARE。它支持这些来源模型与搜索设置下的改善,不能只拿 15.77 反推 TIES 在其他任务的效果。
DARE 也不是每一格都帮上忙。三个模型合并时,GSM8K 从 58.45 降到 56.48;在 encoder 类模型上,DARE 搭配五种合并方法的平均进步只有 −0.03% 到 0.84%,合并模型也常常比不上单一的专家。
作者还注意到,llama-2-13b-code-alpaca 在编程能力上比 WizardLM-13B 还差。他们的结论是,合并的前提是每个来源模型本身都要训练得够好。
放大是必要的
为了确认放大的作用,作者做了一个只丢不放大的对照 DropOnly,逐层比较原模型和处理后的模型,在同样输入下的隐藏表示有多相似。
下图左边是 WizardMath-7B 的 GSM8K 输入,右边是 BERT 的 CoLA 输入。横轴往后走一层,纵轴量该层与原模型表示的平均余弦相似度;相同丢弃率的 DARE 与 DropOnly 要配对看。
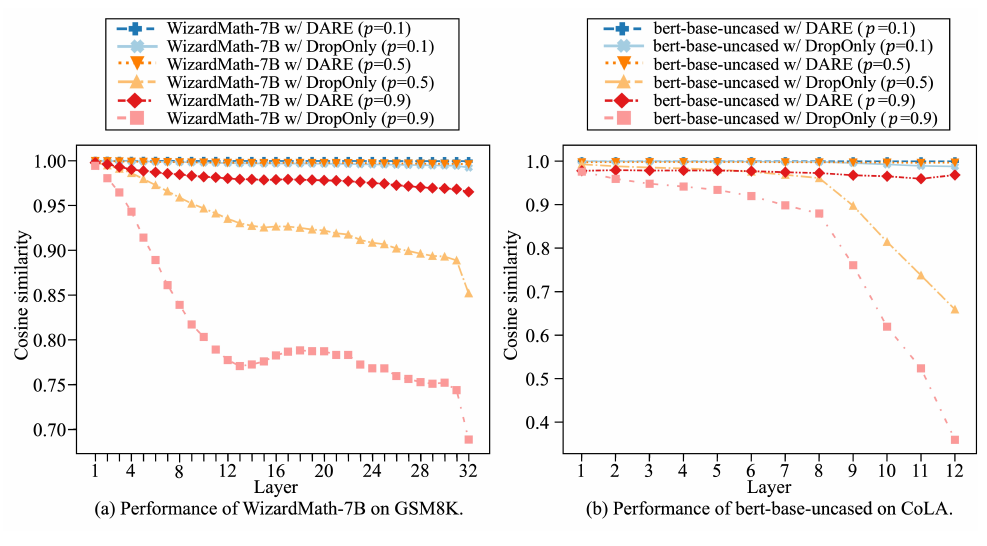
DARE 丢掉 90% 时,每一层的余弦相似度都还在 0.95 以上。DropOnly 只有在 时撑得住;WizardMath-7B 上, 时降到约 0.85, 时约 0.68。表现也一样,丢得越多,DropOnly 和 DARE 的差距越大。
另一个对照是依绝对值剪枝(magnitude pruning,MP)再放大。在 7B 模型上丢 70%,MP 的 AlpacaEval 从 43.85 掉到 10.61,GSM8K 从 46.70 掉到 0.37,HumanEval 从 21.34 掉到 3.05。作者认为,留下的都是大的值,再放大,输出就失控了。
什么时候不能用
DARE 的前提是 delta 很小。作者刻意做了一个失败的例子,把 WizardCoder-Python-13B 的基底,从实际的 CodeLlama-13b-Python 换成 Llama-2-13b 来算 delta。CodeLlama 在 Llama 2 之上又多训练了 5,000 亿个代码相关的 token,参数已经走得很远;这样算出来的 delta,绝对值常常超过 0.01,相对 CodeLlama-13b-Python 却在 0.0002 以内。
结果只丢 10%,HumanEval 和 MBPP 的 pass@1 就从 63.41 和 55.4 掉到 0。持续预训练后的模型,delta 可以到 0.03 左右,DARE 就不适用了。
0.002 是这批模型的观察范围,并非跨架构通用的安全门槛。参数尺度会随模型与层而变,输入也会放大输出扰动;真正可用的检查是先对正确基底算差值分布,再看不同 的保留曲线。只确认模型都是「13B」或张量形状一致,还没确认它们共享同一份基底。
作者也提到,丢掉的若是微调后的完整权重,而不是 delta,只丢 10% 就会让表现掉到接近零。他们的解读是,SFT 主要是在唤醒预训练模型原本的能力,而不是加进全新的能力。
工程上还要分清楚稀疏 delta 和小模型。重建后的权重是 ,基底仍是完整的 dense 模型;丢掉九成差值,推理所需参数量和矩阵乘法没有自动少九成。若存储成「共用基底加稀疏差值」,可能节省多版本存储,还需要对应的文件格式与加载方式。论文主要展示的是能力保留与合并,没有把 70B 网络压成 0.7B 网络。
登上排行榜
最后,作者用 DARE 合并了几个以 Mistral-7B 为基底的模型,做出 supermario v1 和 v2。到 2024 年 1 月 28 日,supermario v2 在 Open LLM Leaderboard 的 7B 级排名第一,平均 75.49。
表格里和它并列的 Beagle14-7B、NeuralBeagle14-7B,模型卡上也标着用 mergekit 合并。那一阵子的 7B 排行榜,前排挤满了合并模型,它们的分数也开始引来数据污染的疑虑。
结论
DARE 的发现比方法本身更有意思。SFT 改动的权重非常小,大部分随机丢掉、剩下的放大,模型照样能用;模型越大,能丢的越多。
当作合并的前处理,它常常能减少干扰,特别是搭配 TIES 时;但帮助有时只有零点几个百分点,偶尔还会倒退。
如果你要拿它来合并,先确认每个模型的 delta 是对着实际的基底算的。基底一换错,丢掉一成就什么都不剩了。