原始论文
Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time
- 发表版本
- ICML 2022会议
- arXiv 首次提交
- arXiv:2203.05482
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingmodelsoups2022,
  title = {{Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time}},
  author = {Mitchell Wortsman and Gabriel Ilharco and Samir Yitzhak Gadre and Rebecca Roelofs and Raphael Gontijo-Lopes and Ari S. Morcos and Hongseok Namkoong and Ali Farhadi and Yair Carmon and Simon Kornblith and Ludwig Schmidt},
  year = {2022},
  eprint = {2203.05482},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.05482}
}
微调一个大模型,标准流程大概是先扫一轮超参数,学习率、权重衰减、训练轮数、数据增强各试几组,训练出一批模型,再挑验证集上最好的一个,其余的删掉。
被删掉的那些模型也花了不少算力。华盛顿大学、Columbia、Google、Meta 与特拉维夫大学的 Wortsman、Ilharco 等人,半年前才发表 WiSE-FT,把零样本 CLIP 和微调后的 CLIP 混在一起;这次他们把念头动到被丢掉的那一批身上。
能不能把它们全部加进来平均,煮成一锅汤?
定义问题
令预训练权重为 ,用超参数组合 微调得到 ,。拿这 个模型,有三种用法:
| 做法 | 推理时的模型 | 推理成本 |
|---|---|---|
| 挑验证集最好的 | ||
| 输出集成 | ||
| 模型汤 |
整理自原论文 Table 2。三种做法的训练成本相同。
集成通常最准,但推理时 个模型都要跑。模型汤只跑一个,问题是平均出来的权重还能不能用。
这里的前提和以往的权重平均不太一样。SWA 这类方法平均的是同一条训练轨迹上的点;这篇平均的是从同一个预训练权重出发、各自独立微调的模型,超参数可以差很多。
解决问题
三种汤
最直接的是均匀汤(uniform soup), 个全部平均。
它有一个明显的风险。如果某组超参数训练出来的模型很差,例如学习率太大,模型跑到了别的盆地,平均就会被它拖下水。
所以作者把重点放在贪婪汤(greedy soup):
import numpy as np

def average(models):
    return np.mean(np.stack(models), axis=0)

def greedy_soup(models, val_acc):
    """models 依驗證集準確率由高到低排好;val_acc(權重) 回傳驗證集準確率。"""
    soup = [models[0]]
    for m in models[1:]:
        if val_acc(average(soup + [m])) >= val_acc(average(soup)):
            soup.append(m)          # 加進去不會變差,就留下
    return average(soup)

# 小例子:二維輸入、兩個類別,用四筆驗證資料選湯的成員。
X = np.array([[2., 0.], [0., 2.], [1., 0.], [0., 1.]])
y = np.array([0, 1, 0, 1])
models = [np.diag([1., 0.5]), np.diag([0.5, 1.]), -4 * np.eye(2)]
val_acc = lambda w: np.mean((X @ w).argmax(axis=1) == y)
models = sorted(models, key=val_acc, reverse=True)
w = greedy_soup(models, val_acc)
print(w.tolist())
print(f"驗證準確率: {val_acc(w):.0%}")
[[0.75, 0.0], [0.0, 0.75]]
驗證準確率: 100%
先把模型依验证集准确率排好,从最好的那个开始,一个一个试着加进锅里。加进去之后验证集准确率没有下降,就留下;下降了就跳过。因为第一个放进去的就是最好的单一模型,贪婪汤在验证集上不会比它差。
例子里前两个模型都能分对四笔数据,平均后仍然分对,第三个一加进来就把分类方向翻转,于是被跳过。套到网络时要把每个对应张量都做平均,筛选逻辑一样。假如汤里已经有 个模型,新成员的候选是 ;每次都用一半、一半,会让后加入的模型权重更大。
排序也有影响。前面留下的成员会改变后面每次测试的平均点,贪婪搜索又只走一遍,所以它找到的是这个顺序下可接受的配方。实验把排序改成随机,ImageNet 准确率从 81.03% 变成平均 80.79%。验证集上的不下降是算法直接检查的性质,测试集与部署数据仍要另外评测。
这里的验证集不能用 ImageNet 官方的验证集,那份数据通常被拿来当测试集。作者从训练集切出大约 2% 当作汤的验证集。
第三种是学习汤(learned soup),用梯度下降学每个模型、甚至每一层的混合系数。它需要同时把所有模型加载到内存,对大模型不太实际,论文放在附录。
具体来说,令 ,用 前向传播,在保留的验证数据上最小化交叉熵,另学一个输出温度参数。原模型权重固定,更新的是配方系数;softmax 让系数为正、总和为 1。逐层版本再让每一层有自己的 ,增加组合弹性。附录实现用 AdamW、固定学习率 0.1 跑 3 个 epochs,且要保存所有候选权重。它省掉逐个贪婪测试,换来额外的优化与内存需求。
讨论
最好的点在中间
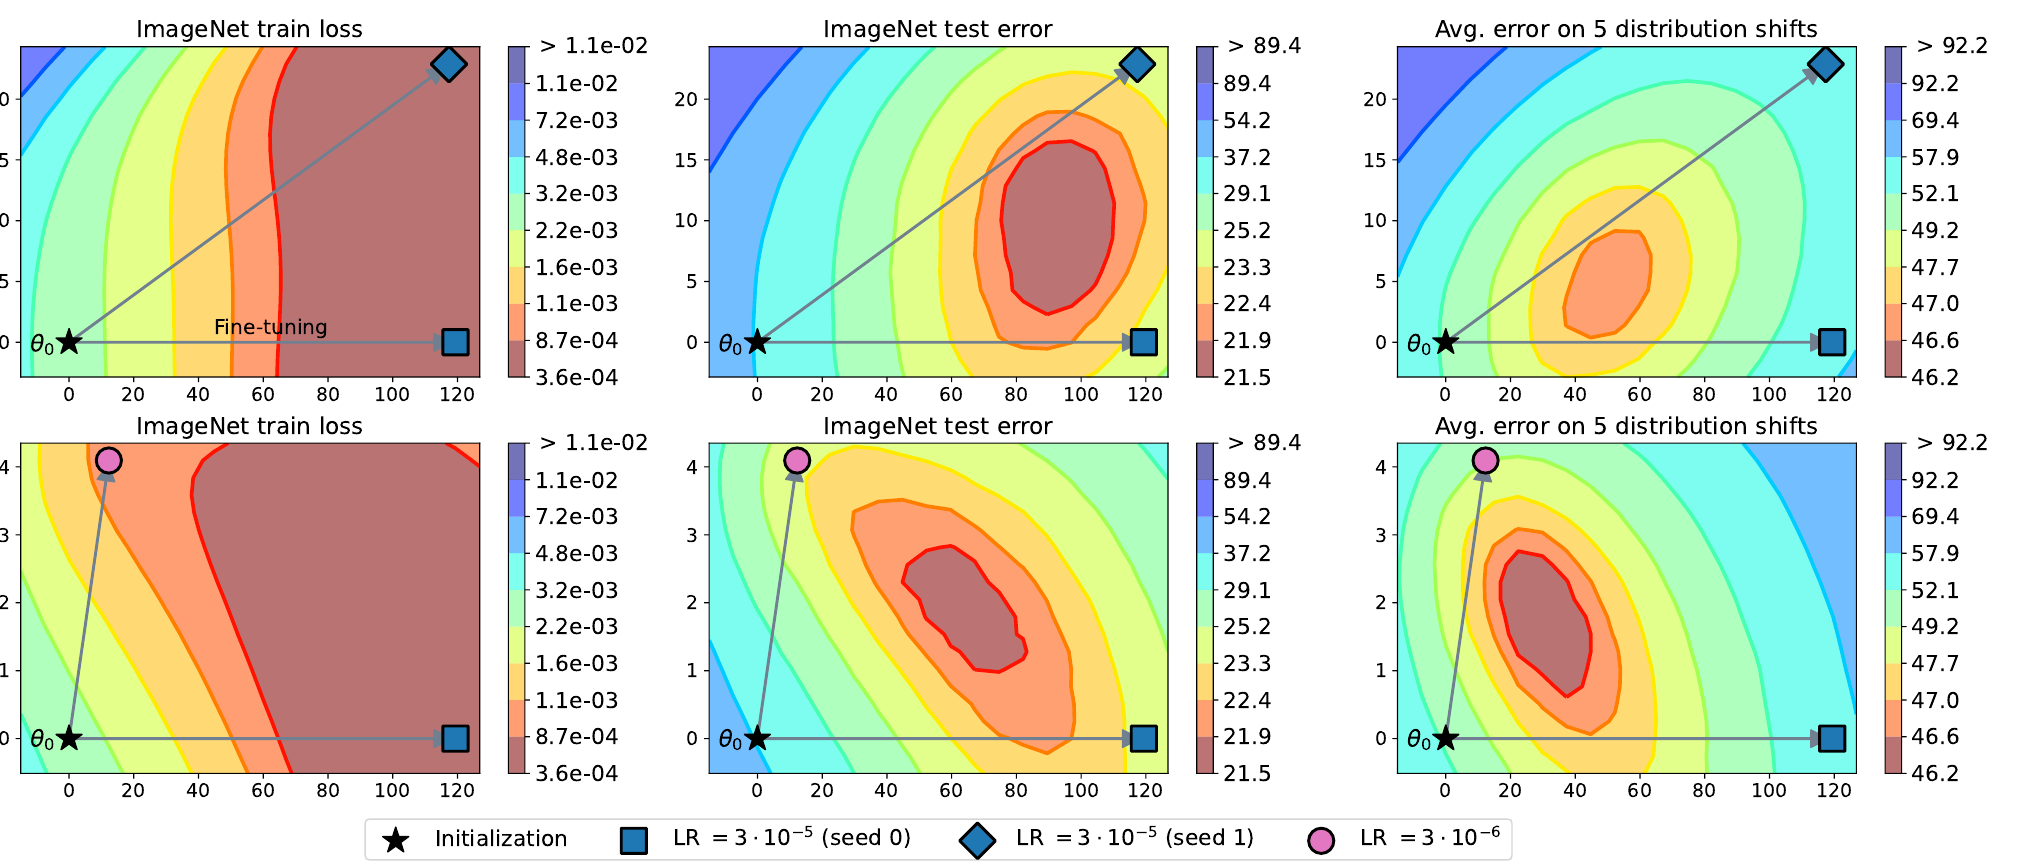
这张图解释了为什么汤可能比较好。作者从零样本的 CLIP 出发微调两次,用起点和两个终点撑出一个平面,在平面上画出损失和错误率。
左边一列的训练损失,两个微调结果都已经落在很低的区域。中间和右边的测试错误率却不一样,等高线是一个盆地,最低的地方在两个微调结果之间,三个点都不在谷底。微调把模型推向训练损失低的地方,测试错误率最低的地方却偏到了一旁。
夹角越大,平均越有用
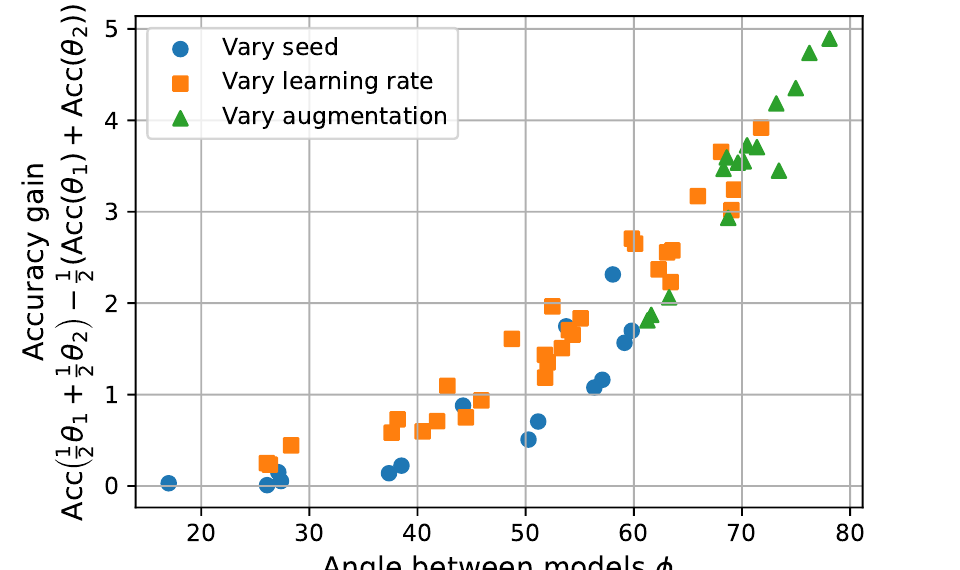
既然最好的点在中间,那平均的好处有多大?作者定义一个「插值优势」:
再看它和两个模型夹角的关系。夹角 是 和 之间的角度,也就是把预训练权重当原点,看两次微调往不同方向走了多远。
图上的点大致排成一条往右上的曲线。只换种子的蓝点多半落在左下,夹角较小,好处也小;换学习率或数据增强,夹角容易拉大,平均的好处也跟着变大,最多大约 5 个百分点。
这也说明了为什么要扫超参数再平均。模型之间越不像,平均起来越有用;前提是它们还在同一个盆地里。
72 个 CLIP
主要实验是把 CLIP ViT-B/32 在 ImageNet 上用随机搜索的超参数微调 72 次:
这批模型共用预训练起点,主要设置的分类头先用 linear probe 初始化,再端到端微调。搜索会变动学习率( 到 )、weight decay、4 到 16 个训练 epochs、label smoothing、mixup 和数据增强。它刻意保留一般超参数搜索会遇到的好坏模型,测的是搜索结束后能多取回多少收益。
| 做法 | ImageNet | 五个偏移数据集平均 |
|---|---|---|
| 最好的单一模型 | 80.38 | 47.83 |
| 均匀汤(72 个全部平均) | 79.97 | 51.45 |
| 贪婪汤 | 81.03 | 50.75 |
| 学习汤(逐层系数) | 81.37 | 50.87 |
| 72 个模型的输出集成 | 81.19 | 50.77 |
准确率(%),整理自原论文 Table 3。
均匀汤在 ImageNet 上比最好的单一模型还差,在分布偏移数据上却高了三个多百分点,显示有些成员确实把平均拖下水了。贪婪汤在两边都赢过最好的单一模型,ImageNet 只比 72 个模型的集成低 0.16 个百分点,推理却只跑一次。
这锅 CLIP 的贪婪汤最后只留下 5 个成员;ALIGN 的另一组实验从 12 个候选里也选了 5 个。逐层 learned soup 的 81.37% 更高一些,但单一组全局系数的 learned soup 是 80.89%,低于贪婪汤。若改做贪婪输出集成,ImageNet 还能到 81.90%,偏移数据平均却是 49.44%。方法排名会跟选模目标一起变,不能只拿某一列的最好成绩来概括全部收益。
作者也比较了两个模型的汤和集成。学习率中等时,两者的准确率高度相关;集成在 ImageNet 上通常略好,汤在分布偏移数据上略好。学习率太大时,两个模型离得太远,集成就明显赢过汤。
刷新纪录的那一锅
最受注意的是 ViT-G/14。这个模型先在 Google 的 JFT-3B 上预训练,作者在 ImageNet 上微调了 58 次,贪婪汤从中挑了 14 个:
| 模型 | ImageNet | 分布偏移平均 |
|---|---|---|
| CoAtNet-7(当时的最佳纪录) | 90.88 | – |
| ViT-G,超参数搜索中最好的单一模型 | 90.78 | 84.68 |
| ViT-G,贪婪汤 | 90.94 | 85.02 |
Top-1 准确率(%),整理自原论文 Table 1。
90.94% 是当时 ImageNet 的最佳纪录,推理计算量还比 CoAtNet-7 少 25%。和超参数搜索中最好的模型比,进步是 0.16 个百分点,训练预算一点都没多花。
管用的范围
作者另外在 ALIGN、BASIC、WILDS 的两个数据集,以及 BERT、T5 的四个 GLUE 文本分类任务上试过。图像分类上的趋势一致;文本分类也有进步,但幅度没有图像分类那么明显,作者把它当成初步结果。
文本实验每个任务随机搜索 32 组微调设置,变动学习率、batch size、epochs 和种子。四个任务分别是句对改写 MRPC、蕴涵判断 RTE、语法可接受度 CoLA、情绪分类 SST-2;指标也不同,MRPC 取 accuracy 与 F1 的平均,CoLA 用 Matthews correlation,RTE 和 SST-2 才是准确率。BERT-base 的 RTE 从 61.0 到 61.7,SST-2 从 92.5 到 93.0,MRPC 与 CoLA 则没有增加;T5-base 的 RTE 从 78.3 到 79.1。这组结果支持同任务微调模型的合并,还没有测一锅汤同时解决四种不同任务。
他们也坦白写了两个限制。一是适用范围,实验大多用在大规模、多样数据上预训练的模型;换成 ImageNet-22k 预训练的模型,贪婪汤仍有进步,但幅度小得多。二是校准,集成能让模型的置信度更准,汤没有这个效果。
校准的比较另取 20 个只差随机种子的模型,避免把超参数差异混进来,再量 expected calibration error。分类得更准和预测概率更可信,是两项需求;部署时若要靠概率设拒答门槛,还得直接检查后者。
一样待在盆地里,为什么还会输给集成?
前面的图给了几何直觉,论文还进一步分析汤与 logit 集成的交叉熵差异。对两模型插值,近似式包含两部分,一部分和沿线损失的二阶导数有关,另一部分是端点 logit 差异在汤的 softmax 分布下的方差。
损失沿线的弯曲形状有利于汤时,第一部分会拉低汤的相对损失;第二部分则有利于输出集成。如果两个模型本来就很像,logit 差异很小,或汤的预测已很确定、softmax 几乎集中在一类,方差项就小。这解释了为什么只说「在同一个盆地」还不够预测两者的差距。
这个近似建立在 logits 沿线接近线性的情况。作者排除学习率 那组距离太远的模型后,近似与实际误差差异更相关;把学习率拉到 的地形对照里,两个微调终点之间已经能看到明显的障碍。贪婪检查有用,就是因为共享起点仍会遇到这种失败成员。
结论
模型汤把「扫完超参数只留一个」改成「扫完超参数,挑一些加进去平均」。训练成本不变,推理仍是一个模型,在 CLIP 和 ViT-G 上都赢过挑最好的那一个。
它成立的条件和 WiSE-FT 一样,所有成员都从同一个预训练权重出发,而且最好还待在同一个盆地里。贪婪汤的验证集检查,就是在挡那些跑出盆地的成员。
如果你手上刚好有一批同一个基底、不同超参数的微调模型,与其只留下最好的一个,不如先照这个顺序试着煮一锅。