原始论文
REPAIR: REnormalizing Permuted Activations for Interpolation Repair
- 发表版本
- ICLR 2023会议
- arXiv 首次提交
- arXiv:2211.08403
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingrepair2022,
  title = {{REPAIR: REnormalizing Permuted Activations for Interpolation Repair}},
  author = {Keller Jordan and Hanie Sedghi and Olga Saukh and Rahim Entezari and Behnam Neyshabur},
  year = {2022},
  eprint = {2211.08403},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2211.08403}
}
2022 年底,关于「排列对齐之后能不能直接平均两个网络」,文献上出现两个互相矛盾的结果。
一边是 Singh 与 Jaggi 在 2020 年用最优传输(optimal transport)做神经元对齐。两个在 CIFAR-10 上准确率超过 93% 的 ResNet18,对齐后线性插值,中点最好也只有 77%,还差 16 个百分点。
另一边是 2022 年 9 月的 Git Re-Basin。它在把宽度放大的 ResNet 上,让 CIFAR-10 上两个独立训练的模型做到几乎零障碍;它比较的对齐方法之一「激活比对」,正是 Singh 与 Jaggi 的方法所涵盖的特例。
两个结果怎么可能同时成立?
Hive AI 的 Keller Jordan 与 Google、TU Graz 的 Sedghi、Saukh、Entezari、Neyshabur 合写的这篇论文给出了答案。后四位正是提出排列不变性猜想的同一组作者。
定义问题
前一篇 Entezari 等人的普查已经看到,对齐后的障碍会随宽度下降,却随深度急剧上升。超过几层的 MLP 或 CNN,对齐也救不回来。
作者想知道,深度到底弄坏了什么。
他们没有继续改进对齐算法,而是直接打开插值后的网络,看每一层的激活值。衡量方式很简单,对某一层,算出每个神经元在一批训练数据上的激活方差,再加总成 。插值模型的 和两个端点模型的 、 比较:
比例接近 1,代表插值模型的激活值和端点模型一样活跃;接近 0,代表这层的输出几乎不随输入改变。
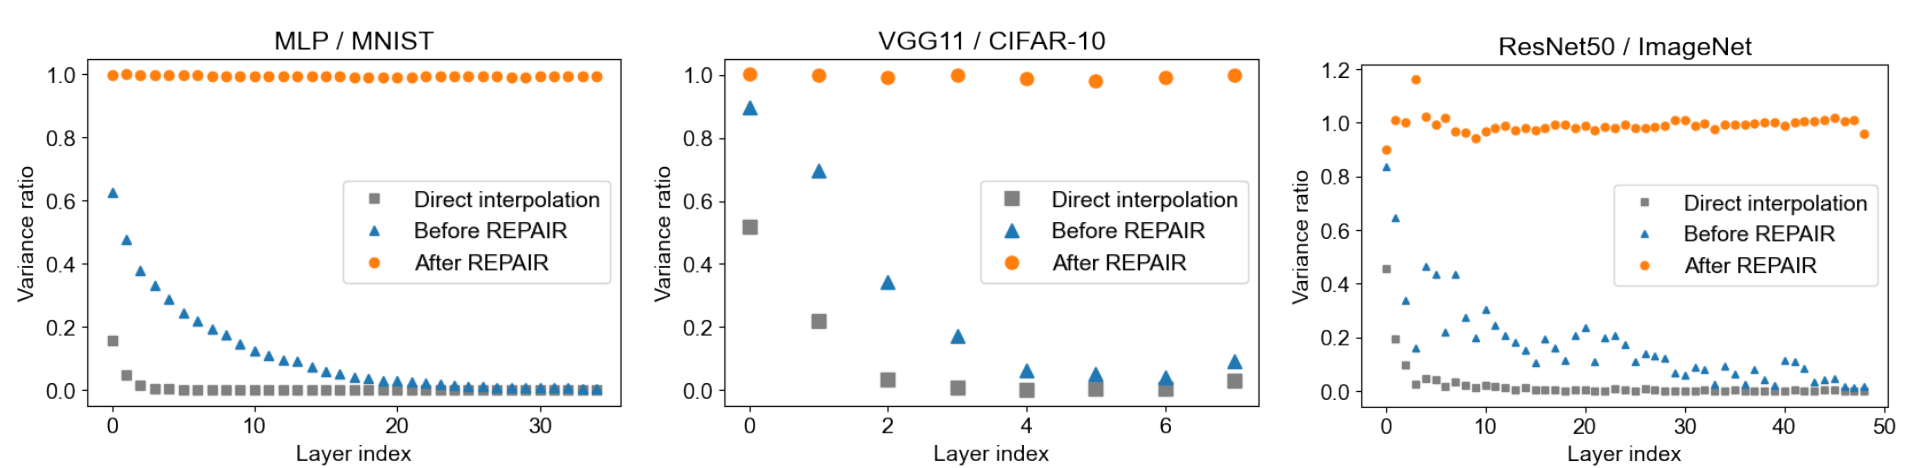
先看蓝色三角形,这是对齐之后、还没修正的插值模型。MLP 第一层的方差比约 0.6,之后一层一层往下掉,到了 35 层的最后几层几乎是零。VGG11 和 ResNet50 也一样,最后几层的方差掉了十倍以上。
作者把这个现象称为方差塌缩(variance collapse)。最后几层的激活值几乎是常数,网络已经分不出不同的输入,准确率自然好不了。
灰色方块是没有对齐直接插值,塌得更快。
解决问题
方差为什么会缩水
先看插值网络的第一层。第一层的输入就是原始数据,所以某个神经元插值后的预激活值(ReLU 之前的值),刚好是两个端点对应神经元的线性组合:
把 、 看成随数据变动的随机变量。取中点 ,
第一项是我们期待的方差,也就是两端标准差平均后再平方;第二项是被扣掉的部分,只要两个神经元的相关系数小于 1,就一定会扣。
如果两个端点的标准差差不多,式子化简成
对齐做得再好,两个独立训练的网络也不会学到一模一样的神经元。作者观察到,对齐后配成一对的神经元,相关系数通常只有 0.4 左右。代进去,
第一层的方差就少了 30%。
更深的层没办法这样精确推导,因为输入已经是前一层缩水过的激活值。作者的直觉是损失会一层一层累积。若粗略假设每层都只剩七成,10 层之后就剩 。
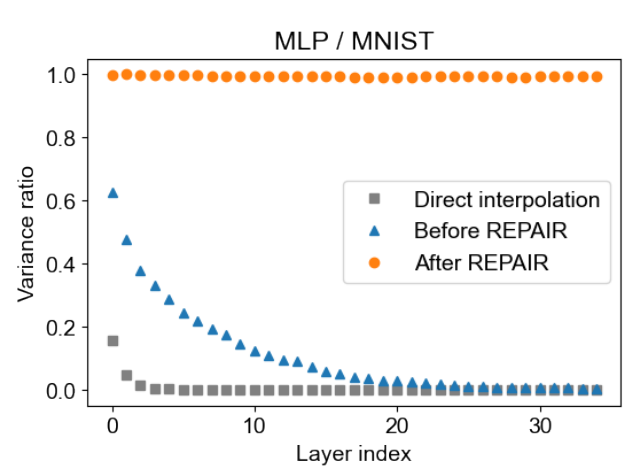
拿这个粗估对照 MLP 的实测。蓝色三角形从第 0 层的约 0.62 开始,第 10 层还有约 0.12,要到第 20 层左右才掉到 0.03 上下。实际的衰减比每层七成慢,但一层接一层往下掉的形状是一样的。
REPAIR 要做到什么
既然问题出在统计量,就把统计量修回来。对每一个要修正的通道,REPAIR 要求插值模型满足两个条件:
均值插值本来就会成立,真正被破坏的是第二条。修正前通常是 。
要修哪些通道,作者的选择是 VGG 的每一个卷积层输出;ResNet 除了卷积层输出,还要加上每个残差块的输出。
近似版:一个缩放系数
如果只看第一层,修正系数可以直接算出来。从端点模型测到 、、 之后,插值神经元的方差是
所需的缩放系数就是「目标标准差除以实际标准差」:
用前面的数字代入,、两端标准差相同时,,把每个神经元的输出放大两成即可。
这个系数对第一层是精确的,对更深的层只是近似。作者在 MNIST 上训练 2 到 50 层的 MLP 测试,没有修正时,中点模型超过 6 层就掉到 90% 以下;用这个近似修正,到 27 层都还能维持 90% 以上。
近似版的好处是只需要在端点模型上做前向传播;统计量算好之后,任何 的修正系数都能直接算出来。
精确版:借 BatchNorm 来测
近似版在 ImageNet 的 ResNet50 这类困难情况上不够用。作者因此提出精确版,直接在插值模型上做前向传播。
做法是在每个要修正的模块后面,临时接上一层 BatchNorm:
from torch import nn

class RepairWrap(nn.Module):
    def __init__(self, module, channels):
        super().__init__()
        self.module = module
        self.bn = nn.BatchNorm2d(channels)      # 新加的层,先开 train 模式

    def set_goal(self, goal_mean, goal_std):
        self.bn.bias.data = goal_mean            # (1-α)·E[X1] + α·E[X2]
        self.bn.weight.data = goal_std           # (1-α)·std(X1) + α·std(X2)

    def forward(self, x):
        return self.bn(self.module(x))
BatchNorm 在训练模式下会先把输入归一化成均值 0、方差 1,再乘上 weight、加上 bias。把这两个参数设成目标的标准差与均值,输出的统计量就刚好是条件要求的样子。
接着把大约 5,000 条训练数据送进网络,让新加的 BatchNorm 估出 running mean 与 running variance;原本网络里的 BatchNorm 全部冻结。估完之后切到评估模式,新加的层就变成固定的缩放与平移,最后可以融合进前一层卷积的权重,模型架构和原本一模一样。
这里有一个有趣的对照。如果网络本来就在每个卷积后接 BatchNorm,那只修正卷积输出,在数学上就等于重新估一次 BatchNorm 的统计量。SWA 在 2018 年就这样处理平均后的模型,只是没有人把它用在两个独立训练的网络之间。REPAIR 把这个做法推广到残差块的输出,以及没有 BatchNorm 的网络。
REPAIR 和对齐算法是互补的,作者在本文中都用 Li 等人 2015 年的激活相关性匹配,再用匈牙利算法求解;有残差连接的网络,同一条残差流上的各层必须套用同一个排列。
讨论
CIFAR-10 上的 ResNet18
两个对齐后的 ResNet18,端点在 CIFAR-10 测试集上是 95.5%。直接插值的中点只有 66.0%;REPAIR 之后中点变成 94.1%,障碍只剩 1.5 个百分点。对照组 Singh 与 Jaggi 的最优传输对齐,中点是 77.0%。
归一化层解开了矛盾
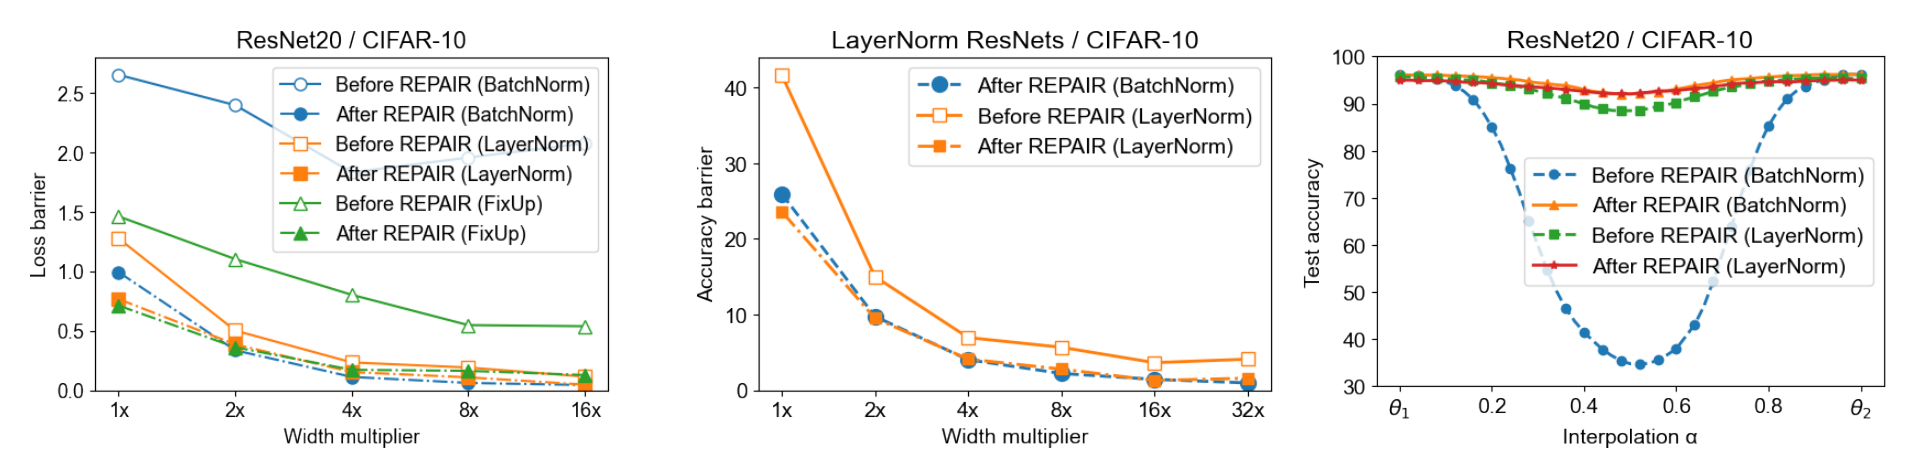
作者在 CIFAR-10 上训练 ResNet20,比较三种归一化:BatchNorm、LayerNorm,以及不用归一化的 Fixup,宽度倍率从 1× 到 16×(最后一个块从 64 到 1024 个通道)。
右图最有说服力。标准宽度的 BatchNorm 版本,修正前中点掉到 34.7%;LayerNorm 版本修正前就有 88.4%。修正之后两者都是 92.0%。
8× 宽度时也一样。LayerNorm 中点修正前已有 90.3%,修正后 93.2%;BatchNorm 修正前只有 32.3%,修正后 94.4%。左图显示,宽度放到 16× 时,BatchNorm 和 LayerNorm 修正后的损失障碍都低于 0.05。
为什么 LayerNorm 特别?作者的解释是,LayerNorm 在推理时也会按当前的输入重新归一化,每层缩水的方差会被拉回来,不会一路累积。BatchNorm 在推理时只是一个固定的仿射变换,缩水会一层一层叠上去。
这就是开头矛盾的答案。作者查了 Git Re-Basin 的代码,发现它的 ResNet 把 BatchNorm 换成了 LayerNorm。Singh 与 Jaggi 用的是标准 BatchNorm 的 ResNet18,所以对齐再好也被方差塌缩拖垮。
LayerNorm 也有代价。同样的训练设置下,LayerNorm 版 ResNet20 在 CIFAR-10 上是 92.4%,BatchNorm 版是 93.6%。
ImageNet
ImageNet 上,对齐后直接插值的 ResNet18、ResNet50 与两倍宽的 ResNet50,中点准确率都低于 1%。REPAIR 之后分别变成 41.1%、56.5%、64.2%。
残差块输出要不要修正,差距不小。ResNet50 只修正卷积输出时中点是 53.2%,加上残差块输出变成 56.5%,障碍从 23.4 个百分点降到 20.1。
但这仍是相当大的障碍。标准 ResNet50 修正后还有 20.1 个百分点,两倍宽是 12.9。作者推测,困难的数据集需要更宽的网络,障碍才会降到很低。
宽度与深度
10 层 MLP(宽度 32 到 2048)与 ResNet20(宽度 1× 到 16×),在 MNIST、FashionMNIST、SVHN、CIFAR-10 四个数据集上,REPAIR 都降低了障碍,而且越宽越低;MNIST 上连较窄的网络都接近零。
深度方面,CIFAR-10 上的 VGG 从 11 层到 19 层,修正前障碍随深度上升,修正后几乎和深度无关。Entezari 等人普查看到的「深度让障碍变高」,至少有一部分来自方差塌缩。
合并不同数据训练的模型
最后一个实验重现 Git Re-Basin 的设置。CIFAR-100 的 50,000 张训练图分成两份各 25,000 张,第一份取前 50 类的 80%、后 50 类的 20%,第二份反过来。两个网络各自擅长一半的类别。
对齐并用 REPAIR 修正后,插值路径上不少模型在完整测试集上的损失比两个端点都低。最好的出现在 ,测试损失 1.30;Git Re-Basin 报告的最佳值是 1.73,也在 。作者坦白说,这个差距一部分来自 REPAIR,一部分来自标准 ResNet 本来就比 LayerNorm 版本强。
这还算排列吗
作者在讨论里提了一个诚实的问题。REPAIR 让更多情况做到低障碍,看起来支持 Entezari 的猜想;但它重新缩放了插值模型的预激活值,已经不是严格的「排列后线性插值」了。
换句话说,在实际可用的宽度、又不换成 LayerNorm 的前提下,光靠排列似乎不够,还需要这种统计量的修正。猜想本身仍然没有被证实。
实际使用时也要记得,REPAIR 需要训练数据。端点模型的统计量要用训练数据来测,精确版还要再送几千条数据进插值模型。手上只有权重、没有数据时,这一步做不了。
结论
这篇论文把一个看似是对齐问题的现象,追到插值网络内部的统计量。两个神经元只要不完全相关,平均之后方差就会缩水,而 BatchNorm 网络会让这个缩水一层层叠加,最后整个网络对输入失去反应。
修正方法只是把每个通道的均值与标准差拉回两个端点之间的插值。ResNet18 在 CIFAR-10 上的障碍,从 Singh 与 Jaggi 最优传输对齐留下的 16 个百分点降到 1.5,ImageNet 上的 ResNet50 从不到 1% 救回到 56.5%。
平常在做权重平均的话,平均完记得重新估一次 BatchNorm 的统计量。官方代码在 KellerJordan/REPAIR,修正只要拿几千条训练数据跑一次前向传播。
SWA 在 2018 年就这样做了,只是那时平均的,都是同一条训练轨迹上的模型。