原始论文
What is being transferred in transfer learning?
- 发表版本
- NeurIPS 2020会议
- arXiv 首次提交
- arXiv:2008.11687
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltuningwhatistransferred2020,
  title = {{What is being transferred in transfer learning?}},
  author = {Behnam Neyshabur and Hanie Sedghi and Chiyuan Zhang},
  year = {2020},
  eprint = {2008.11687},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2008.11687}
}
拿 ImageNet 预训练权重来微调,几乎是计算机视觉的标准开局。
照片分类用它,医学影像用它,连手绘涂鸦也用它。大家都知道有效,常见的解释是「特征重用」:预训练学会了边缘、纹理、形状,下游任务直接拿来用。
可是这个解释有一个明显的漏洞。胸部 X 光和 ImageNet 的照片长得一点都不像,涂鸦更是几条线而已,为什么预训练还是有帮助?
Google 的 Neyshabur、Sedghi、Zhang 三人设计了一组实验,把「预训练到底带过去了什么」拆成几个可以测量的问题。其中一个答案,后来成了模型合并的重要依据。
定义问题
作者把模型分成四种,后面会一直用到这组缩写:
- P:ImageNet 预训练好的模型。
- RI:随机初始化的模型。
- P-T:从 P 出发,在目标数据上微调(fine-tune)后的模型。
- RI-T:从 RI 出发,直接在目标数据上训练的模型。
目标任务选了四个和 ImageNet 距离不同的数据集。DomainNet 的 real(真实照片)、clipart(剪贴画)、quickdraw(Google「Quick, Draw!」游戏里玩家的涂鸦),以及 CheXpert 的胸部 X 光,越往后越不像自然照片。
DomainNet 每个领域有 345 个物体类别,作者各抽 5 万张训练、5 万张测试;CheXpert 则从训练集抽两组各 5 万张,当作训练与测试,任务是判断五种胸部病征。
模型一律是 ResNet-50,搭配 Fixup 初始化,去掉了所有 BatchNorm 层。
要回答的问题有三个。预训练的好处有多少来自特征重用?P-T 和 RI-T 在参数空间里有什么不同?网络的哪些部分真正在迁移?
解决问题
先看学习曲线
在四个目标任务上,P-T 都比 RI-T 好,而且收敛快很多。差距最大的是 real,这符合特征重用的直觉,毕竟真实照片和 ImageNet 最像。
但 CheXpert 和 quickdraw 上也有提升。至少在这两个任务上,「重用视觉特征」似乎解释不了全部。
把图片打散
为了把特征重用拆出来,作者做了一个很直接的实验。把目标数据的图像切成大小相同的方块,随机打乱位置。
224×224 的方块等于没打乱;方块越小,物体的形状和结构就被破坏得越彻底。1×1 时每个像素都被打散,但一个像素的 RGB 三个值仍绑在一起移动,所以作者又多做一种「*」设置,让每个通道的像素各自乱跑,甚至跑到别的通道去。
到了「*」,图像只剩下一堆像素值的分布,任何视觉结构都没了,预训练学到的边缘和纹理不可能派上用场。
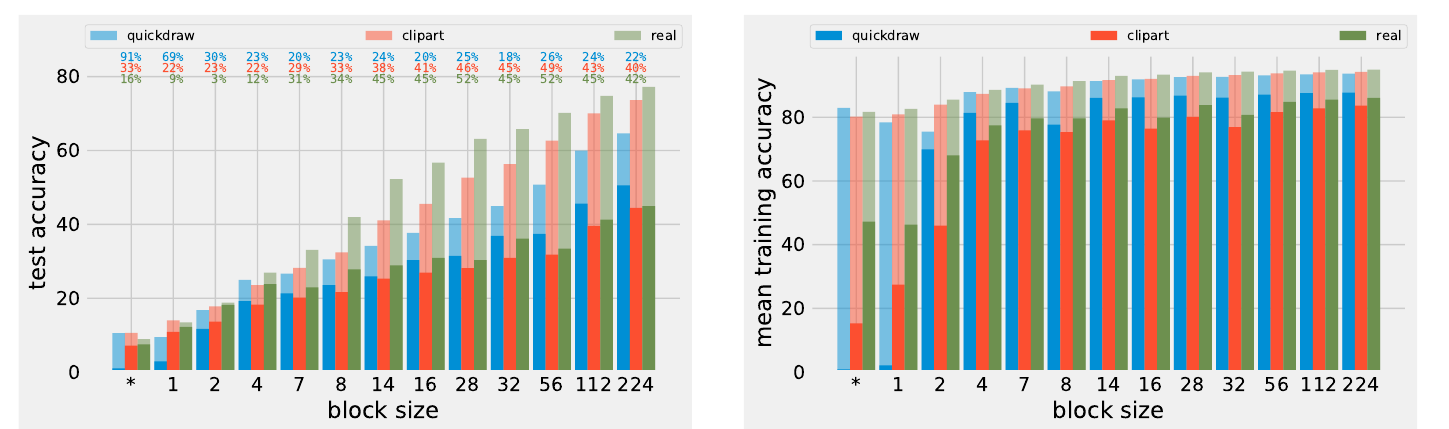
左图上方那三行小数字最值得看。它们是相对准确率差距 ,也就是预训练带来的好处占了多少比例。
real(绿色)在没打乱时是 42%,方块缩到 2 时剩下 3%。clipart(红色)也从 40% 左右降到 20% 出头。方块越小,预训练的好处越少,这是特征重用的证据。
quickdraw(蓝色)不一样。它在大部分方块大小都维持在 20% 到 25% 左右,没有随方块变小而下降;到了 1×1 和「*」,数字反而冲到 69% 和 91%。这两组 RI-T 几乎学不起来,相对差距才会这么大。
右图是训练速度。P-T 的训练准确率不管方块多小都很稳定,RI-T 则在小方块时大幅下降。在「*」设置下,quickdraw 的 RI-T 平均训练准确率接近零,P-T 仍在 80% 以上。
这张图把预训练的好处拆成两部分:
- 特征重用:和预训练数据越像,贡献越大,图像结构被破坏后就消失。
- 低阶统计:即使只剩下像素值的分布,预训练权重仍然让训练快很多,有时也让最终准确率更好。
作者用「低阶统计」称呼后者,强调它不带任何视觉或语义结构。至于预训练权重的哪种性质在帮助优化,例如权重的尺度,论文没有进一步拆解。
打开模型看看
接着作者比较训练好的模型本身。
错误的重叠。 两个 P-T(不同随机种子微调)犯的错很像;P-T 和 RI-T 之间不一致的错误多很多。作者看了 DomainNet 上的例子,P-T 错、RI-T 对的样本多半是模棱两可的图;P-T 对、RI-T 错的样本则包含不少简单的图。
特征相似度。 作者用 CKA(centered kernel alignment)比较两个模型在同一层输出的特征。CheXpert 上的 Table 1:
| 比较对象 | conv1 | layer 1 | layer 2 | layer 3 | layer 4 |
|---|---|---|---|---|---|
| P-T & P | 0.6225 | 0.4592 | 0.2896 | 0.1877 | 0.0453 |
| P-T & P-T | 0.6710 | 0.8230 | 0.6052 | 0.4089 | 0.1628 |
| P-T & RI-T | 0.0036 | 0.0011 | 0.0022 | 0.0003 | 0.0808 |
| RI-T & RI-T | 0.0016 | 0.0088 | 0.0004 | 0.0004 | 0.0424 |
两个 P-T 在每一层都很像;两个 RI-T 准确率也不差,特征却几乎不相似。越往输出端,P-T 和 P 的相似度越低,说明微调主要改动高层。
参数距离。 两个 P-T 在参数空间里也很近。CheXpert 上两个 P-T 的 距离约 200,两个 RI-T 约 255;DomainNet 三个领域的差距更明显,两个 P-T 在 178 到 219 之间,两个 RI-T 则在 777 到 822 之间。
同一个盆地
这是和模型合并最相关的一节。作者在两个解 和 之间做线性插值,看路径上的模型表现:
如果两个解在同一个平坦的盆地里,插值路径也会留在盆地内,表现不会掉下去。
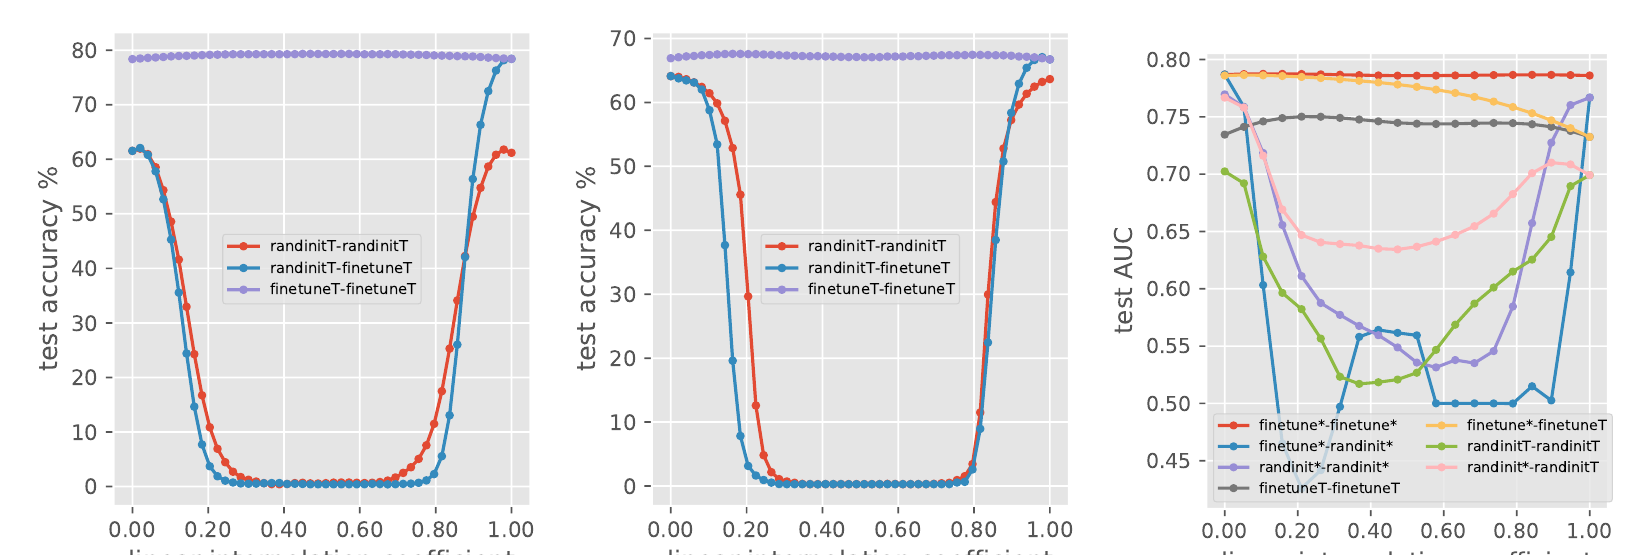
左边两张图很好读。real 上两个 P-T 之间的紫色线从头到尾都在 80% 附近,两个 RI-T 之间的红线在中段掉到接近零。quickdraw 也一样。
更有意思的是,作者让两个 RI-T 使用完全相同的随机初始值,只有训练过程的随机性不同,结果还是有障碍。共享起点本身不够,这个起点必须是预训练过的。CheXpert 上 RI-T 甚至在同一条训练轨迹的最佳 checkpoint 和最终 checkpoint 之间,也有一个小障碍;P-T 则没有。
作者也试着把「盆地」写成正式定义,称为 -basin。一个凸集要算盆地,里面多数点的损失要接近平均;在集合边界加高斯噪声或往外延伸,损失必须明显上升。用测试错误率当损失,两个 P-T 所在的盆地参数,real 是 、clipart 是 、quickdraw 是 ;两个 RI-T 则找不到合理的 让它们落在同一个盆地。
插值路径中段的模型,有时还比两端稍好一点。这是本文对后续研究最有用的观察,同一个预训练起点出发的微调模型,可以直接取平均。
哪些层在迁移
作者沿用 Zhang 等人的做法,把训练好的网络中某一个模块回滚到初始值,其他模块维持训练后的值,看表现掉多少。掉很多的模块叫做「关键」模块。
在 CheXpert 上,P-T 的关键模块分布和一般监督式训练差不多,差别只在全连接层对 P-T 变得关键,这很合理,因为分类头是新任务才训练的。
作者再扩展 Chatterji 等人的模块关键度定义,测量从初始值走到最优值的路径上,模块参数能承受多大的噪声。越靠近输出的模块,谷地越窄,越不能乱动;靠近输入的模块比较宽松。这呼应了「低层学通用特征、高层学任务专属特征」的旧观察,也指出特征重用主要发生在靠近输入的层。
RI-T 的模块在路径上还会出现一个转折点,谷地在那里忽宽忽窄。作者猜测可能和训练中途换了盆地有关,但也说不清楚。
预训练要练到多久
最后一个实验很实用。作者拿 ImageNet 预训练过程中每个 epoch 的 checkpoint 来微调;预训练在第 30、60 个 epoch 衰减学习率。
整体趋势是越后面的 checkpoint 越好,但有几个细节:
- 学习率衰减的前后几个 checkpoint(例如 29、30、31),微调结果差不多。预训练准确率在衰减时跳了一大截,对下游的帮助却没有同步跳升。
- 训练速度的好处大约在 checkpoint 10 就饱和了;最终准确率则在 real 和 clipart 上一直进步到 checkpoint 60 左右。quickdraw 的最终准确率很早就停在 checkpoint 10。
- 因此,预训练模型自己的准确率,不一定是迁移效果的可靠指标。
作者把这些结果和盆地的观察连起来。预训练早期的 checkpoint 还在最终盆地之外,进入盆地之后,从哪个 checkpoint 出发差不多,所以可以从比较早的 checkpoint 开始微调。
讨论
这篇是分析型论文,没有提出新方法,它的价值在于几个可以拿去用的观察。
证据的范围要记住。所有实验只有一个架构(无 BatchNorm 的 ResNet-50)、一个预训练来源(ImageNet),目标任务是四个图像数据集。作者在相关研究中明说,NLP 的迁移学习在数据性质、预训练方式和分布差距上都不同,这篇只研究视觉。
「低阶统计」也只是一个描述。它告诉我们打散图像后还剩下某种好处,至于是像素分布、权重尺度还是其他优化上的性质在起作用,论文没有分开验证。模块关键度的转折点,作者也只留下猜测。
「同一个盆地」这个观察的影响最大。作者在结论只用一句话提到,同一盆地内的模型取平均不会破坏表现。两年后,Model Soups 把它变成一个实际的做法,把许多用不同超参数微调的模型直接平均,并引用这篇作为平均可行的依据。
结论
预训练带过去的东西有两种。一种是视觉特征,下游数据越像 ImageNet 越有用;另一种是连像素都打散了还在的低阶统计,它主要让训练变快。
从同一个预训练权重出发的微调模型,彼此特征相近、参数距离近,线性插值没有障碍。从头训练的模型就算共用同一组随机初始值,也做不到这一点。
下次拿到两个从同一个预训练模型微调出来的权重,先别急着挑一个。把它们平均一下试试,说不定两个都比不上中间那一个。