原始论文
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2606.19348
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{deepseekdeepseekv42026,
  title = {{DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence}},
  author = {DeepSeek-AI and Anyi Xu and Bangcai Lin and Bing Xue and Bingxuan Wang and Bingzheng Xu and Bochao Wu and Bowei Zhang and Chaofan Lin and Chen Dong and Chenchen Ling and Chengda Lu and Chenggang Zhao and Chengqi Deng and Chengyu Hou and Chenhao Xu and Chenze Shao and Chong Ruan and Conner Sun and Damai Dai and Daya Guo and Dejian Yang and Deli Chen and Donghao Li and Dongjie Ji and Erhang Li and Fang Wei and Fangyun Lin and Fangzhou Yuan and Feiyu Xia and Fucong Dai and Guangbo Hao and Guanting Chen and Guoai Cao and Guolai Meng and Guowei Li and Han Yu and Han Zhang and Hanwei Xu and Hao Li and Haofen Liang and Haoling Zhang and Haoming Luo and Haoran Wei and Haotian Yuan and Haowei Zhang and Haowen Luo and Haoyu Chen and Haozhe Ji and Hengqing Zhang and Honghui Ding and Hongxuan Tang and Huanqi Cao and Huazuo Gao and Hui Qu and Hui Zeng and J Yang and JQ Zhu and Jia Luo and Jia Song and Jia Yu and Jialiang Huang and Jialu Cai and Jian Liang and Jiangting Zhou and Jiasheng Ye and Jiashi Li and Jiaxin Xu and Jiewen Hu and Jieyu Yang and Jin Chen and Jin Yan and Jingchang Chen and Jingli Zhou and Jingting Xiang and Jingyang Yuan and Jingyuan Cheng and Jingzi Zhou and Jinhua Zhu and Jiping Yu and Joseph Sun and Jun Ran and Junguang Jiang and Junjie Qiu and Junlong Li and Junmin Zheng and Junxiao Song and Kai Dong and Kaige Gao and Kang Guan and Kexing Zhou and Kezhao Huang and Kuai Yu and Lean Wang and Lecong Zhang and Lei Wang and Leyi Xia and Li Zhang and Liang Zhao and Lihua Guo and Lingxiao Luo and Linwang Ma and Linyan Zhu and Litong Wang and Liyu Cai and Liyue Zhang and Longhao Chen and MS Di and MY Xu and Max Mei and Miaojun Wang and Mingchuan Zhang and Minghua Zhang and Minghui Tang and Mingming Li and Mingxu Zhou and Minmin Han and Ning Wang and Panpan Huang and Panpan Wang and Peixin Cong and Peiyi Wang and Peng Zhang and Qiancheng Wang and Qihao Zhu and Qingyang Li and Qinyu Chen and Qiushi Du and Qiwei Jiang and Rui Tian and Ruifan Xu and Ruijie Lu and Ruiling Xu and Ruiqi Ge and Ruisong Zhang and Ruizhe Pan and Runji Wang and Runqian Chen and Runqiu Yin and Runxin Xu and Ruomeng Shen and Ruoyu Zhang and Ruyi Chen and SH Liu and Shanghao Lu and Shangmian Sun and Shangyan Zhou and Shanhuang Chen and Shaofei Cai and Shaoheng Nie and Shaoqing Wu and Shaoyuan Chen and Shengding Hu and Shengyu Liu and Shiqiang Hu and Shirong Ma and Shiyu Wang and Shuiping Yu and Shunfeng Zhou and Shuting Pan and Shuying Yu and Songyang Zhou and Tao Ni and Tao Yun and Tian Jin and Tian Pei and Tian Ye and Tianle Lin and Tianran Ji and Tianyi Cui and Tianyuan Yue and Tingting Yu and Tun Wang and W Zhang and WL Xiao and Wangding Zeng and Wei An and Weilin Zhao and Wen Liu and Wenfeng Liang and Wenjie Pang and Wenjing Luo and Wenjing Yao and Wenjun Gao and Wenkai Yang and Wenlve Huang and Wenqing Hou and Wentao Zhang and Wenting Ma and Xi Gao and Xiang He and Xiangwen Wang and Xianzu Wang and Xiao Bi and Xiaodong Liu and Xiaohan Wang and Xiaokang Chen and Xiaokang Zhang and Xiaotao Nie and Xiaowen Sun and Xiaoxiang Wang and Xin Cheng and Xin Liu and Xin Xie and Xingchao Liu and Xingchen Liu and Xingkai Yu and Xingyou Li and Xinyu Yang and Xinyu Zhang and Xu Chen and Xuanyu Wang and Xuecheng Su and Xueyin Chen and Xuheng Lin and Xuwei Fu and YC Yan and YQ Wang and YW Ma and Yanfeng Luo and Yang Zhang and Yanhong Xu and Yanru Ma and Yanwen Huang and Yao Li and Yao Li and Yao Xu and Yao Zhao and Yaofeng Sun and Yaohui Wang and Yi Qian and Yi Shao and Yi Yu and Yichao Zhang and Yifan Ding and Yifan Shi and Yijia Wu and Yiliang Xiong and Yiling Ma and Ying He and Ying Tang and Ying Zhou and Yingjia Luo and Yinmin Zhong and Yishi Piao and Yisong Wang and Yixiang Zhang and Yixiao Chen and Yixuan Tan and Yixuan Wei and Yiyang Ma and Yiyuan Liu and Yonglun Yang and Yongqiang Guo and Yongtong Wu and Yu Wu and YuKun Li and Yuan Cheng and Yuan Ou and Yuanfan Xu and Yuanhao Li and Yuduan Wang and Yuehan Yang and Yuer Xu and Yuhan Wu and Yuhao Meng and Yuheng Zou and Yukun Zha and Yunfan Xiong and Yupeng Chen and Yuping Lin and Yuqian Cao and Yuqian Wang and Yushun Zhang and Yuting Yan and Yutong Lin and Yuxian Gu and Yuxiang Luo and Yuxiang You and Yuxuan Liu and Yuxuan Zhou and Yuyang Zhou and Yuzhen Huang and ZF Wu and Zehao Wang and Zehua Zhao and Zehui Ren and Zekai Zhang and Zhangli Sha and Zhe Fu and Zhe Ju and Zhean Xu and Zhenda Xie and Zhengyan Zhang and Zheren Gao and Zhewen Hao and Zhibin Gou and Zhicheng Ma and Zhigang Yan and Zhihong Shao and Zhixian Huang and Zhixuan Chen and Zhiyu Wu and Zhizhou Ren and Zhongyu Wu and Zhuoshu Li and Zhuping Zhang and Zian Xu and Zihao Wang and Zihua Qu and Zihui Gu and Zijia Zhu and Zilin Li and Zipeng Zhang and Ziwei Xie and Ziyi Gao and Ziyi Wan and Zizheng Pan and Zongqing Yao},
  year = {2026},
  eprint = {2606.19348},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2606.19348}
}
从 DeepSeek-V3 到 DeepSeek-R1,这个系列一直在做同一件事:用更少的计算做出更强的模型。
推理模型出现之后,这件事多了一个新的难题。模型要先写一大段思考再回答,智能体任务还要在很长的工具调用记录里来回工作,上下文动辄几十万个 token。标准注意力的计算量随长度平方增长,KV 缓存也随长度线性变大。上下文一长,推理成本就整个被注意力吃掉。
DeepSeek-V4 是对这个问题的回答。报告公开的是预览版,有两个模型:DeepSeek-V4-Pro,总参数 1.6T、每个 token 激活 49B;DeepSeek-V4-Flash,总参数 284B、激活 13B。两者都原生支持一百万个 token 的上下文,权重也都公开。
报告里有三个架构上的新东西:混合了两种压缩注意力的 CSA 与 HCA、取代传统残差连接的 mHC,以及 Muon 优化器。后训练则有一个对模型合并来说很关键的改变,DeepSeek 不再把专家模型的能力用权重合并或混合强化学习整合,而是用多教师的 on-policy 蒸馏。
定义问题
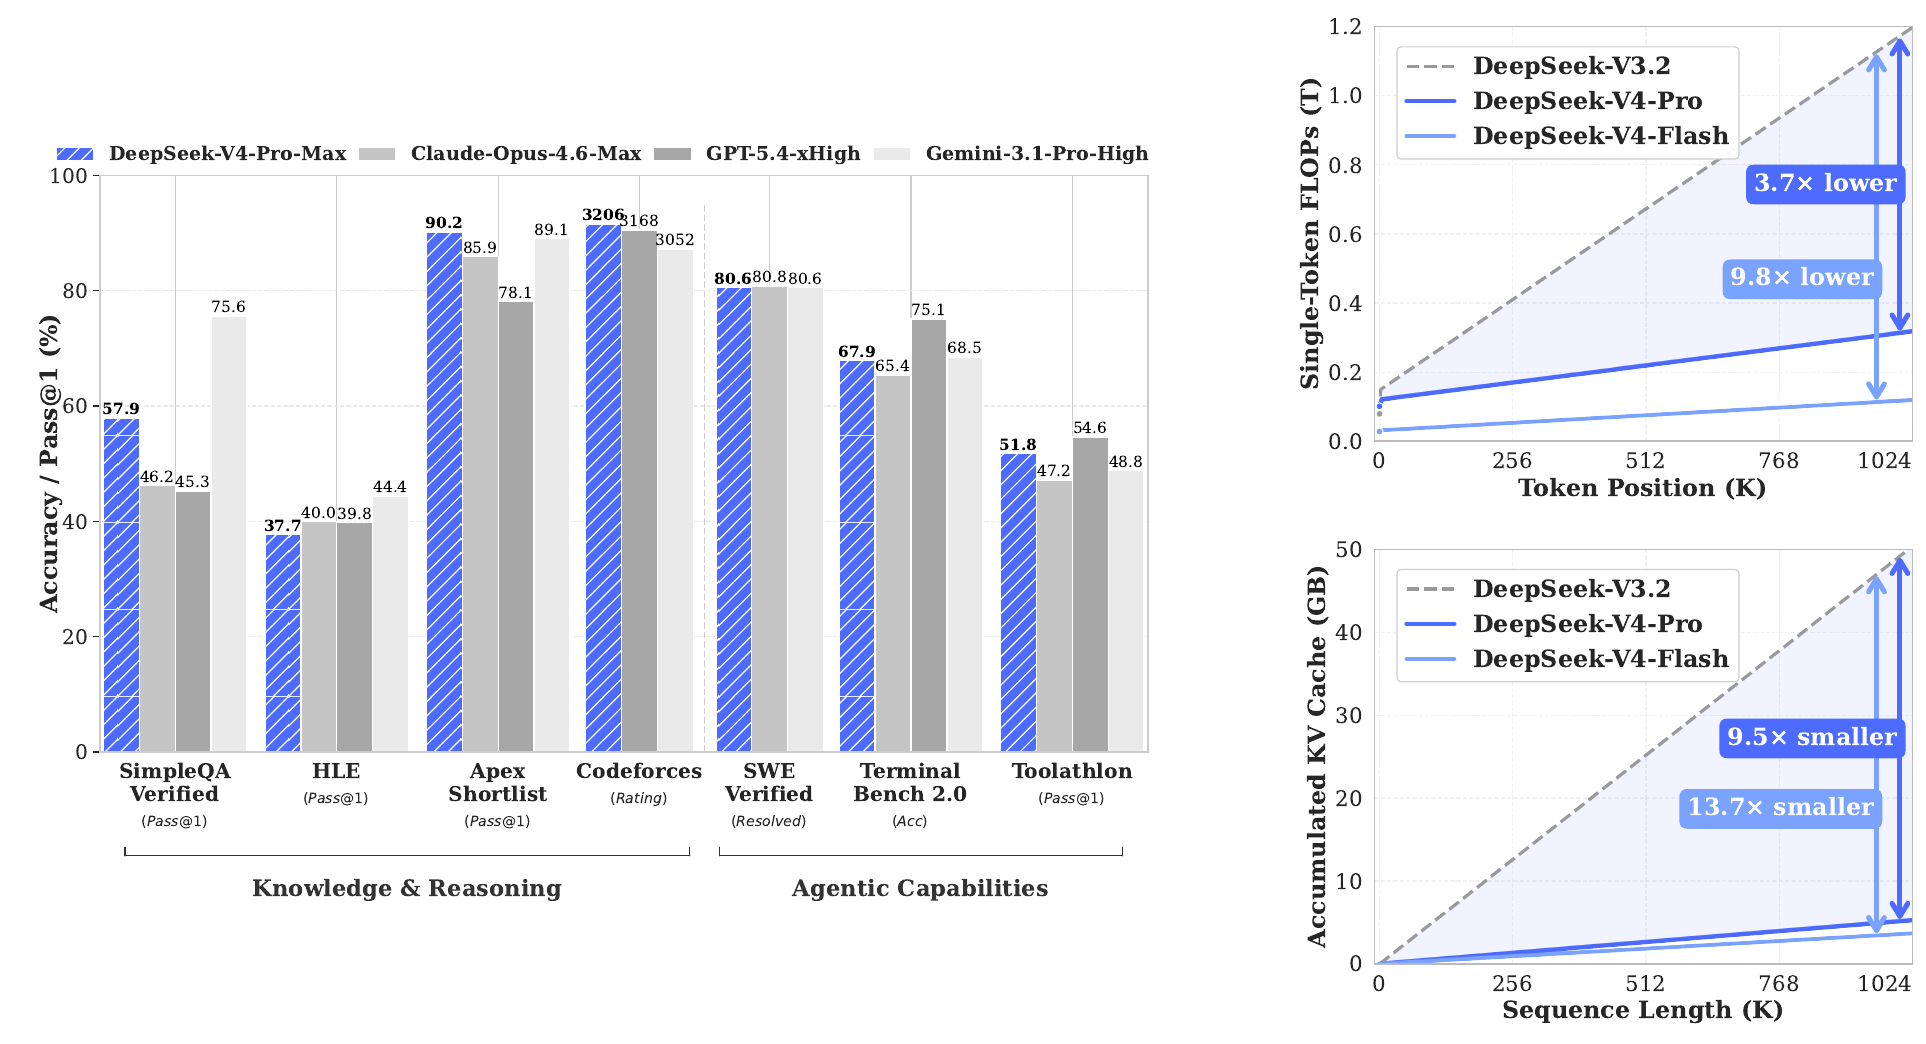
先看右边两张,这是整篇报告的目标。
右上图是生成一个 token 要花的计算量,横轴是这个 token 在上下文中的位置。上一代 DeepSeek-V3.2 的虚线几乎是一条直线往上,位置越靠后,每个 token 越贵。到了一百万个 token,V4-Pro 只需要 V3.2 的 27%,V4-Flash 只要 10%。
右下图是 KV 缓存。同样在一百万个 token,V4-Pro 只需要 V3.2 的 10%,V4-Flash 只要 7%。
要特别说明的是,V3.2 已经用了稀疏注意力,本身就不是一个浪费的基准;而 V4-Pro 每个 token 激活的参数还比 V3.2 多。所以这两张图的差距,主要来自注意力的重新设计。
左边是最强设置 DeepSeek-V4-Pro-Max 和三个闭源模型的比较,后面讨论时再回来看。
解决问题
整体架构
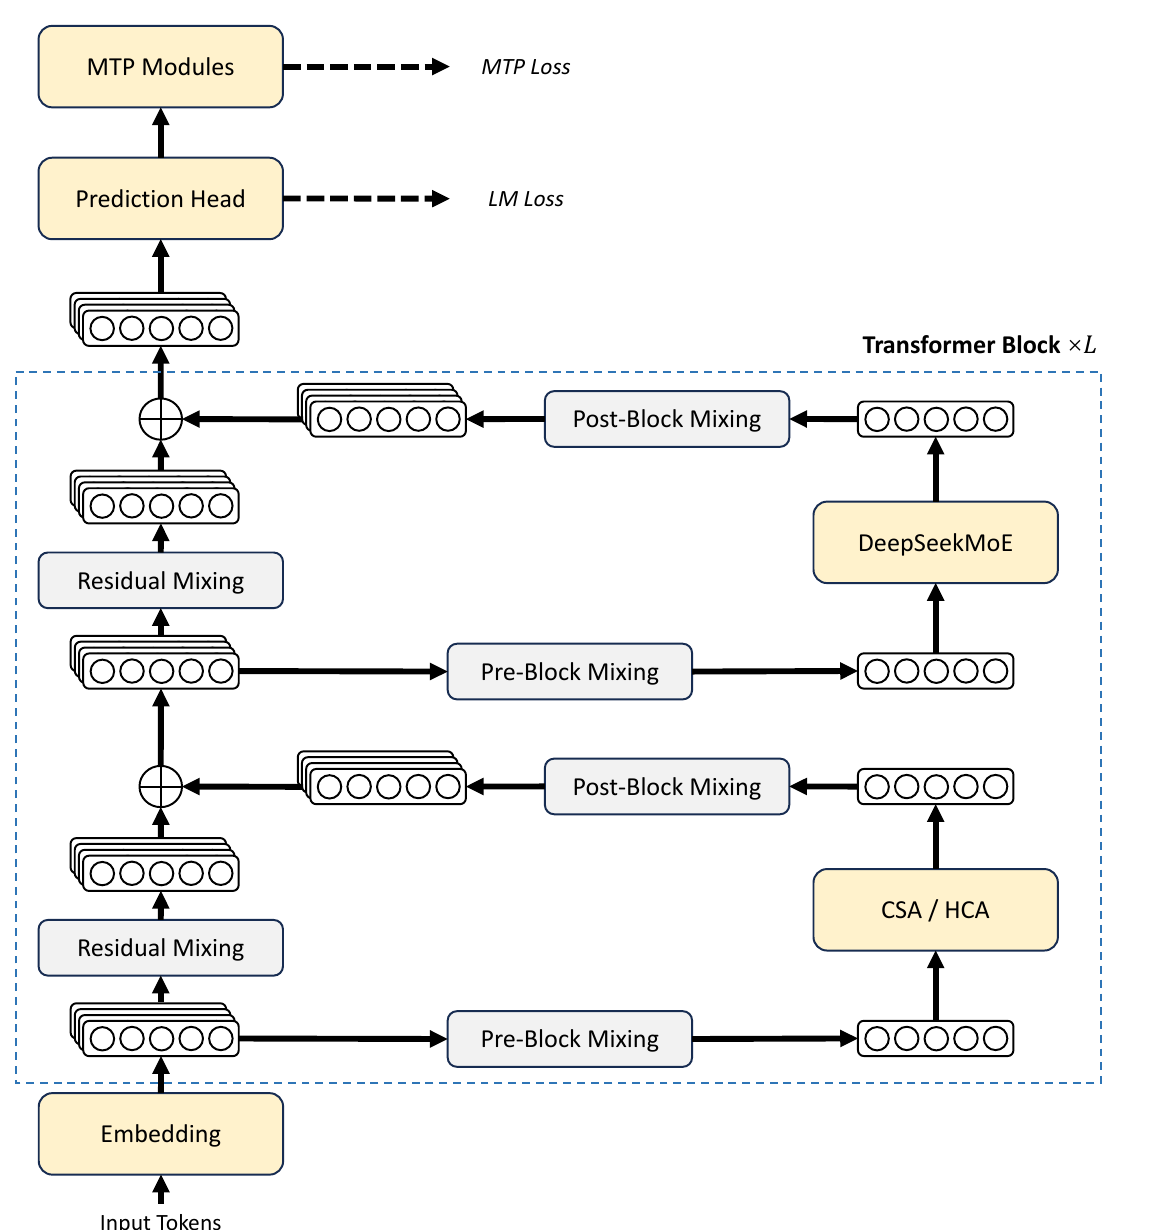
大部分沿用 DeepSeek-V3:前馈层是 DeepSeekMoE,有共享专家与细粒度的路由专家,负载均衡用不加辅助损失的偏置调整,也保留多 token 预测(MTP)。小改动有两个:计算路由亲和度的函数从 Sigmoid 换成 ;最前面几层原本是稠密的前馈层,现在也换成 MoE,但用哈希路由,直接依 token ID 决定送给哪个专家。
图上最显眼的,是残差流画成了四份叠在一起的向量,这就是 mHC。
mHC:把残差流加宽,再加上限制
一般的残差连接是 ,残差流只有一份,宽度等于隐藏维度 。
Hyper-Connections(HC)把残差流扩宽成 份,状态变成 ,再用三个小矩阵决定怎么读写:
把 份残差混成一份,作为这一层的输入; 把这一层的输出分配回各份残差; 让各份残差彼此混合。层本身的输入输出仍是 维,所以内部设计不用改,而 远小于 ,额外的计算很少。
HC 的问题是堆叠很多层之后,数值很容易不稳定。原因不难想象,每一层都乘上一个 ,若它的谱范数大于 1,连乘几十层信号就会爆炸。
mHC(Manifold-Constrained HC)的做法是把 限制成双随机矩阵:所有元素非负,每一行与每一列的总和都是 1。双随机矩阵的谱范数恰好是 1,不会放大信号;两个双随机矩阵相乘仍是双随机矩阵,所以叠再多层也一样。 和 则用 Sigmoid 限制为非负且有界,避免信号互相抵消。
把任意矩阵投影成双随机矩阵,用的是 Sinkhorn-Knopp 算法:先取指数让元素全为正,再反复做列归一化与行归一化。V4 迭代 20 次。我们用 试一次:
import numpy as np

rng = np.random.default_rng(0)
B_raw = rng.normal(scale=2.0, size=(4, 4))          # 未加限制的残差混合矩阵(n_hc = 4)
print("限制前的谱范数:", round(np.linalg.norm(B_raw, 2), 3))

M = np.exp(B_raw)                                     # 先取指数,保证每个元素为正
for _ in range(20):                                   # t_max = 20
    M = M / M.sum(axis=0, keepdims=True)              # 每一列求和为 1
    M = M / M.sum(axis=1, keepdims=True)              # 每一行求和为 1

print("行总和:", np.round(M.sum(axis=1), 4))
print("列总和:", np.round(M.sum(axis=0), 4))
print("限制后的谱范数:", round(np.linalg.norm(M, 2), 4))

x = rng.normal(size=4)
y = x.copy()
for _ in range(60):                                   # 连乘 60 层同样的残差混合
    y = M @ y
print("输入范数:", round(np.linalg.norm(x), 3), " 经过 60 层后:", round(np.linalg.norm(y), 3))
限制前的谱范数: 6.07
行总和: [1. 1. 1. 1.]
列总和: [1. 1. 1. 1.]
限制后的谱范数: 1.0
输入范数: 1.286  经过 60 层后: 0.297
限制前的矩阵谱范数是 6.07,连乘 60 层会是天文数字;投影之后是 1.0,连乘 60 层信号只会收敛,不会爆炸。这个例子为了凸显效果,60 层都用同一个矩阵;实际模型里每层的 不同,但每一个都是双随机的,结论相同。
实际的 、、 会依输入动态生成。做法是把 展平、做 RMSNorm,再经过小型线性层,加上静态的偏置,乘上一个初始很小的门控系数,最后才套上述的限制。V4 的两个模型都用 。
CSA 与 HCA:两种压缩注意力
注意力是长上下文的瓶颈。V4 设计了两种注意力,交错使用。
CSA(Compressed Sparse Attention) 先压缩,再稀疏选取。
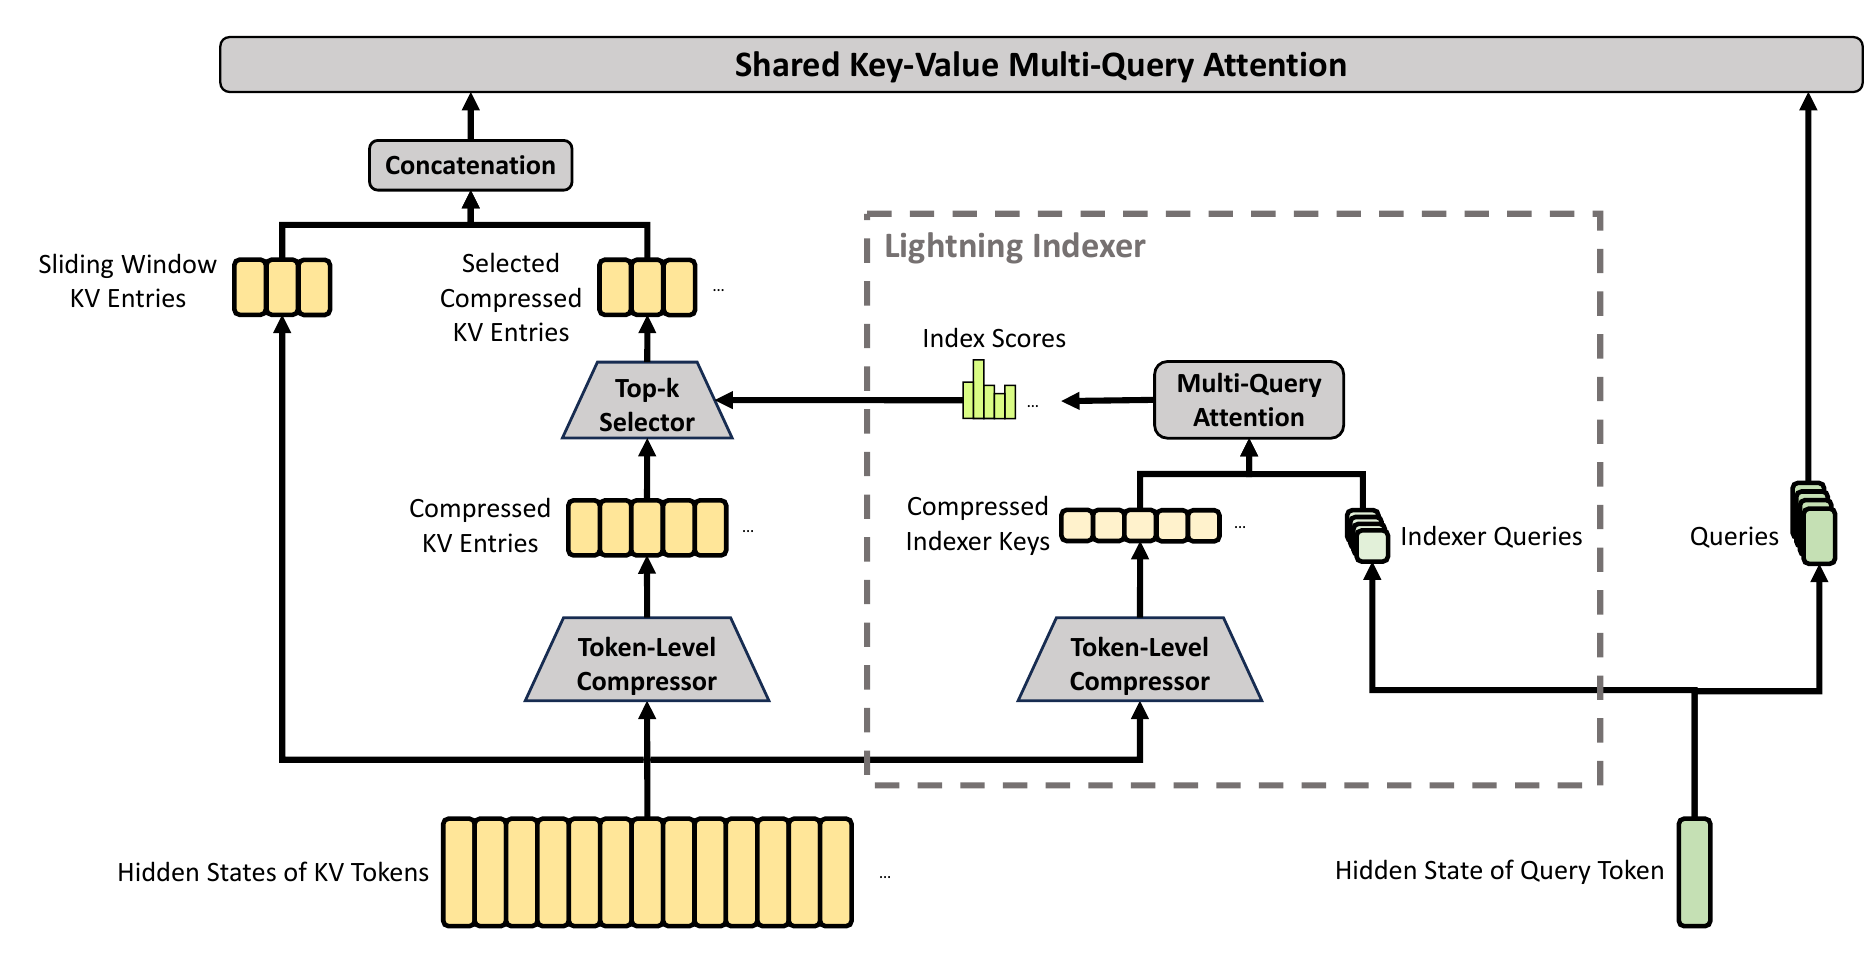
从下往上看。
第一步是压缩。每 个 token 的 KV 压成一个项,压缩权重由可学习的投影加上位置偏置,经过 softmax 决定,等于是这 个 token 的加权平均。V4 设 。
第二步是选取。这是沿用 V3.2 的 DeepSeek 稀疏注意力(DSA),由一个轻量的 lightning indexer 对所有压缩项打分,只挑出分数最高的 个。V4-Pro 的 ,V4-Flash 是 512。indexer 本身用 FP4 精度计算。
第三步是补上近处。压缩项只能看到「之前的整个区块」,看不到自己所在区块里的其他 token;而且语言模型通常最需要最近的上下文。所以另外加一条滑动窗口分支,保留最近 128 个未压缩的 KV。
最后,每个 KV 项同时当 key 和 value,所有查询头共享,是多查询注意力(MQA)的形式。
HCA(Heavily Compressed Attention) 则压得更狠,每 个 token 压成一项,但不做稀疏选取,所有压缩项都看;同样加上 128 个 token 的滑动窗口。
用一百万个 token 算一次,每个查询要看多少个 KV 项:
| 注意力 | 压缩后的 KV 项数 | 每个查询实际看的项数 |
|---|---|---|
| 标准注意力 | 1,000,000 | 1,000,000 |
| CSA(,Pro 的 ) | 250,000 | |
| HCA() | 约 7,813 | 约 |
CSA 靠稀疏选取,每个查询只看一千多项,但能从 25 万个压缩项中精挑细选;HCA 不挑,但每一项都代表 128 个 token,看的是整段上下文的粗略轮廓。两者交错使用,一种负责精准查找,一种负责全局概览。
KV 缓存的大小则取决于压缩后要存多少项。报告说,以常见的 BF16、8 组 GQA、头维度 128 为基准,V4 在一百万 token 时的 KV 缓存只有它的 2% 左右。这还加上了其他省法,例如 KV 项中 RoPE 的维度用 BF16、其他维度用 FP8,几乎省下一半。
报告也列了几个让这套设计能训练的细节:查询与 KV 项在注意力前各做 RMSNorm,避免注意力 logit 爆炸;RoPE 只用在最后 64 维;注意力加入可学习的 sink logit,让一个头的注意力总和可以小于 1。
Muon 优化器
V4 大部分参数改用 Muon 优化器,嵌入层、预测头、RMSNorm 权重与 mHC 的静态偏置则仍用 AdamW。
Muon 的核心是把动量矩阵「正交化」,让更新的所有奇异值都接近 1。精确做法要做奇异值分解,太贵,所以用 Newton-Schulz 迭代近似:
V4 的做法是「混合」的 10 次迭代。前 8 次用 ,快速把奇异值推到 1 附近;最后 2 次换成 ,把奇异值稳定在 1。
因为注意力架构本身已经对查询和 KV 做了 RMSNorm,注意力 logit 不会爆炸,V4 也就不需要其他 Muon 实现中用来压制 logit 的 QK-Clip。
预训练
配置
| V4-Flash | V4-Pro | |
|---|---|---|
| 层数 / 隐藏维度 | 43 / 4,096 | 61 / 7,168 |
| 路由专家(每 token 激活) | 256(6) | 384(6) |
| CSA 选取数 | 512 | 1,024 |
| 总参数 / 激活参数 | 284B / 13B | 1.6T / 49B |
| 训练 token | 32T | 33T |
两者的 CSA 压缩率都是 4、HCA 都是 128,前 3 个 MoE 层用哈希路由。V4-Flash 最前面两层只用滑动窗口注意力,V4-Pro 最前面两层用 HCA,之后 CSA 与 HCA 交错。
训练从 4K 的序列长度开始,逐步拉到 16K、64K、1M。稀疏注意力不是一开始就用。V4-Flash 前 1T 个 token 先用稠密注意力预热(V4-Pro 的稠密阶段更长),到 64K 长度时才加入,并先短暂预热 lightning indexer。学习率大部分时间维持固定,最后用 cosine 衰减到十分之一。
后训练阶段,路由专家的权重与 indexer 的 QK 路径还做了 FP4 的量化感知训练,进一步省下内存与计算。
损失尖峰怎么处理
训练万亿级参数的 MoE,损失尖峰很难避免。作者发现尖峰总是和 MoE 层里的离群值有关,而且路由机制本身似乎会放大离群值,形成恶性循环。单纯回滚只能暂时解决,尖峰还是会再发生。
他们找到两个有效的做法,也坦白说还不清楚原理:
- 预期路由(Anticipatory Routing):在第 步,用当前的参数 计算特征,但路由的决定用旧一点的参数 来算,切断主干网络与路由器同步更新造成的恶性循环。这会增加约 20% 的时间,所以平时不开;系统检测到尖峰时,自动短暂回滚并开启这个模式一段时间,之后再关掉。
- SwiGLU 截断:把 SwiGLU 的线性分支限制在 ,门控分支的上限设为 10,直接压掉离群值。
作者说这两招在 V4-Flash 和 V4-Pro 的训练中都有效,而且不影响表现。
基底模型的比较
作者比较了 V3.2、V4-Flash、V4-Pro 三个基底模型。其中 V4-Flash 最有意思,它的激活参数与总参数都比 V3.2 少,却在多数基准上胜过 V3.2,特别是知识类与长上下文任务。
后训练:从权重合并到蒸馏
先训练一群专家
后训练的第一步和 V3.2 类似,针对不同领域,先 SFT、再用 GRPO 做强化学习,训练出一群专家模型。
推理强度也用专家来做。V4 有三种推理模式:不思考、Think High、Think Max。每种模式用不同的长度惩罚与上下文长度训练,Think Max 还会在系统提示词的开头注入一段指令,要求模型「用最大的努力、不准走捷径」,把所有思考过程都写出来。
难以验证的任务,V4 不再训练一个输出分数的奖励模型,而是用评分准则搭配生成式奖励模型(GRM),而且让策略模型本身就兼任 GRM,评判能力和生成能力一起被强化学习优化。
用蒸馏取代合并
接下来的一步,正是这篇笔记想强调的。
有了十几个专家,要怎么把它们的能力整合进一个模型?Command A 用权重的线性合并;V3.2 则用混合的强化学习。V4 两者都不用,改用多教师的 on-policy 蒸馏(OPD):
是要训练的学生, 是第 个专家, 是它的权重。「on-policy」指的是训练数据由学生自己生成,再让各个专家对学生写出的每个 token 给出自己的概率分布。KL 是反向的,,学生在数学题上会自然靠向数学专家,在编程题上靠向编程专家。
作者明白写出这样做的理由:知识在 logit 层面对齐,实际上避开了传统权重合并或混合强化学习常见的表现退化。这个阶段用了十几个教师模型,蒸馏出一个学生。
细节上,常见的 OPD 实现会把整个词汇表的 KL 简化成每个位置只看采样到的那个 token,当作强化学习的优势值来用。这很省资源,但梯度方差大,训练不稳定。V4 坚持用完整词汇表的 logit 蒸馏,为此还得解决十几个教师同时提供完整 logit 的调度问题。
从 Model Soups 到 Command A,模型合并的论证一直是「便宜」:不用数据、不用训练,平均一下就好。V4 的选择说明,当你有数据、有算力,而且要整合的专家多达十几个、能力差异很大时,花一次蒸馏的成本换掉合并的损失,对 DeepSeek 来说是划算的。
推理时的上下文管理
一百万 token 的上下文也改变了推理内容的保留方式。V3.2 在工具调用之间保留思考内容,但只要用户一发新消息,之前的思考就全部丢掉。V4 在有工具调用的情境中,整段对话的思考内容全部保留,跨越用户消息也一样;一般聊天情境则维持原本的做法。工具调用的格式也改成 XML 风格,作者说能减少转义字符错误与工具调用失败。
讨论
成绩
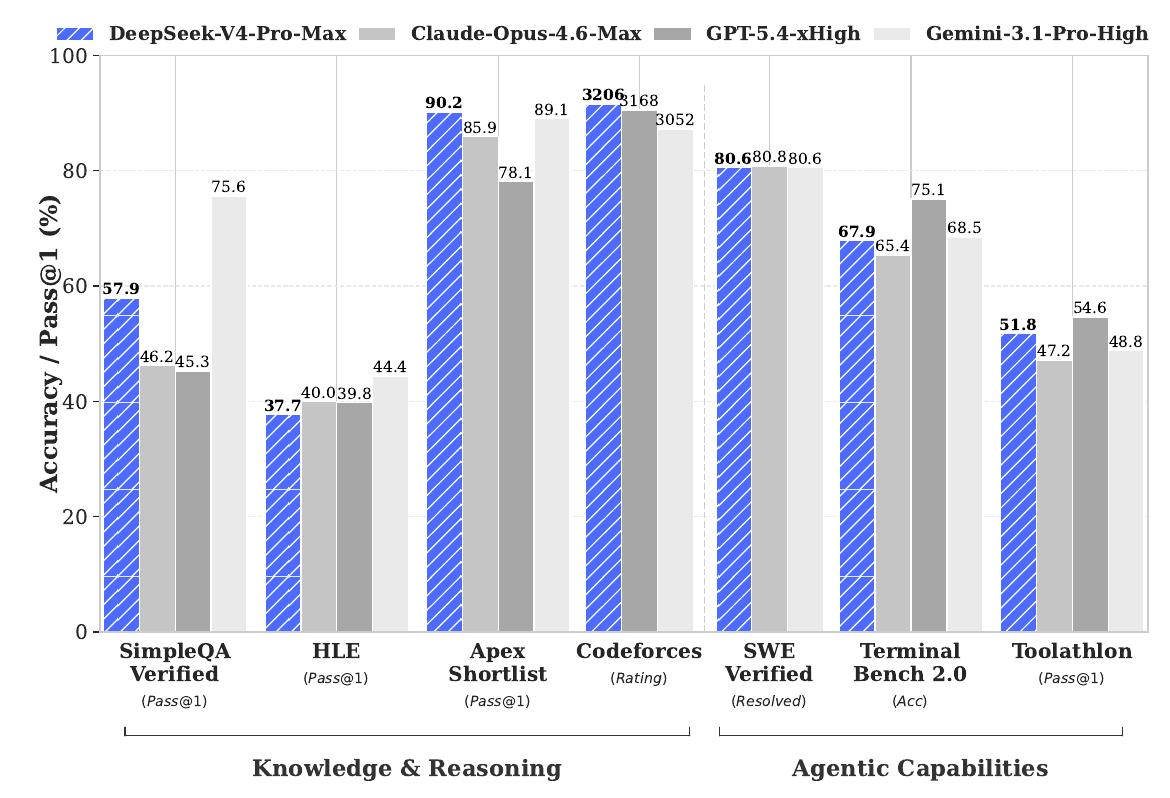
斜线柱是 V4-Pro-Max,其他三个是闭源模型最强的推理设置。
知识类上,V4-Pro-Max 在 SimpleQA Verified 拿到 57.9,高于 Claude-Opus-4.6-Max 的 46.2 与 GPT-5.4-xHigh 的 45.3,但明显低于 Gemini-3.1-Pro-High 的 75.6;HLE 是 37.7,略低于其他三者(40.0、39.8、44.4)。智能体任务上,SWE Verified 的 80.6 和其他模型几乎相同;Terminal Bench 2.0 是 67.9,落后 GPT-5.4-xHigh 的 75.1。
这和作者自己的总结一致:开源模型中的最佳成绩,推理接近最前沿的闭源模型,智能体任务与顶尖开源模型相当、略逊于最前沿的闭源模型。
V4-Flash-Max 的知识类表现因为参数较少而较差,但给它更多思考预算时,推理任务能和 V4-Pro 相当。
作者自己说的局限
结论中有一段很坦白。为了把长上下文效率推到极限,V4 的架构相当大胆;为了降低风险,又保留了许多先前验证过的组件和小技巧,结果整个架构变得相当复杂。作者说下一步要做更全面、更有原则的研究,把架构精简到最本质的设计。预期路由与 SwiGLU 截断有效,但原理还不清楚。
另外,报告名称标明是「预览版」,多数比较是在作者自己的评测框架下进行,部分智能体任务的比较来自内部评测。
结论
DeepSeek-V4 用两种压缩注意力把一百万 token 的上下文变得负担得起:CSA 压 4 倍再精挑一千多项,HCA 压 128 倍看全局轮廓。mHC 把残差流加宽、用双随机矩阵锁住稳定性,Muon 加快收敛。结果是 V4-Pro 在一百万 token 时,每个 token 的计算量只有上一代的四分之一左右,KV 缓存只有十分之一。
对模型合并这条线来说,这份报告提供了一个有意思的反例。同样是把一群专家整合成一个模型,Command A 选择平均权重,DeepSeek 选择让学生自己写、让老师们逐 token 指导。
合并的好处是便宜,蒸馏的好处是准。DeepSeek 的算力,显然买得起后者。