原始论文
Averaging Weights Leads to Wider Optima and Better Generalization
- 发表版本
- UAI 2018会议
- arXiv 首次提交
- arXiv:1803.05407
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingswa2018,
  title = {{Averaging Weights Leads to Wider Optima and Better Generalization}},
  author = {Pavel Izmailov and Dmitrii Podoprikhin and Timur Garipov and Dmitry Vetrov and Andrew Gordon Wilson},
  year = {2018},
  eprint = {1803.05407},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1803.05407}
}
2018 年 2 月底,Garipov、Izmailov 等人发表了模式连通(mode connectivity)的论文,顺手提出一种集成方法 FGE。训练快结束时,把学习率换成周期很短的循环,每次学习率降到谷底就存一份权重,最后把存下来的几个模型一起推理、输出取平均。
FGE 只花训练一个模型的时间,就得到一组不错的集成。可是推理时,每个模型都得跑一次。
两周后,同一组作者放上这篇论文。他们看着 FGE 存下来的那些点在参数空间里的位置,发现它们散在一片好区域的边缘,中间是空的。
那就不要集成了,直接把权重平均,站到中间去。
定义问题
把权重沿着 SGD 的轨迹平均,这个想法不新。凸优化里,Ruppert 1988 年、Polyak 与 Juditsky 1992 年就分析过,平均迭代点可以加快收敛。训练神经网络时,实务上也有人维持一个指数移动平均(EMA),搭配逐渐衰减的学习率;作者测过,这样的 EMA 和一般 SGD 收敛后的表现差不多。
问题出在学习率。学习率一路衰减,SGD 的轨迹收敛到一点,这时候取平均,只是把轨迹抹平一些,结果和不平均差不多。
作者想要的,是让 SGD 在一片好区域里多走一点,再取平均。他们也想知道,平均出来的那一点,泛化为什么会比较好。
解决问题
算法
SWA 的流程很短:
- 先用一般的学习率调度训练,论文里大约是总预算的 75%。
- 接着改用固定的学习率,或周期性在 到 之间线性递减的循环学习率,继续训练。
- 每隔固定的 次迭代,把当下的权重 加进平均;用循环学习率时, 就是一个周期,刚好在学习率最低的时候取点:
- 训练结束,用 当作最终模型。
第 3 步是累加式的算术平均。 记录已经收进来的点数;从 0 开始,第一个点直接成为平均,第二个点加入时才各占一半。第三个点加入时,旧平均乘上 、新点乘上 ,最后三个点各占 。不需要把每一份权重都存下来,也和越新的点权重越大的 EMA 不同。
循环学习率的细节值得分清楚。SWA 在一个周期内只做线性下降,走到底就直接跳回上界:
FGE 的三角形周期还会慢慢升回去;SWA 把这半段省掉了,因为我们只要最后的平均好用,途中每一个快照的准确率可以差一点。固定学习率走得更远、单点表现可能更差,也能有好的平均结果。
论文的 CIFAR 设置里,VGG 和 WRN 在 SWA 阶段用固定学习率 0.01;Preactivation ResNet 在 CIFAR-10 用 0.01、CIFAR-100 用 0.05,每个 epoch 收一次。PyramidNet 则用 3 个 epoch 一个循环,从 0.05 降到 0.001。这些是搭配各自架构得到的设置,实现时仍要用自己的验证数据选起始时间与学习率。
BatchNorm 要重算
有一件事很容易漏掉。如果网络有 BatchNorm,训练时累积的均值与方差,是对应各个 的,不是对应 的。作者的做法是训练结束后,用 在训练数据上多跑一次前向传播,重新收集这些统计量。
PyTorch 后来把累加平均与重算统计量放进 torch.optim.swa_utils。我们用只有线性层和 BatchNorm 的小网络看一次这个差别。两个快照的线性权重分别是单位矩阵的 1 倍与 3 倍:
import torch
from torch import nn
from torch.utils.data import DataLoader
from torch.optim.swa_utils import AveragedModel, update_bn

model = nn.Sequential(nn.Linear(2, 2, bias=False), nn.BatchNorm1d(2))
swa_model = AveragedModel(model)
with torch.no_grad():
    for scale in [1.0, 3.0]:
        model[0].weight.copy_(scale * torch.eye(2))
        swa_model.update_parameters(model)

print("平均權重:", swa_model.module[0].weight.tolist())
print("重算前的均值:", swa_model.module[1].running_mean.tolist())
loader = DataLoader(torch.tensor([[1., 2.], [3., 4.]]), batch_size=2)
update_bn(loader, swa_model)
print("重算後的均值:", swa_model.module[1].running_mean.tolist())
平均權重: [[2.0, 0.0], [0.0, 2.0]]
重算前的均值: [0.0, 0.0]
重算後的均值: [4.0, 6.0]
平均模型的线性层是 ,两笔输入到 BatchNorm 前会变成 和 ,所以均值应该是 。只平均可学习参数,running mean 还停在原先的 ;update_bn 才把它对上新权重。这个例子只示范统计量的更新,没有训练分类器。
实际训练时,进入 SWA 阶段后照常用梯度更新原模型的权重,再按采样频率调用 update_parameters;全部平均完成后才跑一次 update_bn,最后切到 eval() 评测。用来重算的是训练数据,不需要标签,也不用反向传播。
为什么平均权重像集成
FGE 平均的是输出,SWA 平均的是权重。两者什么时候差不多?作者用一阶展开回答。
令 FGE 存下的点是 ,平均是 ,各点与平均的差是 ,所以 。把网络输出 在 附近展开:
对 取平均,一次项加起来刚好是 ,只剩下二次项:
只要这些点彼此靠得够近,集成的输出和平均权重的输出就只差一个二次小量。FGE 的点正是刻意用很小的步子找出来的,SWA 因此能用一个模型逼近 FGE 的集成。
这段推导还有一个前提, 在附近要足够平滑,二阶余项也要小。若把相隔很远、甚至来自不同随机初始化的模型放进来, 很大,展开式就无法支持「平均权重接近平均输出」的判断。SWA 收的是同一条训练轨迹后段的点。
作者在 CIFAR-100 的 ResNet-164 上跑了 20 个 epoch 的 FGE。相邻快照的类别概率向量,平均差异范数是 0.126;SWA 与 FGE 集成之间是 0.079。相邻快照的类别预测一致率不超过 87.33%,SWA 与集成却有 95.26%。这些量测让一阶项相消的推导有了实际对照,两者输出接近,但仍然留有差距。
讨论
站在边缘的 SGD
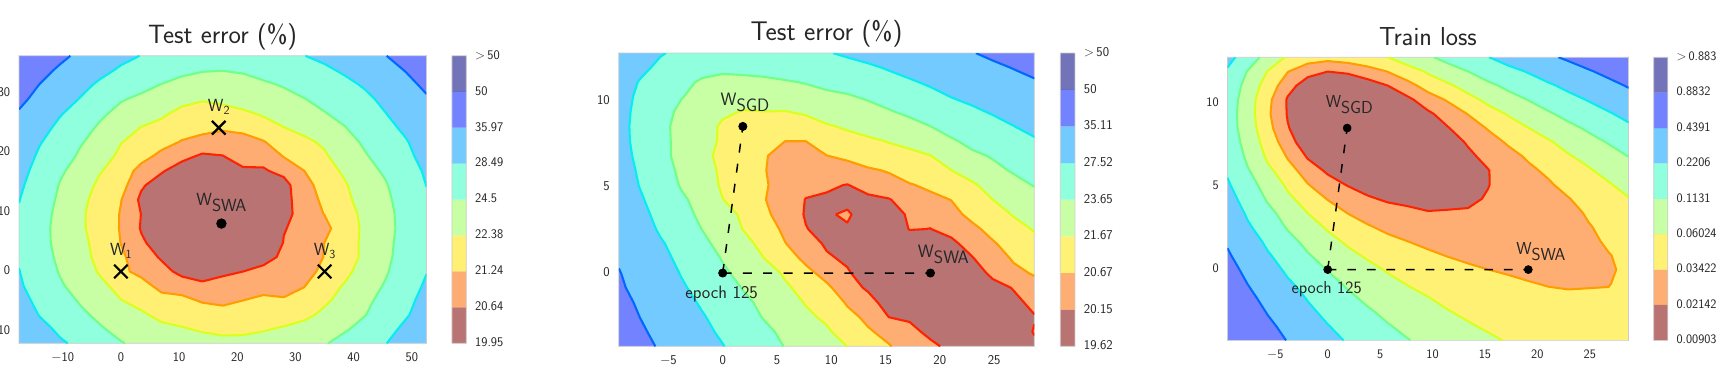
这张图是 CIFAR-100 上的 Preactivation ResNet-164。左图可以直接看到 SWA 的动机,三个 FGE 采样点围在红色区域的外圈,平均出来的 落在中间。
中图和右图要一起看。两者从同一个第 125 个 epoch 的权重出发,分别跑完 SGD 和 SWA。右图的训练损失上, 已经在低损失区里,位置却偏在边缘;中图的测试错误率上, 比 更接近错误率最低的地方。
训练损失和测试错误率的地形并没有完全重叠,中间错开了一段。站在低损失区的边缘,地形稍微一偏,测试错误率就上去了;站在中间,余裕比较多。
作者用两个实验支持这个说法。第一个从两个解各沿 10 个随机方向往外走。下图横轴是移动距离,左边量测试错误率,右边量训练损失,蓝色是 SWA、绿色是 SGD,每条线对应一个方向。
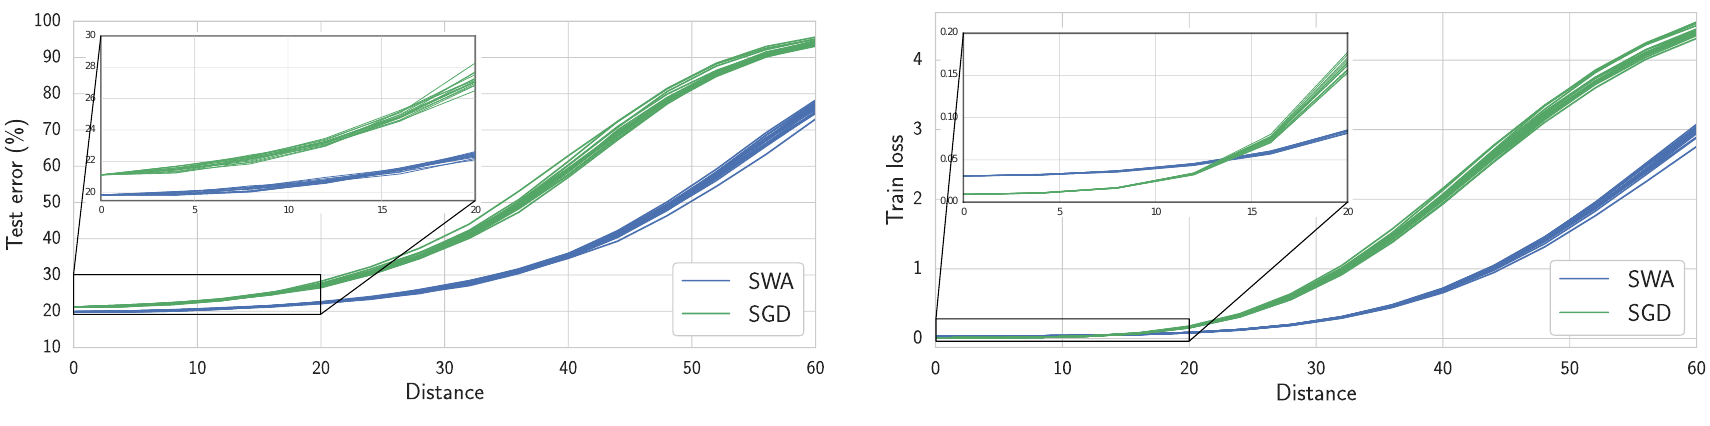
从距离 0 的位置看,两者的训练损失差不多,SGD 甚至略低;但 SWA 的曲线宽得多,要走得更远,错误率才会上升同样的幅度。这个切面检查的是离开各自解之后的敏感度。
第二个是直接看 到 这条线。线上的训练损失和测试错误率明显错开, 落在一片平坦区域的边界,旁边就是陡坡。作者的结论是,SWA 和 SGD 在同一个盆地里,SWA 找到的是盆地里更平坦的位置;它的训练损失往往略高一点,严格说不是损失的局部最小值。
CIFAR 与 ImageNet
CIFAR 的实验先用一般调度跑完约 75% 的预算,再改用 SWA 跑完剩下的部分。CIFAR-100 上的 Preactivation ResNet-164,一般 SGD 是 78.49%;同样的总预算改用 SWA,是 79.77%,和 FGE 集成的 79.84% 几乎一样,推理只要一个模型。把预算加到 1.5 倍,SWA 到 80.35%。VGG-16 从 72.55% 到 73.91%,WRN-28-10 从 80.82% 到 81.46%。SWA Table 1
ImageNet 上,作者直接拿 torchvision 的预训练模型,用循环学习率再跑 5 或 10 个 epoch:
| 模型 | SGD | SWA 5 epochs | SWA 10 epochs |
|---|---|---|---|
| ResNet-50 | 76.15 | 76.83 ± 0.01 | 76.97 ± 0.05 |
| ResNet-152 | 78.31 | 78.82 ± 0.01 | 78.94 ± 0.07 |
| DenseNet-161 | 77.65 | 78.26 ± 0.09 | 78.44 ± 0.06 |
Top-1 准确率(%),整理自原论文 Table 2。
三个架构都进步了 0.6 到 0.9 个百分点,花的只是原本训练的一小部分。
预算与平坦度,要各自读
前面的「同样预算」适用于 VGG、ResNet 和 WRN。PyramidNet 与 Shake-Shake 的实验则先跑完一整份标准预算,再加 0.25 或 0.5 份预算做 SWA,所以论文没有列它们的 成绩。CIFAR-100 的 PyramidNet-272 从 SGD 的 83.41% 到 的 84.16%;CIFAR-10 的 Shake-Shake 从 96.93% 到 的 97.16%,加到 是 97.12%。多平均、更久训练也有边际效益。
额外成本包括训练时保存一份平均权重、每次收样做一次逐参数加权,以及结束后重估 BatchNorm 的前向传播。部署时只保留平均模型,参数量与单次推理量才回到原模型的水准。对激活值很大的图像训练,作者量到的内存增加不多;若权重本身占了大部分内存,额外一份权重就要另外评估。
再回头看平坦度。论文量的是指定参数表示下的 10 个随机方向,以及 SGD 到 SWA 的特定方向;尤其后者能看到 SGD 附近一侧很陡、另一侧较平。神经网络可以靠重新缩放参数改变地形的视觉宽度,因此作者也讨论了单靠「平」来解释泛化的争议。这组证据支持这些架构与训练设置中的几何解释,使用时仍得直接量测验证准确率。
结论
SWA 的做法很短,训练后段让学习率维持在较高的水准,把走过的权重平均,再重算一次 BatchNorm。它的道理也不复杂,SGD 停在好区域的边缘,平均把模型带回中间。
自己用的时候,最容易漏掉的是最后那一步。网络里有 BatchNorm 的话,平均完记得跑一次 update_bn,让统计量对上平均后的权重。
这个平均后来走得很远。2024 年 Llama 3 的技术报告写到后训练的模型平均时,引用的第一篇就是这篇。