原始论文
Essentially No Barriers in Neural Network Energy Landscape
- 发表版本
- ICML 2018会议
- arXiv 首次提交
- arXiv:1803.00885
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingnobarriers2018,
  title = {{Essentially No Barriers in Neural Network Energy Landscape}},
  author = {Felix Draxler and Kambis Veschgini and Manfred Salmhofer and Fred A. Hamprecht},
  year = {2018},
  eprint = {1803.00885},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1803.00885}
}
谈神经网络的损失地形,最常见的画面是一座座山谷。
训练就是从某个地方滚下山,最后停在某个谷底。谷底有宽有窄,宽的谷底据说泛化比较好;不同的随机种子会滚进不同的谷底,彼此之间隔着山脊。把两个谷底的权重连一条直线,沿途的损失会先升后降,这也是很多人实际测过的结果。
海德堡大学的 Draxler、Veschgini、Salmhofer 与 Hamprecht 对这个画面有不同的看法。作者团队横跨图像处理实验室与理论物理研究所,他们从分子统计力学借来一个找反应路径的工具,想看看两个谷底之间能不能绕出一条不必翻山的路。
答案出乎意料。在 CIFAR 上的 ResNet 和 DenseNet,他们找到的路几乎是平的。
几乎在同一时间,Garipov 等人的模式连通也独立得到相同的观察。两篇找路径的方法完全不同。
定义问题
固定架构与训练数据,损失只是参数 的函数 。拿两组各自训练到收敛的参数 、,我们想找一条从 走到 的连续路径,让沿途最高的损失尽可能低:
这条路径叫做最小能量路径(minimum energy path, MEP),路径上的最高点就是两个极小值之间真正的鞍点。
作者把「损失」和「能量」当同义词用,这是物理学的习惯。损失地形上的谷底是稳定的状态,鞍点则是两个状态之间必须翻过的障碍。
二维时可以把网格画出来,用动态规划找 MEP;但网络参数动辄上百万维,只能从一条初始路径出发,用局部信息一点一点把它弯到低处。找到的路径未必是精确的 MEP,它的最高点只能当作鞍点能量的上界。
所以这篇的逻辑是这样的。只要我们能找到一条最高点很低的路,就证明了两个极小值之间的障碍不会比这个值更高。
解决问题
弹簧串起来的枢纽点
先把路径离散化。 个枢纽点(pivot) 串成一条链,头尾固定在两个极小值:、。
最直观的做法,是把枢纽点之间用弹簧连起来,最小化
第一项把每个点往低处拉,第二项让点与点之间保持距离。
问题在弹簧系数 。 太小,枢纽点会滑向低处,损失高的区域反而变得稀疏,偏偏我们最想量清楚的就是最高点。 太大,弹簧能量随路径总长的平方增长,整条链被拉直,切过角落,错过真正的鞍点。
Nudged Elastic Band
NEB(Nudged Elastic Band)用一个简单的修改解决这个两难。它把两种力拆开,只留下各自有用的方向:
设 是枢纽点 的局部切线方向,
损失力只保留垂直于路径的分量,负责把路径往低处推;弹簧力只保留平行于路径的分量,负责把点排均匀。这样一来,高处的点不会顺着路径滑下去,弹簧也不会把路径拉直。
切线方向的取法也有讲究。 指向两个邻居中损失比较高的那一个,这个选择能避免路径出现折角,在鞍点附近的近似也比较好。
作者在实现上又往前一步。他们找不到一个在不同损失地形、不同枢纽点数量下都好用的 ,干脆把弹簧力设成零,改成每一轮先把枢纽点沿路径重新等距排好,再施加垂直方向的损失力。这种变体在文献里又叫 string method。
用一个二维小例子走一遍
神经网络的参数太多,没办法画。我们换一个二维的地形来看 NEB 在做什么:
第一项让单位圆上的损失为零,第二项给圆周加一点倾斜,使 和 成为两个极小值。两点之间的直线经过原点,那里的损失是 1;沿着圆周绕过去,最高点只有大约 0.1。
import numpy as np

def loss(p):
    x, y = p[..., 0], p[..., 1]
    return (x**2 + y**2 - 1) ** 2 + 0.1 * y**2

def grad(p):
    x, y = p[..., 0], p[..., 1]
    r = x**2 + y**2 - 1
    return np.stack([4 * r * x, 4 * r * y + 0.2 * y], axis=-1)

def redistribute(path):
    seg = np.linalg.norm(np.diff(path, axis=0), axis=1)
    s = np.concatenate([[0], np.cumsum(seg)])
    t = np.linspace(0, s[-1], len(path))
    return np.stack([np.interp(t, s, path[:, d]) for d in range(2)], axis=1)

a, b = np.array([-1.0, 0.0]), np.array([1.0, 0.0])
path = np.linspace(a, b, 12)               # 起点:直线上的 12 个枢纽点
path[1:-1, 1] += 0.05                      # 轻推一下,避免停在完全对称的鞍点上
line_max = loss(np.linspace(a, b, 201)).max()

for step in range(2000):
    path = redistribute(path)              # 作者的做法:去掉弹簧,每轮重新等距排好
    for i in range(1, len(path) - 1):
        lo, hi = path[i - 1], path[i + 1]
        tau = (hi - path[i]) if loss(hi) > loss(lo) else (path[i] - lo)
        tau /= np.linalg.norm(tau)
        g = grad(path[i])
        f_perp = -(g - (g @ tau) * tau)    # 只保留垂直于路径的损失力
        path[i] = path[i] + 0.05 * f_perp

fine = np.concatenate([np.linspace(p, q, 20, endpoint=False) for p, q in zip(path[:-1], path[1:])] + [path[-1:]])
print(f"直线上的最高损失:{line_max:.3f}")
print(f"NEB 路径的最高损失:{loss(fine).max():.3f}")
x, y = fine[loss(fine).argmax()] + 0.0
print(f"最高点位置:({x:.2f}, {y:.2f})")
直线上的最高损失:1.000
NEB 路径的最高损失:0.098
最高点位置:(-0.00, 0.96)
直线上的障碍是 1.0;NEB 把中间的枢纽点往上推到圆周附近,障碍降到 0.098。这个值就是这个地形的鞍点能量。沿 求 的最小值,可以算出鞍点在 、。
切线那一行就是刚才说的规则:指向损失较高的邻居。如果把 f_perp 换成完整的 -g,中间的点会顺着圆周往两端滑,最后全挤到两个谷底附近,路径最高处反而没有点在测量。
AutoNEB 与最小生成树
在百万维空间里,一开始不知道要多少个枢纽点。AutoNEB 先用少量枢纽点跑几轮 NEB,再检查路径:如果两个相邻枢纽点之间的损失,比两端线性插值的估计高出「整条路径能量差」的 20% 以上,就在那里插入新的枢纽点。每对相邻枢纽点之间另外评估 9 个点,用来发现这种漏掉的高峰。
AutoNEB 仍可能卡在局部的最小能量路径上,得到一个偏高的鞍点。作者用一个不等式处理这个问题。已知 A 到 B、B 到 C 的路径,把两段接起来就是 A 到 C 的一条路,所以
这是一个超度量(ultrametric)性质。有了它,只要所有极小值通过已知路径连成一张图,每一对极小值之间的障碍就都有上界;某条路径太高,也可以靠其他路径绕过去替换掉。
作者因此把问题变成找最小生成树。先把第一个极小值连到其他所有极小值,再反复挑出树上最高的那条边,尝试用 AutoNEB 在两侧子树之间找一条更低的路。找到就换,找不到就放回去,直到每一对都算过或计算预算用完。每一条 AutoNEB 路径的成本,大约相当于把网络完整训练一次。
讨论
实验设置
每种架构训练 10 个极小值,全部来自不同的随机初始化。作者确认它们真的不一样:ResNet 和 DenseNet 的任两个极小值之间,测试集上被分错的样本最多只有 70% 重叠。
架构涵盖三类:
- 无跳跃连接的基本 CNN:宽度 12 到 96 个通道的单层 CNN,以及 48 通道的二层、三层 CNN。
- ResNet:ResNet-8、20、32、44、56,按原论文流程训练 136 个 epoch。
- DenseNet:DenseNet-40-12 与 DenseNet-100-12-BC,训练 266 个 epoch。
数据集是 CIFAR-10 与 CIFAR-100。AutoNEB 每对极小值跑 14 个 NEB 循环,用带动量的 SGD,学习率从 0.1 分段降到 0.001。
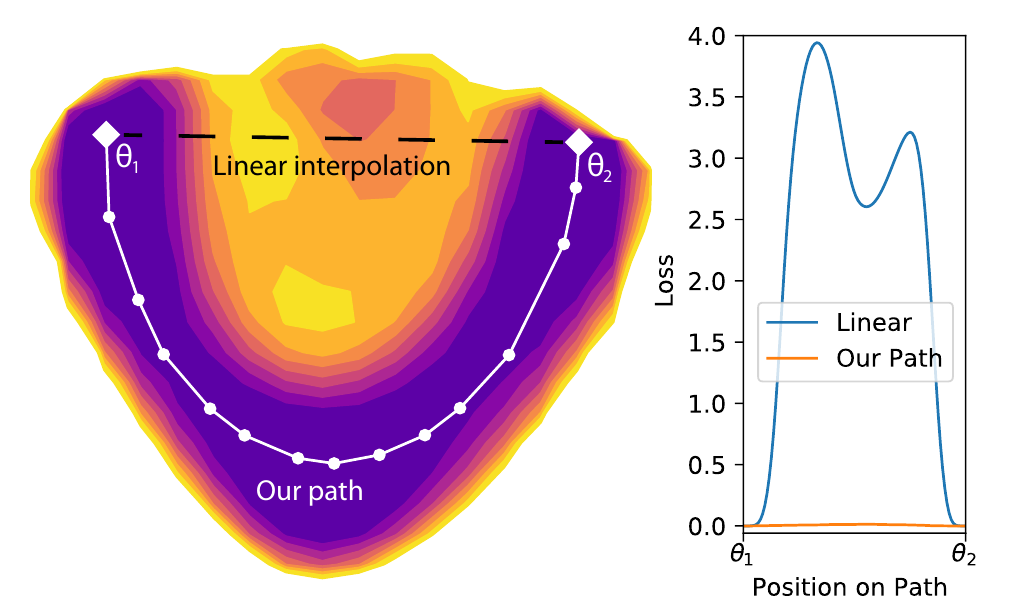
这张图是一个百万维损失函数的二维切面。直线在中间撞上一大片高损失区,最高接近 4;AutoNEB 找到的路径从旁边绕过去,整段损失几乎没有起伏。
鞍点有多低
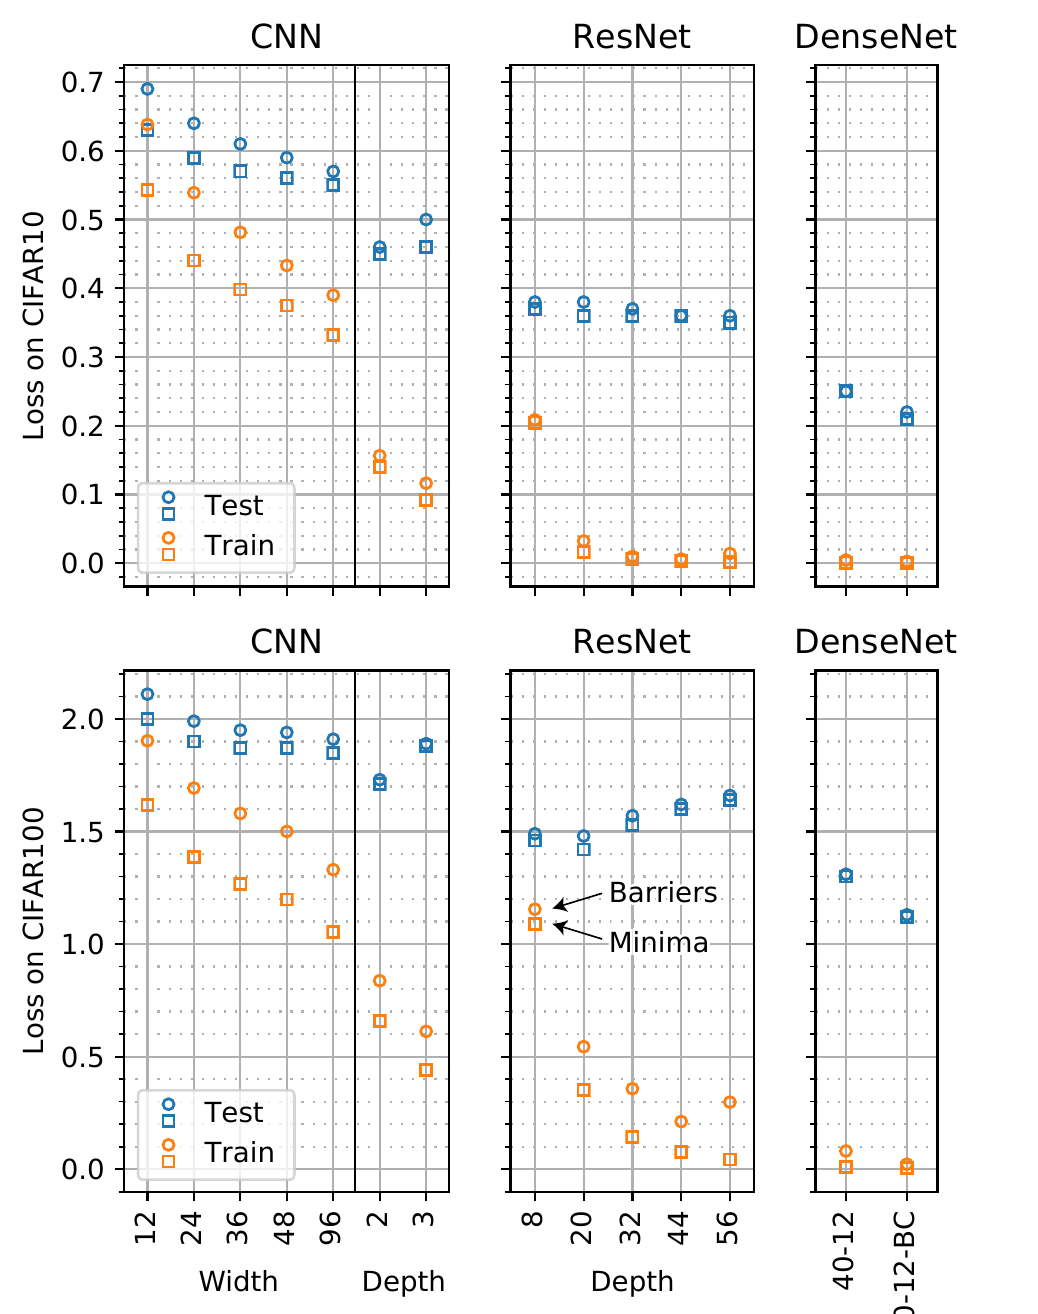
这张是全篇的核心结果。看法是比较同一颜色的方块和圆点:方块是极小值的平均损失,圆点是路径上鞍点的平均损失,两者越接近,障碍越低。
左边的基本 CNN 可以看到趋势。宽度从 12 增加到 96,训练集鞍点逐渐往极小值靠;加深到两层、三层,差距缩得更快。到了 ResNet 和 DenseNet,CIFAR-10 上的训练鞍点几乎贴着极小值。
附录 Table B.1 给了数字。以 CIFAR-10 的 ResNet-56 为例,极小值的平均训练损失是 0.0022,鞍点是 0.0141;DenseNet-100-12-BC 分别是 0.0005 和 0.0026。比例看起来差了好几倍,但对照基准很重要。未训练网络在 CIFAR-10 上的损失是 ,深层残差网络的鞍点比这个值小了大约两个数量级,也比同一个模型在测试集上的损失小一个数量级左右。
CIFAR-100 比较难,障碍也比较高。ResNet-56 的训练损失从 0.0428 升到 0.2978,DenseNet-100-12-BC 从 0.0050 升到 0.0223;和随机初始化网络约 4.6 的损失相比,差距仍然很小。
分类错误率的变化也不大。附录列出,沿路径最高的错误率,ResNet 比极小值多最多 0.7(CIFAR-10)与 2.9 个百分点(CIFAR-100),DenseNet 则是 0.4 与 1.5 个百分点。
另一种衡量方式是看训练曲线,损失要到哪个时候才降到鞍点以下。答案是很晚,所有架构都要等到第一次学习率衰减之后;多数 ResNet 和 DenseNet 甚至要到第二次衰减之后,也就是训练的最后阶段。换句话说,这些鞍点和「训练到快结束时的模型」差不多好。
路径长什么样子
路径本身也很规整。沿着路径看各个参数相对于直线插值的偏离,每个坐标都走得很平滑,最大的偏离集中在鞍点附近。整条路径比两点间的直线长 50% 到 2.5 倍。
作者在结论提出,这些路径也许可以当成一个庞大的模型集成来用,因为路径上的测试损失甚至略低一点。这个方向后来由 Garipov 等人的 FGE 做得更完整。
为什么会这么平
论文没有证明,作者给了两个定性的解释。
第一个是韧性。现代网络每层有几十到几百个通道,还有跳跃连接。对一个参数做小扰动,其他大量参数可以一起调整来弥补,所以模型能一步一步改变结构,损失却不明显上升。Dropout 与集成正是利用并强化这种韧性;网络能大幅压缩而损失不明显上升,也是同样的原因。
第二个是冗余,作者用 XOR 举例。
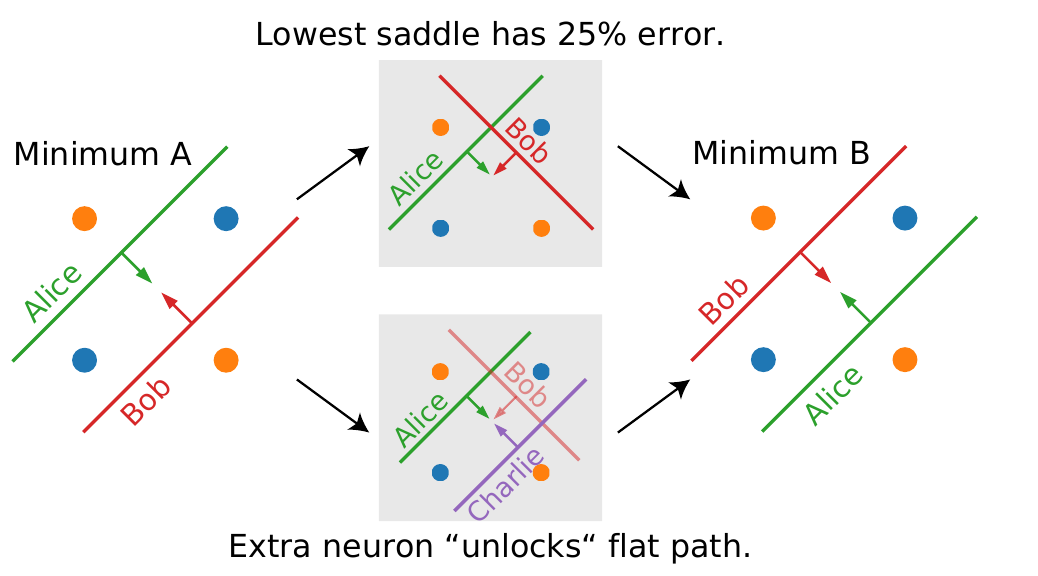
教科书上解 XOR 的两层感知机,隐藏层有两个神经元,作者叫它们 Alice 和 Bob。把两人互换位置(下一层权重跟着交换),得到另一个等价的极小值。只有两个神经元时,从 A 走到 B 的任何连续路径,中途至少会分错一个点,最低的鞍点有 25% 的错误率。
多加一个神经元 Charlie,就能安排一段接力。Charlie 先顶替 Bob,Bob 慢慢移到 Alice 的位置,Alice 再接手 Charlie 的工作,最后 Charlie 退场。只要下一层暂时忽略正在移动的那个神经元,全程都不会分错。
这个例子把神经元互换(排列对称)和额外容量连在一起。后来 Entezari 等人与 Git Re-Basin 一路追问的,正是排列对称在障碍中扮演什么角色。
限制
AutoNEB 找到的只是上界,作者也承认目前无法刻画这个现象在什么条件下成立。实验只有 CIFAR-10/100 上的图像分类,模型最大到 DenseNet-100;每条路径的成本接近完整训练一次,所以每种架构只取 10 个极小值。
另一个容易混淆的地方是「连通」的形式。这篇证明的是存在一条弯曲的低损失路径,直线插值仍然会撞上高峰。权重平均需要的是直线上没有障碍,这是更严格的条件;后来的线性模式连通、排列对齐研究,处理的就是这一段距离。
结论
这篇论文把一个化学里找反应路径的工具带进深度学习,对 ResNet 和 DenseNet 得到一个干净的观察。两个独立训练的极小值之间,存在一条几乎不用爬坡的路;网络越宽、越深,这条路越平。
谷底的画面因此要改一改,低损失区域更像是一整片相连的低地,各个极小值只是低地上的不同位置。
PyTorch 实现放在 fdraxler/PyTorch-AutoNEB。真要拿来跑大模型之前,先想清楚预算,每连一对极小值,大概就是再训练一次网络的时间。