原始论文
Communication-Efficient Learning of Deep Networks from Decentralized Data
- 发表版本
- AISTATS 2017会议
- arXiv 首次提交
- arXiv:1602.05629
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingfedavg2016,
  title = {{Communication-Efficient Learning of Deep Networks from Decentralized Data}},
  author = {H. Brendan McMahan and Eider Moore and Daniel Ramage and Seth Hampson and Blaise Agüera y Arcas},
  year = {2016},
  eprint = {1602.05629},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1602.05629}
}
手机键盘的下一个词预测,最好的训练数据就是用户每天打的字。
问题是这些字包括消息、网址,甚至密码。把它们全部上传到数据中心再训练,隐私风险很大;而且聊天用语和维基百科差很多,拿公开语料代替,又学不到用户实际的打字习惯。
2016 年,Google 的 McMahan、Moore、Ramage 等人提出一个做法,让数据留在手机上,每台手机只把「模型该怎么改」送回服务器。他们把这种训练方式叫做联邦学习(Federated Learning),并给了一个很朴素的算法 FederatedAveraging,后来大家简称 FedAvg。
这篇论文放在模型合并的脉络里也很重要。FedAvg 每一轮都在做同一件事,把许多份各自训练过的权重直接平均。论文里有一张小图,说明为什么这件事在神经网络上可行,后来的模型合并研究一再回到这个条件。
定义问题
假设有 个客户端(client,例如手机),第 个客户端持有 条数据,总共 条。我们想最小化全体数据上的平均损失:
是客户端 自己数据上的平均损失。如果数据是随机打散分配的,每个 的期望值就等于 ,这是一般分布式训练默认的 IID 情况。
作者指出联邦学习有四个和数据中心不一样的地方:
- Non-IID:每台手机的数据来自一位用户,分布和全体差很多。
- 不平衡:有人每天打几千字,有人一个月才用一次。
- 大量分散:参与的客户端数量,可能比每个客户端平均的数据条数还多。
- 通信受限:手机常离线、上传带宽通常不到 1 MB/s,而且只有在充电、连上不按流量计费的 Wi-Fi 时才愿意参与,一天大概只能参与几轮。
最后一点决定了整篇论文的衡量方式。手机上的计算相对便宜,贵的是通信轮数。所以这篇比较方法时,看的是要几轮通信才能达到目标准确率。
目标很清楚,多花一点本地计算,换更少的通信轮数。但这里有一个大问题。神经网络的损失是非凸的,把两组各自训练出来的权重直接平均,理论上可能得到一个很烂的模型。为什么可以平均?
解决问题
从 FedSGD 开始
作者先定义一个基准。每一轮随机挑选比例 的客户端,每个被选到的客户端算出自己全部数据上的梯度 ,服务器把梯度按数据量加权平均后更新:
这就是大批量的同步 SGD,论文称为 FederatedSGD(FedSGD)。 控制每轮的全局批量大小, 就是全批量梯度下降。
接着作者把同一个更新换个写法。每个客户端先用自己的梯度走一步,再由服务器平均权重:
两种写法在数学上等价,因为每个客户端都从同一个 出发,平均权重等于平均梯度。
写成第二种形式之后,下一步就很自然了。既然客户端已经在本地走一步,为什么不多走几步再回报?
FedAvg
FedAvg 让每个客户端在本地跑好几轮 SGD,再把权重送回服务器平均。计算量由三个参数控制:
- :每轮参与的客户端比例。
- :每个客户端在本地数据上跑几个 epoch。
- :本地的 minibatch 大小; 表示整份本地数据当作一个 batch。
一个有 条数据的客户端,每轮做 次本地更新。、 时,FedAvg 就退回 FedSGD。
服务器端的流程写成代码,大概是这样:
def fedavg_round(w, clients, C, E, B, lr):
    m = max(int(C * len(clients)), 1)
    selected = random.sample(clients, m)
    total = sum(c.num_examples for c in selected)

    new_w = zeros_like(w)
    for c in selected:
        w_k = client_update(c, w, E, B, lr)          # 从同一个 w 出发,本地跑 E 个 epoch
        new_w += (c.num_examples / total) * w_k      # 按本轮参与者的数据量加权
    return new_w
加权平均的分母是本轮被选中的客户端数据总量 。假设这一轮选到三台手机,各有 600、300、100 条数据,权重就是 0.6、0.3、0.1;数据多的客户端,对新模型的影响也比较大。
为什么可以平均
回到刚才的疑问。作者用一个小实验回答。
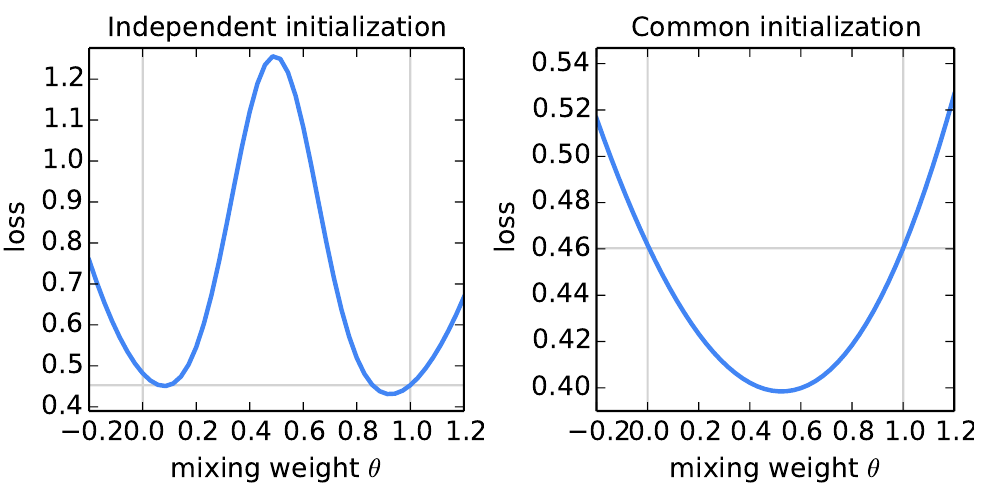
实验设置很小。两个多层感知机 和 ,各自在 MNIST 中不重叠的 600 条数据上,用学习率 0.1、批量 50 训练 240 步(相当于 20 个 epoch),大约训练到开始过拟合本地数据的程度。接着计算 在完整训练集上的损失, 从 −0.2 扫到 1.2。
先看左图。两个模型用不同的随机种子初始化,两端的损失都在 0.45 附近,但中间的平均模型冲到 1.2 以上,比任何一方都糟。
再看右图。两个模型从同一个随机初始化出发,曲线变成一个碗。 的损失大约 0.40,明显低于两个父模型各自约 0.46 的损失。注意两张图的纵轴刻度不一样,右图整条曲线都很低。
FedAvg 每一轮的所有客户端都从同一个 出发,正好落在右图的情况。作者没有证明这件事对所有网络都成立,只引用当时对过参数化网络损失地形的观察,再用这张图说明直觉。
「共同起点的权重可以直接平均」,后来在 SWA、Model Soups、任务算术等模型合并工作里反复出现,条件也一样是共享起点。
讨论
实验设置
作者在五种模型、四个数据集上训练了两千多个模型:
- MNIST 2NN:两层各 200 单元的多层感知机,199,210 个参数。
- MNIST CNN:两层 5×5 卷积加一层 512 单元全连接,1,663,370 个参数。
- Shakespeare LSTM:字符级两层 LSTM,866,578 个参数。
- CIFAR-10:TensorFlow 教程里的小型 CNN,约 个参数。
- 大型下一词预测 LSTM:10,000 词的词表,4,950,544 个参数。
数据切分方式是这篇的重点。MNIST 的 IID 版本打散后分给 100 个客户端,每个 600 条。Non-IID 版本则先按数字标签排序,切成 200 份、每份 300 条,每个客户端拿两份;多数客户端只看过两种数字,这是作者故意设计的极端情况。
Shakespeare 比较接近真实状况。作者把莎士比亚全集里每个剧本的每个角色当成一个客户端,共 1,146 个,台词多的角色和只有几句的角色差很多,天然就是不平衡又非 IID。
每个设置都在一组学习率网格上扫过,取最佳学习率,再计算学习曲线穿过目标准确率时的轮数。
并行度:要找多少人来
第一组实验先固定 ,调整每轮参与比例 。以 2NN、 为例,IID 数据上,从每轮 1 个客户端到 (10 个客户端),达到 97% 准确率的轮数从 316 降到 87;非 IID 数据上从 3,275 降到 664。
时,增加 的效果小得多。作者最后选 作为后续实验的默认值,认为这是计算效率和收敛速度的平衡点。
本地多算几步
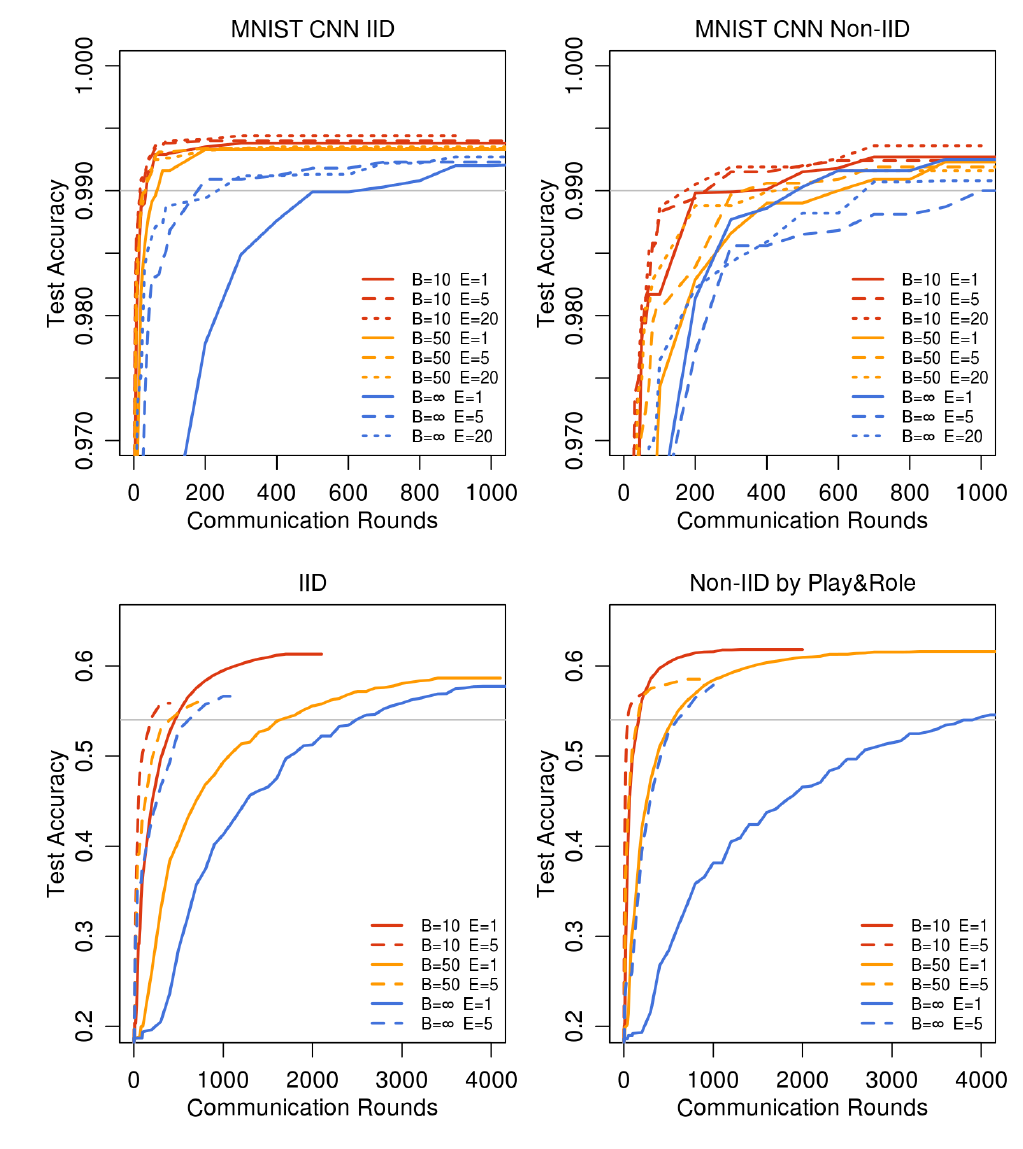
这张图要看蓝色实线和红色线的距离。蓝色实线是 、,也就是 FedSGD;红色线是 ,每轮本地更新次数最多。四张图里,红线都比蓝色实线早很多穿过灰色目标线。
换算成达到目标准确率所需的通信轮数,四种设置下 FedAvg 都快上好几倍。
- MNIST CNN,IID:FedSGD 要 626 轮达到 99%,、 只要 18 轮,快 34.8 倍。
- MNIST CNN,病态非 IID:FedSGD 483 轮,最佳设置 173 轮,快 2.8 倍。
- Shakespeare,IID:FedSGD 2,488 轮达到 54%,、 要 192 轮,快 13.0 倍。
- Shakespeare,按角色切分:FedSGD 3,906 轮,同一设置只要 41 轮,快 95.3 倍。
第二项值得停下来看。每个客户端只有两种数字,各自训练出来的模型差很多,平均起来仍然比 FedSGD 快。作者自己也说,平均能带来任何好处而不是直接发散,已经很令人意外。不过加速只有 2.8 倍左右,表中还有一些设置比 FedSGD 更慢,例如 、 在非 IID 上要 1,000 轮。
第四项则是反过来的惊喜。按角色切分的数据反而比 IID 版本加速更多。作者推测是因为部分角色的台词很多,本地多训练几步特别有价值;这是推测,论文没有进一步验证。
除了轮数,FedAvg 最后的准确率也比较高。MNIST CNN 的 FedSGD 在 1,200 轮后达到 99.22%,跑到 6,000 轮也没有再进步;、 的 FedAvg 在 300 轮就到 99.44%。作者推测模型平均带有类似 dropout 的正则化效果,同样没有给出验证实验。
本地算太多会怎样
越大,本地模型越接近各自数据的最优解。如果问题是凸的, 时起点就不重要了,再多轮平均也不会有进一步改善。
作者也在 Shakespeare LSTM 上把 拉到很大(最多到 200)。 太大时,训练损失会停滞甚至发散。MNIST CNN 则没有明显退化;大型下一词预测任务上, 也比 稍好。作者因此建议,训练后期可以像衰减学习率一样,减少每轮的本地计算量。
这是 FedAvg 最常被追问的地方。客户端各走各的方向,走得越远,平均回来越可能偏离全局目标。
CIFAR-10 与真实规模
CIFAR-10 上,作者把 50,000 张训练图像均分给 100 个客户端,属于平衡的 IID 设置。另一个基准是不切分数据、直接用批量 100 做一般 SGD。
以达到 80% 准确率的轮数来看,SGD 要 18,000 次更新(在联邦设置中每次都算一轮通信),FedSGD 要 3,750 轮,FedAvg 只要 280 轮。85% 的目标下,SGD 要 99,000 次,FedAvg 要 2,000 轮,FedSGD 则没有在实验时间内达到。
最后一组是真实规模的下一词预测。作者把一千万条社交网站公开帖子按作者分组,得到超过 50 万个客户端,每轮 200 个客户端参与,FedAvg 用 、。FedSGD 要 820 轮才达到 10.5% 的准确率,FedAvg 只要 35 轮,少了 23 倍;FedAvg 在不同评估轮之间的准确率波动也比较小。
这篇还没回答的事
这些实验都是模拟。客户端集合固定、每轮同步、没有掉线或恶意更新,作者在一开始就把这些实务问题排除在范围外。指标是通信轮数,没有直接测量墙钟时间或手机耗电。
收敛性也只有实验证据。病态非 IID 的加速明显较小,后续研究把这个问题拆得更清楚。Zhao 等人的 Federated Learning with Non-IID Data 发现,在每个客户端只有一个类别的极端切分下,准确率最多可掉 55%,并把原因归到本地权重和全局权重之间的发散。SCAFFOLD 把同一现象称为 client drift,用控制变量修正本地更新;Li 等人的 收敛分析 则在强凸、平滑的假设下说明,非 IID 时学习率需要衰减。
隐私的部分,论文的主张是「数据不离开设备」和「只传最小必要更新」。它没有提供差分隐私或安全聚合的形式保证,作者把这两者列为后续工作。
结论
FedAvg 的算法可以写在半页里。客户端从同一份权重出发,本地多跑几轮 SGD,服务器按数据量加权平均。换来的是通信轮数少一到两个数量级,以及在非 IID 数据上仍能训练的实验证据。
Google 后来也确实把它用在 Gboard 的下一词预测上。
从模型合并的角度回头看,最耐人寻味的还是那个混合两组权重的小实验。两个独立初始化的模型一平均就坏掉,同一起点出发的模型平均后反而更好。这个条件,在之后好几年的权重平均研究里一直都在。
要自己动手的话,论文建议先调 ;只要批量还能吃满手机的并行算力,把它调小几乎不多花时间。 就别贪多了,本地跑太久,每台手机都会把模型往自己的数据拉。