原始论文
Loss Surfaces, Mode Connectivity, and Fast Ensembling of DNNs
- 发表版本
- NeurIPS 2018会议
- arXiv 首次提交
- arXiv:1802.10026
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingmodeconnectivity2018,
  title = {{Loss Surfaces, Mode Connectivity, and Fast Ensembling of DNNs}},
  author = {Timur Garipov and Pavel Izmailov and Dmitrii Podoprikhin and Dmitry Vetrov and Andrew Gordon Wilson},
  year = {2018},
  eprint = {1802.10026},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1802.10026}
}
同一个网络,用两组不同的随机种子各训练一次,会得到两组完全不同的权重,准确率却差不多。
这两组权重在参数空间里是两个点。把它们用直线连起来,沿线取几个点测一下,中间的错误率往往高得吓人。论文给的例子是 CIFAR-10 上的 VGG-16,线段正中间的测试错误率到了 90%,十个类别等于乱猜。
所以大家很自然地把每个解想成一个孤立的山谷,谷与谷之间隔着高山。
Samsung 莫斯科 AI 中心、Skoltech、Cornell 与莫斯科高等经济大学的 Garipov、Izmailov、Podoprikhin、Vetrov 与 Wilson 换了个问法。直线走不通,弯的路呢?
定义问题
令 和 是两个独立训练好的网络权重, 是训练损失。直线连接是
作者要找的是一条曲线 ,两端固定在 和 ,中间怎么弯由参数 决定,而且整条曲线上的损失都要低。
如果找得到,「解是孤立的山谷」这个图像就得改写。找不到时,还得分清楚是曲线形式太受限、优化没成功,还是两点确实难以连接;单靠一次搜索失败,无法排除其他路径。
解决问题
让曲线自己学
曲线上每个点都是一组网络权重,把它代进网络就能算损失。作者的目标是整条曲线的平均损失:
这个期望值的梯度可以用抽样估计。每一步从 随机抽一个 ,算出曲线上那一点的权重,拿一个小批量数据算损失,再对 做一次梯度下降。端点 、 固定不动,只有决定曲线形状的 在学。
两种曲线
作者用了两种最简单的参数化。第一种是只弯一次的折线,弯点就是 :
第二种是二次贝塞尔曲线, 是控制点:
两种曲线在 、 都刚好落在两个端点上。 和网络权重的形状一模一样,所以要学的参数量等于一个网络。
我们拿贝塞尔曲线的中点算一下。 时,两个端点各占 ,控制点占 。所以控制点往某个方向移动一单位,中点的权重会跟着移动半单位;反向传播时,损失对控制点的梯度也就是损失对当下权重的梯度,再乘上 。端点的权重没有加入优化器,训练过程就不会把原来两个模型改掉。
折线也一样,只是每次更新的倍率随所在的半段改变。这使曲线训练能沿用一般网络的前向与反向传播,多做的主要是权重的线性组合。它仍然需要训练数据、额外的优化与一个控制点的存储空间,不能把「找得到低损失路径」当成免费合并两个模型的配方。
小网络上跑一次
在小网络上跑一次就能看到效果。用 scikit-learn 内置的 1,797 张 8×8 手写数字,两层各 200 个单元的 MLP,同样的 1,200 张训练数据、不同的初始权重,训练出两个端点;再从直线的中点出发,学一条贝塞尔曲线:
import torch
import torch.nn as nn
from torch.func import functional_call
from sklearn.datasets import load_digits

X, y = load_digits(return_X_y=True)
X = torch.tensor(X / 16.0, dtype=torch.float32)
y = torch.tensor(y)
perm = torch.randperm(len(X), generator=torch.Generator().manual_seed(0))
idx_train, idx_test = perm[:1200], perm[1200:]

def make(seed):
    torch.manual_seed(seed)
    return nn.Sequential(nn.Linear(64, 200), nn.ReLU(),
                         nn.Linear(200, 200), nn.ReLU(),
                         nn.Linear(200, 10))

def train(model, seed, steps=480):
    opt = torch.optim.SGD(model.parameters(), lr=0.1)
    g = torch.Generator().manual_seed(seed)
    for _ in range(steps):
        b = idx_train[torch.randint(len(idx_train), (50,), generator=g)]
        loss = nn.functional.cross_entropy(model(X[b]), y[b])
        opt.zero_grad(); loss.backward(); opt.step()
    return {k: v.detach() for k, v in model.state_dict().items()}

w1 = train(make(1), seed=10)                 # 兩個端點:同樣的資料,不同的初始權重
w2 = train(make(2), seed=20)
net = make(0)

@torch.no_grad()
def evaluate(w):
    loss = nn.functional.cross_entropy(functional_call(net, w, (X[idx_train],)), y[idx_train]).item()
    acc = (functional_call(net, w, (X[idx_test],)).argmax(1) == y[idx_test]).float().mean().item()
    return f"loss {loss:.3f}, 測試 {acc:.1%}"

def line(t):
    return {k: (1 - t) * w1[k] + t * w2[k] for k in w1}

theta = {k: v.clone().requires_grad_(True) for k, v in line(0.5).items()}   # 彎點從直線中點出發

def bezier(t):
    return {k: (1 - t) ** 2 * w1[k] + 2 * t * (1 - t) * theta[k] + t ** 2 * w2[k] for k in w1}

opt = torch.optim.SGD(theta.values(), lr=0.1)
g = torch.Generator().manual_seed(0)
for _ in range(1200):
    t = torch.rand((), generator=g).item()   # 每一步隨機抽一個 t
    b = idx_train[torch.randint(len(idx_train), (50,), generator=g)]
    loss = nn.functional.cross_entropy(functional_call(net, bezier(t), (X[b],)), y[b])
    opt.zero_grad(); loss.backward(); opt.step()   # 只更新彎點 theta,端點不動

for t in [0, 0.25, 0.5, 0.75, 1]:
    print(f"t={t:<4}  直線: {evaluate(line(t))}  |  曲線: {evaluate(bezier(t))}")
t=0     直線: loss 0.119, 測試 95.5%  |  曲線: loss 0.119, 測試 95.5%
t=0.25  直線: loss 0.415, 測試 93.6%  |  曲線: loss 0.142, 測試 95.5%
t=0.5   直線: loss 0.949, 測試 88.9%  |  曲線: loss 0.156, 測試 95.3%
t=0.75  直線: loss 0.420, 測試 95.0%  |  曲線: loss 0.140, 測試 95.3%
t=1     直線: loss 0.119, 測試 94.8%  |  曲線: loss 0.119, 測試 94.8%
functional_call 让同一个网络结构直接吃一组外部给的权重,曲线上的每个点都能这样代进去算。两端的损失都是 0.119。直线走到中间,损失升到 0.949;学过的曲线在中间只有 0.156,测试准确率也维持在 95% 上下。
这个网络很小,直线上的墙也不算高。论文里的网络大得多,墙也高得多。
讨论
大网络上的曲线
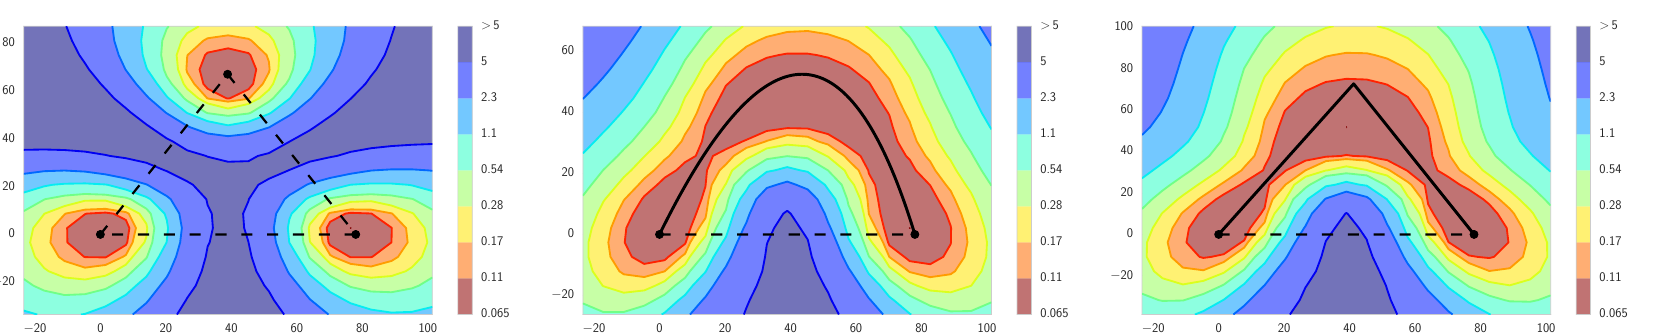
这张图是 ResNet-164 在 CIFAR-100 上的训练损失。每张图是参数空间里的一个二维切面,横轴固定穿过两个解,红色是损失低的地方,蓝色是损失高的地方。
左图用三个独立训练得到的解来确定切面,三个解各自一块红色,彼此之间都是蓝色,符合「孤立山谷」的直觉。中图和右图换了切面,让学到的曲线落在平面上,下方两个解就被一条红色的通道连了起来;两点之间的直线虚线,仍然穿过蓝色区域。
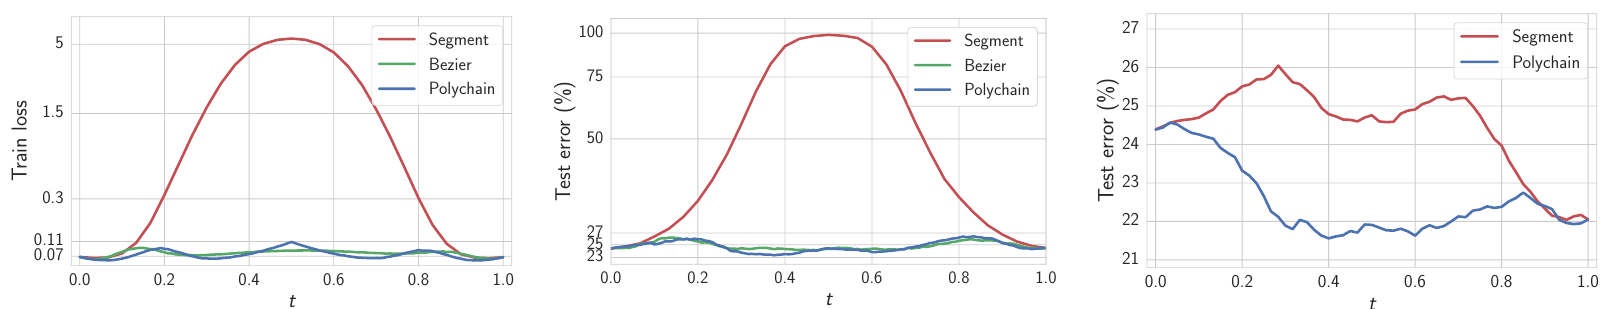
Figure 2 把同一组实验画成曲线。左图与中图的红线是直线段,中间的训练损失与测试错误率都冲到顶;绿色的贝塞尔曲线与蓝色的折线则几乎是平的。
直线上的墙有多高,和架构有关。CIFAR-10 上,VGG-16 的线段中点测试错误率到 90%;ResNet-158 和 Wide ResNet-28-10 比较低,最差分别是 80% 和 66%。作者认为这呼应了先前的观察,残差网络的损失地形比 VGG 这类经典模型更规则。
曲线也不唯一。同样的两个端点、不同的种子训练两条折线,VGG-16 上两个弯点之间的距离是 29.6,两个端点之间是 50。
曲线上的点,各有各的想法
既然整条曲线的损失都低,曲线上的点是不是只是同一个模型换了写法?
右图回答了这件事。拿端点 和曲线上某一点 组成两个模型的集成(把输出平均),沿着折线往前走,集成的错误率从 开始下降;到 ,就和两个独立训练的端点组成的集成一样好。只往前走一小段,就能拿到预测结果明显不同、准确率仍高的模型。
如果曲线上的点只是同一个函数换了参数写法,例如 ReLU 两侧的权重互相缩放,集成就不会有好处。作者在附录也示范了怎么构造这种没用的连接曲线。
从曲线到集成
这个观察带出论文的第二个贡献,快速几何集成(Fast Geometric Ensembling,FGE)。
既然在一个解附近走一小步,就能找到不一样、又够好的模型,那就不必真的去学一条曲线。FGE 先用一般的学习率调度训练到总预算的大约 80%,接着换成周期很短的循环学习率,每个周期 2 到 4 个 epoch。学习率高时往外走,低时回到谷底,每次走到低点就存一份权重,最后把这些权重对应的模型做集成。
和先前的 Snapshot Ensembles 相比,差别在步子的大小。Snapshot Ensembles 的一个周期是 20 到 40 个 epoch,从头到尾都在用;FGE 只在最后阶段用短周期。在 CIFAR-100 的 Preactivation-ResNet-164 上,FGE 相邻两次保存的检查点之间,权重的欧氏距离大约是 7;Snapshot Ensembles 大约是 40。
ImageNet 上的结果最直接。作者拿一个 top-1 错误率 23.87% 的预训练 ResNet-50,用 FGE 多跑 5 个 epoch,周期 2 个 epoch,最后 4 个模型(含原本那个)组成的集成,错误率是 23.31%,少了 0.56 个百分点。
FGE 仍然是集成,推理时要把每个模型都跑一次。
周期怎么走、模型在哪里存
先看原图左半边,从上到下依序是学习率、测试错误率、离起点的参数距离;黑圈标出保存检查点的时机。右半边改看相同训练预算的成绩,叉号是单个快照,用线连接的菱形才是集成。
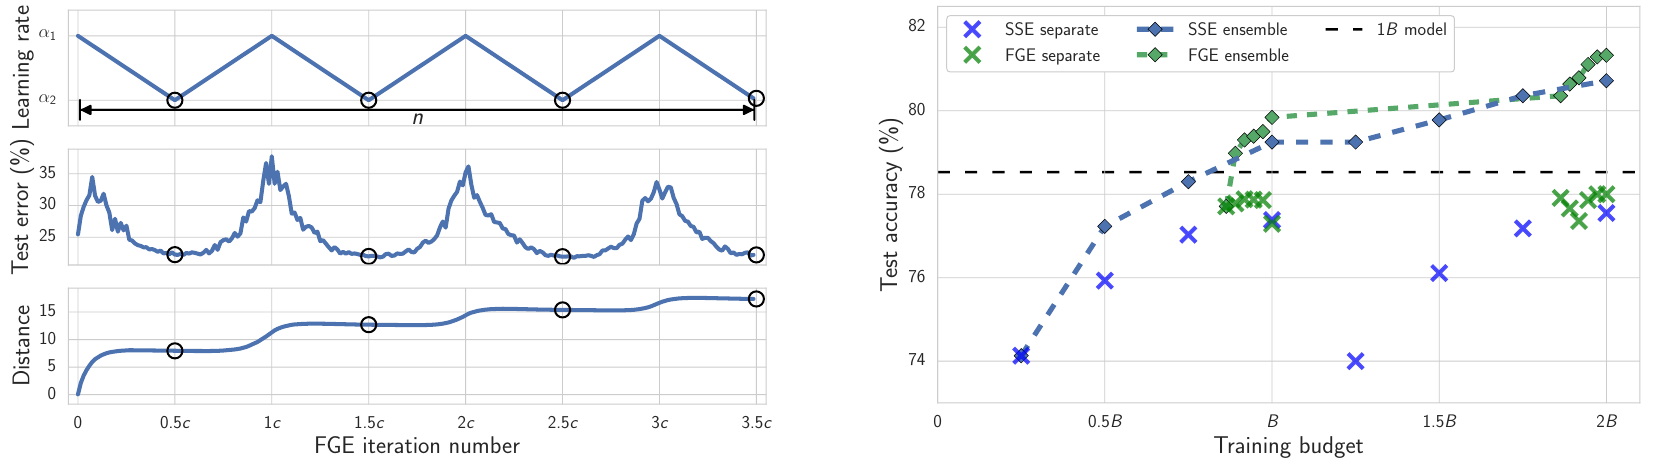
FGE 的学习率是一个三角形。令一个周期有偶数个小批量更新 ,周期内的位置是 ,上、下界是 :
从高学习率降到低点,再升回去。检查点保存在周期的中间,也就是 、学习率等于 的时候。高点附近的模型错误率会暂时上升,作者要留下的是走回低错误区之后的权重。
在 CIFAR 的实验里,VGG 用 2 个 epoch 一个周期,、;ResNet 和 WRN 用 4 个 epoch,、。例如 ResNet 的标准预算 epochs,先跑一般调度到第 125 个 epoch,再在 126–147 之间收集 6 个模型。这些快照共用前面的训练路径,省下的是反复从头训练的时间。
这里也能看出曲线搜索和 FGE 的分工。前半篇先固定两个端点、学弯点,拿来验证低损失通道存在;FGE 则从一个模型出发,靠短周期找到附近的多个解。实际运行 FGE 时,完全不需要先训练第二个端点或学一条贝塞尔曲线。
同样预算,换到多少准确率
比较集成时,要把训练预算和推理模型数分开看。论文的 是一般方法把一个模型训练到收敛所需的 epochs; 就是两倍训练量。下表挑 CIFAR-100、 的结果,指标是测试错误率,越低越好。
| 架构 | 独立训练 Ind | Snapshot Ensembles | FGE |
|---|---|---|---|
| VGG-16, | 27.4 ± 0.1 | 26.4 ± 0.1 | 25.7 ± 0.1 |
| Preactivation ResNet-164, | 21.5 ± 0.4 | 20.9 ± 0.2 | 20.2 ± 0.1 |
| WRN-28-10, | 19.2 ± 0.2 | 17.9 ± 0.2 | 17.7 ± 0.2 |
测试错误率(%),整理自原论文 Table 1。同一行的训练预算相同,推理时使用的模型数依方法而异。
三组都赢过 Snapshot Ensembles,其中 VGG 和 ResNet 各少了 0.7 个百分点。到 时,CIFAR-100 的 WRN 是 Ind 17.48%、SSE 17.30%、FGE 16.95%。但换到 CIFAR-10、WRN 的 设置,Ind 是 3.31%,FGE 是 3.52%;集成方法的优势会随数据集、架构和预算改变。
作者也量了预测多样性。在 CIFAR-100 的 ResNet-164 上,两个独立模型对 19.97% 的测试图像给出不同类别,同一轮 FGE 的两个快照则是 14.57%。FGE 的单个快照还稍弱一些,约 78.0% 准确率,完整独立训练约 78.5%。它的优势来自同样时间能取得更多有用的快照,足以补回单个模型与多样性的差距。
最后还有 BatchNorm。曲线上的权重改了,中间激活值的分布也会改;附录对有 BatchNorm 的网络重新估计统计量,再量曲线上的损失。若沿用端点的 running mean 和 variance,画出的高墙可能同时混进统计量失配。看地形之前,得先让每个点对应的网络能正确推理。
结论
这篇论文用一个很朴素的训练方法,把两个独立训练的解用一条只弯一次的线连了起来。线上的损失几乎不变,直线上却有一道高墙。
「每个解是一个孤立山谷」的图像,从此得改成「解之间有低损失的通道,只是通道不直」。这也解释了为什么把两个独立训练的网络直接平均会坏掉,因为平均走的是直线。
FGE 的推理成本留了一个尾巴。两周后,同一组作者就发表了 SWA,存下来的那些权重不再拿去集成,直接平均成一个模型。