原始论文
Assembly of Experts: Linear-time construction of the Chimera LLM variants with emergent and adaptable behaviors
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2506.14794
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelmergingassemblyofexperts2025,
  title = {{Assembly of Experts: Linear-time construction of the Chimera LLM variants with emergent and adaptable behaviors}},
  author = {Henrik Klagges and Robert Dahlke and Fabian Klemm and Benjamin Merkel and Daniel Klingmann and David A. Reiss and Dan Zecha},
  year = {2025},
  eprint = {2506.14794},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2506.14794}
}
DeepSeek 曾经同时有两个很像、个性却很不一样的模型。
一个是 DeepSeek-R1,推理模型,回答前会先在 <think> 和 </think> 之间写一大段思考过程,数学题做得很好,但话很多。另一个是 2025 年 3 月更新的 DeepSeek-V3-0324,一般的对话模型,不写思考过程,回答直接,速度快。
两者的架构完全相同,都从 DeepSeek-V3 的基底出发,总共 6,710 亿个参数。如果能把 R1 的推理能力和 V3-0324 的简洁合在一起,不用重新训练,那就太划算了。
德国的软件咨询公司 TNG Technology Consulting 真的这样做了。他们在 2025 年 4 月把合并出来的 DeepSeek-R1T-Chimera 放上 Hugging Face,一个多月后才补上这篇论文,说明他们怎么做、以及沿途看到的现象。
定义问题
先回顾一下 DeepSeek-V3 的架构,这是理解整篇论文的关键。
它是一个混合专家(MoE)Transformer,共 61 个解码器层。前 3 层是一般的稠密层,后 58 层的前馈网络换成专家:每层有共享专家,每个 token 都会经过;还有 256 个路由专家,由一个路由器替每个 token 挑出 8 个来用。所以总参数 671B,每个 token 实际用到的只有约 37B。
一个模型拆开来,就是一堆张量文件。DeepSeek-V3 家族的 safetensors 权重文件里共有 91,991 个张量,可以分成几类:前 3 层的稠密层、各层的注意力、共享专家、路由专家,以及路由器的门控。
合并两个模型时,每一类张量都可以分开处理。这就是作者说的「组装」:不只决定两个模型各给多少权重,还决定哪些零件要合并、哪些直接沿用其中一方。
之前也有人用合并来缩短推理模型的回答,例如 Wu 等人在 7B 到 14B 的模型上做得不错,但在 32B 以上的模型遇到困难,很难在大幅缩短回答的同时保住推理质量。这篇要回答的是,671B 的模型能不能这样组装,组出来的模型行为又会怎么变。
解决问题
合并规则
令 是基底模型(这里是 V3-0324), 是其他模型(这里只有 R1)。对每一个张量 ,合并后的张量是
这里有三个可以调的东西:
- :各模型的权重,通常是凸组合,、总和为 1。两个模型时, 就是 R1 的比例。
- :要合并的张量集合。作者比较两种,一种是全部张量(full merging),一种是只有路由专家,不含门控(expert merging)。
- :门槛。只有和基底差得够多的张量才合并,差异以归一化的 Frobenius 范数度量,也就是范数除以张量元素个数的平方根。
门槛借用了 TIES-Merging 的修剪想法,但 TIES 是逐个参数修剪,这里是整个张量一起决定要不要合并。
实现上就是逐一读取 91,991 个张量,算出合并结果再写回同样格式的文件,用 vLLM 就能直接加载。运算量和模型大小成正比,所以标题说是「线性时间」,完全不需要梯度计算。
先看看两个模型差在哪
作者先量了 R1 和 V3-0324 每个张量的差异。结果很有规律。路由专家在整个模型里的差异都相当平均,只在最前与最后几层有明显的模式;共享专家的门控投影在前面几层几乎一样,到了最后几层差异很大;注意力层也有类似的趋势。
这张差异分布,后来成为选择门槛 的依据。
怎么评估
每个合并模型都在 8 张 H100 或 8 张 MI325X 上用 vLLM 推理,主要测两个基准:MT-Bench(多轮对话质量)和 AIME-2024(数学竞赛题)。两者平均起来,作者称为「智力分数」。
成本则用平均输出 token 数衡量,以 R1 的输出量为 100%。
另外还有一个行为指标。作者强制每个回答都以 <think> 开头,再看回答里有没有出现收尾的 </think>。R1 一定会出现,V3-0324 从不出现,这个比例就代表模型有多「像推理模型」。
讨论
几乎每个组合都能用
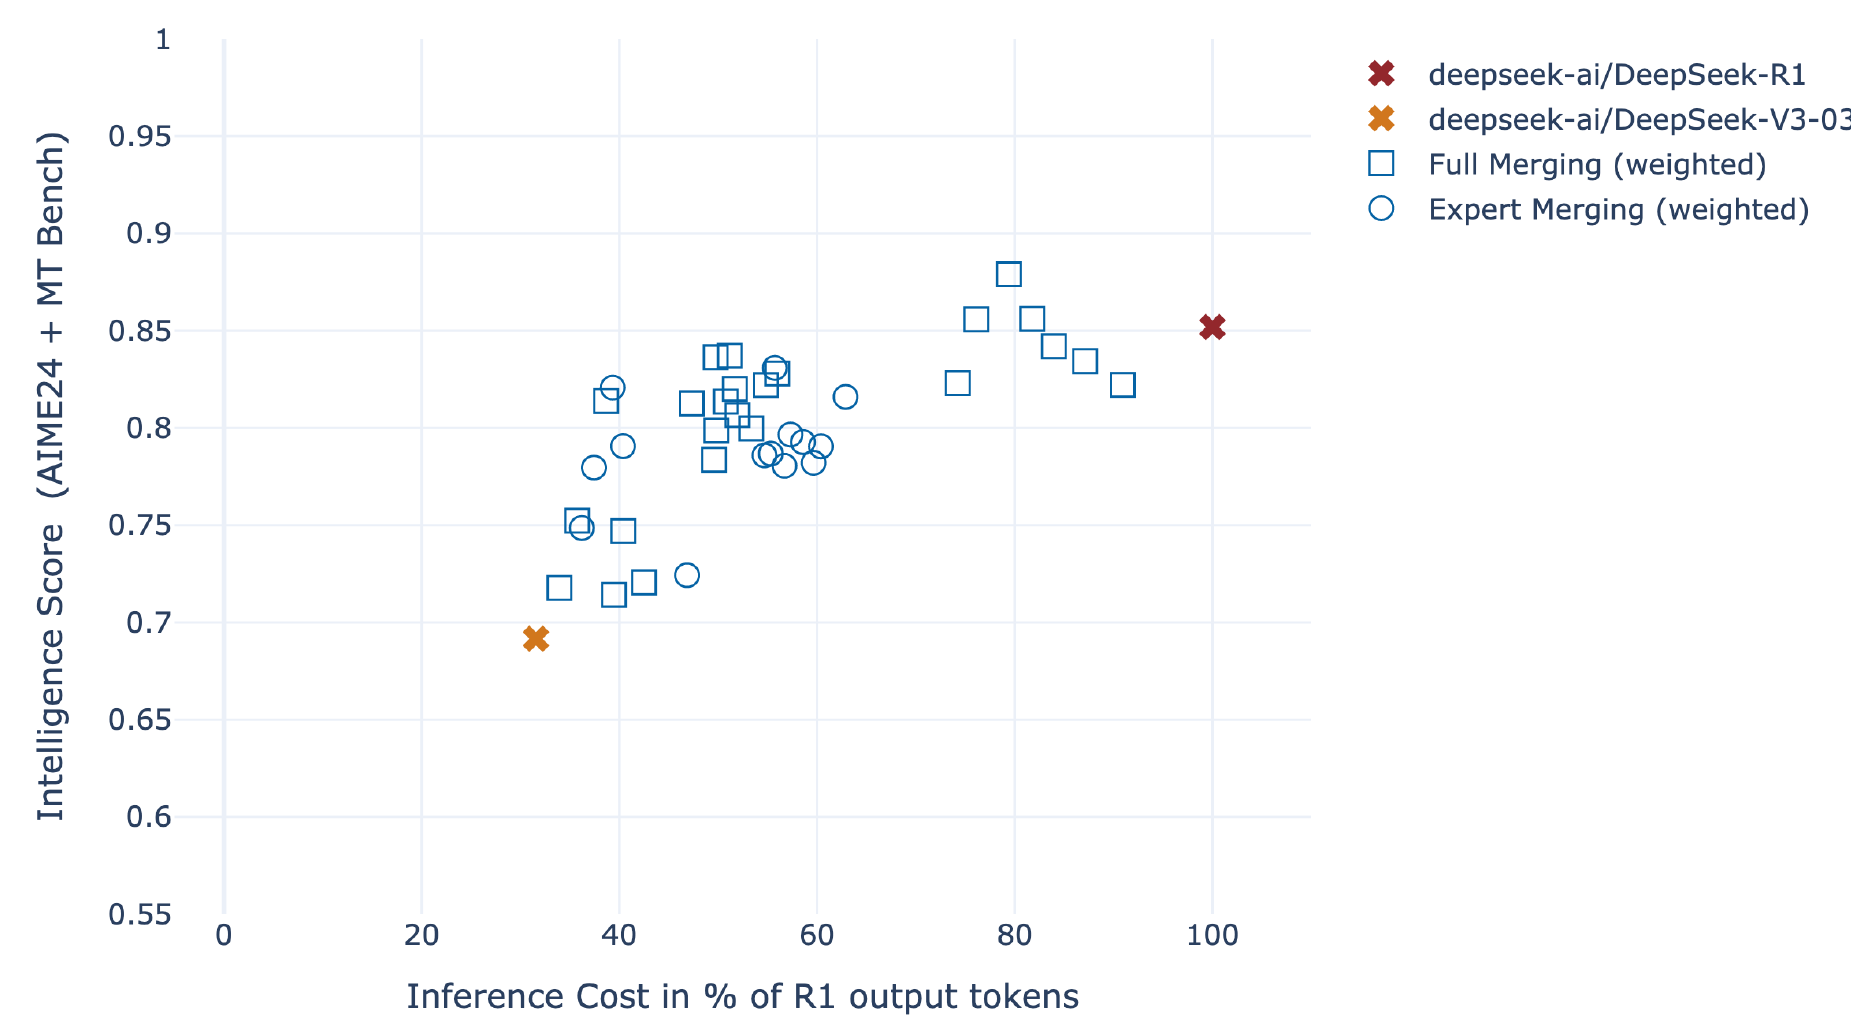
这张图的理想位置是左上角,分数高、成本低。
R1 在右边,分数约 0.85,成本 100%;V3-0324 在左下,分数约 0.69,成本约 31%。各种合并模型散在两者之间,没有任何一个掉到底下去。作者特别强调,他们搜索过的整个参数空间里,没有出现坏掉的模型。
有好几个点落在成本 50% 左右、分数 0.82 以上的位置,用一半的 token 拿到接近 R1 的分数。还有一个全张量合并的点,成本约 80%,分数将近 0.88,比 R1 本身还高。
作者把这解释为 V3、V3-0324、R1 都位于同一个低损失的谷底里,凸组合不会跑出谷外。这和 Model Soups 的观察一致,只是规模大了好几个数量级。
推理行为是突然出现的
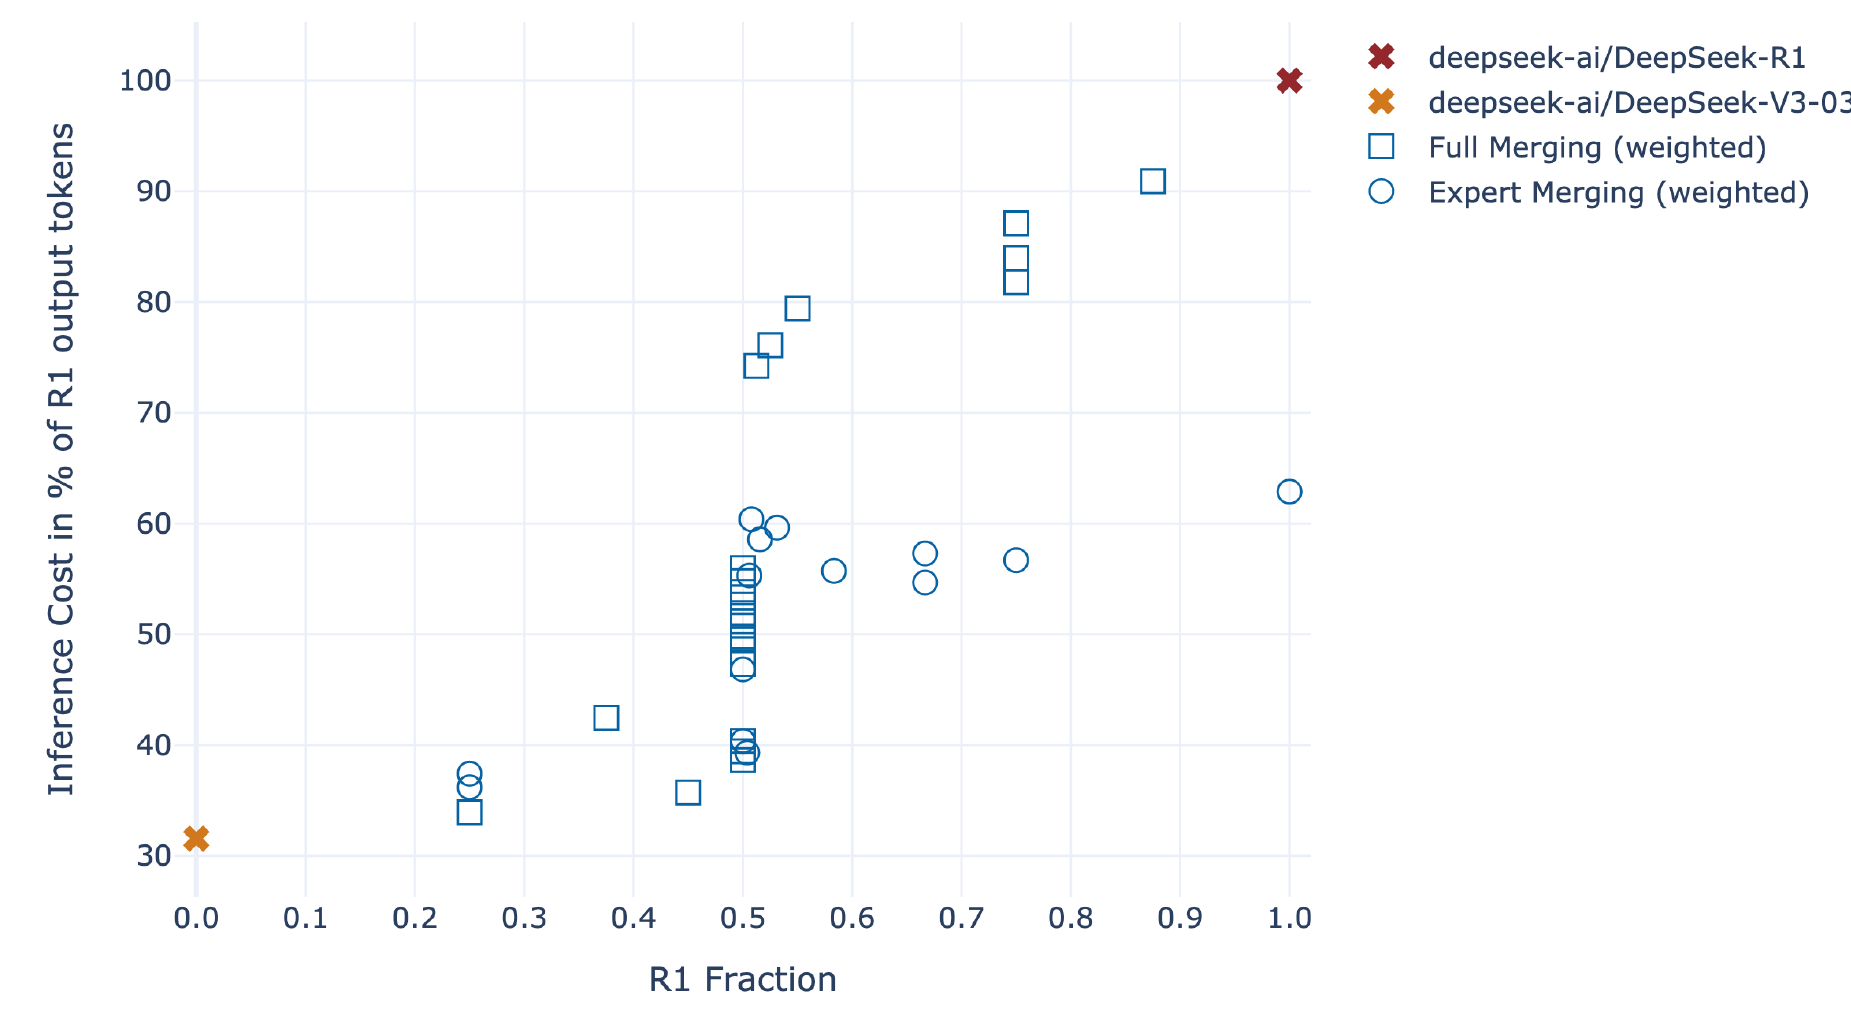
横轴是 R1 的比例 。输出长度在 0.5 附近急剧跳升,前后两段都比较平,形状像一条 S 形曲线。
</think> 标签更明显。R1 比例在 0.504 以上的合并模型,通常会写出完整的思考过程并以 </think> 收尾;比例低一点点的,通常就不会。这个转折点只在 0.5 附近一个很窄的范围内。
所以合并模型的不同性质,变化方式也不同。一般的推理能力随比例平滑变化,「写不写思考过程」这种行为特征则像开关一样,越过门槛才出现。
图中另一个重点是两种符号的差距。只合并路由专家(圆圈)的成本,整体比全张量合并(方块)低很多。就算路由专家全部换成 R1 的,成本也只有 R1 的六成左右。
门槛:哪些零件重要
固定 的全张量合并,作者逐步提高门槛 。门槛低时,大部分注意力与路由专家张量都会被合并;门槛提高到某个程度,多数共享专家张量被排除,保留 V3-0324 的值;再提高,注意力张量也被排除,只剩差异最大的路由专家还在合并。
结果是成本随门槛一路下降,智力分数则一直维持稳定,直到门槛高到开始排除大量 R1 路由专家时,分数才开始掉。
R1T-Chimera
把以上观察放在一起,作者提出两个假说。第一,R1 的推理能力主要放在路由专家里。第二,V3-0324 其余的部分,包括注意力、共享专家与稠密层,足以和这些专家协作,不会明显降低表现。
于是他们试了最极端的设置:只合并路由专家,而且 ,路由专家完全换成 R1 的,其他全部沿用 V3-0324。这就是 DeepSeek-R1T-Chimera。
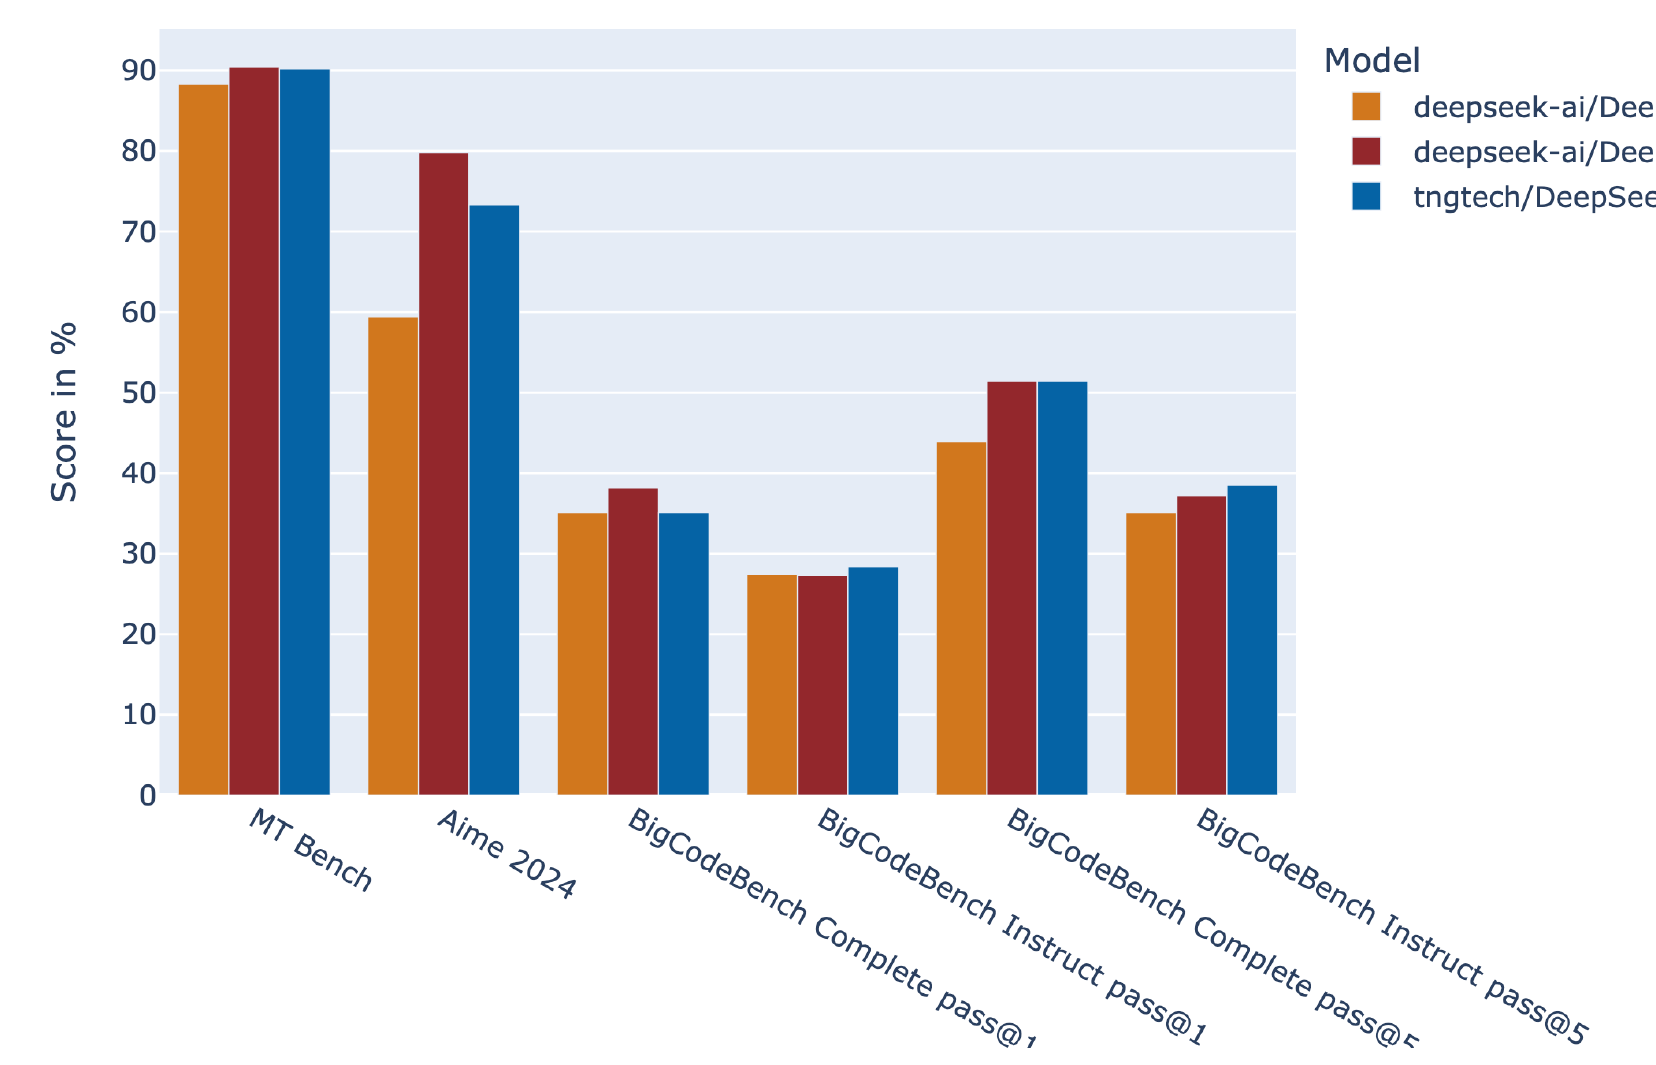
MT-Bench 上三者几乎一样。AIME 2024 上 Chimera 约 73 分,比 V3-0324 的约 59 分高很多,但仍落后 R1 的约 80 分。BigCodeBench 的四个子项,Chimera 大致和 R1 持平。输出 token 则少了大约四成。
作者说 Chimera 的思考过程比两个父模型都更精简、更有条理;这是定性的观察,论文没有量化。
TNG 先在内部 GPU 集群上用 Chimera 取代 R1,再公开权重。根据论文,2025 年 5 月底它每天通过 Chutes 这个无服务器推理平台处理近 50 亿个 token。
证据的范围
这篇的实验设计相当简略,有几件事要记得。
- 评测太少:整个参数搜索只用 MT-Bench 和 AIME-2024 两个基准,AIME-2024 只有 30 题,一两题的差距就是好几个百分点;论文没有报告重复次数或方差。
- 「智力分数」是自定义指标:把一个由模型评审的对话分数和一个数学竞赛分数直接平均,用来排序可以,拿来当能力的绝对标尺则太粗。
- 只有一对父模型:所有观察都来自 V3-0324 和 R1,「推理能力放在路由专家」的假说,在其他模型家族上还没有验证。
在相关研究里作者也提到,Kimi k1.5 的团队比较过,用长度惩罚的损失来微调,比合并长短两种推理模型更能产出省 token 的模型。合并的优势在于便宜,不一定在于最好。
TNG 在 2025 年 7 月又发布了 R1T2 Chimera,改成三个父模型(R1-0528、R1、V3-0324),同样沿用 V3-0324 的注意力与共享层。
结论
这篇论文把模型合并做到了 671B 的规模,而且利用 MoE 的结构,把「合并」细分成「选零件」。把 R1 的路由专家换进 V3-0324 的身体里,得到一个推理能力接近 R1、输出短四成的模型,全程没有任何梯度计算。
最有意思的是沿途观察到的相变。推理能力平滑变化,写思考过程的习惯却在 R1 比例过半的瞬间突然出现。
MoE 模型的零件可以这样拆开来换,前提是两个模型来自同一个基底。拿两个不同家族的 MoE 来缝,那就真的只是缝合怪了。