原始论文
Command A: An Enterprise-Ready Large Language Model
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2504.00698
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{transformerscommanda2025,
  title = {{Command A: An Enterprise-Ready Large Language Model}},
  author = {Team Cohere and Aakanksha and Arash Ahmadian and Marwan Ahmed and Jay Alammar and Milad Alizadeh and Yazeed Alnumay and Sophia Althammer and Arkady Arkhangorodsky and Viraat Aryabumi and Dennis Aumiller and Raphaël Avalos and Zahara Aviv and Sammie Bae and Saurabh Baji and Alexandre Barbet and Max Bartolo and Björn Bebensee and Neeral Beladia and Walter Beller-Morales and Alexandre Bérard and Andrew Berneshawi and Anna Bialas and Phil Blunsom and Matt Bobkin and Adi Bongale and Sam Braun and Maxime Brunet and Samuel Cahyawijaya and David Cairuz and Jon Ander Campos and Cassie Cao and Kris Cao and Roman Castagné and Julián Cendrero and Leila Chan Currie and Yash Chandak and Diane Chang and Giannis Chatziveroglou and Hongyu Chen and Claire Cheng and Alexis Chevalier and Justin T. Chiu and Eugene Cho and Eugene Choi and Eujeong Choi and Tim Chung and Volkan Cirik and Ana Cismaru and Pierre Clavier and Henry Conklin and Lucas Crawhall-Stein and Devon Crouse and Andres Felipe Cruz-Salinas and Ben Cyrus and Daniel D'souza and Hugo Dalla-Torre and John Dang and William Darling and Omar Darwiche Domingues and Saurabh Dash and Antoine Debugne and Théo Dehaze and Shaan Desai and Joan Devassy and Rishit Dholakia and Kyle Duffy and Ali Edalati and Ace Eldeib and Abdullah Elkady and Sarah Elsharkawy and Irem Ergün and Beyza Ermis and Marzieh Fadaee and Boyu Fan and Lucas Fayoux and Yannis Flet-Berliac and Nick Frosst and Matthias Gallé and Wojciech Galuba and Utsav Garg and Matthieu Geist and Mohammad Gheshlaghi Azar and Ellen Gilsenan-McMahon and Seraphina Goldfarb-Tarrant and Tomas Goldsack and Aidan Gomez and Victor Machado Gonzaga and Nithya Govindarajan and Manoj Govindassamy and Nathan Grinsztajn and Nikolas Gritsch and Patrick Gu and Shangmin Guo and Kilian Haefeli and Rod Hajjar and Tim Hawes and Jingyi He and Sebastian Hofstätter and Sungjin Hong and Sara Hooker and Tom Hosking and Stephanie Howe and Eric Hu and Renjie Huang and Hemant Jain and Ritika Jain and Nick Jakobi and Madeline Jenkins and JJ Jordan and Dhruti Joshi and Jason Jung and Trushant Kalyanpur and Siddhartha Rao Kamalakara and Julia Kedrzycki and Gokce Keskin and Edward Kim and Joon Kim and Wei-Yin Ko and Tom Kocmi and Michael Kozakov and Wojciech Kryściński and Arnav Kumar Jain and Komal Kumar Teru and Sander Land and Michael Lasby and Olivia Lasche and Justin Lee and Patrick Lewis and Jeffrey Li and Jonathan Li and Hangyu Lin and Acyr Locatelli and Kevin Luong and Raymond Ma and Lukáš Mach and Marina Machado and Joanne Magbitang and Brenda Malacara Lopez and Aryan Mann and Kelly Marchisio and Olivia Markham and Alexandre Matton and Alex McKinney and Dominic McLoughlin and Jozef Mokry and Adrien Morisot and Autumn Moulder and Harry Moynehan and Maximilian Mozes and Vivek Muppalla and Lidiya Murakhovska and Hemangani Nagarajan and Alekhya Nandula and Hisham Nasir and Shauna Nehra and Josh Netto-Rosen and Daniel Ohashi and James Owers-Bardsley and Jason Ozuzu and Dennis Padilla and Gloria Park and Sam Passaglia and Jeremy Pekmez and Laura Penstone and Aleksandra Piktus and Case Ploeg and Andrew Poulton and Youran Qi and Shubha Raghvendra and Miguel Ramos and Ekagra Ranjan and Pierre Richemond and Cécile Robert-Michon and Aurélien Rodriguez and Sudip Roy and Sebastian Ruder and Laura Ruis and Louise Rust and Anubhav Sachan and Alejandro Salamanca and Kailash Karthik Saravanakumar and Isha Satyakam and Alice Schoenauer Sebag and Priyanka Sen and Sholeh Sepehri and Preethi Seshadri and Ye Shen and Tom Sherborne and Sylvie Shang Shi and Sanal Shivaprasad and Vladyslav Shmyhlo and Anirudh Shrinivason and Inna Shteinbuk and Amir Shukayev and Mathieu Simard and Ella Snyder and Ava Spataru and Victoria Spooner and Trisha Starostina and Florian Strub and Yixuan Su and Jimin Sun and Dwarak Talupuru and Eugene Tarassov and Elena Tommasone and Jennifer Tracey and Billy Trend and Evren Tumer and Ahmet Üstün and Bharat Venkitesh and David Venuto and Pat Verga and Maxime Voisin and Alex Wang and Donglu Wang and Shijian Wang and Edmond Wen and Naomi White and Jesse Willman and Marysia Winkels and Chen Xia and Jessica Xie and Minjie Xu and Bowen Yang and Tan Yi-Chern and Ivan Zhang and Zhenyu Zhao and Zhoujie Zhao},
  year = {2025},
  eprint = {2504.00698},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2504.00698}
}
Cohere 是一家以企业客户为主的加拿大语言模型公司,创始人之一 Aidan Gomez 是《Attention Is All You Need》的共同作者。它的模型主打检索增强生成(RAG)、工具使用与多语言,通常不在聊天排行榜上抢第一,而是强调在企业的实际场景里好用、好部署。
2025 年 3 月,Cohere 发布了 Command A。这是一个 1,110 亿参数的模型,支持 23 种商业语言,只要两张 A100 或 H100 就能部署。权重以非商业许可(CC-BY-NC)公开,供研究使用。
这份技术报告的重点在后训练流程。一般的做法是拿一个模型依次做 SFT、偏好学习、强化学习;Command A 则是让好几个团队各自训练擅长不同能力的专家模型,最后用模型合并把它们合成一个。报告说,这是第一次在这种规模上把模型合并当成后训练的核心。
定义问题
企业用的语言模型要同时做很多事:读文档回答问题、调用工具、写代码、做数学、说多国语言、遵守安全规范,还要能处理很长的上下文。
这些能力的训练方式差很多。编程和数学容易验证,可以大量合成数据,用可验证的奖励做强化学习;安全和 RAG 则多半依赖人工标注,数据量小得多,适合用偏好比较来训练。把这些数据全部混在一起、用同一套超参数训练一个模型,很难让每一项都达到最好。
组织上也有同样的问题。多个团队同时改进不同能力时,如果都在同一个模型上工作,彼此的实验会互相干扰,进度也得互相等待。
能不能让每个能力各自训练到最好,再便宜地合在一起?这是整份报告想回答的问题。
解决问题
架构与预训练
先快速看一下底座。Command A 是纯解码器的 Transformer,主要有三个设计。
- 交错的注意力层:每 4 层中,3 层是滑动窗口注意力,1 层是完整注意力,比例 3:1。滑动窗口层使用 RoPE,完整注意力层则不用任何位置编码(NoPE)。
- 并行的 Transformer 块:注意力和前馈网络并行计算,而不是先后串接。作者说表现相当,吞吐量明显提升。
- 其他:GQA、SwiGLU、不使用偏置项、输入与输出共享嵌入矩阵。词汇表有 255,000 个 token,共享嵌入能省下大量内存。
训练用 µP 在小模型上调超参数,再直接搬到大模型。主要的矩阵乘法用 FP8 计算,作者没有观察到不稳定,但全程用 FP8 会让下游表现略差,所以先用 BF16 训练一段,再切换到 FP8。预训练最后有一段冷却期,学习率在 50,000 步内从 降到 ,上下文长度先维持 8K,再逐步拉到 32K、128K、256K。
后训练:两次合并
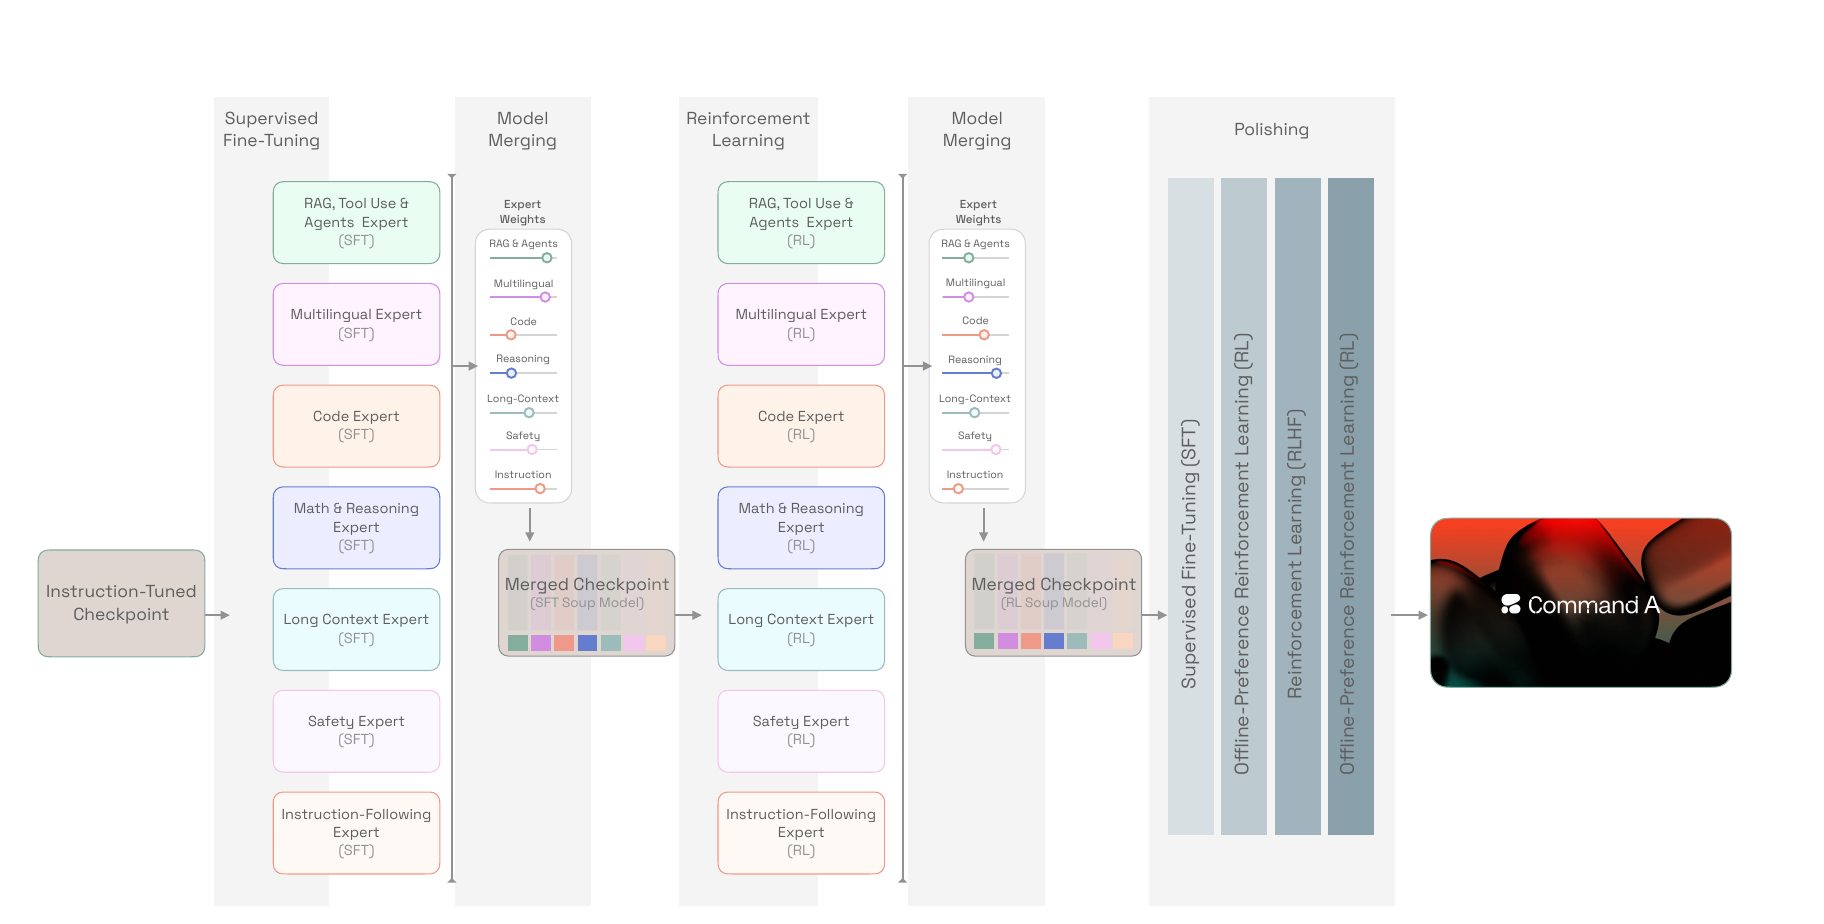
这张图由左往右读。
- 指令模型:先在预训练模型上做一次 SFT,得到具备基本能力的指令模型。
- SFT 专家:从同一个指令模型出发,并行训练多个专家,各自用专门的数据配比与超参数。报告正文列出六个:编程、安全、RAG、数学、多语言,以及通用与长上下文。
- SFT Soup:把这些专家合并成一个模型。
- RL 专家:从 SFT Soup 出发,再并行训练一组强化学习专家,每个领域用适合的方法,数学和编程用可验证的奖励,安全和多语言用偏好比较。
- RL Soup:再合并一次。
- 抛光:最后做一轮全局的对齐,修正合并留下的问题,并让整体风格更符合人的偏好。
图中两个「Model Merging」方框里画了一排滑块,表示每个专家在合并时的权重可以调整。这是整套流程的关键,合并后如果发现某项能力不够,不必重新训练,调一下滑块重新合并就好。
合并的四种用途
报告把模型合并分成四种用途,Command A 都用到了:
- 专家合并:把擅长不同能力的模型合成一个,这是主角。
- Polyak 平均:平均同一次训练的多个 checkpoint,降低随机梯度的噪声。
- 种子合并:平均用不同随机种子训练的模型,减少偶然性。
- 插值恢复能力:专家只在短上下文上训练,长上下文能力会退化。把专家和原本的基底模型插值,可以找回大部分的长上下文能力,同时保留专家的新能力。作者指出这和 Google DeepMind 的 WARP 很接近。
线性合并就够了
专家合并用的是线性平均:
作者试过 SLERP 和任务算术,发现没有明显的进步,反而增加了复杂度。线性合并还有一个实用的性质,它满足结合律,合并的合并仍然可以写成一次合并,整条流程比较容易追踪。
权重 用人工搜索。增加某个专家的权重,大致会提升那个领域的表现,这个关系很直观;但因为所有权重总和要是 1,其他领域会被相应调低,而它们会掉多少就不太好预测。作者的搜索方式是两者结合:哪个领域不够好就调高它的专家;再以当前的候选为中心,对每个专家的权重做小幅扰动、暴力搜索。
整个过程追踪了 500 个评估指标。作者说,如果用传统的集中式开发,要同时照顾这么多指标会困难得多。
一致性比最优更重要
合并能不能成功,很大程度取决于专家之间是否「兼容」。作者整理了几个经验:
所有专家都从同一个指令模型出发。 一个原因是特殊 token。有些专家会用到工具调用等特殊 token,其他专家没用到,这些 token 的嵌入在它们那里就没有被训练。作者试过只从有训练到的专家那里取这些嵌入,效果反而不如大家都从同一个起点出发、正常平均。另一个原因是长上下文,后训练通常会削弱长上下文能力,而且很难救回来;从一个本身就能处理长上下文的指令模型出发,比较容易保住。
做「去掉一个」的合并。 搜索时刻意比较少了某个专家的合并结果,就能找出哪个专家在拖累别人。作者称这种现象为「碰撞」。
每个专家都放一点其他领域的数据。 少量的跨领域数据像是正则项,让专家不要偏离太远,保持彼此兼容。碰撞有时也来自共用数据在风格或格式上的小差异。
作者的结论是,维持专家之间的一致性,比追求单一专家的最佳表现更重要。
合并很便宜,评估很贵
这一点是在实际产品中才会遇到的问题。学术研究通常固定一组专家,再去找最好的合并方法,目标是少数几个指标。但 Command A 要同时照顾几百个指标,每试一组权重,都要跑完整套评估。合并本身的计算量很小,评估却要大量的推理时间。
而且专家本身也一直在变。作者说,让合并成功的很大一部分工作,其实是回头修改专家的训练方式。
讨论
合并保留了多少专家能力
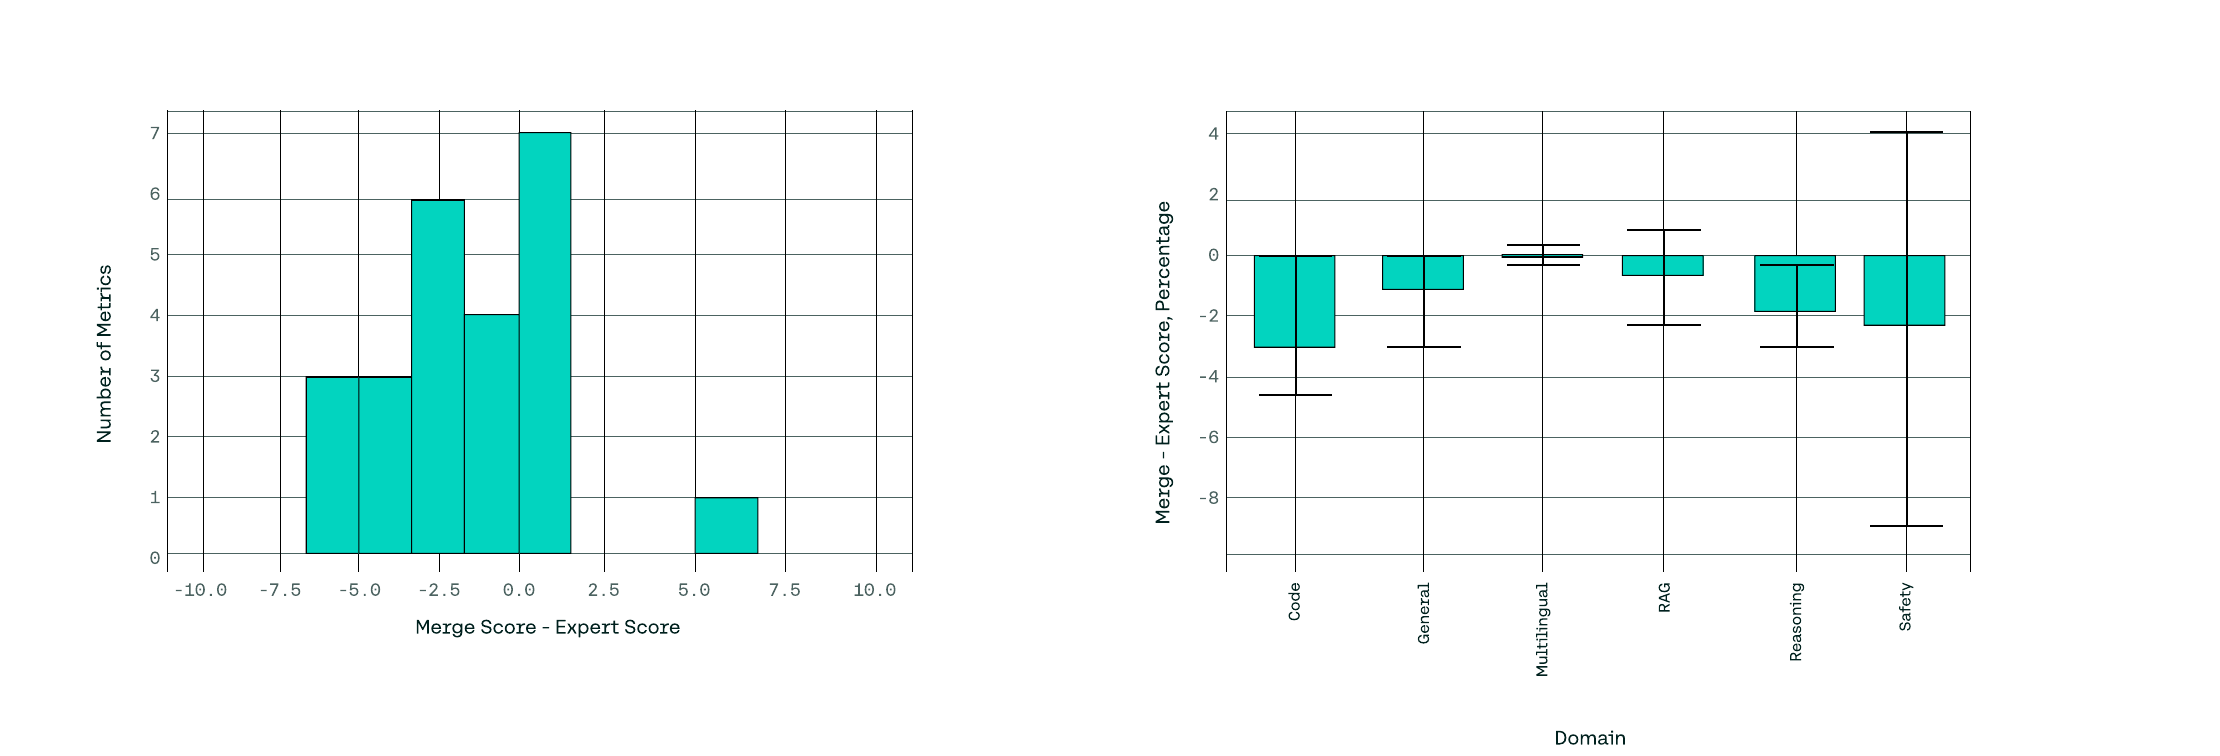
左图是所有被追踪的指标,合并后与最佳专家的分数差。绝大多数集中在 0 附近偏左,报告说平均只掉了 1.8%,绝大多数指标保留在最佳专家的 2.5% 以内,少数甚至比专家还好。
右图按领域拆开。多语言、RAG 和通用能力保留得最好;编程损失最多,平均约 3%。安全的误差线很长,表示不同安全指标在合并后的变化差异很大。
作者还观察到,在 111B 的规模下,合并相当稳定。大幅调整专家权重,领域表现通常只变动 2% 到 3%,很少出现某项能力整个崩溃的情况。
合并是粗略的操作
合并后的模型不保证落在损失地形的局部最优点上。作者发现,在合并后的模型上,用比主要 SFT 低 10 到 20 倍的学习率,再做少量的 SFT 步数,就能明显提升表现,很多指标达到甚至超过专家的 100%。
作者的直觉解释是,合并能把各项能力组合起来,但它们在表示空间里可能还没「对齐」;少量的梯度更新可以把这些能力调整到位。这和抛光阶段的作用一致,抛光也被用来修补合并时掉下的分数。
抛光本身用了两种 Cohere 的方法,交替进行:离线的 SRPO 与在线的 CoPG。作者发现交替使用能互相修正,某一阶段若出现退步,通常会在下一阶段被拉回来。
整体成绩
学术基准上,Command A 与 DeepSeek-V3、GPT-4o、Llama 3.3 70B 互有胜负。例如 MATH 是 80.0,高于 DeepSeek-V3 的 70.2 与 GPT-4o 的 68.5;GPQA 是 50.8,低于 DeepSeek-V3 的 59.1。企业智能体任务 τ-bench 是 51.7,高于 DeepSeek-V3 的 39.1。
人工评测中,Command A 对 GPT-4o(2024 年 11 月版)与 DeepSeek-V3 的胜率大致是五五开,编程项目上对 DeepSeek-V3 的胜率是 54.7%,对 GPT-4o 则是 46.8%。速度方面,作者声称 Command A 每秒最多可输出 156 个 token,是 GPT-4o 的 1.75 倍、DeepSeek-V3 的 2.4 倍;这是厂商自己的测量,部署条件不同时数字会变。
读这份报告要注意的事
合并的效果只以分布图与平均值呈现,没有列出每个专家、每组权重的具体分数,也没有比较「不合并、直接混数据训练一个模型」的对照组。权重是人工搜索出来的,换一组专家或换一个规模,同样的经验是否成立,报告没有验证。
结论
Command A 让模型合并从研究技巧变成大型模型的开发流程。每个团队各自把一项能力练到最好,再用最简单的线性平均合成一个模型,必要时调一下权重重新合并,不用重新训练。
报告里最实用的,是那几条经验之谈:所有专家从同一个起点出发、每个专家都掺一点别人的数据、用「去掉一个」的合并找出捣乱的专家、合并后补几步低学习率的 SFT。
学术论文多半在比哪一种合并方法最好;Cohere 选了最简单的那一种,把力气花在让专家彼此合得来。合并只是最后那一下,功夫都在合并之前。