原始論文
Model Merging in LLMs, MLLMs, and Beyond: Methods, Theories, Applications and Opportunities
- arXiv 首次提交
- arXiv:2408.07666
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingmodelmergingsurvey2024,
  title = {{Model Merging in LLMs, MLLMs, and Beyond: Methods, Theories, Applications and Opportunities}},
  author = {Enneng Yang and Li Shen and Guibing Guo and Xingwei Wang and Xiaochun Cao and Jie Zhang and Dacheng Tao},
  year = {2024},
  eprint = {2408.07666},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2408.07666}
}
模型合併這幾年的論文長得很快,名字也越來越多。
任務算術、TIES、DARE、AdaMerging、RegMean、Fisher Merging、Model Breadcrumbs、TSV-M、WEMoE……每一篇都說自己解決了合併時的某種干擾,但很少有人把它們放在一起看:這些方法分別在處理哪個問題?需要什麼資料?在大型語言模型上還成不成立?
中山大學深圳校區、東北大學與南洋理工大學的 Yang、Shen、Guo 等人寫的這篇綜述,就是要回答這些問題。它在 2024 年 8 月首次公開,之後持續更新,2025 年底的第五版已經擴充到四十頁。作者另外維護一個 GitHub 論文清單,持續收錄新的工作。
這篇筆記把重點放在它的分類方式、作者自己跑的比較實驗,以及它認為還沒解決的問題。
定義問題
模型合併和其他做法差在哪
作者先拿模型合併和四種相近的學習方式比較。
- 單任務學習:每個任務訓練一個專家模型,互不干擾,但知識無法共用,模型數量也跟著任務數量增加。
- 多任務學習:一個模型同時學所有任務,但需要拿到所有任務的資料一起訓練。
- 聯邦學習:資料留在各個客戶端,模型更新交給伺服器聚合,但需要很多輪通訊。
- 集成學習:同時保留多個專家模型,把它們的輸出合起來,推論與儲存成本都很高。
模型合併則是直接把幾個訓練好的專家模型的參數合起來,得到單一模型,大多數情況下不需要原始資料,也不需要再訓練。
形式上,給定 個架構相同的模型 ,它們通常從同一個預訓練模型 微調而來,目標是找到
最簡單的版本是直接平均。作者指出平均常常效果很差,原因有兩類:一是缺少合併的前提條件,例如模型不在同一個盆地、架構不一致;二是不同任務之間的參數互相衝突、互相干擾。
整份綜述的方法分類,就是沿著這兩個原因展開的。
解決問題
分類:合併前與合併時
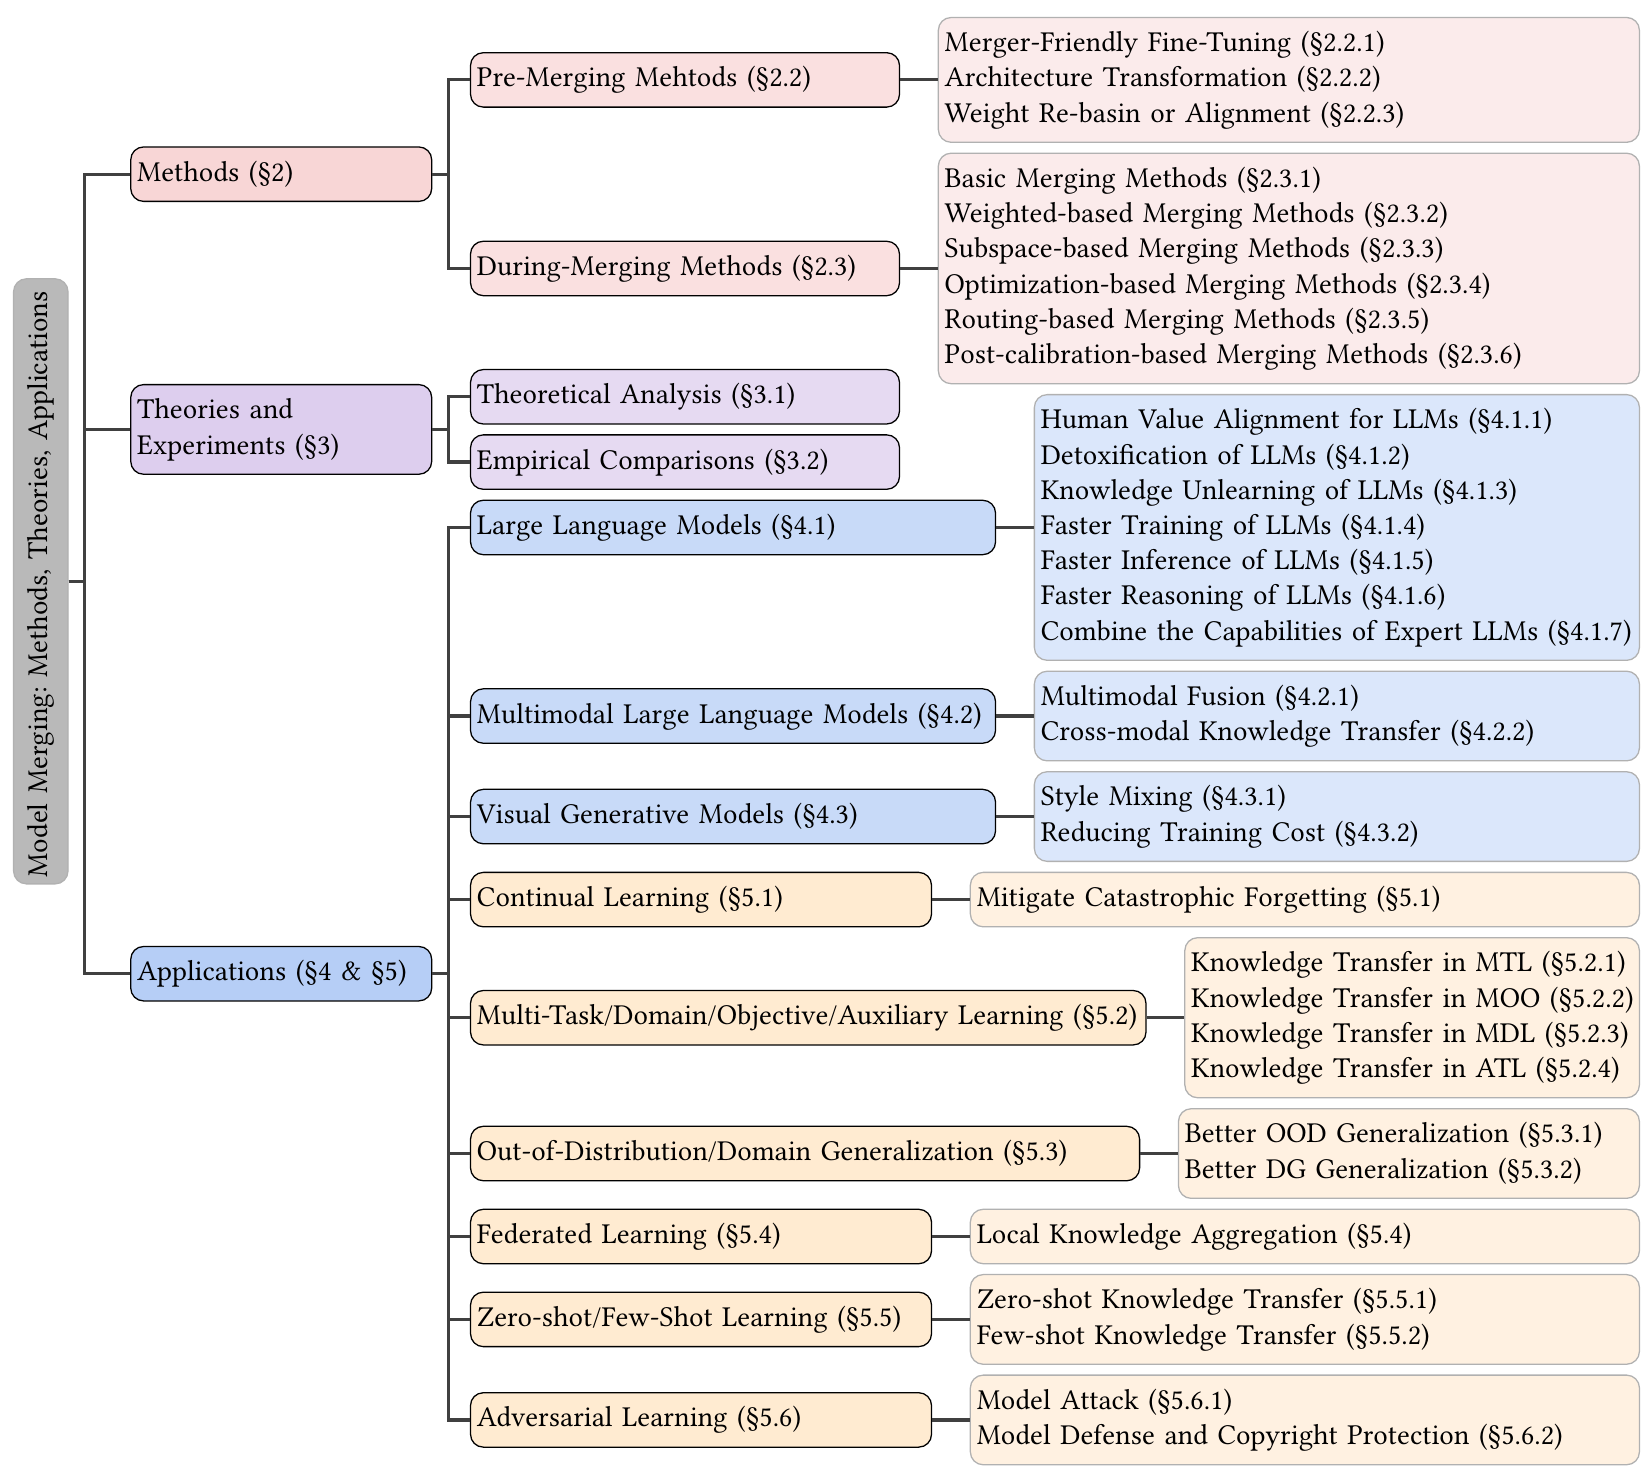
這張圖是整篇的目錄。上面的「方法」分成兩個時間點。
合併前(pre-merging),目的是替合併創造好的條件:
- 合併友善的微調:在微調階段就讓模型比較容易合併。代表是 切線空間的任務算術,在線性化的模型上微調,讓任務向量更解耦;後續工作只線性化部分層來降低成本,或用 sharpness-aware 最小化讓損失地形更平坦,也有只微調一小部分參數、減少彼此衝突的做法。
- 架構轉換:架構不同的模型沒辦法直接合參數,先用知識蒸餾或補層,把它們變成同一種架構。FuseLLM、FusionChat 屬於這類,代價是需要資料與訓練。
- 權重重新對齊:獨立訓練的模型先做神經元排列對齊,讓它們落在同一個盆地。Git Re-Basin、最佳傳輸對齊 OTFusion 都在這裡;作者也引用了 REPAIR 的觀察,對齊的成效和正規化層有很大關係。
合併時(during-merging),處理任務之間的衝突,分成六類:
- 基本方法:直接平均,或任務算術。
- 加權方法:替不同模型、不同層甚至不同參數決定權重。例如用演化演算法搜尋係數、AdaMerging 在無標註的測試資料上以熵為代理損失學習係數、RegMean 對線性層求閉式解、Fisher Merging 用 Fisher 資訊衡量參數重要性。SLERP 也被歸在這一類。
- 子空間方法:把任務向量投影到稀疏或低秩的子空間。稀疏的有 TIES-Merging、DARE、Model Breadcrumbs;低秩的有對任務向量做 SVD 的 TSV-M、ISO-C、KnOTS。
- 最佳化方法:利用任務向量本身的性質寫出不需資料的目標函數,例如讓任務向量更正交(AWD),或在線性層上建構免資料的損失(WUDI-Merging)。
- 路由方法:前面幾類合出來的是一個固定模型。路由方法則依輸入動態決定怎麼合,例如 WEMoE 讓線性層依路由網路加權合併。效果通常最好,代價是要保留額外參數,推論也變慢。
- 事後校正:合併後的模型,內部表示和各個專家差很多。Representation Surgery 等方法加一個小模組,把這個偏差修回來。
一張比較表的重點
作者把代表性方法依幾個維度排開比較,包括合併後的參數量、是否免調整、需要什麼資料、靜態還是動態,以及權重的粒度(全域、任務、層、參數)。排在一起比,有幾個取捨很明顯。
- 絕大多數方法合併後只有一個模型的參數量;路由與校正方法則大於一個,WEMoE 甚至遠大於一個。
- 粒度越細的加權方法通常越好,但多半需要額外的資料來估計權重,例如驗證集或無標註的測試集。
- 很多最佳化與低秩子空間方法標榜不需要資料。
作者的結論是,沒有一種方法適合所有情境,要依表現要求、實作難度、手上的資料與算力來選。
理論還很零碎
第三章整理了理論分析,依合併的模型來源分成三類。
- 同一條訓練軌跡:像 SWA、EMA,在最小平方迴歸等簡化設定下,有偏差與變異數的分解,也有凸與非凸情況的穩定性與泛化界。
- 同一任務、不同超參數:用線性模式連通與平坦極小值來解釋。從同一個預訓練模型出發、用不同設定微調的模型,通常線性連通。
- 不同任務:以 NTK 與權重解耦來解釋任務算術;也有研究把任務向量和梯度連起來,全批次梯度下降訓練一個 epoch 時,任務向量恰好等於學習率乘上負梯度。
作者坦白說,這三條理論各講一部分,多數建立在共同起點、寬網路或線性化的假設上,能不能套到大型語言模型上還沒驗證,也還沒有一個統一的框架。
討論
作者自己跑的比較
作者在綜述裡另外跑了一組比較實驗,涵蓋五種骨幹:CLIP 的 ViT-B/32 與 ViT-L/14 合併 8 個影像分類任務,RoBERTa-Large 合併 8 個 GLUE 任務,Llama-3.1-8B 合併 5 個文字生成任務,InternVL-2.5 合併 5 個多模態任務。
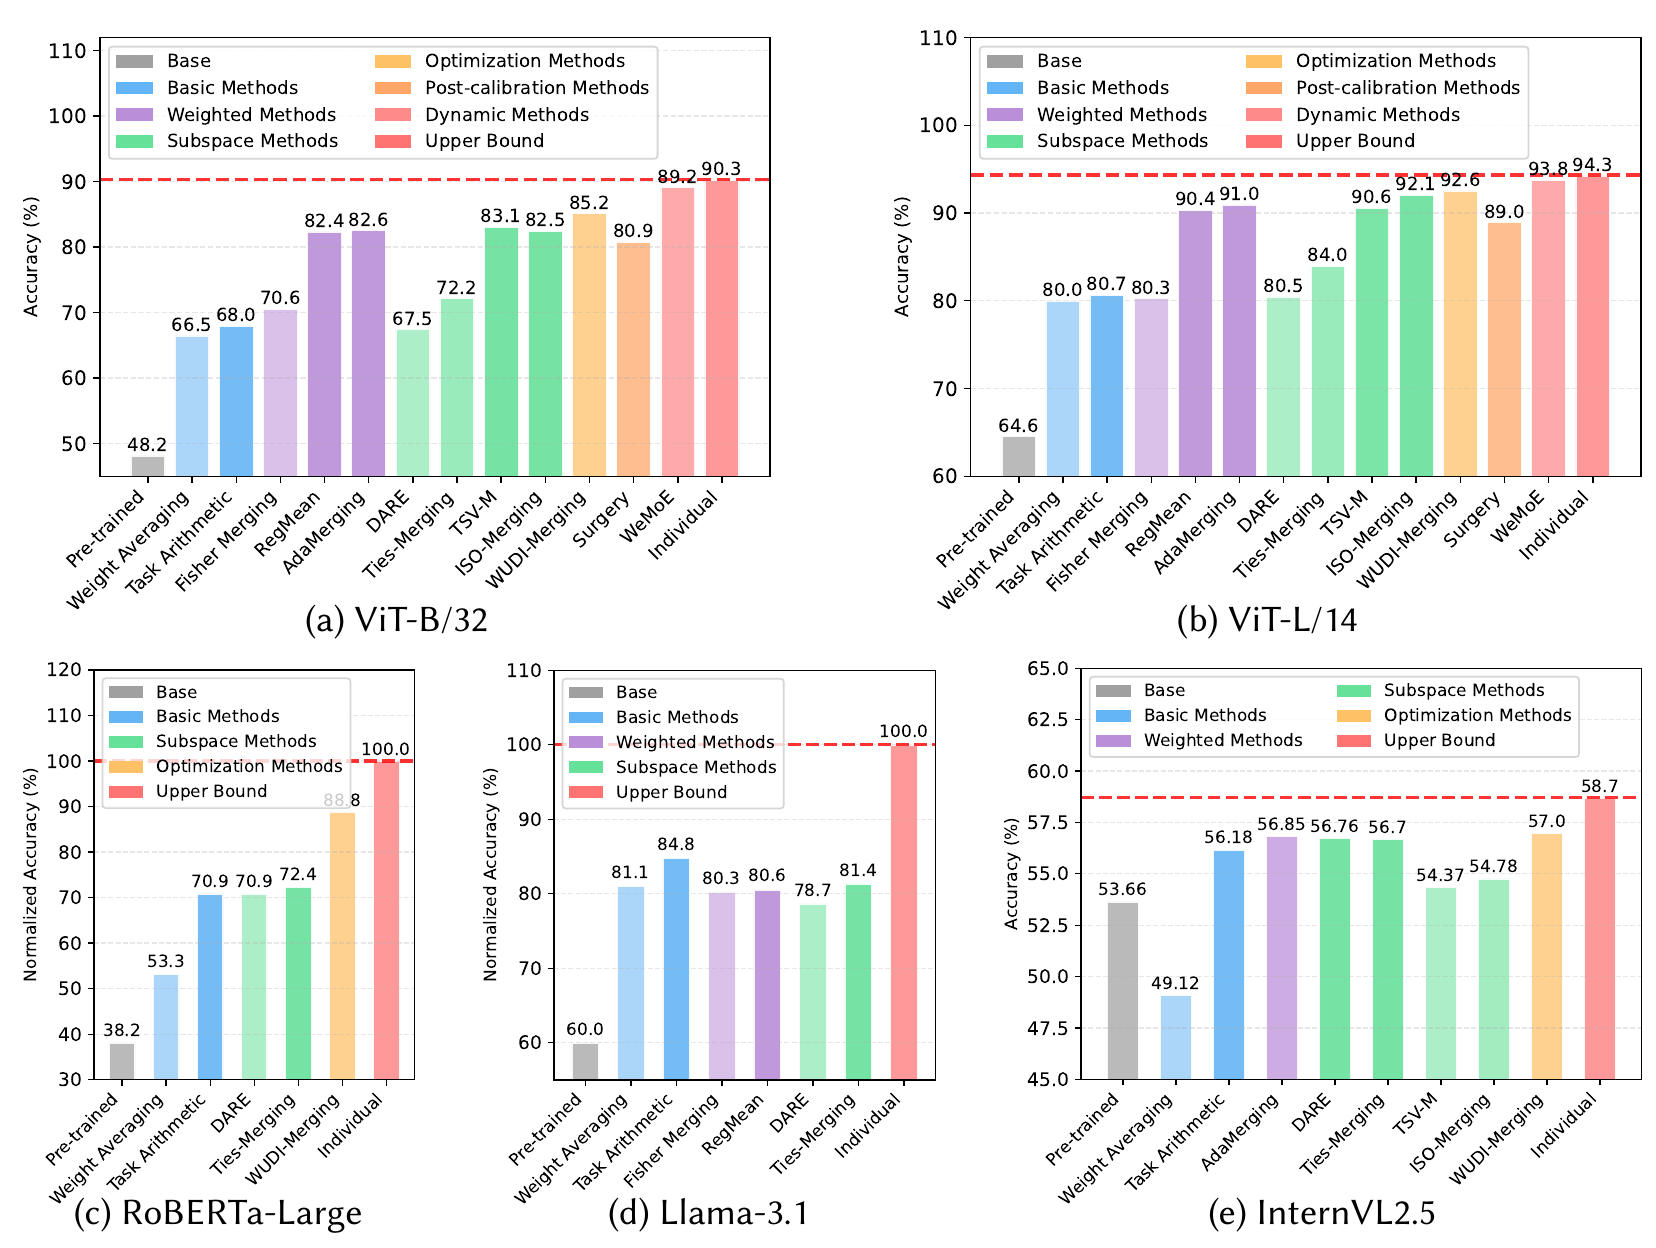
每張圖最左邊的灰色是預訓練模型,最右邊的紅色是每個任務各自微調的模型,也就是上界。中間各種顏色的方法,越接近紅色虛線越好。
先看 ViT-B/32。直接平均只有 66.5,離上界 90.3 很遠;加權與低秩子空間方法拉到 82 到 83;免資料的 WUDI-Merging 是 85.2;需要額外參數的路由方法 WEMoE 達到 89.2,幾乎追上上界。ViT-L/14 上所有方法都好很多,WEMoE 是 93.8,上界 94.3,大模型比較好合,這和 大了就好合 的觀察一致。
再看 Llama-3.1,結果就很不一樣了。任務算術以 84.8 排第一,Fisher Merging、RegMean、DARE、TIES 都在 78.7 到 81.4 之間,比任務算術還差,也只略高於或低於直接平均的 81.1;離上界 100 還差十幾分。在視覺任務上明顯勝出的「進階」方法,到了語言模型的生成任務上並沒有優勢。
InternVL2.5 上,直接平均的 49.12 甚至低於預訓練模型的 53.66,合併反而讓模型變差。各方法間的差距只有一兩分,最好的 WUDI-Merging 是 57.0,上界 58.7。
這組比較是讀這篇綜述最有價值的地方之一。不少合併方法是在 CLIP 的八個分類任務上開發、調整出來的,換到 LLM 和多模態模型上,排名會重新洗牌。挑方法之前,最好在自己的模型和任務上重新比過一輪。
大型語言模型上的七種用途
第四章列出模型合併在 LLM 上的應用,有幾個方向和站內其他筆記相關。
- 對齊人類偏好:分別訓練符合不同偏好的模型,再依使用者需要合併。
- 去毒:用減去任務向量的方式移除有毒或不實的輸出。
- 遺忘:同樣用減法移除特定知識,例如誤學的受版權保護內容,免去從頭重訓的成本。
- 加速訓練:在預訓練中平均 checkpoint。作者把 PMA 與 WSM 都歸在這裡,兩者都把 checkpoint 平均當成學習率衰減的替代。
- 加速 MoE 推論:先合併專家參數再計算,減少要算的專家數量。
- 加速推理:把長思考的推理模型和回答簡短的一般模型合併,縮短輸出。作者引用的例子中,任務算術與 TIES 能在 7B 模型上把推理長度減少約一半,準確率大致不變。
- 合併專家能力:把不同領域的專家模型合成一個通用模型。
至於技術報告中的實際使用,這篇綜述談得不多。Llama 3、Tülu 3、Command A 等報告把合併寫進正式訓練流程的細節,要回到各自的報告去看。
還沒解決的問題
最後一章列出七個方向,前幾個最實際。
- 和獨立模型的差距:合併仍高度依賴「同一個預訓練模型、小心控制微調的學習率與步數」這個前提。就算如此,任務一多,差距就很明顯,例如 Llama-3.1 上最好的方法 84.8,上界是 100。
- 理論:不同任務、從頭訓練的模型合併,幾乎沒有理論說明。
- 可信度:模型擁有者想保護自己的模型不被合併,合併者則要防止有人在模型裡藏後門。
- 效率:高表現的方法通常要把所有模型同時載入記憶體,例如合併 72 個微調過的 ViT-B/32 就需要超過 200GB;搜尋係數也要反覆評估。
- 異質模型:架構不同的模型,目前只能先蒸餾成同一個架構,成本很高。
怎麼讀這篇綜述
這是一篇範圍很廣的綜述,第五章還涵蓋了持續學習、多任務學習、分布外泛化、聯邦學習、少樣本學習、對抗攻擊等十多個子領域,每一類通常只用一兩段話帶過。
用來做什麼比較合適?它的分類可以當成地圖:遇到一個新的合併方法,先找出它屬於合併前還是合併時、需要什麼資料、是靜態還是動態,就大致知道它在解決什麼問題、要付出什麼代價。具體方法的細節與實驗條件,還是要回到原論文核對。
結論
這篇綜述用「合併前」與「合併時」兩個階段,把散落的合併方法整理成一張清楚的地圖,並補上理論、應用與挑戰。
讀完最值得帶走的,是作者自己的那組比較。在 CLIP 上表現很好的進階方法,到了 Llama-3.1 上不一定贏得過最簡單的任務算術。
方法很多,先拿任務算術當基準比過再說。