原始論文
Language Models are Super Mario: Absorbing Abilities from Homologous Models as a Free Lunch
- 發表版本
- ICML 2024會議
- arXiv 首次提交
- arXiv:2311.03099
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingdare2023,
  title = {{Language Models are Super Mario: Absorbing Abilities from Homologous Models as a Free Lunch}},
  author = {Le Yu and Bowen Yu and Haiyang Yu and Fei Huang and Yongbin Li},
  year = {2023},
  eprint = {2311.03099},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2311.03099}
}
2023 年下半年,Hugging Face 上已經有大量從同一個 Llama 2 微調出來的模型。WizardLM 擅長遵循指令,WizardMath 擅長數學,還有各種寫程式的版本。
想要一個同時會這些事的模型,最直接的辦法是把資料湊在一起重新微調。可是很多模型只公開權重,訓練資料拿不到;就算拿得到,13B、70B 的模型重新訓練也不便宜。
阿里巴巴的 Le Yu、Bowen Yu、Haiyang Yu、Fei Huang 與 Yongbin Li 把這件事比喻成超級瑪利歐吃道具。模型能不能直接「吸收」同源模型的能力,不用重新訓練,連 GPU 都不用?
這篇論文先回答了一個更基本的問題,微調到底改了多少權重。
定義問題
令 是預訓練權重, 是在任務 上做監督式微調(SFT)後的權重,兩者的差稱為 delta 參數:
這就是任務算術裡的任務向量。合併多個模型時,TIES-Merging 已經指出,很多 delta 參數是冗餘的,會稀釋其他模型的重要變化;它的做法是依絕對值修剪,只留最大的 20%。
作者的觀察更激進。他們量了好幾個語言模型的 delta 參數,SFT 前後的差值大多在 0.002 以內,冗餘得非常厲害。如果把絕大部分直接丟掉,模型還能不能用?
解決問題
丟掉,再放大
DARE 的名字就是做法,Drop And REscale。
每個 delta 參數以機率 被歸零,留下來的乘上 。最後 。
這裡的丟棄是隨機的,不看大小。這一點和 TIES 或一般剪枝都不同。
為什麼要放大
看一個線性層。輸入是 ,預訓練權重 、偏差 ,delta 是 、。第 個輸出是
DARE 只動 delta 的部分。每個 有 的機率被留下並乘上 ,有 的機率變成 0,所以 delta 那一項的期望值是
取 ,期望值就回到原本的 。這個等式針對固定輸入的單一線性層;網路後面還有非線性,而且前層的隨機改動也會影響下一層的輸入,整個模型需要另外量測。
作者把這段推導稱為「粗略的證明」。期望值不變,不保證單次抽樣的誤差小;實際能丟多少,還得看實驗。
用兩個 delta 值看一次就知道。下面把 的四種等機率遮罩全部列出,沒有真的訓練網路:
import numpy as np
from itertools import product

delta = np.array([0.001, 0.002])
x = np.array([1., 2.])
p = 0.5
outputs = []
for dropped in product([0, 1], repeat=2):
    kept_delta = (1 - np.array(dropped)) * delta / (1 - p)
    outputs.append(float(kept_delta @ x))
print("各遮罩的 delta 輸出:", np.round(outputs, 6).tolist())
print(f"原本: {delta @ x:.6f}, 遮罩平均: {np.mean(outputs):.6f}")
各遮罩的 delta 輸出: [0.01, 0.002, 0.008, 0.0]
原本: 0.005000, 遮罩平均: 0.005000
四種結果平均起來正確,單獨挑一種卻可能是 0,也可能是原來的兩倍。DARE 在產生模型時只抽一次遮罩,部署後不會每次重新抽、更不會把四個模型全部跑完。因此要解釋能否保住能力,還得看隨機擾動的大小。
沿這個例子再推一小步。對某個固定 delta 值 ,DARE 後的變異數是
這是對伯努利遮罩的直接計算。 時倍率是 9, 時是 99;delta 越大、丟棄率越高,單次擾動越難壓低。對輸入固定、遮罩獨立的線性層,輸出擾動的變異數會累加各項 。這個計算有助理解後面的失敗案例,模型大小與可容忍 的關係仍要由實驗決定。
當成合併的前處理
DARE 本身不負責合併。它像一個外掛,先把每個要合併的模型都 DARE 一次,再交給現有的合併方法。以任務算術為例:
想法是,每個模型只剩一小部分非零的 delta,彼此重疊的位置變少,合併時的干擾也就少了。
若兩個模型的遮罩獨立,每一格同時保留下來的機率是 。 時,原本兩個 delta 都可能修改的座標,只剩約 1% 會一起存活。這說明稀疏化如何減少直接重疊;留下的值同時被放大十倍,所以合併品質仍要把重疊、尺度與來源模型能力一起看。
討論
能丟多少
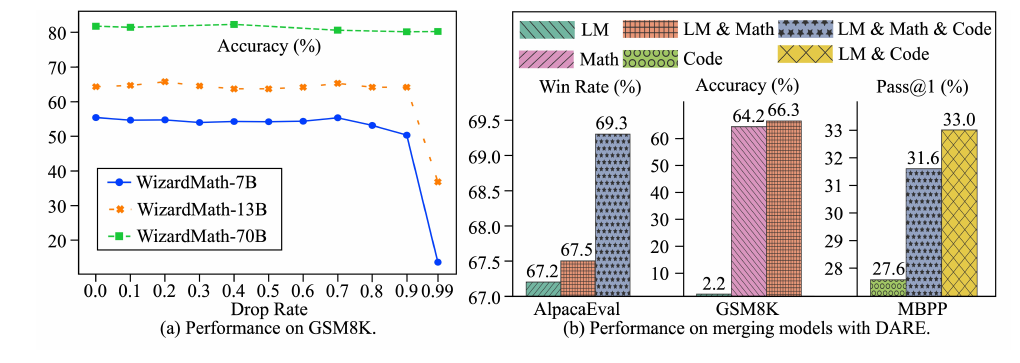
左圖是丟棄率對 WizardMath 的影響。三個大小的模型,丟到 90% 都還幾乎沒變;丟到 99%,7B 和 13B 撐不住了,70B 仍然維持。
作者由此歸納出兩點。SFT 模型的 delta 參數冗餘到可以丟掉 90% 甚至 99%;模型越大,能容忍的丟棄率越高。encoder 類的 BERT、RoBERTa 在 GLUE 上也看得到同樣的趨勢,丟到 0.9 之後才明顯下滑。
作者掃的是 。Decoder 的指令遵循用 AlpacaEval win rate,數學用 GSM8K、MATH 準確率,程式用 HumanEval、MBPP 的 pass@1;生成用 greedy decoding。Encoder 則是 BERT-base 與 RoBERTa-base 的八個 GLUE 任務,依任務分別量準確率、F1、相關係數等。各張圖的「維持表現」要對應自己的指標,WizardMath-70B 在 GSM8K 的高容忍度也不能直接搬到所有專家上。
GLUE 的原始訓練集另切 10% 做驗證,官方 validation 當測試。這使 drop rate 可以用保留資料選;最極端的 99% 是展示可達到的案例,使用時可以先從較低丟棄率開始掃。
合併三個 13B 模型
作者合併了三個都從 Llama-2-13b 微調出來的模型,WizardLM-13B(LM,指令遵循)、WizardMath-13B(Math,數學)與 llama-2-13b-code-alpaca(Code,程式)。WizardCoder-Python-13B 沒有選,因為它是從 CodeLlama-13b-Python 微調的,基底不同。
| 模型 | DARE | AlpacaEval | GSM8K | HumanEval | MBPP |
|---|---|---|---|---|---|
| LM | – | 67.20 | 2.20 | 36.59 | 34.00 |
| Math | – | – | 64.22 | – | – |
| 任務算術:LM + Math | 否 | 67.04 | 66.34 | 28.66 | 30.60 |
| 任務算術:LM + Math | 是 | 67.45 | 66.26 | 26.83 | 32.40 |
| TIES:LM + Math | 否 | 68.63 | 15.77 | 37.80 | 35.60 |
| TIES:LM + Math | 是 | 68.70 | 36.16 | 36.59 | 37.00 |
| 任務算術:LM + Math + Code | 否 | 69.03 | 58.45 | 18.29 | 29.80 |
| 任務算術:LM + Math + Code | 是 | 69.28 | 56.48 | 23.17 | 31.60 |
部分數字整理自原論文 Table 1。「–」表示該模型不評這一項。
最醒目的是第一列到第三列。WizardLM 在 GSM8K 上只有 2.20,和 WizardMath 用任務算術合併之後是 66.34,比 WizardMath 本身的 64.22 還高。這個合併其實不靠 DARE 也做得到;加上 DARE,GSM8K 是 66.26,差不多。
DARE 幫得最明顯的是 TIES。TIES 先依絕對值修剪,在這組模型上反而把數學能力剪壞了,GSM8K 只剩 15.77;先 DARE 再 TIES,回到 36.16。作者的解釋是,DARE 之後大部分 delta 已經是 0,TIES 修剪時剪掉的就只是這些 0,不會再傷到有用的值。
這組 TIES 也和原始論文的固定配方不同。DARE 論文在 decoder 實驗的保留比例搜尋 0.5、0.7、0.9,縮放係數在 0.5、1.0 裡選,然後比較有無 DARE。它支持這些來源模型與搜尋設定下的改善,不能只拿 15.77 反推 TIES 在其他任務的效果。
DARE 也不是每一格都幫上忙。三個模型合併時,GSM8K 從 58.45 降到 56.48;在 encoder 類模型上,DARE 搭配五種合併方法的平均進步只有 −0.03% 到 0.84%,合併模型也常常比不上單一的專家。
作者還注意到,llama-2-13b-code-alpaca 在程式能力上比 WizardLM-13B 還差。他們的結論是,合併的前提是每個來源模型本身都要訓練得夠好。
放大是必要的
為了確認放大的作用,作者做了一個只丟不放大的對照 DropOnly,逐層比較原模型和處理後的模型,在同樣輸入下的隱藏表示有多相似。
下圖左邊是 WizardMath-7B 的 GSM8K 輸入,右邊是 BERT 的 CoLA 輸入。橫軸往後走一層,縱軸量該層與原模型表示的平均餘弦相似度;相同丟棄率的 DARE 與 DropOnly 要配對看。
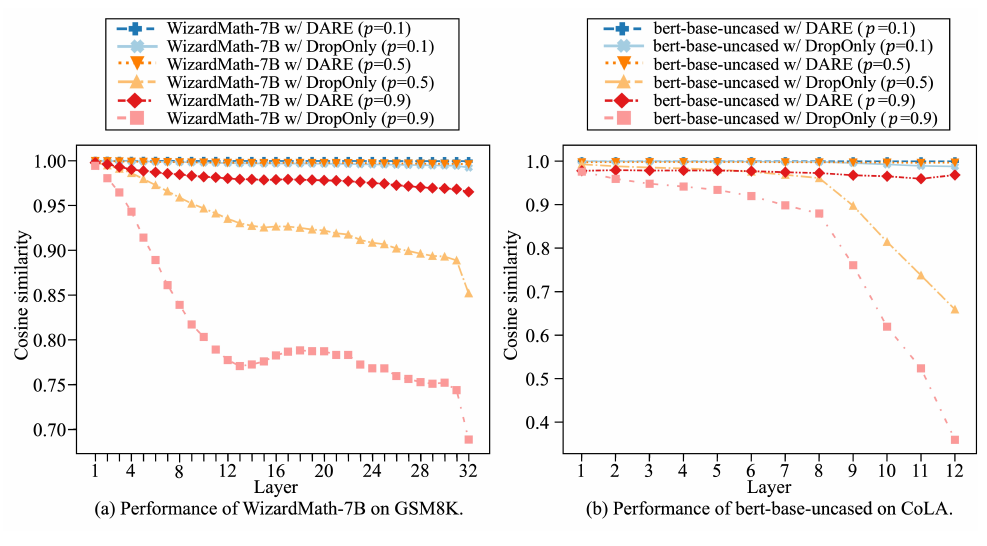
DARE 丟掉 90% 時,每一層的餘弦相似度都還在 0.95 以上。DropOnly 只有在 時撐得住;WizardMath-7B 上, 時降到約 0.85, 時約 0.68。表現也一樣,丟得越多,DropOnly 和 DARE 的差距越大。
另一個對照是依絕對值剪枝(magnitude pruning,MP)再放大。在 7B 模型上丟 70%,MP 的 AlpacaEval 從 43.85 掉到 10.61,GSM8K 從 46.70 掉到 0.37,HumanEval 從 21.34 掉到 3.05。作者認為,留下的都是大的值,再放大,輸出就失控了。
什麼時候不能用
DARE 的前提是 delta 很小。作者刻意做了一個失敗的例子,把 WizardCoder-Python-13B 的基底,從實際的 CodeLlama-13b-Python 換成 Llama-2-13b 來算 delta。CodeLlama 在 Llama 2 之上又多訓練了 5,000 億個程式相關的 token,參數已經走得很遠;這樣算出來的 delta,絕對值常常超過 0.01,相對 CodeLlama-13b-Python 卻在 0.0002 以內。
結果只丟 10%,HumanEval 和 MBPP 的 pass@1 就從 63.41 和 55.4 掉到 0。持續預訓練後的模型,delta 可以到 0.03 左右,DARE 就不適用了。
0.002 是這批模型的觀察範圍,並非跨架構通用的安全門檻。參數尺度會隨模型與層而變,輸入也會放大輸出擾動;真正可用的檢查是先對正確基底算差值分布,再看不同 的保留曲線。只確認模型都是「13B」或張量形狀一致,還沒確認它們共享同一份基底。
作者也提到,丟掉的若是微調後的完整權重,而不是 delta,只丟 10% 就會讓表現掉到接近零。他們的解讀是,SFT 主要是在喚醒預訓練模型原本的能力,而不是加進全新的能力。
工程上還要分清楚稀疏 delta 和小模型。重建後的權重是 ,基底仍是完整的 dense 模型;丟掉九成差值,推論所需參數量和矩陣乘法沒有自動少九成。若保存成「共用基底加稀疏差值」,可能節省多版本儲存,還需要對應的檔案格式與載入方式。論文主要展示的是能力保留與合併,沒有把 70B 網路壓成 0.7B 網路。
登上排行榜
最後,作者用 DARE 合併了幾個以 Mistral-7B 為基底的模型,做出 supermario v1 和 v2。到 2024 年 1 月 28 日,supermario v2 在 Open LLM Leaderboard 的 7B 級排名第一,平均 75.49。
表格裡和它並列的 Beagle14-7B、NeuralBeagle14-7B,模型卡上也標著用 mergekit 合併。那一陣子的 7B 排行榜,前排擠滿了合併模型,它們的分數也開始引來資料污染的疑慮。
結論
DARE 的發現比方法本身更有意思。SFT 改動的權重非常小,大部分隨機丟掉、剩下的放大,模型照樣能用;模型越大,能丟的越多。
當作合併的前處理,它常常能減少干擾,特別是搭配 TIES 時;但幫助有時只有零點幾個百分點,偶爾還會倒退。
如果你要拿它來合併,先確認每個模型的 delta 是對著實際的基底算的。基底一換錯,丟掉一成就什麼都不剩了。