原始論文
Git Re-Basin: Merging Models modulo Permutation Symmetries
- 發表版本
- ICLR 2023會議
- arXiv 首次提交
- arXiv:2209.04836
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmerginggitrebasin2022,
  title = {{Git Re-Basin: Merging Models modulo Permutation Symmetries}},
  author = {Samuel K. Ainsworth and Jonathan Hayase and Siddhartha Srinivasa},
  year = {2022},
  eprint = {2209.04836},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2209.04836}
}
隱藏層裡的單元沒有固定的順序。把第 3 號和第 7 號單元對調,只要下一層讀取輸入的位置也跟著對調,網路算出來的東西一模一樣。
這種排列的對稱性,Hecht-Nielsen 在 1990 年就討論過。它意味著同一個函數有大量不同的權重寫法。論文算了幾個常見架構的數量:
| 架構 | 隱藏單元的排列方式 |
|---|---|
| 三層 MLP,寬度 512 | |
| VGG16 | |
| ResNet50 | |
| 可觀測宇宙的原子數上限 |
整理自原論文 Table 1。
兩個從不同隨機初始化訓練出來的網路,直線混合時中間會冒出一道高牆,這件事大家早就知道。2021 年,Entezari 等人提出一個大膽的猜想,如果把排列的可能都考慮進去,SGD 找到的解之間,大多數沿直線混合都不會有障礙。換句話說,損失地形在「不計排列」的意義下,可能只有一個盆地。
華盛頓大學的 Samuel Ainsworth、Jonathan Hayase 與 Siddhartha Srinivasa 想把這個猜想變成能用的工具。給定兩個獨立訓練的模型,能不能找到一個排列,把其中一個「搬」進另一個的盆地,再直接平均?
定義問題
衡量的方式沿用 Frankle 等人的損失障礙(loss barrier):
沿線最高的損失,減去兩端損失的平均。等於 0,代表這條直線上沒有隆起。
目標是找一個保持功能不變的排列 ,讓 和 之間的障礙盡量小。對第 層,排列用一個置換矩陣 表示,模型 B 的權重換成
調換第 層輸出單元的順序, 讓這一層讀取輸入的順序,跟著上一層的換位一起變。
輸入與輸出的位置有語意,所以兩端固定。影像的 RGB 通道、分類器的類別順序,都不能為了讓權重接近就任意交換。可動的是網路內部的隱藏維度,而且同一維度經過的偏置、正規化參數、分支連接都要一起換。殘差相加的兩條路徑必須使用相容的排列,不能逐層各自亂排。
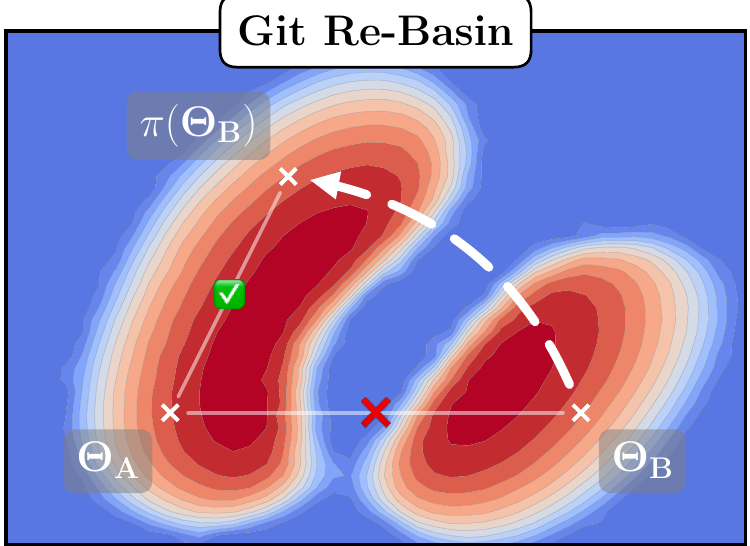
這張示意圖就是整篇的目標。 和 在不同的谷裡,直線中點掉出谷外;把 換成功能完全相同的 ,它就跑到 所在的谷,兩者的中點也落在谷裡。
解決問題
作者提出三種找排列的方法。
比對激活值
第一種最直覺。兩個模型要解同一個任務,大概會學到相似的特徵,只是位置不同。把訓練資料餵進兩個模型,收集第 層的激活值 ,找一個置換矩陣讓兩者最接近:
右邊這個形式是經典的線性指派問題(linear assignment problem),有多項式時間的解法,例如匈牙利演算法。每一層各自獨立解,跑一遍資料就夠。
比對權重
第二種完全不看資料,只看權重本身。
第一層權重的每一列,就是一個單元在看什麼。如果 A 的第 列和 B 的第 列很像,這兩個單元大概在算同一個特徵。拿三個單元、四個輸入的小例子算一次:
import numpy as np
from scipy.optimize import linear_sum_assignment

# 模型 A 第一層的三個單元,各有 4 個輸入權重
W_A = np.array([[ 1.0, -0.5,  0.2,  0.0],
                [ 0.1,  0.9, -0.8,  0.3],
                [-0.6,  0.0,  0.4,  1.1]])

# 模型 B 學到差不多的三個單元,只是順序換成 (A 的第 2, 0, 1 個),數值也略有不同
W_B = np.array([[-0.5,  0.1,  0.5,  1.0],
                [ 0.9, -0.4,  0.1, -0.1],
                [ 0.2,  1.0, -0.7,  0.2]])

S = W_A @ W_B.T                       # S[i, j]:A 的單元 i 和 B 的單元 j 有多像
print(S.round(2))
rows, cols = linear_sum_assignment(S, maximize=True)
print("A 的單元 i 配到 B 的單元", cols)
[[-0.45  1.12 -0.44]
 [-0.06 -0.38  1.54]
 [ 1.6  -0.61 -0.18]]
A 的單元 i 配到 B 的單元 [1 2 0]
相似度矩陣每一列最大的值,剛好指向正確的對應。A 的第 0 個單元配到 B 的第 1 個,第 1 個配到第 2 個,第 2 個配到第 0 個。這個例子的答案一眼就看得出來;真實網路有幾百個單元,相似度也沒有這麼分明,就交給指派演算法一次找出總和最大的配對。
找到排列後,還要把它套對。接一個輸出層,檢查模型 B 換位前後算出的值:
W_out = np.array([[1., -2., 0.5], [0.3, 0.4, -0.7]])
x = np.array([0.2, -0.1, 0.5, 1.0])
before = W_out @ np.maximum(W_B @ x, 0)
W_B_aligned = W_B[cols, :]       # 隱藏層換列
W_out_aligned = W_out[:, cols]  # 下一層的輸入換欄
after = W_out_aligned @ np.maximum(W_B_aligned @ x, 0)
print("換位前後功能相同:", np.allclose(before, after))
換位前後功能相同: True
這一步還沒平均模型,只把 B 換成等價寫法。對齊本身應保持 B 的輸出;接下來和 A 平均,才會改變網路的函數。分開檢查這兩步,可以避免把排列套錯和平均效果不好混為一談。
麻煩在於層與層會互相牽動。一個隱藏單元的身分,既由它的輸入權重決定,也由它送往下一層的權重決定;改了第 層的排列,第 層的輸入順序也得跟著改。把所有層合起來,目標是
作者證明這個「雙線性指派之和」是 NP-hard,三層以上連常數倍的近似都沒有多項式時間的方法。
他們的折衷是座標下降。固定其他層,只看 ,問題就退化成一個普通的線性指派問題:
括號裡第一項比的是輸入端(已經照上一層排好),第二項比的是輸出端(已經照下一層排好)。以隨機順序輪流更新每一層,直到排列不再改變。作者說實際上幾秒到幾分鐘就收斂。
每次只接受讓整體內積提高的排列,可能排列又只有有限多個,因此程序會停止。但目標是讓權重接近,沒有直接最小化資料上的損失,而且停止點只是座標更新找不到改進的位置。作者在 ImageNet 的對照中特別限制只掃一遍,合併模型的 top-1 準確率約只有 7%;反覆掃到收斂則是 51.01%。前一層排好就再也不回頭,會漏掉後面各層提供的資訊。
用直通估計器學排列
第三種直接把排列當成可學的東西,最小化 和投影後的 平均之後的損失。投影到最近的排列這一步不可微分,就用直通估計器(straight-through estimator)處理,前向傳播用投影後的權重,反向傳播時當作沒有投影。
這個方法效果最好,但要跑一整個訓練迴圈,成本高得多。
更精確地說,優化器保存一份可自由改動的 。每次前向,先從 B 的所有等價排列中找最接近它的 ,再算 的訓練損失。投影仍沿用權重比對;反向時把投影近似成恆等映射,讓梯度能回到 。最後交付的是原模型 B 的某個排列,所以 B 端點的函數依然不變。
| 對齊法 | 用到資料嗎? | 最佳化什麼? | 主要代價 |
|---|---|---|---|
| Activation matching | 要,收集中間表示 | 各層啟動值的匹配程度 | 前向資料與各層指派 |
| Weight matching | 不用 | 全網路權重內積 | 重複解逐層指派 |
| STE matching | 要,計算合併損失 | 中點模型的訓練損失 | 訓練迴圈加上反覆投影 |
資料相同、架構相容時,可以選 activation 或 STE;原訓練資料無法取得時,weight matching 仍能運作。代價最小的選項,也是論文後面拿來合併分開訓練模型的工具。
討論
排好之後,直線就通了
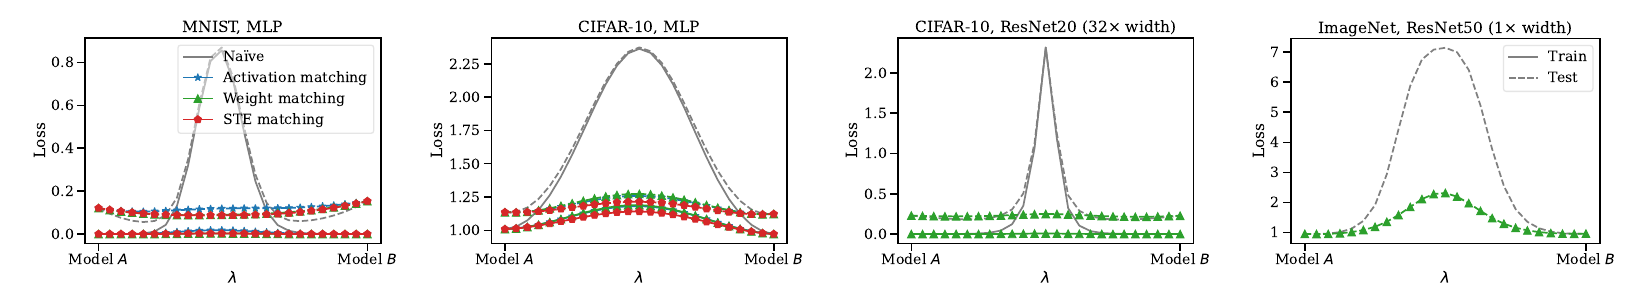
四張圖從左到右,資料與模型越來越難。灰線是直接插值,每張圖的中間都有一座山;三種排列方法都把山壓低了。
MNIST 上,三種方法都做到零障礙;用權重比對和直通估計器時,測試損失的曲線甚至變成凸的,中間的混合模型比 A、B 都好。CIFAR-10 上,把 ResNet20 加寬到 32 倍後也是零障礙,作者說這是他們所知第一次在 ResNet 上做到。ImageNet 上的 ResNet50 還有一個小山丘,障礙比直接插值少了 67%,沒有歸零。
三種方法的差距不大。直通估計器最好但最貴;權重比對完全不用資料,只花幾秒,卻和需要資料的激活比對差不多。作者認為它在成本和效果之間取得了很好的平衡。
這幾組實驗還有容易漏看的架構差異。MLP 有三個各 512 單元的隱藏層、ReLU、沒有正規化;CIFAR 的 VGG 與 ResNet20 則把正規化換成 LayerNorm,加上裁切、旋轉與翻轉,用 momentum SGD 訓練。ImageNet 的 ResNet50 才保留標準 BatchNorm,而且每個插值模型都重算 BatchNorm 統計量。直接拿標準 BatchNorm 的 CIFAR 模型照做,量到的曲線可能會不同。
67% 是損失障礙的相對降幅,和準確率增加 67 個百分點是兩回事。前面提到 ImageNet 合併中點的 51.01% top-1,也顯示障礙大幅降低後,中間模型仍可能遠弱於兩個端點。這裡的主要成果,是說明哪些條件下能找到低障礙排列,尚未把獨立 ImageNet 模型的無損合併解完。
越寬越好連
為什麼 ImageNet 沒有歸零?作者懷疑是寬度不夠。
他們在 CIFAR-10 上把 VGG-16 和 ResNet20 的寬度逐步加大,再做權重比對。標準寬度的模型看不到線性連通;寬度一加大,障礙一路降到 0。作者的假設是,模型需要足夠的容量(特別是寬度)去容納資料的複雜度,線性連通才會出現。
這也表示,窄的模型要嘛是排列找得不夠好,要嘛還有排列以外的對稱性沒被考慮,例如跨層的縮放。作者在討論裡把排列對稱性定位成「必要、但不完整」的一塊。
訓練出來的,不是一開始就有
另一個觀察是,線性連通是訓練過程中慢慢出現的。作者在 MNIST 和 CIFAR-10 的 MLP 上,每個 epoch 都做一次比對再量障礙,訓練初期障礙很高,之後才逐漸下降。
他們也構造了一個反例。有一些不是用 SGD 找到的解,不管怎麼排列,都無法和其他解線性連通。這不違反 Entezari 的猜想,猜想本來就只談 SGD 的解;但它暗示,能找到線性連通,部分要歸功於 SGD 本身的偏好。
反例只有兩維輸入、兩個各含兩單元的隱藏層。兩個模型都完美解出同一個分類問題,但把「判斷第一維」和「判斷第二維」放在不同層;只在各層內換單元,無法把跨層的分工搬過去。小網路的全部排列都能列舉,作者逐一檢查後仍有障礙。這比單純搜尋沒找到排列更有力,也說明可用的對稱性不只單元換位。
分開訓練,合在一起
最後一個實驗最接近實際用途。作者把 CIFAR-100 切成兩半,資料集 A 有 0 到 49 類的 20% 和 50 到 99 類的 80%,資料集 B 反過來,各訓練一個 ResNet20。
用權重比對合併兩者,合併模型在整個測試集上的損失比 A、B 都低,記憶體和計算量只有集成的一半,機率估計的校準也比兩個原始模型好。它仍然比不上用全部資料訓練的模型,也比不上兩個模型的集成;直接插值則差得多。
這兩份訓練資料互不重疊,但兩個模型都看得到全部 100 個類別,只是比例相反。分類頭的輸出語意因此能保持一致。結果改善的是交叉熵與機率校準,分類準確率沒有同時超過兩個原始模型。若把實驗簡化成「不同資料各練一個,合起來全面更好」,就會遺失這項取捨。
附錄另做了多模型版本。每次把一個模型對齊到其餘模型的平均,輪流更新,再取全體平均;32 個各看一半 MNIST 資料的 MLP,合併後校準接近輸出集成,推論只保留一個。這提供了雙模型以外的示例,規模與資料難度仍和現代大型語言模型有一段距離。
結論
Git Re-Basin 把「不同初始化的模型不能平均」這件事,改寫成「先排好座位,再平均」。權重比對不需要任何資料,幾秒就能跑完,在夠寬的網路上可以把障礙壓到零。
它也劃出了邊界。網路要夠寬,ImageNet 上的標準 ResNet50 還做不到零障礙。後來的 REPAIR 發現,對齊後的平均模型,激活值的變異數會塌縮,重新縮放之後,ImageNet 上的障礙又能再降一截。
後來常見的大型語言模型合併,多從同一份預訓練 checkpoint 的微調版本出發,先沿用共同的參數座標。若手上是獨立訓練的模型,就得先處理這篇提出的對齊問題,再檢查合併後的功能能保留多少。