原始論文
What Matters for Model Merging at Scale?
- arXiv 首次提交
- arXiv:2410.03617
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingmergingatscale2024,
  title = {{What Matters for Model Merging at Scale?}},
  author = {Prateek Yadav and Tu Vu and Jonathan Lai and Alexandra Chronopoulou and Manaal Faruqui and Mohit Bansal and Tsendsuren Munkhdalai},
  year = {2024},
  eprint = {2410.03617},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2410.03617}
}
早期模型合併研究常圍繞 CLIP、ViT、T5、BERT 等模型,個別實驗會用到更大的視覺模型或語言模型;像 DARE 已經測過 7B、13B 專家的合併。但基底品質、參數規模、專家數量和合併方法,往往沒有放進同一套實驗逐項比較。小設定下最好用的技巧,放大後仍然重要嗎?
可是 2024 年,合併已經出現在大模型的訓練流程裡。論文提到,Llama 3 和 Gemma 2 的技術報告都寫了模型合併。小模型上得到的結論,放大之後還成立嗎?
UNC 的 Prateek Yadav(TIES-Merging 的第一作者)在 Google 實習期間,和 Google、Virginia Tech 的 Tu Vu、Jonathan Lai、Alexandra Chronopoulou、Manaal Faruqui、Tsendsuren Munkhdalai,以及 UNC 的 Mohit Bansal,用 PaLM-2 做了一次系統化的測試,最大到 640 億參數。
定義問題
作者想回答四個問題:
- 從純預訓練的模型、還是從指令微調過的模型出發做專家,哪一種比較好合併?
- 模型越大,合併越容易還是越難?
- 合併會怎麼影響模型在沒看過的任務上的零樣本能力?
- 能合併幾個專家而不明顯掉分?這和模型大小有什麼關係?
解決問題
實驗設計
這篇沒有提出新方法,篇幅都花在實驗設計上。
基底模型:PaLM-2 與它的指令微調版本 PaLM-2-IT,大小有 1B、8B、24B、64B 四種。
專家:從 T0 的資料集合挑出八類任務當作「held-in」,每一類全參數微調出一個專家。另外保留一批沒有用來訓練的「held-out」任務,測零樣本泛化。
合併:每次合併 2、4、6 或 8 個專家,每種設定用三組隨機種子挑專家,結果取平均。
方法:只選不需要額外資訊、能擴展到數百億參數的四種方法,簡單平均、任務算術、TIES-Merging,以及 DARE 加 TIES(論文稱 Dare-TIES)。需要 Fisher 矩陣、反向傳播或激活值的方法都沒有納入。
比較基準:各任務的專家,以及用八類任務混合資料訓練的多任務模型。
把這個矩陣展開,先有 個專家;再做 組合併設定,連同基準合計約九千次模型評測。這三個種子用來抽哪些專家進入合併,不是每個專家重新訓練三次。相同的子集種子跨模型大小、基底與方法共用,避免某個方法恰好抽到比較容易的任務。
專家到底會什麼
八類 held-in 共 16 個資料集,每個類別選兩份。它們包含選擇題問答、抽取式問答、閉卷問答、情緒分析、主題分類、結構轉文字、摘要與改寫判斷。例如摘要專家用 CNN/DailyMail 與 XSum,改寫專家用 MRPC 與 QQP。一次合併「問答+摘要」時,held-in 就只評這兩類的四份資料。
held-out 另外保留四類、七份資料,句子補完 COPA 與 HellaSwag、推論 ANLI 與 RTE、共指 WSC 與 Winogrande,以及詞義 WiC。所有合併模型都評這同一組保留任務,觀察學過專家任務之後還能否遷移。
PaLM-2-IT 也有明確的來源。作者以 FLAN-v2 做最多 60,000 步指令微調,先移除 T0 mixture 的任務,再從這個基底全參數訓練各專家。專家預設 2,000 步、學習率 、dropout 0.05,部分任務依收斂調整步數。這個「IT」是本研究為比較而建立的版本,專家訓練資料相對有限,是後面解讀規模效應的重要條件。
怎麼讀分數
分數全部做了正規化。held-in 任務除以該任務專家的分數,1 代表和專家一樣好;held-out 任務除以基底模型的分數,1 代表和沒微調的基底模型一樣。大於 1,就是合併讓基底模型在沒看過的任務上變好了。
例如某份資料的專家是 80 分、合併模型 72 分,held-in 保留率是 0.9;某個保留任務的基底是 40 分、合併模型 44 分,held-out 則是 1.1。後者是相對改善 10%,原始分數多 4 分。因為資料集還混有摘要等不同指標,不能把正規化值的 0.1 一律換成準確率增加十個百分點。
平均時也有順序,先在每一類裡平均資料集的正規化分數,再跨類別、跨三組子集種子平均。這使每個任務類別有相同權重。只拿全部資料集直接平均,WiC 只有一份資料的類別就會被壓低比重。
討論
從指令微調過的模型出發
所有設定下,從 PaLM-2-IT 出發的專家,合併後的 held-in 表現都比從 PaLM-2 出發的好,不管方法、大小或專家數量。合併的專家越多,兩者的差距越大。
作者的解讀延續 Ortiz-Jimenez 等人的觀點,大規模的指令微調可能讓權重更「解耦」,不同任務的修改比較不會互相干擾。他們建議,用手上最好的基底模型來做專家,而基底模型的好壞,可以用它的零樣本能力來判斷。
越大越好合併
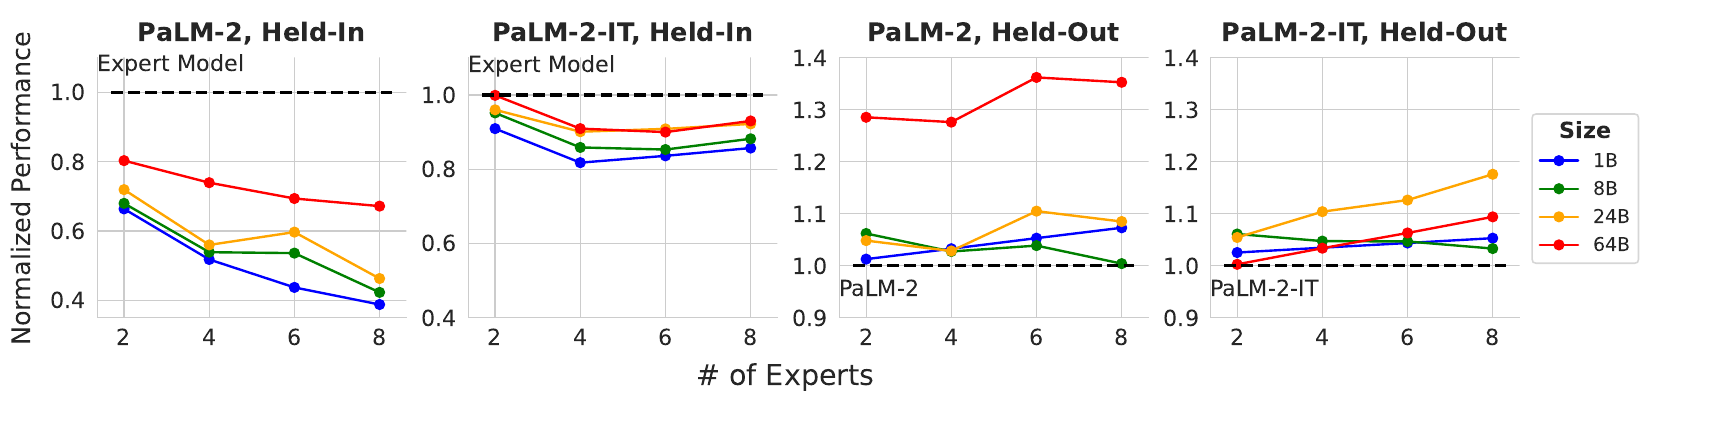
先看左邊兩張 held-in。顏色從藍(1B)到紅(64B),大致是越大越高。大的指令微調模型最好合併,64B 的 PaLM-2-IT 合併之後,幾乎和各任務的專家一樣好。
同一張圖也回答了第四個問題。以附錄的任務算術結果看,8B 的 PaLM-2,專家從 2 個增加到 8 個,held-in 從 0.68 掉到 0.42;8B 的 PaLM-2-IT 則從 0.95 到 0.88。到了 64B 的 IT 基底,這兩點是 1.00 和 0.93。規模與基底品質都能減少合併多專家的損失,但八個專家合起來,仍少了約 7% 的平均保留表現。
合併反而更會舉一反三
右邊兩張是 held-out。大多數情況下,合併模型在沒看過的任務上都比原本的基底模型好,數值大於 1。
兩種基底的趨勢不一樣。PaLM-2 的專家數量影響不大,但 64B 的版本比基底好了約 30%;作者認為,這主要是因為 PaLM-2 本身的零樣本能力很弱,提升空間大。PaLM-2-IT 則是專家越多越好,24B 和 64B 尤其明顯;作者推測,合併越多專家,各自的雜訊互相抵消得越多。
最後是和多任務模型的比較。64B 的 PaLM-2-IT 合併 8 個專家時,任務算術的 held-out 是 1.09,多任務模型是 1.05;同時 held-in 是 0.93,低於多任務模型的 0.99。也就是新任務的平均泛化較好,已學任務的能力仍有取捨。24B 的任務算術合併 8 個專家,held-out 是 1.18,和多任務模型的 1.18 相同;這兩種情況要分開看。
方法變得不重要
在 64B 的 PaLM-2-IT 上,四種合併方法的 held-in 和 held-out 表現幾乎一樣,不管合併幾個專家。
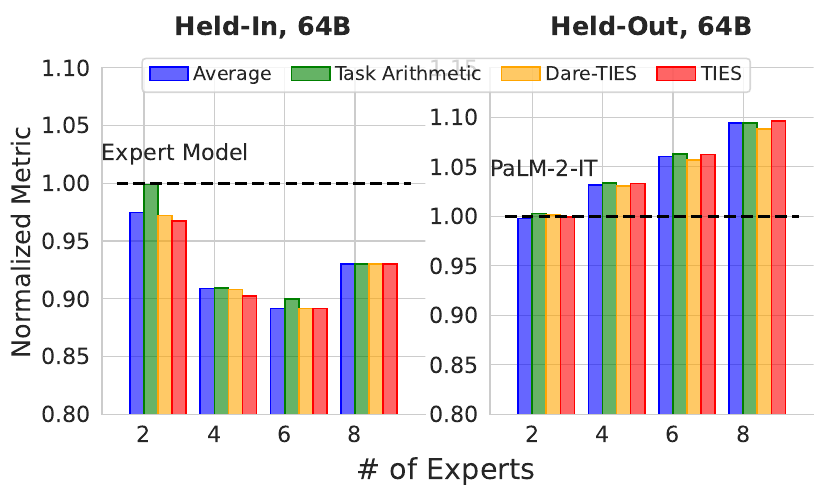
橫軸分別放 2、4、6、8 個專家,每組四根柱比較方法。左圖的參考線是專家,右圖則是 IT 基底;同一個 1,在兩邊有不同的比較對象。左圖略低於專家,右圖隨來源增加升到基底之上,方法間的柱高差卻很小。
作者的推測是,模型很大、每個專家的訓練資料相對有限時,專家其實嚴重過度參數化;TIES 處理干擾、DARE 隨機修剪這些在小模型上有用的技巧,到了大模型就不太重要了。他們的結論是,大型的指令微調專家,簡單平均可能就夠了。
把四種方法排在一起
我們挑同樣合併八個 IT 專家的設定,將兩種規模並排。每一格都使用前面的正規化方式:
| 方法 | 24B held-in | 24B held-out | 64B held-in | 64B held-out |
|---|---|---|---|---|
| 平均權重 | 0.77 | 1.16 | 0.93 | 1.09 |
| 任務算術 | 0.92 | 1.18 | 0.93 | 1.09 |
| DARE-TIES | 0.88 | 1.17 | 0.93 | 1.09 |
| TIES | 0.86 | 1.16 | 0.93 | 1.10 |
| 多任務訓練 | 0.98 | 1.18 | 0.99 | 1.05 |
整理自原論文附錄 C 的 PaLM-2-IT 結果表,均為八個專家。
64B 的四種方法幾乎重合,24B 的 held-in 卻還有 0.15 的差距。因此「大了就好合」還包含基底、任務與規模的組合,沒有一個通用的參數量門檻讓所有方法突然相同。甚至同樣是 64B,換回未指令微調的 PaLM-2、合併八個專家,任務算術 held-in 是 0.67,TIES 是 0.56,差距又出現了。
方法本身也有不同尺度。平均權重是 ,任務算術則用 ;後者容許調整總改動量。TIES 的逐格平均與 DARE 的隨機稀疏化,會進一步改變各位置的更新。這張比較表告訴我們最終結果可以接近,過程並沒有因此變成同一個運算。
從這組實驗能帶走什麼
第一,held-out 的正規化改善和基底分數有關。未 IT 的 64B 基底零樣本分數較弱,任務算術合併八個專家可達 1.35,卻仍低於多任務訓練的 1.72。比起只看「改善三成多」,把基底、多任務與專家都放回對照,才能決定是否值得用。
第二,規模趨勢有個別例外。像未 IT 的 24B 基底,八專家的簡單平均在 held-out 是 0.83,TIES 是 0.90,都低於基底;這篇支持的是強基底與大規模整體更容易合併,遇到退化仍要看各任務明細。指令微調讓權重解耦、專家雜訊在合併時抵消,都是作者用來解釋趨勢的假說,研究沒有直接量出一條因果鏈。
第三,這是一個模型家族、最多八個專家、指定 T0 任務與專家微調預算的研究。它沒有把不同 tokenizer、獨立預訓練來源或數十個長期訓練的領域專家混進來,也沒有量完整產品的延遲、安全性與服務成本。若自己的需求超出這個範圍,最有用的借鏡是這套實驗矩陣,先把基底品質與專家數控制好,再比合併配方。
結論
這篇論文用 PaLM-2 把合併放大到 640 億參數,得到的訊息很一致。專家要從夠強、最好是指令微調過的基底出發;模型越大越好合併,也能合併更多專家;合併通常會提升零樣本泛化,大模型上甚至超過多任務訓練;而合併方法之間的差別,越大越不明顯。
作者也提醒,合併模型在專家自己的任務上,通常仍然比不上專家。他們認為,和多任務模型相比,這個損失可能沒有那麼嚴重。
最後一點值得記下來。TIES-Merging 的作者自己做了這個實驗,然後發現,到了 64B,TIES 和簡單平均差不多。