原始論文
Model Merging in Pre-training of Large Language Models
- 發表版本
- NeurIPS 2025會議
- arXiv 首次提交
- arXiv:2505.12082
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingpretrainingmerging2025,
  title = {{Model Merging in Pre-training of Large Language Models}},
  author = {Yunshui Li and Yiyuan Ma and Shen Yan and Chaoyi Zhang and Jing Liu and Jianqiao Lu and Ziwen Xu and Mengzhao Chen and Minrui Wang and Shiyi Zhan and Jin Ma and Xunhao Lai and Deyi Liu and Yao Luo and Xingyan Bin and Hongbin Ren and Mingji Han and Wenhao Hao and Bairen Yi and LingJun Liu and Bole Ma and Xiaoying Jia and Xun Zhou and Siyuan Qiao and Liang Xiang and Yonghui Wu},
  year = {2025},
  eprint = {2505.12082},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2505.12082}
}
預訓練一個大型語言模型,最難熬的是不知道它最後會有多好。
現在常用的學習率排程叫 WSD(Warmup-Stable-Decay)。先短暫暖身,接著用固定的學習率訓練很長一段時間,最後再把學習率降下來「退火」。問題是固定學習率階段的 checkpoint 分數總是偏低,要等退火完,才看得到模型最後的水準;想知道訓練方向對不對,就得另外拉一條分支去退火,每次都要再花上幾百億到上千億個 token。
模型合併的研究大多在微調之後,把幾個不同任務的模型合在一起。預訓練階段的合併則是另一回事,合的是同一條訓練軌跡上的 checkpoint。Llama 3 和 DeepSeek-V3 的技術報告都提到用了這類技巧,但沒有交代細節;一般研究者也拿不到大規模預訓練的中間 checkpoint,很難自己研究。
ByteDance Seed 的這篇論文從頭訓練了一系列稠密與 MoE 模型,最大到 200B 總參數,把預訓練中的 checkpoint 合併拿出來仔細量。他們把這個做法叫做 PMA(Pre-trained Model Average)。
定義問題
合併的對象是同一條訓練軌跡上依序存下的 個 checkpoint ,合併後的模型是加權和:
相鄰兩個 checkpoint 之間相隔固定的訓練量 ,以 token 數計。例如 、,就是取最近 80B token 內、每隔 8B 存一次的 10 個 checkpoint。
權重 的分法,論文比較三種常見做法:
- SMA(簡單移動平均):每個 checkpoint 一樣重,。
- EMA(指數移動平均):遞迴計算 ,越新的 checkpoint 權重越大, 越大越偏重最新的。
- WMA(加權移動平均):權重線性增加,例如 ,再除以總和正規化。
以 為例,SMA 的權重是 ,WMA 是 。
作者把研究拆成六個問題:合併對表現有什麼影響、哪種合併方法比較好、間隔與數量怎麼選、合併後的模型當作下一階段的起點有沒有幫助、能不能提升訓練穩定性,以及合併為什麼有效。
實驗用的是內部語料與內部架構。MoE 模型從 0.7B/7B(啟動參數/總參數)到 20B/200B,稠密模型從 411M 到 70B。評測涵蓋 MMLU、BBH、GSM8K、HumanEval 等十六個公開基準,多數圖表報的是它們的加權平均分。
解決問題
固定學習率階段:直接平均就變好
第一個實驗最簡單,在固定學習率階段訓練一段時間後,把 checkpoint 平均起來,和最新的 checkpoint 比。
四種大小的 MoE 模型都有明顯進步。Seed-MoE-1.3B/13B 的 HumanEval 從 31.1 升到 36.6,Seed-MoE-10B/100B 從 54.3 升到 61.6。大模型在 BBH 這類接近飽和的基準上進步較小。附錄的稠密模型也一樣,Seed-Dense-70B 的 HumanEval 從 50.6 升到 57.9,GSM8K 從 85.9 升到 91.3,而且模型越大,進步幅度沒有變小。
這和 2018 年的 SWA 是同一個直覺。學習率固定且偏大時,模型在谷底附近來回晃動,每個 checkpoint 都停在谷壁的不同位置;平均起來,就比較接近谷底的中心。
退火階段:早期平均就追上終點
第二個實驗在退火階段做合併。學習率依 cosine 曲線往下降,模型分數也一路上升。
有意思的是,在退火剛開始時合併 checkpoint,得到的分數已經和退火結束時差不多;較大的模型甚至有時候超過自然退火完的結果。
這引出一個更大膽的問題。如果合併可以達到退火的效果,能不能乾脆不退火?
不退火,只合併
作者從 Seed-MoE-1.3B/13B 在 1.4T token 處分出兩條訓練:一條維持固定學習率,一條開始退火,各自再訓練 250B token。然後拿固定學習率那條的 checkpoint 來合併。
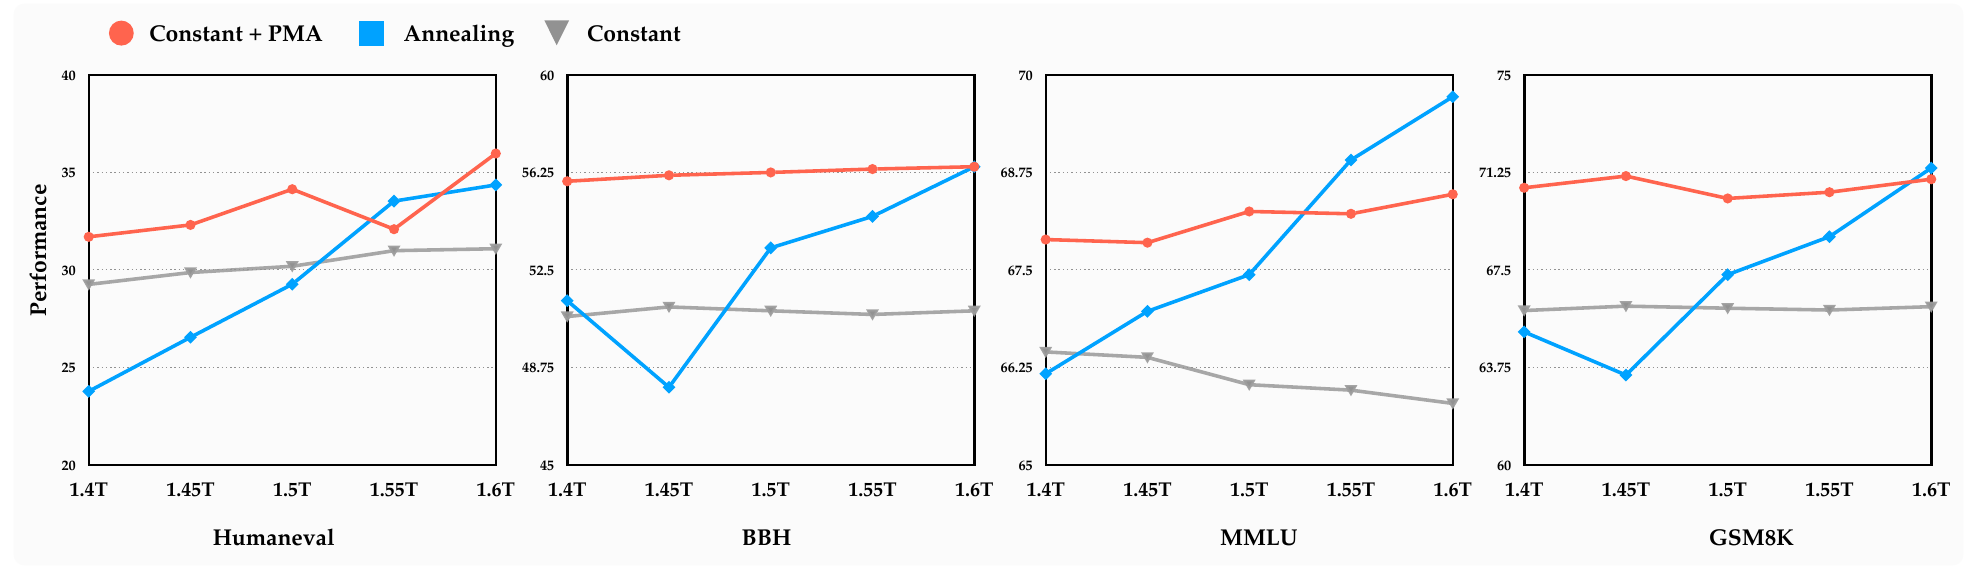
先看灰線和紅線。同樣是固定學習率,不合併的灰線幾乎沒有進步,MMLU 甚至一路下滑;合併後的紅線一開始就高出一截。
再看藍線。退火初期分數通常比較低,BBH 和 MMLU 甚至先掉下去,之後才一路上升。到了 1.6T,HumanEval、BBH、GSM8K 上紅藍兩線已經差不多,MMLU 則是退火明顯比較高,大約高出兩分。
作者的結論是,固定學習率加上合併,在訓練過程的任何時間點都能大致預測退火後的表現,用來做快速驗證很划算。這個結論在三個基準上成立,MMLU 則是一個例外,讀圖時要記得。
怎麼合:方法、間隔、數量
方法。在 Seed-MoE-1.3B/13B 上,訓練到 204B token 時,三種方法都比合併前好,WMA 最好, 的 EMA 也勝過 。訓練早期權重變化很大,越新的 checkpoint 越值得多給權重。訓練到後期,三種方法的差距就幾乎消失了。作者之後都用最簡單的 SMA。
間隔 。固定 ,比較 為 4B、8B、16B、32B token。訓練早期(204B token)時,16B 和 32B 的間隔反而比不合併還差,因為往回取太遠,混進了訓練初期還很不穩定的權重。訓練越久,不同間隔的差距越小。
作者歸納出一個隨模型大小縮放的經驗值:0.7B/7B 模型約 4B token,1.3B/13B 約 8B,10B/100B 約 80B。大模型通常用更大的批次,checkpoint 之間的間隔也跟著拉長。
數量 。固定 ,比較 3、6、10、15 個 checkpoint。訓練早期取太多一樣會混進不穩定的權重;訓練後期則是越多越好, 比 高了將近 1 分。作者折衷取 。
合併後當作下一階段的起點
預訓練之後通常還有繼續訓練(continued training, CT)、SFT 和強化學習。作者把合併後的權重當作下一階段的起點,稱為 PMA-init。
CT 階段。在 Seed-MoE-0.7B/7B 上,用約 1T token 訓練後合併,再接著做 CT。PMA-init 的初始損失稍低,MMLU 在早期也比較好;但訓練到後面,兩邊的損失收斂到差不多的位置,整體分數也持平。換了幾種學習率排程,結論都一樣。
SFT 階段。在 Seed-MoE-15B/150B 上,用合併後的權重做 220M token 的 SFT。同樣的學習率下,PMA-init 的 MMLU 從 86.8 變成 87.1,LiveBench 從 50.5 變成 52.0,AMC-2023 從 61.0 變成 64.0;內部評測的 OOD 與指令遵循各多兩分以上。
但作者也誠實寫了,這種幅度的進步在其他大小的模型上沒能重現。PMA-init 不會傷害下游表現,有時有幫助,不保證每次都有。
救回損失暴衝
PMA-init 還有一個比較意外的用途。
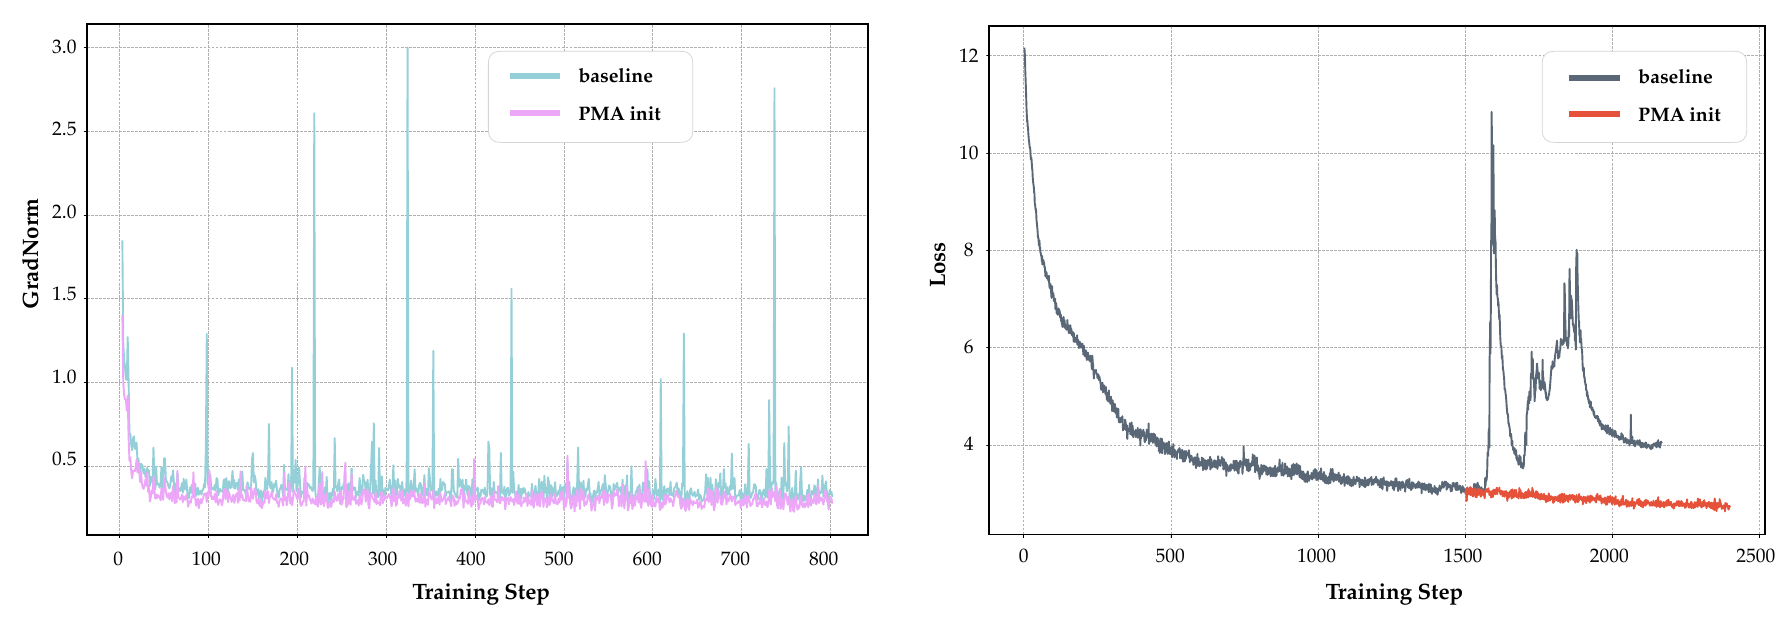
左圖是 SFT 時的梯度範數,PMA-init 那條明顯平穩,損失尖峰也比較少。
右圖是作者刻意製造的不穩定訓練。在大模型上直接研究損失暴衝太貴,他們用一個 330M/3.3B 的小 MoE 模型,配上 6e-3 這種特別大的學習率,重現大模型常見的暴衝。原始訓練在暴衝後再也回不到原本的軌跡。作者取暴衝前存下的三個 checkpoint 合併,從那裡重新開始,訓練就穩穩地走過了原本出事的位置。
這給大規模訓練一個實用的選項。遇到救不回來的損失暴衝,不必退回很早的 checkpoint 或整個重來,先把暴衝前的幾個 checkpoint 平均一下再接著訓練。
討論
為什麼平均會更好
作者用損失在最佳點 附近的二階展開解釋。令每個 checkpoint 和最佳點的偏差為 ,海森矩陣為 ,梯度在最佳點為零,於是
平均後的模型偏差是 。把兩邊展開比較,合併模型的損失低於個別模型平均損失的條件是
右邊在 正定時一定是正的。左邊的交叉項如果多半是負的,也就是各個 checkpoint 相對於最佳點往「互補」的方向偏,這個條件就很容易成立。
用兩個 checkpoint 試一下最極端的情況。若 ,兩個點剛好在最佳點兩側,平均後正好落在 ,損失就是最低的 。若 ,兩點重合,平均沒有任何好處。
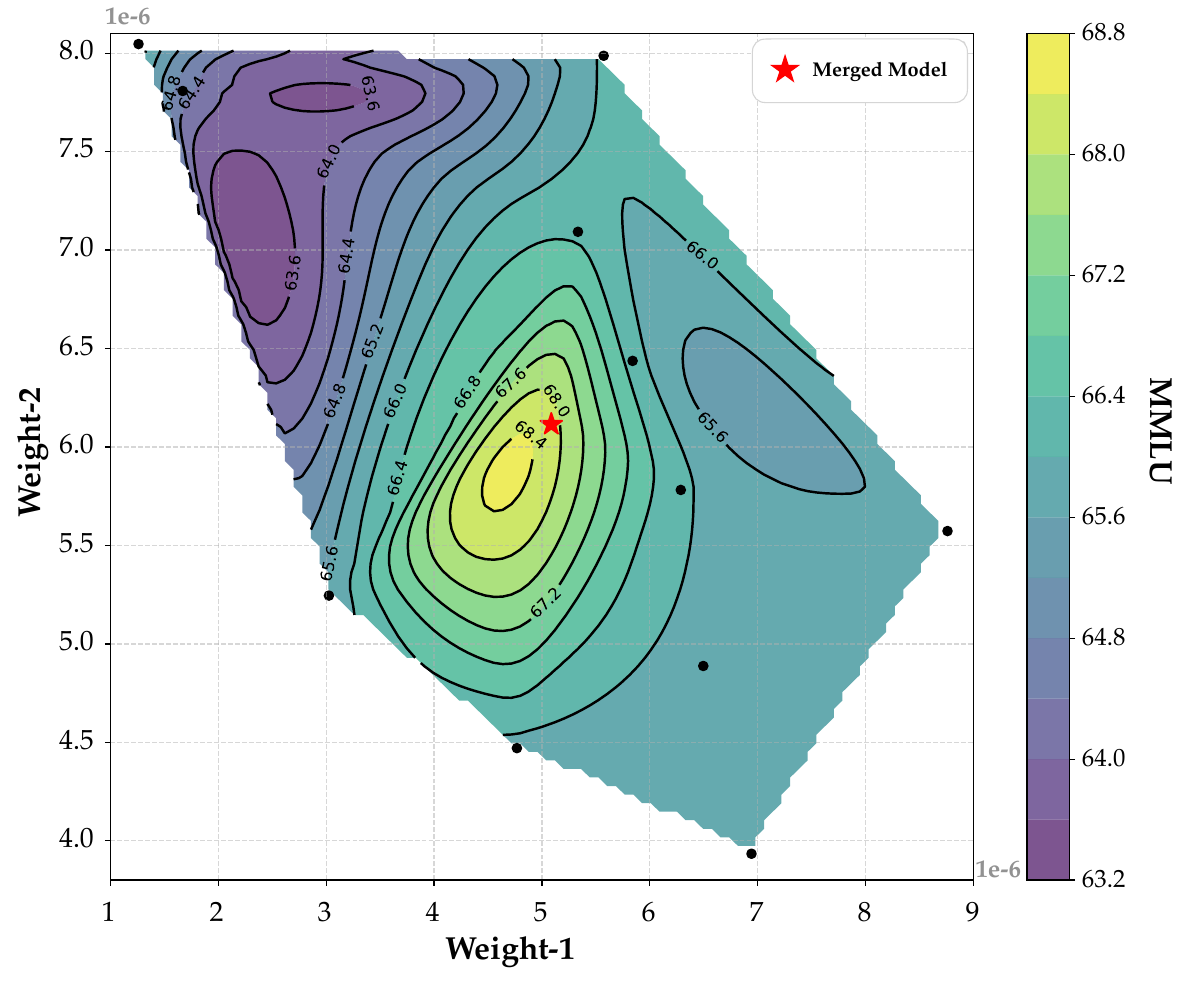
作者也從 Seed-MoE-1.3B/13B 某一層挑了兩個參數畫圖。各 checkpoint 散在高分區的周圍,平均後的紅星更靠近中心。
這也解釋了為什麼退火完的 checkpoint 合併效果有限。學習率降得很低時,checkpoint 都已經擠在同一個小谷底裡,偏差的方向不再互補,平均也就跳不出去了。
不過這個分析有不少假設。它假設 checkpoint 都在同一個最佳點附近、二階近似成立、海森矩陣正定;在非凸的預訓練過程中,這些都只是近似。兩個參數的等高線圖,則是一個極高維空間的小切面,作者自己也只用它做直覺說明。
讀這篇時要注意的事
所有模型、架構與語料都是內部的,無法重現。主要指標是十六個基準的加權平均,權重沒有公開。間隔的經驗值來自三種大小的 MoE 模型,換成不同的批次大小或資料配比,數字未必適用。
另一方面,這篇的實驗規模在公開文獻裡很少見。從幾億參數到兩千億總參數都做了消融,對想在自己的預訓練流程中加入 checkpoint 平均的團隊,是一份很具體的參考。
幾個月後的 WSM 沿著同一個方向走得更遠,直接把學習率衰減整個換成 checkpoint 合併。
結論
這篇論文把「預訓練時平均 checkpoint」從技術報告裡的一句話,變成有系統消融的實驗結果。
固定學習率階段平均最近的 checkpoint,分數就會明顯提高,而且大致能預測退火之後的表現。SMA 就夠用,間隔隨模型大小放大,訓練後期 checkpoint 多一點更好。PMA-init 在 CT 與 SFT 上不傷表現,還能把一次救不回來的損失暴衝拉回正軌。
預訓練跑到一半想偷看成績的話,可以先把最近十個 checkpoint 平均一下。退火要花的那幾千億 token,晚點再花也不遲。