原始論文
REPAIR: REnormalizing Permuted Activations for Interpolation Repair
- 發表版本
- ICLR 2023會議
- arXiv 首次提交
- arXiv:2211.08403
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingrepair2022,
  title = {{REPAIR: REnormalizing Permuted Activations for Interpolation Repair}},
  author = {Keller Jordan and Hanie Sedghi and Olga Saukh and Rahim Entezari and Behnam Neyshabur},
  year = {2022},
  eprint = {2211.08403},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2211.08403}
}
2022 年底,關於「排列對齊之後能不能直接平均兩個網路」,文獻上出現兩個互相矛盾的結果。
一邊是 Singh 與 Jaggi 在 2020 年用最佳傳輸(optimal transport)做神經元對齊。兩個在 CIFAR-10 上準確率超過 93% 的 ResNet18,對齊後線性插值,中點最好也只有 77%,還差 16 個百分點。
另一邊是 2022 年 9 月的 Git Re-Basin。它在把寬度放大的 ResNet 上,讓 CIFAR-10 上兩個獨立訓練的模型做到幾乎零障礙;它比較的對齊方法之一「激活比對」,正是 Singh 與 Jaggi 的方法所涵蓋的特例。
兩個結果怎麼可能同時成立?
Hive AI 的 Keller Jordan 與 Google、TU Graz 的 Sedghi、Saukh、Entezari、Neyshabur 合寫的這篇論文給了答案。後四位正是提出排列不變性猜想的同一組作者。
定義問題
前一篇 Entezari 等人的普查已經看到,對齊後的障礙會隨寬度下降,卻隨深度急遽上升。超過幾層的 MLP 或 CNN,對齊也救不回來。
作者想知道,深度到底弄壞了什麼。
他們沒有繼續改良對齊演算法,而是直接打開插值後的網路,看每一層的激活值。量法很簡單,對某一層,算出每個神經元在一批訓練資料上的激活變異數,再加總成 。插值模型的 和兩個端點模型的 、 比較:
比例接近 1,代表插值模型的激活值和端點模型一樣活躍;接近 0,代表這層的輸出幾乎不隨輸入改變。
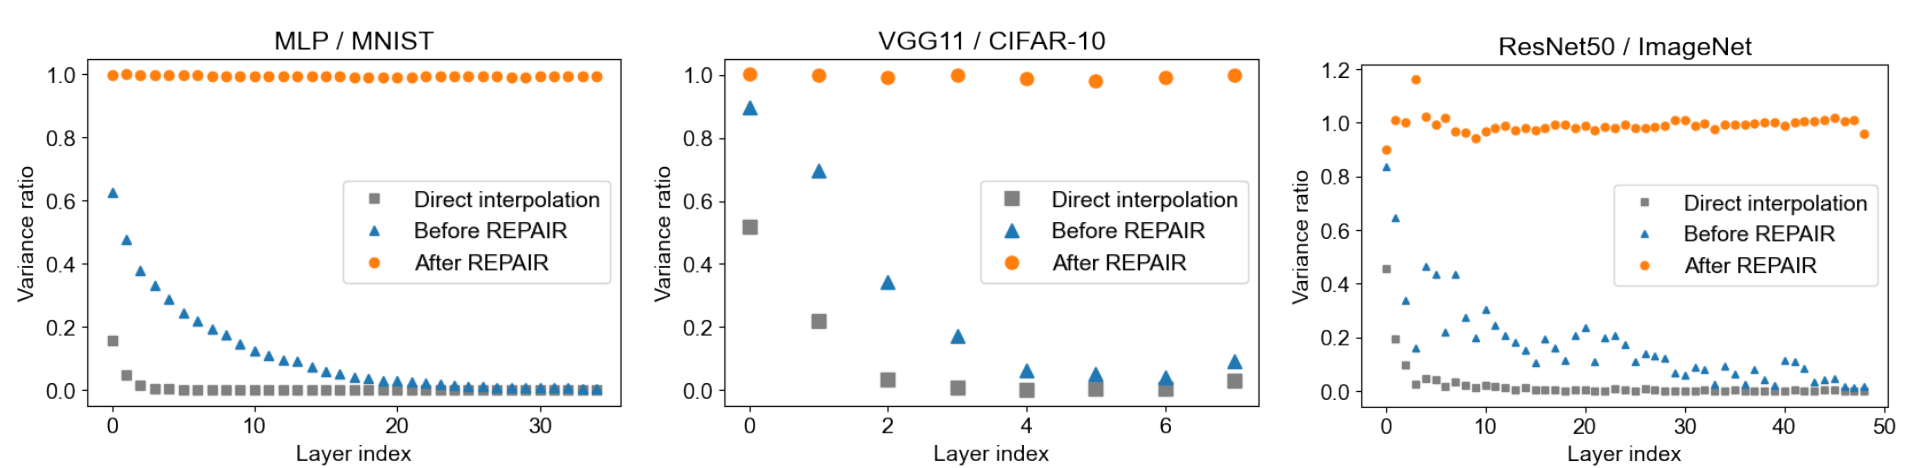
先看藍色三角形,這是對齊之後、還沒修正的插值模型。MLP 第一層的變異數比約 0.6,之後一層一層往下掉,到了 35 層的最後幾層幾乎是零。VGG11 和 ResNet50 也一樣,最後幾層的變異數掉了十倍以上。
作者把這個現象稱為變異數崩塌(variance collapse)。最後幾層的激活值幾乎是常數,網路已經分不出不同的輸入,準確率自然好不了。
灰色方塊是沒有對齊直接插值,崩得更快。
解決問題
變異數為什麼會縮水
先看插值網路的第一層。第一層的輸入就是原始資料,所以某個神經元插值後的預激活值(ReLU 之前的值),剛好是兩個端點對應神經元的線性組合:
把 、 看成隨資料變動的隨機變數。取中點 ,
第一項是我們期待的變異數,也就是兩端標準差平均後再平方;第二項是被扣掉的部分,只要兩個神經元的相關係數小於 1,就一定會扣。
如果兩個端點的標準差差不多,式子化簡成
對齊做得再好,兩個獨立訓練的網路也不會學到一模一樣的神經元。作者觀察到,對齊後配成一對的神經元,相關係數通常只有 0.4 左右。代進去,
第一層的變異數就少了 30%。
更深的層沒辦法這樣精確推導,因為輸入已經是前一層縮水過的激活值。作者的直覺是損失會一層一層累積。若粗略假設每層都只剩七成,10 層之後就剩 。
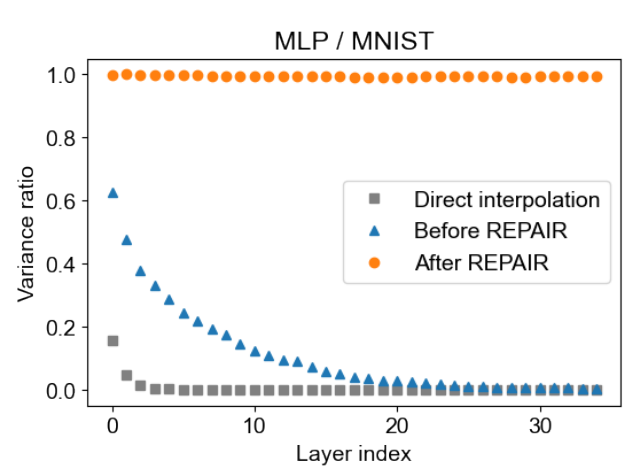
拿這個粗估對照 MLP 的實測。藍色三角形從第 0 層的約 0.62 開始,第 10 層還有約 0.12,要到第 20 層左右才掉到 0.03 上下。實際的衰減比每層七成慢,但一層接一層往下掉的形狀是一樣的。
REPAIR 要做到什麼
既然問題出在統計量,就把統計量修回來。對每一個要修正的通道,REPAIR 要求插值模型滿足兩個條件:
平均值插值本來就會成立,真正被破壞的是第二條。修正前通常是 。
要修哪些通道,作者的選擇是 VGG 的每一個卷積層輸出;ResNet 除了卷積層輸出,還要加上每個殘差區塊的輸出。
近似版:一個縮放係數
如果只看第一層,修正係數可以直接算出來。從端點模型量到 、、 之後,插值神經元的變異數是
所需的縮放係數就是「目標標準差除以實際標準差」:
用前面的數字代入,、兩端標準差相同時,,把每個神經元的輸出放大兩成即可。
這個係數對第一層是精確的,對更深的層只是近似。作者在 MNIST 上訓練 2 到 50 層的 MLP 測試,沒有修正時,中點模型超過 6 層就掉到 90% 以下;用這個近似修正,到 27 層都還能維持 90% 以上。
近似版的好處是只需要在端點模型上做前向傳播;統計量算好之後,任何 的修正係數都能直接算出來。
精確版:借 BatchNorm 來量
近似版在 ImageNet 的 ResNet50 這類困難情況上不夠用。作者因此提出精確版,直接在插值模型上做前向傳播。
做法是在每個要修正的模組後面,暫時接上一層 BatchNorm:
from torch import nn

class RepairWrap(nn.Module):
    def __init__(self, module, channels):
        super().__init__()
        self.module = module
        self.bn = nn.BatchNorm2d(channels)      # 新加的層,先開 train 模式

    def set_goal(self, goal_mean, goal_std):
        self.bn.bias.data = goal_mean            # (1-α)·E[X1] + α·E[X2]
        self.bn.weight.data = goal_std           # (1-α)·std(X1) + α·std(X2)

    def forward(self, x):
        return self.bn(self.module(x))
BatchNorm 在訓練模式下會先把輸入正規化成平均 0、變異數 1,再乘上 weight、加上 bias。把這兩個參數設成目標的標準差與平均值,輸出的統計量就剛好是條件要求的樣子。
接著把大約 5,000 筆訓練資料送進網路,讓新加的 BatchNorm 估出 running mean 與 running variance;原本網路裡的 BatchNorm 全部凍結。估完之後切到評估模式,新加的層就變成固定的縮放與平移,最後可以融合進前一層卷積的權重,模型架構和原本一模一樣。
這裡有一個有趣的對照。如果網路本來就在每個卷積後接 BatchNorm,那只修正卷積輸出,在數學上就等於重新估一次 BatchNorm 的統計量。SWA 在 2018 年就這樣處理平均後的模型,只是沒有人把它用在兩個獨立訓練的網路之間。REPAIR 把這個做法推廣到殘差區塊的輸出,以及沒有 BatchNorm 的網路。
REPAIR 和對齊演算法是互補的,作者在本文中都用 Li 等人 2015 年的激活相關性比對,再用匈牙利演算法求解;有殘差連接的網路,同一條殘差流上的各層必須套用同一個排列。
討論
CIFAR-10 上的 ResNet18
兩個對齊後的 ResNet18,端點在 CIFAR-10 測試集上是 95.5%。直接插值的中點只有 66.0%;REPAIR 之後中點變成 94.1%,障礙只剩 1.5 個百分點。對照組 Singh 與 Jaggi 的最佳傳輸對齊,中點是 77.0%。
正規化層解開了矛盾
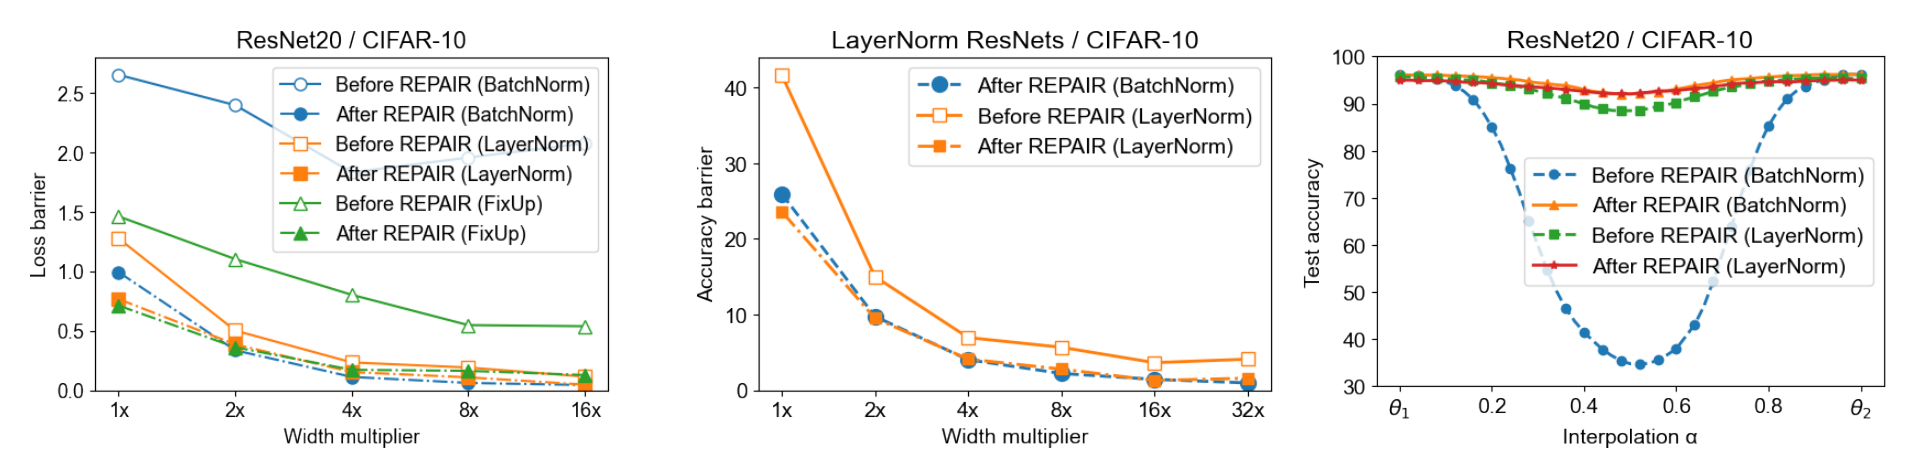
作者在 CIFAR-10 上訓練 ResNet20,比較三種正規化:BatchNorm、LayerNorm,以及不用正規化的 Fixup,寬度倍率從 1× 到 16×(最後一個區塊從 64 到 1024 個通道)。
右圖最有說服力。標準寬度的 BatchNorm 版本,修正前中點掉到 34.7%;LayerNorm 版本修正前就有 88.4%。修正之後兩者都是 92.0%。
8× 寬度時也一樣。LayerNorm 中點修正前已有 90.3%,修正後 93.2%;BatchNorm 修正前只有 32.3%,修正後 94.4%。左圖顯示,寬度放到 16× 時,BatchNorm 和 LayerNorm 修正後的損失障礙都低於 0.05。
為什麼 LayerNorm 特別?作者的解釋是,LayerNorm 在推論時也會依當下的輸入重新正規化,每層縮水的變異數會被拉回來,不會一路累積。BatchNorm 在推論時只是一個固定的仿射轉換,縮水會一層一層疊上去。
這就是開頭矛盾的答案。作者查了 Git Re-Basin 的程式碼,發現它的 ResNet 把 BatchNorm 換成了 LayerNorm。Singh 與 Jaggi 用的是標準 BatchNorm 的 ResNet18,所以對齊再好也被變異數崩塌拖垮。
LayerNorm 也有代價。同樣的訓練設定下,LayerNorm 版 ResNet20 在 CIFAR-10 上是 92.4%,BatchNorm 版是 93.6%。
ImageNet
ImageNet 上,對齊後直接插值的 ResNet18、ResNet50 與兩倍寬的 ResNet50,中點準確率都低於 1%。REPAIR 之後分別變成 41.1%、56.5%、64.2%。
殘差區塊輸出要不要修正,差距不小。ResNet50 只修正卷積輸出時中點是 53.2%,加上殘差區塊輸出變成 56.5%,障礙從 23.4 個百分點降到 20.1。
但這仍是相當大的障礙。標準 ResNet50 修正後還有 20.1 個百分點,兩倍寬是 12.9。作者推測,困難的資料集需要更寬的網路,障礙才會降到很低。
寬度與深度
10 層 MLP(寬度 32 到 2048)與 ResNet20(寬度 1× 到 16×),在 MNIST、FashionMNIST、SVHN、CIFAR-10 四個資料集上,REPAIR 都降低了障礙,而且越寬越低;MNIST 上連較窄的網路都接近零。
深度方面,CIFAR-10 上的 VGG 從 11 層到 19 層,修正前障礙隨深度上升,修正後幾乎和深度無關。Entezari 等人普查看到的「深度讓障礙變高」,至少有一部分來自變異數崩塌。
合併不同資料訓練的模型
最後一個實驗重現 Git Re-Basin 的設定。CIFAR-100 的 50,000 張訓練圖分成兩份各 25,000 張,第一份取前 50 類的 80%、後 50 類的 20%,第二份反過來。兩個網路各自擅長一半的類別。
對齊並用 REPAIR 修正後,插值路徑上不少模型在完整測試集上的損失比兩個端點都低。最好的出現在 ,測試損失 1.30;Git Re-Basin 報告的最佳值是 1.73,也在 。作者坦白說,這個差距一部分來自 REPAIR,一部分來自標準 ResNet 本來就比 LayerNorm 版本強。
這還算排列嗎
作者在討論裡提了一個誠實的問題。REPAIR 讓更多情況做到低障礙,看起來支持 Entezari 的猜想;但它重新縮放了插值模型的預激活值,已經不是嚴格的「排列後線性插值」了。
換句話說,在實際可用的寬度、又不換成 LayerNorm 的前提下,光靠排列似乎不夠,還需要這種統計量的修正。猜想本身仍然沒有被證實。
實務上也要記得,REPAIR 需要訓練資料。端點模型的統計量要用訓練資料量,精確版還要再送幾千筆資料進插值模型。手上只有權重、沒有資料時,這一步做不了。
結論
這篇論文把一個看似是對齊問題的現象,追到插值網路內部的統計量。兩個神經元只要不完全相關,平均之後變異數就會縮水,而 BatchNorm 網路會讓這個縮水一層層疊加,最後整個網路對輸入失去反應。
修正方法只是把每個通道的平均值與標準差拉回兩個端點之間的插值。ResNet18 在 CIFAR-10 上的障礙,從 Singh 與 Jaggi 最佳傳輸對齊留下的 16 個百分點降到 1.5,ImageNet 上的 ResNet50 從不到 1% 救回到 56.5%。
平常在做權重平均的話,平均完記得重新估一次 BatchNorm 的統計量。官方程式碼在 KellerJordan/REPAIR,修正只要拿幾千筆訓練資料跑一次前向傳播。
SWA 在 2018 年就這樣做了,只是那時平均的,都是同一條訓練軌跡上的模型。