原始論文
WSM: Decay-Free Learning Rate Schedule via Checkpoint Merging for LLM Pre-training
- 發表版本
- ICLR 2026會議
- arXiv 首次提交
- arXiv:2507.17634
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingwsm2025,
  title = {{WSM: Decay-Free Learning Rate Schedule via Checkpoint Merging for LLM Pre-training}},
  author = {Changxin Tian and Jiapeng Wang and Qian Zhao and Kunlong Chen and Jia Liu and Ziqi Liu and Jiaxin Mao and Wayne Xin Zhao and Zhiqiang Zhang and Jun Zhou},
  year = {2025},
  eprint = {2507.17634},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2507.17634}
}
訓練大型語言模型,學習率排程一直是個麻煩的設定。
傳統的 cosine 排程從一開始就得知道總共要訓練多少步,曲線才畫得出來;想多訓練一些資料,就得從頭來過。WSD(Warmup-Stable-Decay)在中間插了一段固定學習率的穩定期,可以隨時從穩定期分支出去退火,DeepSeek-V3、ERNIE 4.5 都採用它。
但 WSD 還是有一堆要事先決定的事:什麼時候開始退火、退火用多少 token、用哪一種衰減曲線。退火做完之後如果還想再訓練,就得退回退火之前的狀態,重新規劃。
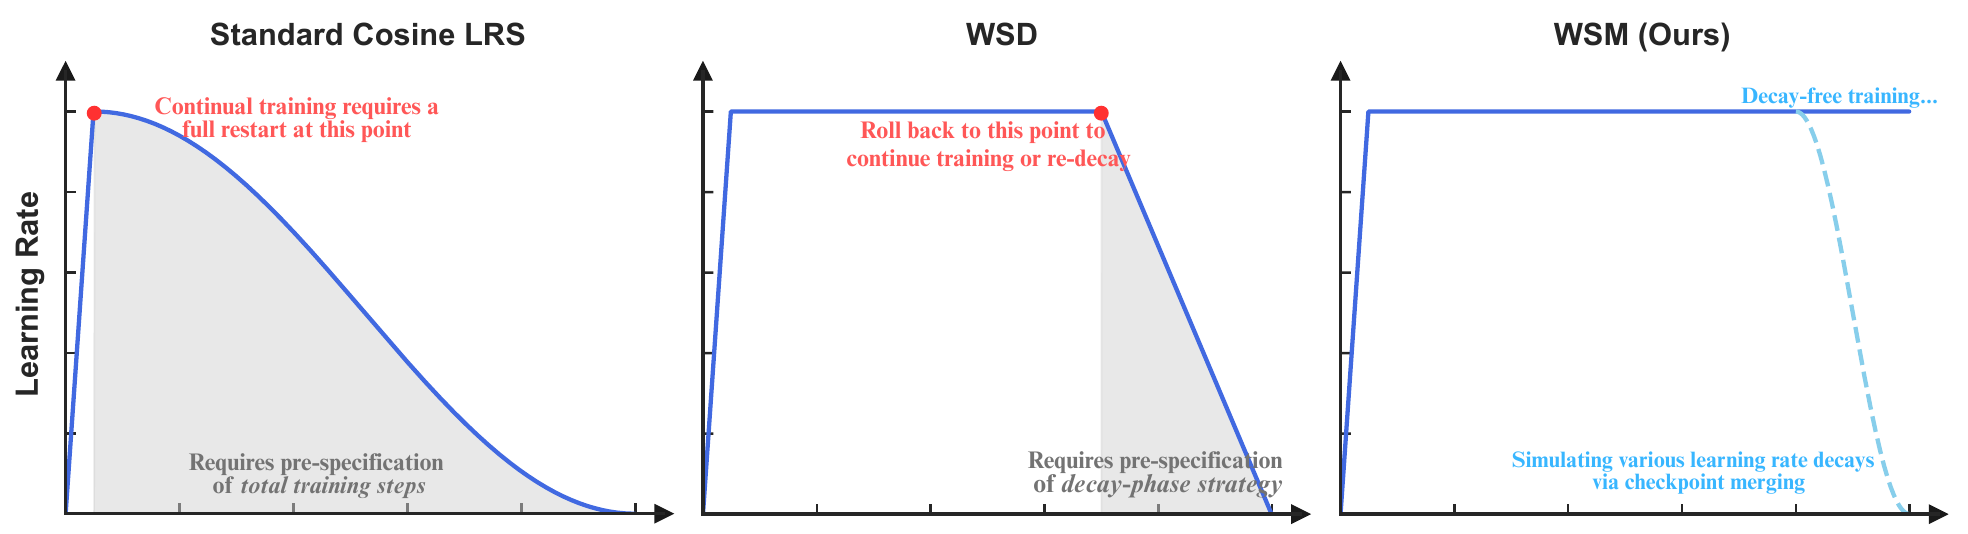
螞蟻集團 Ling 團隊與中國人民大學的這篇論文,想把衰減這一段整個拿掉。學習率暖身之後就一直固定,退火的效果改用合併 checkpoint 來取得。他們把這個排程叫做 WSM(Warmup-Stable and Merge)。
定義問題
同一時期,ByteDance Seed 的 PMA 已經發現,在固定學習率階段平均 checkpoint,分數能接近甚至追上退火後的模型。
但「平均」和「退火」之間是什麼關係,一直沒有說清楚。平均時每個 checkpoint 該給多少權重?等權平均、指數移動平均,對應的又是什麼樣的退火?如果能把這層關係寫成公式,就能用合併去模擬任何一種已知效果很好的衰減曲線。
解決問題
把合併寫成衰減
設有 個依序存下的 checkpoint ,合併後的模型是
這個式子看不出和學習率有什麼關係。作者換一種寫法,把每個 checkpoint 寫成「起點加上之後的更新」。令 是第 步的更新量(已經乘上學習率),,那麼
代回合併式,交換兩個加總的順序。第 次更新 ,會出現在所有 的 checkpoint 裡,所以
其中 。
這個結果很直觀。合併 checkpoint,等於從 出發,把後面每一步的更新乘上一個係數 再加回去。因為 是 的尾端累加,它一定隨 遞減,這正好就是一條衰減的學習率曲線。
反過來也行。想要某條遞減的衰減曲線 ,對應的 checkpoint 權重唯一決定為
這是論文的定理 3.1。
算一次看看
我們用一個小例子把兩個方向都走一遍。先看等權平均 5 個 checkpoint 相當於什麼衰減,再反過來算 1-sqrt 衰減需要什麼權重,最後確認兩邊的結果真的一樣。
import numpy as np

def merge_weights_from_decay(w):
    """定理 3.1:由梯度衰減係數 w_1..w_k 反推 checkpoint 權重 c_0..c_k。"""
    k = len(w)
    c = np.zeros(k + 1)
    c[k] = w[-1]
    for j in range(1, k):
        c[j] = w[j - 1] - w[j]
    c[0] = 1 - w[0]
    return c

rng = np.random.default_rng(0)
k = 4
theta_n = rng.normal(size=3)
g = rng.normal(size=(k, 3)) * 0.1            # 固定學習率下的 k 次更新
ckpts = [theta_n - g[:j].sum(0) for j in range(k + 1)]   # θ_n, θ_{n+1}, ..., θ_{n+k}

# 1) 平均最近 5 個 checkpoint,相當於哪一種衰減?
c_mean = np.full(k + 1, 1 / (k + 1))
w_equiv = [c_mean[i:].sum() for i in range(1, k + 1)]
print("平均 5 個 checkpoint → 每步更新的有效倍率:", np.round(w_equiv, 2))

# 2) 想要 1-sqrt 衰減,checkpoint 權重該怎麼給?
t = np.arange(1, k + 1) / (k + 1)
w_sqrt = 1 - np.sqrt(t)
c_sqrt = merge_weights_from_decay(w_sqrt)
print("1-sqrt 衰減倍率:", np.round(w_sqrt, 3))
print("對應的 checkpoint 權重:", np.round(c_sqrt, 3), " 總和", round(c_sqrt.sum(), 6))

merged = sum(cj * th for cj, th in zip(c_sqrt, ckpts))
decayed = theta_n - (w_sqrt[:, None] * g).sum(0)
print("合併結果與衰減結果的最大差距:", np.abs(merged - decayed).max())
平均 5 個 checkpoint → 每步更新的有效倍率: [0.8 0.6 0.4 0.2]
1-sqrt 衰減倍率: [0.553 0.368 0.225 0.106]
對應的 checkpoint 權重: [0.447 0.185 0.142 0.12  0.106]  總和 1.0
合併結果與衰減結果的最大差距: 1.3877787807814457e-17
第一行說明,等權平均 5 個 checkpoint,等於把之後 4 段更新分別乘上 0.8、0.6、0.4、0.2,就是一條線性衰減。第三行是反推的結果。要模擬 1-sqrt 衰減,最舊的 checkpoint 要給最大的權重 0.447,後面依序遞減。最後一行的差距在浮點誤差範圍內,兩種算法得到同一組參數。
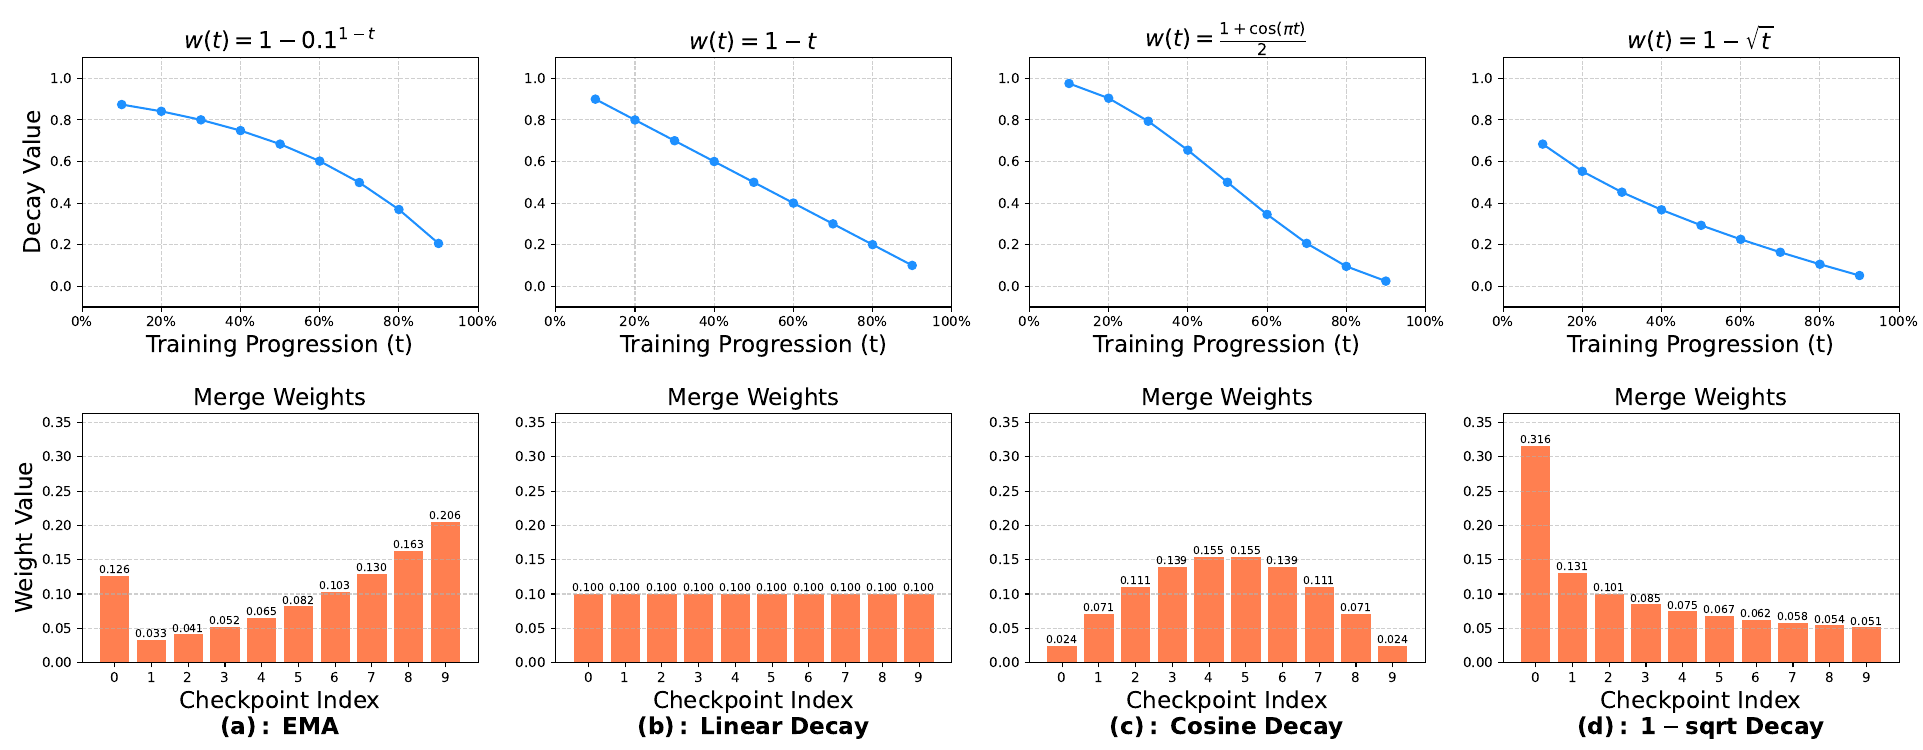
論文把四種常見的合併方式都換算成衰減曲線。最有意思的是 EMA。EMA 給新的 checkpoint 比較大的權重,看起來很合理,換算出來卻是一條凸的衰減曲線,前面幾乎不降,最後才急著往下掉。
WSM 的流程
有了這層對應,WSM 的流程分成三步。
- 暖身到峰值學習率,之後一直維持不變。
- 訓練到某個時間點,可以把資料換成精選的高品質資料,對應一般「退火資料」的做法。
- 每隔固定 token 數存一次 checkpoint,另一個非同步的程序持續取最近 個 checkpoint,依照想模擬的衰減曲線算權重並合併。
訓練本身從不中斷,合併出來的模型隨時可以拿去評估或交付。
作者也比較了離線與線上兩種合併。保留全部 checkpoint 的離線合併,可以事後嘗試不同的衰減曲線與窗口大小;找到最佳設定後,就能改成只保留最近 個 checkpoint 的線上版本。代價主要是儲存空間,作者的實驗中 就已經足夠。
討論
實驗設定
模型是 Ling-mini,總參數 16.3B、啟動參數 1.4B 的 MoE。架構是 1 個稠密層加 19 個 MoE 層,每層 256 個專家選 8 個,外加 1 個共享專家。優化器是 AdamW,峰值學習率 4.78e-4,批次 2048。
起點是一個用固定學習率訓練了 10.2T token 的 checkpoint,其中 10T 是一般長度、200B 是長上下文資料。從這裡切換到高品質的退火資料,分成兩條各訓練 400B token:
- WSD:照常衰減學習率。
- WSM:學習率維持不變,每 25B token 存一次 checkpoint,用等權平均合併最近的幾個。
比 WSD 更好
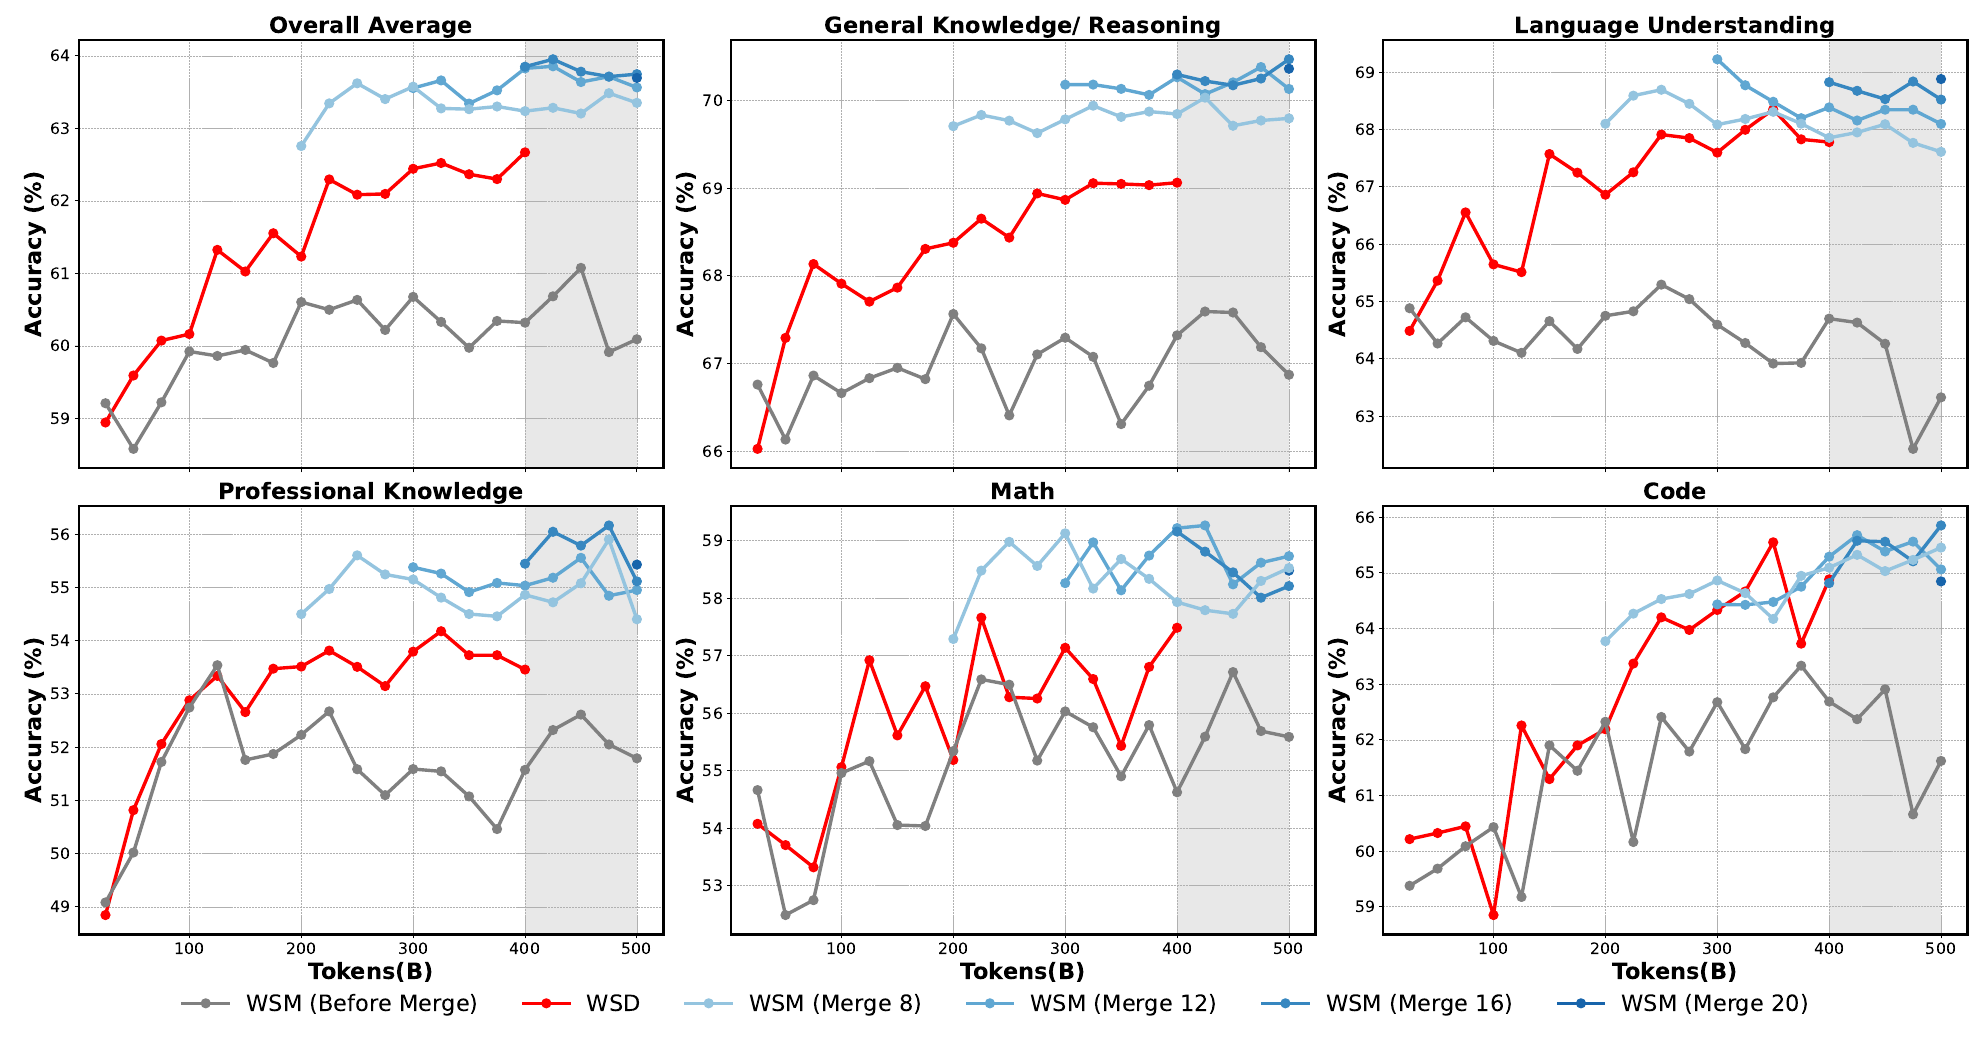
先看灰線和藍線。灰線是固定學習率下還沒合併的 checkpoint,分數一直卡在低處;合併之後的藍線一下子就跳到紅線之上。整體平均圖中,紅色的 WSD 到 400B 大約 62.7,藍線多在 63 到 64 之間。
400B 之後的灰色區域是 WSM 的另一個好處。WSD 的衰減在 400B 結束,再訓練就要重新規劃;WSM 的學習率從來沒降過,可以直接接著訓練下去。
各取表現最好的 checkpoint 比較,WSM 平均高出 1.3 分。數學、程式、專業知識都有進步,個別基準中 MATH 多 2.7 分、HumanEval 多 2.4 分、MMLU-Pro 多 2.1 分。
這個優勢在 SFT 之後也還在。兩邊的基底模型在相同設定下做 5 個 epoch 的 SFT,WSM 的整體平均是 64.07,WSD 是 62.90;但程式類是例外,WSM 反而低了 0.28 分。
在任何時間點都能預測退火
作者也在整個預訓練過程中,每到 2T、4T、6T、8T、10T token 就做一次比較。一邊是真的退火 100B token,一邊是在前 100B token 內取 4 個 checkpoint 平均。
這次用的是一般預訓練資料,不是高品質退火資料,WSM 的優勢沒那麼明顯,但兩者的分數一路緊緊貼著。所以 WSM 也能拿來當成「退火後會有多好」的預估,不用每次都開一條退火分支。
哪個因素最重要
合併方法。模擬 1-sqrt 衰減的權重、等權平均、EMA 三者比較,整體平均分別是 64.06、63.95、63.01,都高於 WSD 的 62.67。1-sqrt 略勝等權平均,EMA 明顯最差。
這和退火的經驗一致。作者在 WSD 實驗中也發現,凹的 1-sqrt 曲線與線性曲線,比凸的曲線好。EMA 對應的正是凸的衰減。
合併時長。合併窗口涵蓋的 token 數越多,表現越好,但進步逐漸變小。這也和退火一樣,退火資料加到某個程度之後,再加也沒什麼用。EMA 則完全看不出窗口大小的影響。
合併粒度。固定合併時長 80B token,比較存檔間隔:每 5B 存一次合併 16 個、每 10B 合併 8 個、每 20B 合併 4 個、每 40B 合併 2 個,整體平均分別是 63.63、63.78、63.36、62.77;只取一個 checkpoint 則是 60.33。粒度越細,越接近連續的衰減曲線,但差距遠小於時長造成的差距。
作者因此認為,合併時長是最關鍵的因素,影響比存檔間隔與合併數量都大。
合併加衰減,沒有加分
既然合併能模擬衰減,兩者能不能疊加?作者試了先衰減再合併,以及先合併再衰減,都沒有得到額外的提升。先合併再衰減的模型在一開始比較好,但最後還是追平。
作者的解讀是,合併與衰減是通往同一個目標的兩條路,彼此可以替代,但無法疊加。
對 MoE 的副作用
最後一個觀察是 MoE 的負載平衡。WSM 的模型,專家負載的偏差明顯比較小,最大偏差從 0.601 降到 0.545,最小偏差從 0.322 降到 0.201;但語言模型損失略高,0.697 對 0.675。合併讓各專家的使用更平均,代價是損失稍微變差,兩者對下游分數的影響論文沒有進一步拆開。
證據的範圍
主要實驗只在一個 16B 的 MoE 模型上,起點是一個已經訓練了 10.2T token 的 checkpoint。對照的 WSD 用的是作者在附錄比較過、效果最好的 1-sqrt 衰減,這讓比較更公平;但退火長度只有 400B token 一種,換成其他長度時差距會不會一樣大,論文沒有交代。摘要裡寫的 +3.5% MATH、+5.5% MMLU-Pro 是另一種比例算法,以百分點計是正文的 2.7 與 2.1。
Ling 團隊之後的 Ling 2.0 技術報告也採用了 WSM 排程。
結論
WSM 用一個交換加總順序的推導,把 checkpoint 合併和學習率衰減接在一起。合併權重的尾端累加就是衰減係數,反過來也能從任何遞減的衰減曲線算出合併權重。
實作上,學習率暖身後就不再調整,退火交給合併。訓練可以一直延續,任何時間點都能取得一個「退火後」的模型,而且在作者的實驗中比 WSD 還好一點。
先別急著用 EMA。它看起來最順手,換算出來卻是效果最差的那條凸曲線。