原始論文
TIES-Merging: Resolving Interference When Merging Models
- 發表版本
- NeurIPS 2023會議
- arXiv 首次提交
- arXiv:2306.01708
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingtiesmerging2023,
  title = {{TIES-Merging: Resolving Interference When Merging Models}},
  author = {Prateek Yadav and Derek Tam and Leshem Choshen and Colin Raffel and Mohit Bansal},
  year = {2023},
  eprint = {2306.01708},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2306.01708}
}
任務算術把每個微調模型寫成一個任務向量 ,加起來再乘一個係數,就得到一個多任務模型。兩個任務時效果很好,任務一多,合併模型和各自微調的專家之間,差距就越拉越大。
北卡羅萊納大學教堂山分校(UNC)的 Prateek Yadav、Derek Tam、Colin Raffel、Mohit Bansal,以及 IBM Research 與 MIT 的 Leshem Choshen,想知道這些損失是從哪裡來的。
他們的答案是,向量相加的時候,參數之間在打架。
定義問題
作者把干擾分成兩種。
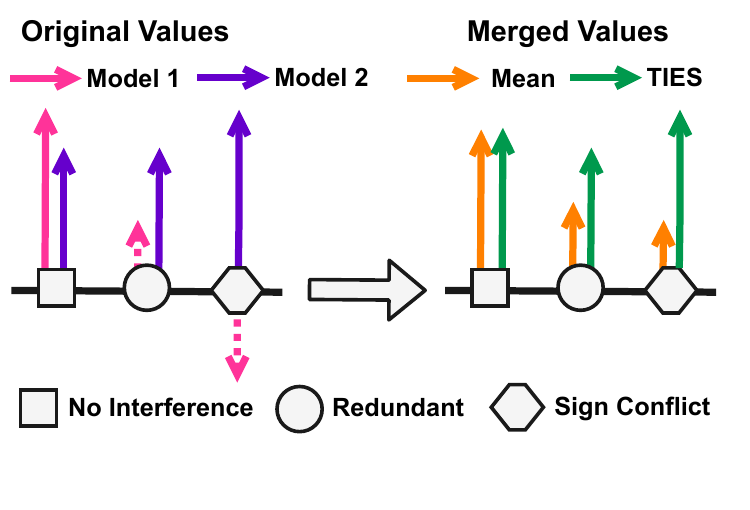
冗餘參數(圓形)。微調時,很多參數只動了一點點,這些小變化對任務幾乎沒有影響。可是合併時,一個參數對模型 A 很重要、對模型 B 只是雜訊,平均下來,A 的重要變化就被 B 的雜訊稀釋,變短了。
正負號衝突(菱形)。同一個參數,A 要它變大,B 要它變小,直接平均,兩者互相抵消。
兩種情況,結果都是合併後的參數變小,原本的差別被抹平。
作者先用數據確認這兩件事都存在。第一,只保留每個任務向量絕對值最大的 20%,其餘歸零,十一個任務的平均表現和全部保留差不多;可見大部分的變化確實是冗餘的。第二,修剪到 20% 之後,合併兩個模型就有約 2% 的參數正負號衝突,合併十一個模型時升到約 30%。
這裡的十一個任務用的是 T0-3B 上的 (IA) 微調。它只訓練一組縮放中間啟動值的小向量,主模型固定,因此「保留 20%」指的是微調參數的改動。作者後面另外驗證全參數的 T5 與 CLIP,不能把這張圖直接解讀成所有大模型都能固定刪掉 80% 改動。
解決問題
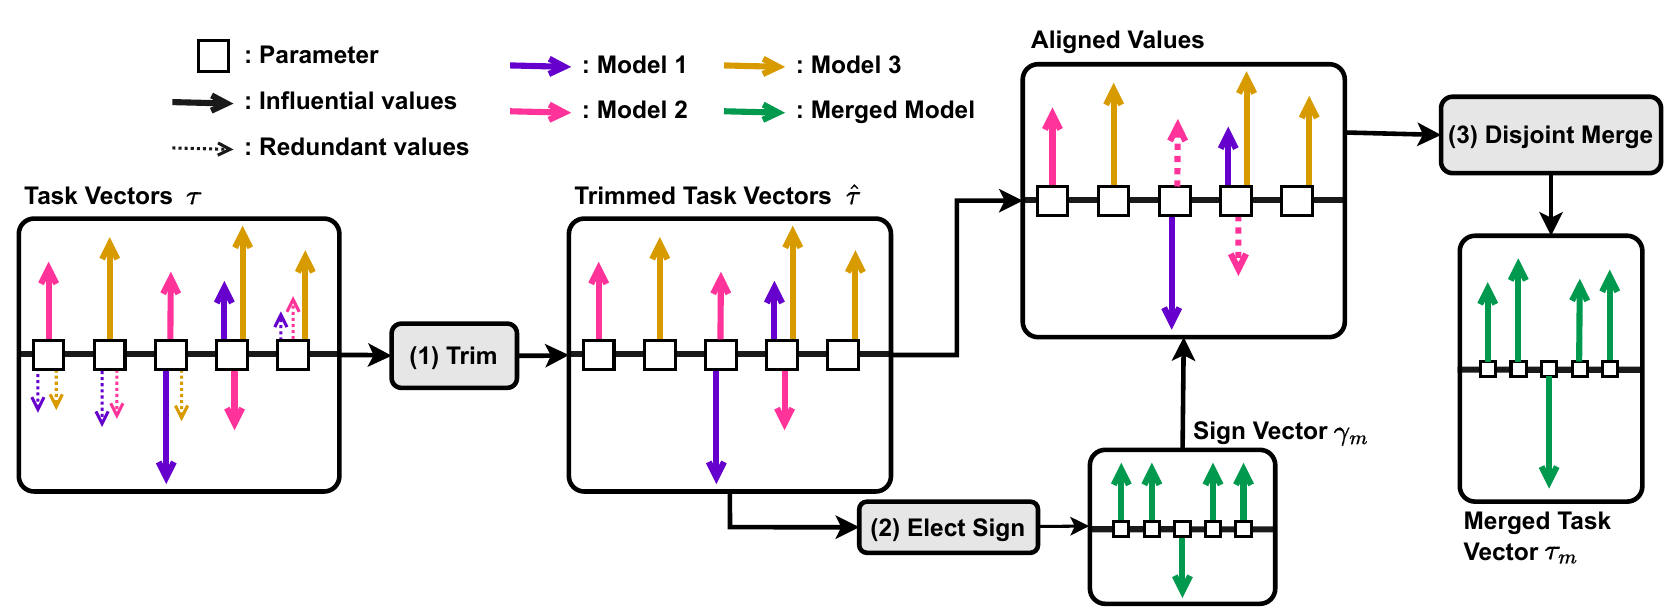
TIES 的名字來自三個步驟,Trim、Elect Sign、Disjoint Merge。先把每個任務向量拆成正負號 和大小 ,。
- 修剪(Trim):每個任務向量只保留絕對值最大的 ,其餘設成 0,得到 。
- 選正負號(Elect):對每個參數 ,把各任務在這個參數上的值加起來,總和的正負號就是這個參數最後的方向:
這等於比較往正方向和往負方向的「總量」,哪邊大就聽哪邊的。
- 不相交平均(Disjoint Merge):每個參數只平均和選出的方向一致的值,被修剪成 0 的值不算:
最後一樣乘上係數加回去,。
Trim 歸零的是差值,對應的微調權重會回到初始化值,基底參數還在。Disjoint Merge 的分母則是這一格實際留下、且方向相符的成員數。假設一格只有一個任務留下 ,另外十個任務都歸零,結果仍是 ;若除以十一,就又把修剪想消除的稀釋加回去了。各格的分母可以不同。
手算一次
拿三個任務、六個參數算一次,數字是為了示範編的,每個任務保留絕對值最大的一半:
import numpy as np

tau = np.array([[ 0.8, -0.1,  0.5,   0.02, -0.6, 0.3 ],   # 任務 A
                [-0.7,  0.4,  0.6,  -0.03,  0.1, 0.05],   # 任務 B
                [ 0.9, -0.2, -0.05,  0.01, -0.5, 0.4 ]])  # 任務 C

print("直接平均:", tau.mean(0).round(3))

# 1. Trim:每個任務只留絕對值最大的一半
k = tau.shape[1] // 2
cut = np.sort(np.abs(tau), axis=1)[:, -k][:, None]
trimmed = np.where(np.abs(tau) >= cut, tau, 0.0)
print(trimmed)

# 2. Elect:每個參數用剩下數值的總和投票,決定正負號
sign = np.sign(trimmed.sum(0))

# 3. Merge:只平均和投票結果同號的值
agree = (np.sign(trimmed) == sign) & (trimmed != 0)
ties = (trimmed * agree).sum(0) / np.maximum(agree.sum(0), 1)
print("TIES    :", ties.round(3))
直接平均: [ 0.333  0.033  0.35   0.    -0.333  0.25 ]
[[ 0.8  0.   0.5  0.  -0.6  0. ]
 [-0.7  0.4  0.6  0.   0.   0. ]
 [ 0.9  0.   0.   0.  -0.5  0.4]]
TIES    : [ 0.85  0.4   0.55  0.   -0.55  0.4 ]
第 0 個參數是正負號衝突。A、C 要它變大,B 要它變小,直接平均只剩 0.333;投票的結果是正,只平均 A 和 C,得到 0.85。
第 1 個參數是冗餘。只有 B 認真改了它,A、C 的 −0.1、−0.2 是小雜訊,直接平均被抵消成 0.033;修剪掉雜訊後,B 的 0.4 完整保留。
第 3 個參數三個任務都只動了零點零幾,修剪後歸零,乾脆不動。
注意第 2 步用的是總和,不是單純數人頭。第 0 個參數兩正一負,數人頭也會選正;但如果是一個 +0.9 對兩個 −0.1,總和仍然是正的,大的變化說了算。
若某一格全被修剪掉,程式就讓它保持 0;這份示範也把正負總量剛好相消的格子留在 0,避免空集合除法。以門檻篩 top-k 時,相同大小的值可能一起留下,實際實作也要決定如何處理門檻同值。這些分支通常只占少數,卻會影響兩份合併程式能否重現同一組權重。
此外,TIES 的 和任務算術的 不能直接共用。前者先做逐格平均,後者先把任務向量相加;即使先忽略修剪與符號篩選, 個任務的加總也比平均大 倍。固定配方的 TIES 取 1、任務算術取 0.4,是各自的建議設定,並非相同尺度的控制實驗。
討論
實驗設定
作者在三種設定上測:
- 參數高效微調:T0-3B 上用 (IA) 微調十一個任務,包括句子補完、自然語言推論、共指消解與詞義消歧。
- 全參數微調的語言模型:T5-base 與 T5-large,七個任務。
- 全參數微調的影像模型:CLIP 的 ViT-B/32 與 ViT-L/14,八個影像分類任務。
比較的對象有簡單平均、Fisher Merging、RegMean 與任務算術。
Fisher 與 RegMean 還需要資料導出的統計量,分別估計參數重要性與線性層輸入的內積;TIES 的三個合併步驟只讀權重。若要用驗證集挑 和 ,評測資料仍然需要,論文因此把有、無驗證集兩種結果分開列。
主要結果
有驗證集可以調超參數時(TIES 的 與 、任務算術的 等):
| 方法 | (IA) | T5-base | T5-large | ViT-B/32 | ViT-L/14 |
|---|---|---|---|---|---|
| 各自微調的專家 | 71.4 | 82.8 | 88.8 | 90.5 | 94.2 |
| 多任務聯合訓練 | 73.1 | 83.6 | 88.1 | 88.9 | 93.5 |
| Fisher Merging | 62.2 | 68.9 | 64.6 | 68.3 | 82.2 |
| RegMean | 58.0 | 71.2 | 73.2 | 71.8 | 83.7 |
| 任務算術 | 63.9 | 73.2 | 73.3 | 70.1 | 84.5 |
| TIES-Merging | 66.4 | 73.9 | 76.9 | 73.6 | 86.0 |
各任務的平均表現,整理自原論文 Table 1。
TIES 在五個設定上都是合併方法裡最好的,比次佳的方法高 0.7 到 3.6 個百分點。但表格最上面兩列提醒我們,合併和專家之間還有一大段距離;ViT-B/32 上,專家平均 90.5,TIES 是 73.6。
作者也做了一個不用驗證集的固定配方,、。這組數字是在參數高效微調的設定上挑的,再拿去全參數微調的模型上測。和任務算術建議的 相比,TIES 在 ViT-B/32 上是 72.4 對 60.4,ViT-L/14 是 86.0 對 83.3,T5-large 是 74.4 對 73.5;T5-base 則反過來,69.7 對 73.2,TIES 輸了。
任務數量的影響也是重點。作者把合併的任務數從 2 個逐步增加,任務越多,TIES 領先任務算術的幅度越大,這和前面「模型越多,正負號衝突越多」的觀察一致。
這組任務數分析用七個 T5-large 任務,每個任務數最多抽十種子集,縱軸先把各任務分數除以專家分數,再在本次合併的任務上平均。兩個任務時 TIES 與任務算術都接近 1;任務增加後兩者都下降,TIES 掉得較慢。它和 Task Arithmetic 筆記中「每次都在全部八個任務上評測」的圖,平均的範圍不同,所以曲線方向也不同。
沒看過的任務呢?
作者把七個任務合併好的 T5,拿到六個未參與微調的資料集評測,包括 Cosmos QA、Social IQA、QuAIL 的問答,WiC 的詞義,以及 COPA、H-SWAG 的句子補完。T5-base 上,最強比較方法 RegMean 是 34.3,TIES 是 35.3;T5-large 則從 36.0 到 40.4。這裡改善的是對這六個保留任務的泛化,與前面合併任務內的七十幾分不是同一組考題。
同任務的多個 checkpoint 也會互相干擾。作者從 Hugging Face 取每個任務十個 BERT 模型,RTE 上 TIES 72.2、任務算術 71.8;MRPC 是 86.8 對 86.0;WNLI 則是 58.8 對 59.2。TIES 在多數設定更好,仍有方法排名反過來的情況。
每一步都有用嗎
作者逐一拿掉 TIES 的元件。少了係數縮放(直接用 )和不相交平均,影響最大,T5-base 上分別少 2.5 和 1.9 個百分點,(IA) 上分別少 5.2 和 3.2。修剪和選正負號拿掉也會變差,只是幅度小一些。
這組消融用驗證分數,完整方法是 T5-base 74.5、(IA) 70.7,和前面主表的測試平均分開看。拿掉 Elect 時,作者仍排除被修剪的 0,只把正負值一起平均;拿掉 Disjoint Mean 時,則保留方向篩選,卻讓被修剪位置的 0 進入分母。這樣才能分辨「方向相消」與「被零值稀釋」各自造成多少損失。
另一組實驗直接檢驗「方向」有多重要。把任務向量中絕對值最大的 20% 或 30%,以機率 翻轉正負號,表現隨 單調下降;翻轉其餘 70% 到 80% 的小值,幾乎沒有影響。大的值方向錯了,任務就壞了。
如果正負號都選對
最後作者問了一個假設性的問題。如果每個參數的正負號都選對,合併能做到多好?
他們在十一個 (IA) 任務上另外訓練一個多任務模型,直接拿它的正負號當作「正確答案」,跳過投票。這樣合併出來的模型是 72.0%,多任務模型是 73.1%,只差 1.1 個百分點;TIES 自己投票的版本是 66.4%。
作者的結論是,只要能拿到正確的方向,合併幾乎能追上多任務訓練。附錄裡他們也試了用少量資料去估計這個正負號向量。
但 oracle 已經看過多任務訓練結果,用途是量還有多少改善空間。附錄改成每個任務 32 筆資料估計符號,從頭訓練只能到 66.5,從平均模型初始化則到 67.7,完整 oracle 是 72.0。只要少量資料就能可靠選對方向,仍然是一項待解問題。
結論
TIES-Merging 用三個很便宜的步驟處理任務向量相加時的干擾。小的變化丟掉,方向用總量投票,只平均站在同一邊的值。固定配方只需要相容的微調權重與共同基底;想挑更合適的配方,就要把驗證評測的成本一起算進去。
它的實驗也把邊界畫得很清楚。合併方法之間的差距是幾個百分點,合併和專家之間的差距常常是十幾個百分點。
一年多後,Yadav 和 Google 的合作者把合併放大到 640 億參數重新測了一次,發現到了大模型,各種合併方法的差別越來越小。