原始論文
Editing Models with Task Arithmetic
- 發表版本
- ICLR 2023會議
- arXiv 首次提交
- arXiv:2212.04089
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingtaskarithmetic2022,
  title = {{Editing Models with Task Arithmetic}},
  author = {Gabriel Ilharco and Marco Tulio Ribeiro and Mitchell Wortsman and Suchin Gururangan and Ludwig Schmidt and Hannaneh Hajishirzi and Ali Farhadi},
  year = {2022},
  eprint = {2212.04089},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.04089}
}
預訓練模型拿到手,通常還要改一改。讓它在某個任務上更好、讓它少說一些有毒的話、讓它跟上新的資料,這些都屬於論文說的「編輯」。
最常見的編輯方法是微調。微調一次,就多一個模型;想要模型同時會兩件事,常見做法是把兩份資料湊在一起做多任務訓練。每增加一種能力,資料與訓練流程又得調整一輪。
華盛頓大學、Microsoft Research 與 AI2 的 Ilharco、Ribeiro、Wortsman 等人,之前剛做完 WiSE-FT 和 Model Soups,都在研究權重的線性混合。這次他們換一個角度,把「微調改了什麼」單獨拿出來,當成一個向量來操作。
定義問題
令 是預訓練權重, 是在任務 上微調後的權重。任務向量(task vector)定義為兩者的差:
這是一個和整個模型一樣大的向量,記錄為了任務 ,每個權重往哪個方向移、移了多少。
把任務向量加回某組權重 ,可以帶一個縮放係數 :
、 時,就剛好回到微調後的模型。 由保留的驗證資料決定。
這裡有一個前提。任務向量是逐個權重相減,所以必須是同一個架構,而且微調時不能多出新的參數。作者因此選了兩類「開放式」的模型,一類是開放詞彙的影像分類器(如 CLIP,換任務只要換類別名稱,用文字編碼器生出分類頭),一類是 text-to-text 的語言模型(如 T5、GPT-2)。
這些向量能不能像數字一樣相加、相減,讓模型的行為也跟著照做?
解決問題
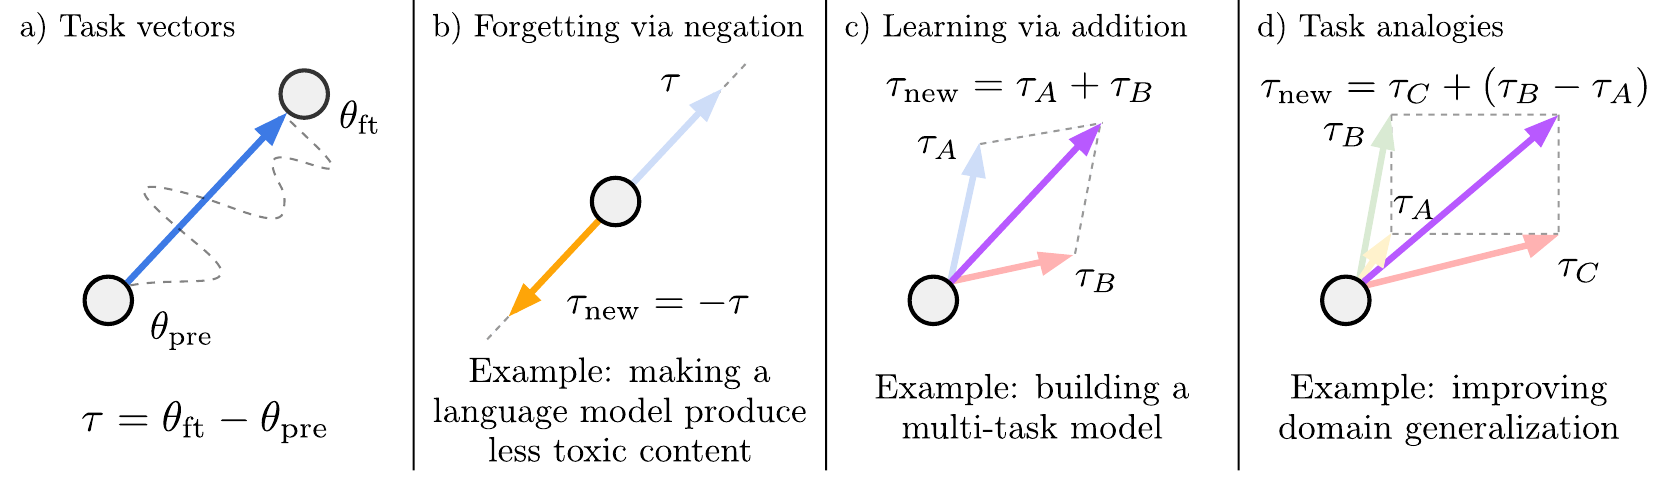
作者研究三種運算,全都是逐個權重做的:
- 取負號(遺忘):。從預訓練權重往微調的反方向走,模型在那個任務上變差,其他任務盡量不受影響。
- 相加(學習):。把幾個任務的向量加起來,得到一個同時處理這些任務的模型。
- 類比:如果四個任務滿足「A 之於 B,如同 C 之於 D」,就用 去改善 D,即使 D 幾乎沒有資料。
三種運算最後都是 。整個編輯只是向量運算,推論時的記憶體和計算量都和原本的模型一樣。
這裡很容易把「任務相加」和「平均兩個微調模型」混在一起。設 、,我們有
直接平均等於任務算術取 ;取 則保留兩個完整的微調改動。例如基底參數是 ,兩個任務分別改成 和 ,平均得到 ,任務相加得到 。對大網路而言,尺度差一倍足以改變成績,所以係數選擇是方法的一部分。
類比聽起來最抽象,舉論文的例子比較好懂。想做 Yelp 評論的情感分類,手上卻只有 Amazon 評論的情感標註,Yelp 只有沒標註的文字。作者這樣組:
是在 Amazon 上做情感分類學到的;括號裡兩個向量,是分別在 Yelp 和 Amazon 的文字上做語言模型訓練學到的,不需要標註。括號的差,大致就是「從 Amazon 換到 Yelp」這個領域變化的方向。
討論
取負號:忘掉一個任務
影像分類用 CLIP,目標任務有八個資料集,汽車型號(Cars)、紋理(DTD)、衛星影像(EuroSAT、RESISC45)、交通號誌(GTSRB)、手寫數字(MNIST)、場景(SUN397)、門牌數字(SVHN)。對照任務是 ImageNet,用來確認其他能力沒被弄壞。
ViT-L/14 減去任務向量之後,八個目標任務的平均準確率從 64.8% 降到 19.0%,掉了 45.8 個百分點;控制任務 ImageNet 從 75.5% 降到 72.9%,代價是 2.6 個百分點。作為對照,改成在目標任務上做梯度上升(把損失往上推),目標任務也會變差,但 ImageNet 跟著嚴重退步到 16.3%;加一個大小相同的隨機向量,則對目標任務效果很小。
文字生成上,作者在 Civil Comments 毒性分數高於 0.8 的留言上微調 GPT-2 Large,得到「說有毒的話」的任務向量,再把它減掉。生成內容被判定為有毒的比例從 4.8% 降到 0.8%,WikiText-103 的困惑度從 16.4 變成 16.9。梯度上升同樣能降毒性,但困惑度壞到不能用。
這組實驗用固定的爭議性前綴產生 1,000 段文字,再用 Detoxify 分類器評分; 是在困惑度惡化不超過 0.5 的條件下挑出的最大值。對照的「直接用無毒留言微調」得到 1.8% 毒性比例、17.2 困惑度,取反向量在這組取捨上更好。附錄換過其他提示與 RealToxicityPrompts,也量了不同大小的 GPT-2;困難提示上的毒性仍有改善空間。
因此這裡的「遺忘」是可測量的行為退化,證據是指定任務與提示下的輸出。若目的是移除某筆訓練資料或保證特定資訊無法被取出,這篇沒有提供那種形式的驗證。
相加:一個模型做好幾件事
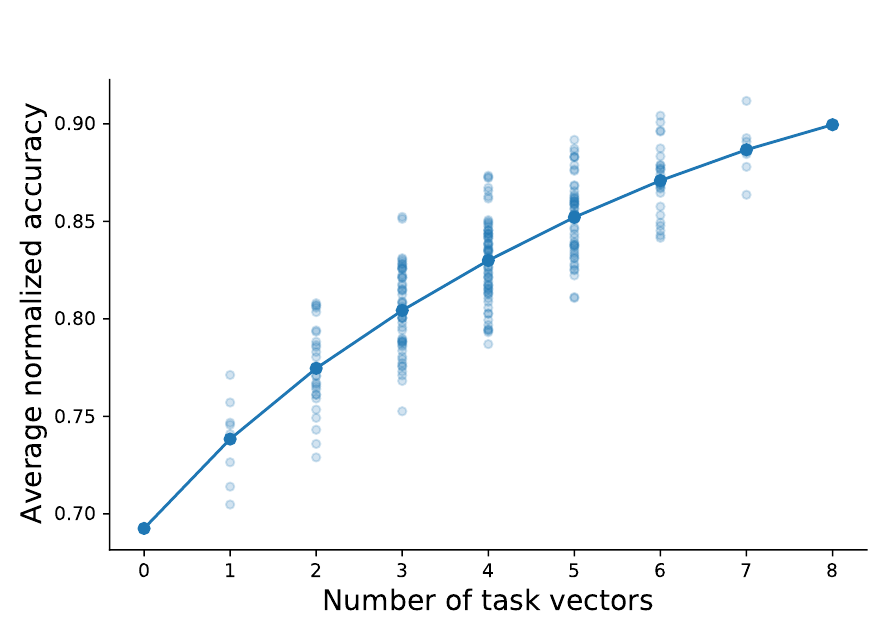
各任務的難度不同,作者用正規化準確率來比,也就是把合併模型在每個任務上的準確率,除以該任務單獨微調的模型的準確率。100% 代表和各自的專家一樣好。
兩兩相加,在那兩個對應任務上平均保留了專家 98.9% 的準確率。上圖換了一個量法,每個點是一種向量子集,但成績一律平均在全部八個任務上。作者掃過 種子集;0 個向量就是零樣本的預訓練模型,大約 69%,任務覆蓋增加後,整體平均也提高。八個任務向量都可供選擇時,找到的最佳多任務模型達到 91.2% 正規化準確率。
一個模型做八件事,和八個專家各自上場相比,差不到一成。但要注意,這也代表合併確實有損失,任務越多,越難完全保住。
正規化要先逐任務相除,再取平均。例如專家在兩個任務分別是 80% 和 100%,合併後是 72% 和 95%,保留率是 ;原始平均準確率則是 83.5%,兩者用途不同。論文的 91.2% 用來衡量保留各專家的程度。
係數用驗證資料從 0 到 1、每次增加 0.05 搜尋,所有相加向量共用一個 ,避免每個任務獨立調係數導致組合爆炸。附錄發現 0.3 到 0.5 是不少組合的好區域,但不同子集的最佳值差異仍大;可用向量越多,也未必全部放進去最好。
還有一個強基準不能漏。用全部八個任務資料直接做多任務微調,正規化準確率是 99.4%,高於任務算術最佳的 91.2%。任務算術換到的是模組化、不必重新取得各任務訓練資料,以及合併時免訓練的便利。資料可以集中、願意再訓練一次時,多任務微調仍值得優先比較。
自然語言方面,作者先在四個 GLUE 任務上微調 T5-base,再從 Hugging Face 上找了 427 個相容的公開模型,把它們的任務向量一個一個加到自己的模型上,用驗證集挑最好的那一個和係數。加上別人任務的向量,有時能讓目標任務比單純微調更好。
這次四個任務的平均分數從 78.1 到 78.6,MRPC 從 88.5 到 89.3,其餘增幅約 0.2 到 0.7。它是「搜尋很多候選,再選有幫助的向量」的結果。附錄另外合併六個公開 T5 checkpoint 的成對組合,涵蓋問答、摘要、情緒與文字生成,依任務使用 accuracy、exact match 或 ROUGE-2;不能拿同一個準確率數字概括全部文字任務。
類比:沒有目標標註也能學
前面的 Yelp 與 Amazon 例子,在多種大小的 T5 上都比只用 Amazon 情感資料微調好,接近直接在目標資料上微調的表現。作者發現情感分類的向量要給比較大的權重,所以用了兩個獨立的係數。
例如以 Amazon 為目標的 T5-base,只用 Yelp 的情緒標註微調是 90.8%,加入領域類比後是 92.7%,直接在 Amazon 標註上微調是 93.2%。兩個語言模型向量要有目標與輔助領域的無標註文字;「沒有目標標註」仍然用到了目標領域資料。類比的作用,是用這些無標註文字估計領域移動,再把已學到的情緒分類方向接過去。
另一組實驗用 ImageNet 和手繪素描資料集共有的 125 個類別,切成「照片/素描」×「兩組類別」四個子族群。要改善「素描的獅子」這一類,就用
平均下來,比預訓練模型高 3.4 個百分點,效果大約相當於替目標子族群多蒐集並標註一百張左右的訓練樣本。
為什麼加得起來
作者量了 CLIP 在九個任務上的任務向量,兩兩之間的餘弦相似度。大多數組合只有 0.01 到 0.03,幾乎互相垂直。比較高的都是語意相近的任務。MNIST 和 SVHN 都是認數字,是 0.18;GTSRB 的交通號誌也要認數字,和這兩者是 0.06;EuroSAT 和 RESISC45 都是衛星影像,是 0.05。
作者推測,正是這種接近垂直的關係,讓向量相加時互相干擾很少。這只是觀察上的推測;後來 Ortiz-Jimenez 等人進一步分析,認為關鍵在權重的「解耦」,而且這種性質是預訓練帶來的,在隨機初始化的模型上做不到。
另外兩個觀察對實作很有用。第一,學習率越大,相加的效果退化得越快,比單一微調模型更敏感;作者建議用任務向量時,微調的學習率要保守一點。第二,任務向量在微調早期就朝最終的方向收斂,只微調幾百步、拿中間的任務向量來加,準確率就差不多飽和了。
限制
作者自己列的限制很直接。任務向量只能用在同一個架構上;所有實驗也都是從同一個預訓練權重出發的模型。
他們也注意到,這個限制在實務上沒那麼嚴格。寫論文的時候,Hugging Face 上已經有三千多個從同一個 BERT-base 微調出來的模型,從同一個 T5-small 出發的也有八百多個。
結論
任務算術把微調的結果寫成一個向量,然後告訴我們,這些向量可以加、可以減、可以做類比,模型的行為大致也跟著照做。
它沒有發明新的訓練方法,用的仍然是一般的微調;新的是看待微調結果的方式。之後的 TIES-Merging、DARE 都從這個框架出發,各自處理向量相加時的干擾。
下次在 Hugging Face 上看到一個從你熟悉的基底微調出來的模型,可以先把它和基底相減,看看那個向量長什麼樣子。