原論文
Muon is Scalable for LLM Training
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2502.16982
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersmuonscalable2025,
  title = {{Muon is Scalable for LLM Training}},
  author = {Jingyuan Liu and Jianlin Su and Xingcheng Yao and Zhejun Jiang and Guokun Lai and Yulun Du and Yidao Qin and Weixin Xu and Enzhe Lu and Junjie Yan and Yanru Chen and Huabin Zheng and Yibo Liu and Shaowei Liu and Bohong Yin and Weiran He and Han Zhu and Yuzhi Wang and Jianzhou Wang and Mengnan Dong and Zheng Zhang and Yongsheng Kang and Hao Zhang and Xinran Xu and Yutao Zhang and Yuxin Wu and Xinyu Zhou and Zhilin Yang},
  year = {2025},
  eprint = {2502.16982},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2502.16982}
}
Muon はあるコンテストで名を上げた。
NanoGPT speedrun は、Keller Jordan が GitHub で運営している公開コンテストだ。ルールは、8 枚の H100 で言語モデルを FineWeb の検証セットで loss 3.28 まで学習させ、かかった時間の短さを競うというもの。3.28 は Andrej Karpathy が GPT-2 small を再現したときに達した成績だ。2024 年 10 月 15 日、Jordan はオプティマイザを AdamW から自分で設計した Muon に替え、学習速度を一気に 35% 上げて記録を更新した。その後の 2 か月で、7 人の研究者がさらに 12 回新記録を出し、どれも Muon を使い続けていた。
2024 年 12 月、Jordan は Muon の設計を紹介するブログ記事を書いた。記事の最後には、彼自身も答えられない問いが三つ挙げられている。200 億パラメータ、1 兆 token 以上に拡張できるか? Newton–Schulz 反復を大規模な GPU クラスタに分散できるか? 事前学習にしか効かず、ファインチューニングや強化学習ではだめなのではないか?
2 か月後、Moonshot AI(月之暗面、Kimi の開発元)がこの技術報告を発表し、最初の二つの問いと、三つ目の問いの一部に答えた。彼らは Muon を使って、アクティブパラメータ 30 億、総パラメータ 160 億の MoE モデルをゼロから学習させ、5.7 兆 token を読ませて、Moonlight と名付けた。
Muon そのものには論文がない。そこでこのノートでは、まず Jordan のブログから Muon をきちんと説明し、次に Moonshot AI が規模を広げるために補った二つのことを見て、最後に「約 2 倍の計算効率」という主張がその後どう検証されたかを見る。
問題の定義
Muon とは何か
Jordan の定義はたった 4 行だ(ブログの Algorithm 2)。
最初の 2 行はモーメンタム付き SGD そのものだ。違いは 3 行目で、Muon はまずモーメンタム行列 を「直交化」してから更新に使う。 の特異値分解が なら、直交化はそれを に置き換えることで、方向(、)は残し、すべての特異値を 1 にする。NewtonSchulz5 は、行列積 5 ステップでこれを近似するプログラムで、後で分解して見る。
この操作は行列にしか意味がないので、Muon は隠れ層の 2D の重み、たとえば Transformer の注意の射影やフィードフォワード層にだけ使う。スカラーとベクトルのパラメータ(LayerNorm のゲイン、バイアス)、それに 2D ではあるが埋め込み層と最後の分類ヘッドは、AdamW に任せる。畳み込みカーネルは後ろの 3 次元を平坦化して行列にする。
実装では Nesterov 型のモーメンタムを使い、 を直交化に送る。モーメンタム係数は 0.95。ブログには Vlado Boza の実験も記録されていて、Q、K、V の三つの射影を別々に直交化したほうが、一つの行列にまとめるより効果が高かった。
なぜ直交化するのか
Jordan の経験的な観察では、SGD のモーメンタムと Adam が Transformer の 2D の重みに対して計算する更新は、どちらも条件数がとても高く、ほぼ低ランクの行列になっている。更新全体が少数の特異方向に支配され、ほかの方向の成分は無視できるほど小さい。彼の推測では、それらの小さな方向は小さくても学習には重要で、直交化はすべての方向を同じ大きさに引き上げるので、こうした「まれな方向」を増幅することになる。
もう一つの説明は、Jeremy Bernstein と Laker Newhouse の 2024 年の Old Optimizer, New Norm から来ている。彼らはオプティマイザを「あるノルムの制約のもとで、勾配に沿って最も急な一歩を踏み出すもの」と見る。各座標の大きさを制限する( ノルム)と、最も急な一歩は勾配の sign を取ることになる。行列全体のスペクトルノルム(最大特異値)を制限すると、最も急な一歩は になる。EMA を切った Adam は前者に退化し、累積を切った Shampoo はちょうど後者になる。
重み行列は隠れベクトルに作用する線形作用素なので、それがどれだけ変えられたかをスペクトルノルムで測るのは理にかなっている。Moonshot AI も論文でこの見方を採り、Muon のノルム制約は Adam より合理的だと考えている。
規模を広げるとどうなるか
Muon は 1.5B 以下のモデルでは目覚ましかった。Jordan は Muon で 1.5B のモデルを GPT-2 XL の HellaSwag 水準まで学習させ、8×H100 で 10 時間かかった。AdamW なら 13.3 時間かかる。しかしこれらはどれも小さなモデル、短い学習だった。
Moonshot AI がモデルと token 数を大きくすると、Muon の AdamW に対する優位が縮んでいくことがわかった。この論文はその原因を突き止め、数千億から数兆 token の学習で、Muon を別途調整せずにそのまま使えるようにすることを目指している。
問題の解決
Newton–Schulz:SVD を使わない直交化
SVD なら を直接計算できるが、GPU では遅すぎる。Shampoo の実装でよく使われる coupled Newton 反復は、Jordan によれば float32 でないと安定せず、やはり遅い。Newton–Schulz 反復は行列積だけを使い、bfloat16 でも安定して実行できる。
1 ステップの反復が行列に何をするかを見てみよう。 とすると、1 ステップの Newton–Schulz は次のとおりだ。
と はそのままで、各特異値 が 5 次多項式 に送られるだけだ。 回反復するのは、 を 回続けて適用することにほかならない。
だから二つの条件が成り立ちさえすれば、反復は行列を へと押しやる。
- すべての特異値が最初に に収まっていること。まず行列をその Frobenius ノルムで割ればよい。直交化は全体のスケーリングを気にしない。
- 係数をうまく選び、 を繰り返し適用すると の値がすべて 1 へ押しやられるようにすること。
でも収束はする。しかし Jordan が気にしていたのはステップ数だ。 なので、 が大きいほど、とても小さな特異値が速く増幅される。彼はさらに、最終的な特異値はちょうど 1 である必要はなく、0.7〜1.3 の間に収まっていれば学習の loss 曲線にも影響しないことに気づいた。そこでこの許容範囲のもとで をできるだけ大きくし、勾配法で を得た。これなら 5 ステップで足りる。
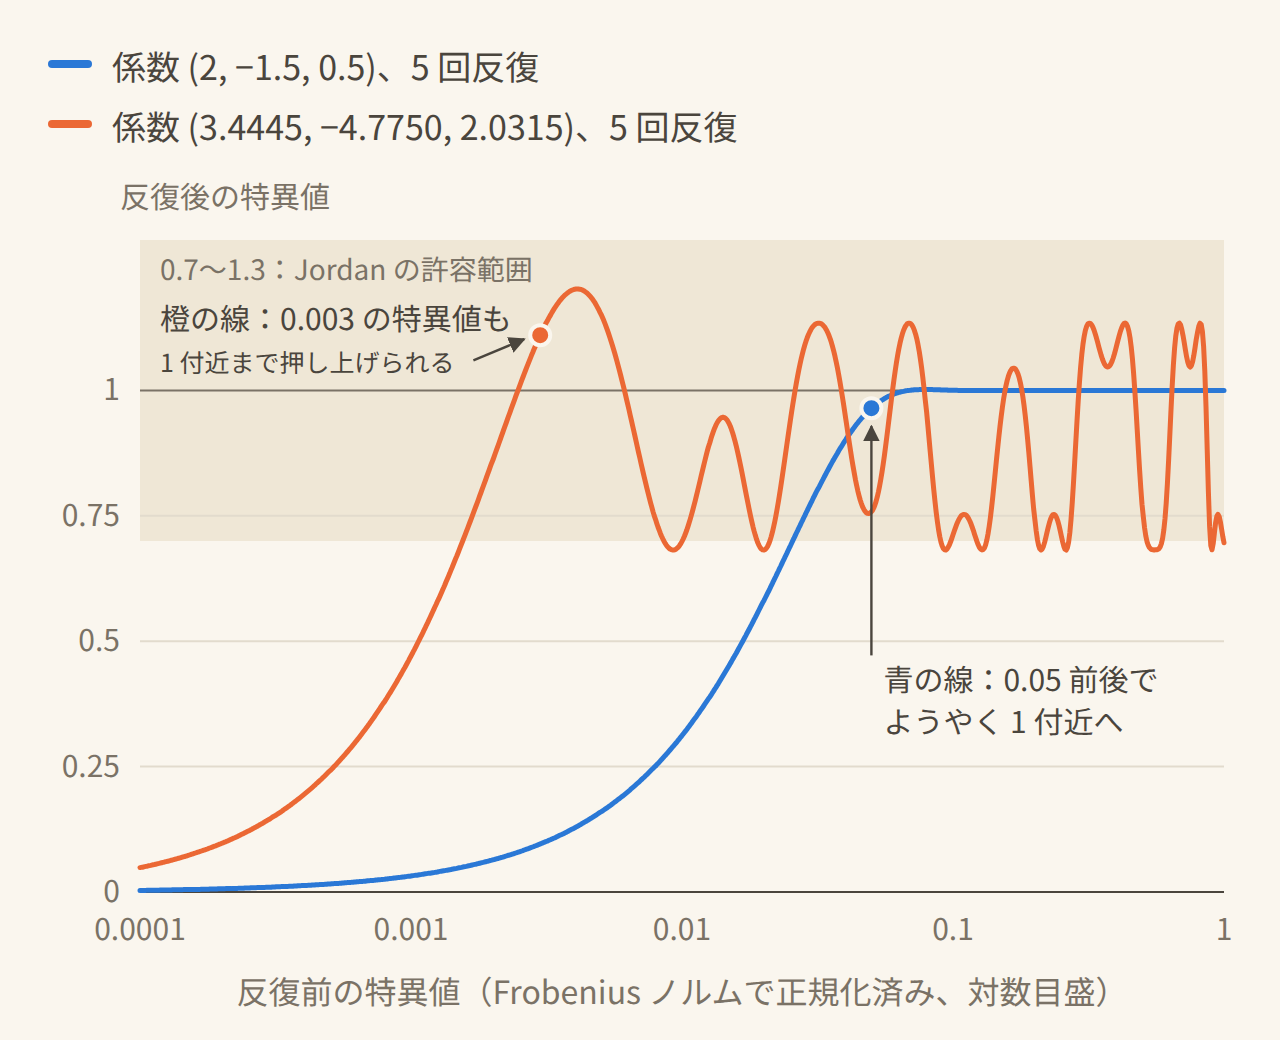
青い線は保守的な係数で、1 への収束はきれいだが、特異値が 0.05 前後ないと押し上げられない。それより小さな特異値は 5 ステップの後もまだ小さく、直交化が終わっていない。橙の線は Jordan が調整した係数で、0.003 ほどの小さな特異値まで 1 付近に押し上げられるが、その代わり結果は約 0.68〜1.2 の間で揺れる。Muon が使っているのはこの橙の線で、計算しているのは厳密には「特異値がおおむね近い」 だ。
公式実装(KellerJordan/Muon)はこれだけだ。
def zeropower_via_newtonschulz5(G, steps: int):
    a, b, c = (3.4445, -4.7750,  2.0315)
    X = G.bfloat16()
    if G.size(-2) > G.size(-1):
        X = X.mT                                   # X @ X.mT が小さいほうの側になるようにする
    X = X / (X.norm(dim=(-2, -1), keepdim=True) + 1e-7)   # 特異値を [0, 1] に収める
    for _ in range(steps):
        A = X @ X.mT
        B = b * A + c * A @ A
        X = a * X + B @ X                          # aX + b(XXᵀ)X + c(XXᵀ)²X
    if G.size(-2) > G.size(-1):
        X = X.mT
    return X
計算コストも高くない。()の行列では、1 ステップの反復で約 回の浮動小数点演算になる。Jordan の見積もりでは、追加のオーバーヘッドは最大でも で、 は反復ステップ数、 はモデルの次元、 はバッチあたりの token 数だ。NanoGPT speedrun の 、 ではオーバーヘッドは約 0.7%、Llama 405B の 、 約 1,600 万に替えると約 0.5% になる。
一つ目:重み減衰
Jordan の原版の Muon には重み減衰がない。Moonshot AI は規模を広げたとき、重みと各層の出力の RMS が大きくなり続け、最後には bfloat16 の高精度な範囲を超えてしまうことに気づいた。彼らの解決策は、AdamW と同じ分離型の重み減衰を加えることだ。
効果を確かめるため、彼らは 8 億パラメータのモデルに 1,000 億 token を読ませた。これは彼らのスケーリング則から導いた最適 token 数のおよそ 5 倍だ。重み減衰なしの Muon は最初は最も速く収束し、24,000 ステップ前後では重み減衰を加えた版を 0.023 リードしていた。その後、一部の重みが大きくなりすぎ、66,000 ステップでは逆に 0.017 追い越された。重み減衰を加えた Muon は、この過剰学習の区間で、原版の Muon と AdamW の両方に勝った。
後の独立した評価もこれを支持している。EPFL の Semenov らは 124M から 720M のモデルで二つの版を比べ、原版の Muon はモデルが大きくなるにつれて性能が落ちたが、この論文の版(彼らは D-Muon と呼ぶ)はすべての設定で安定していた。
二つ目:各行列の更新を同じ大きさにする
二つ目の問題は直交化そのものに潜んでいる。 の特異値はすべて 1 なので、その Frobenius ノルムの 2 乗はランク に等しい。 のフルランク行列のランクは なので、各要素の二乗平均平方根(RMS)は次のようになる。
これが論文の Lemma 1 だ。学習中に測った Muon の更新の RMS も、確かにこの理論値に近い。
隠れ次元 のモデルに当てはめて計算してみよう。注意の query 射影は で、更新の RMS は約 。従来の MLP の第 1 層は で、更新の RMS は約 しかなく、半分になる。同じ学習率のもとで、形の違う行列は 1 ステップごとに実際に進む距離が違う。
論文は問題が起きる二つの状況を挙げている。 がとても大きい行列(たとえば大きな dense MLP)では、更新が小さすぎて学習が進まない。 がとても小さい行列(たとえば GQA や MLA で各 KV head を独立したパラメータとして扱う場合)では、逆に更新が大きすぎて学習が不安定になる。
修正の方法は、各行列の更新に を掛けて、Lemma 1 を打ち消すことだ。Moonshot AI はさらに一歩進めた。Muon は行列しか扱わないので、埋め込み層、分類ヘッド、RMSNorm は相変わらず AdamW に任せることになり、二つのオプティマイザは同じ学習率と重み減衰を共有するのが望ましい。AdamW の更新の RMS は彼らの経験では 0.2〜0.4 くらいなので、Muon の更新もこの範囲にスケーリングする。
こうすると、どの行列の更新の RMS も 0.2 になり、Muon は AdamW 向けに調整した学習率と重み減衰をそのまま使える。これが論文で最も実用的な式だ。Moonlight のオープンソースの例では adjusted_ratio = 0.2 * math.sqrt(max(A, B)) の 1 行だけで、これで Muon の項の学習率を大きくする。重み減衰の項に掛けるのは元の lr のままだ。
0.2 という数字には実験の裏づけがある。小さなモデルで 2,000 ステップ(約 20 億 token)学習させ、Muon の更新の RMS を 0.05、0.1、0.2、0.4、0.8 にすると、検証 loss はそれぞれ 3.503、3.374、3.325、3.314、3.543 で、AdamW は 3.679 だった。0.2 と 0.4 はほとんど同じくらい良く、著者らは 0.2 を選んだ。
別の実験では、RMS を制御する三つのやり方を比べた。形の違いを際立たせるため、800M モデルの SwiGLU を の 2 層 MLP に替え、4B token の時点で評価している。
| やり方 | 検証 loss | MLP の重みの RMS |
|---|---|---|
| 一律に を掛ける | 2.812 | 0.0252 |
| 出力を直接 RMS 0.2 に正規化 | 2.789 | 0.0501 |
| を掛ける | 2.789 | 0.0489 |
原論文 Table 1 をもとに整理。
隠れ次元 しか見ない一つ目のやり方では、 の MLP で更新が後の二つの半分しかなく()、loss も高い。後の二つは同じくらい良く、論文はコストの低い三つ目を選んだ。
ほかのハイパーパラメータはそのままだ。Newton–Schulz 反復を 10 ステップにすると直交化はより正確になるが、学習結果は良くならなかったので 5 ステップを使う。モーメンタムも調整したが一貫した改善はなく、0.95 のままにしている。
分散 Muon
大規模な学習では、通常 ZeRO-1 でオプティマイザの状態を各データ並列(DP)ノードに分割し、各ノードは自分の担当するパラメータの断片だけを更新する。AdamW は要素ごとの演算なのでこれで問題ないが、Muon は行列全体がないと直交化できない。
論文の Distributed Muon は、ZeRO-1 に 2 ステップを加える。
- いつもどおり勾配を各ノードに reduce-scatter し、ローカルの断片のモーメンタムで更新する。
- 追加:DP グループ内で、更新後の勾配の断片を gather して行列全体にする。
- 追加:行列全体で Newton–Schulz を実行し、自分の断片に属する結果だけを残して更新を適用する。
- いつもどおりパラメータを all-gather する。
メモリについては、Muon のモーメンタムは一つ、AdamW は二つなので、オプティマイザが追加で使うメモリは分散 AdamW の半分だ。通信については、追加の gather はローカルの断片だけに関わり、しかも bfloat16 で行うので、総通信量は分散 AdamW の 1〜1.25 倍だ。レイテンシについては、オプティマイザのステップは通常、順伝播と逆伝播の時間の 1%〜3% しか占めず、gather も計算と重ねられる。著者らによれば、彼らのクラスタではレイテンシにはっきりした差は見られなかった。
議論
スケーリング則:約 2 倍
公平にするため、著者らはまず AdamW のスケーリング則を調べた。複数の計算予算のもとでモデルサイズと token 数を変えて最適な組み合わせを探し、さらに学習率とバッチサイズをグリッドサーチし、これを 2〜3 回繰り返した。最終的に得たのは Llama アーキテクチャの dense モデル 5 個で、399M から 1.5B(埋め込みを除く)、token 数は 8.9B から 38.9B、学習率は 9.5e-4 から 8.3e-4 だ。Muon は更新の RMS をすでにそろえているので、AdamW の最適なハイパーパラメータをそのまま使う。
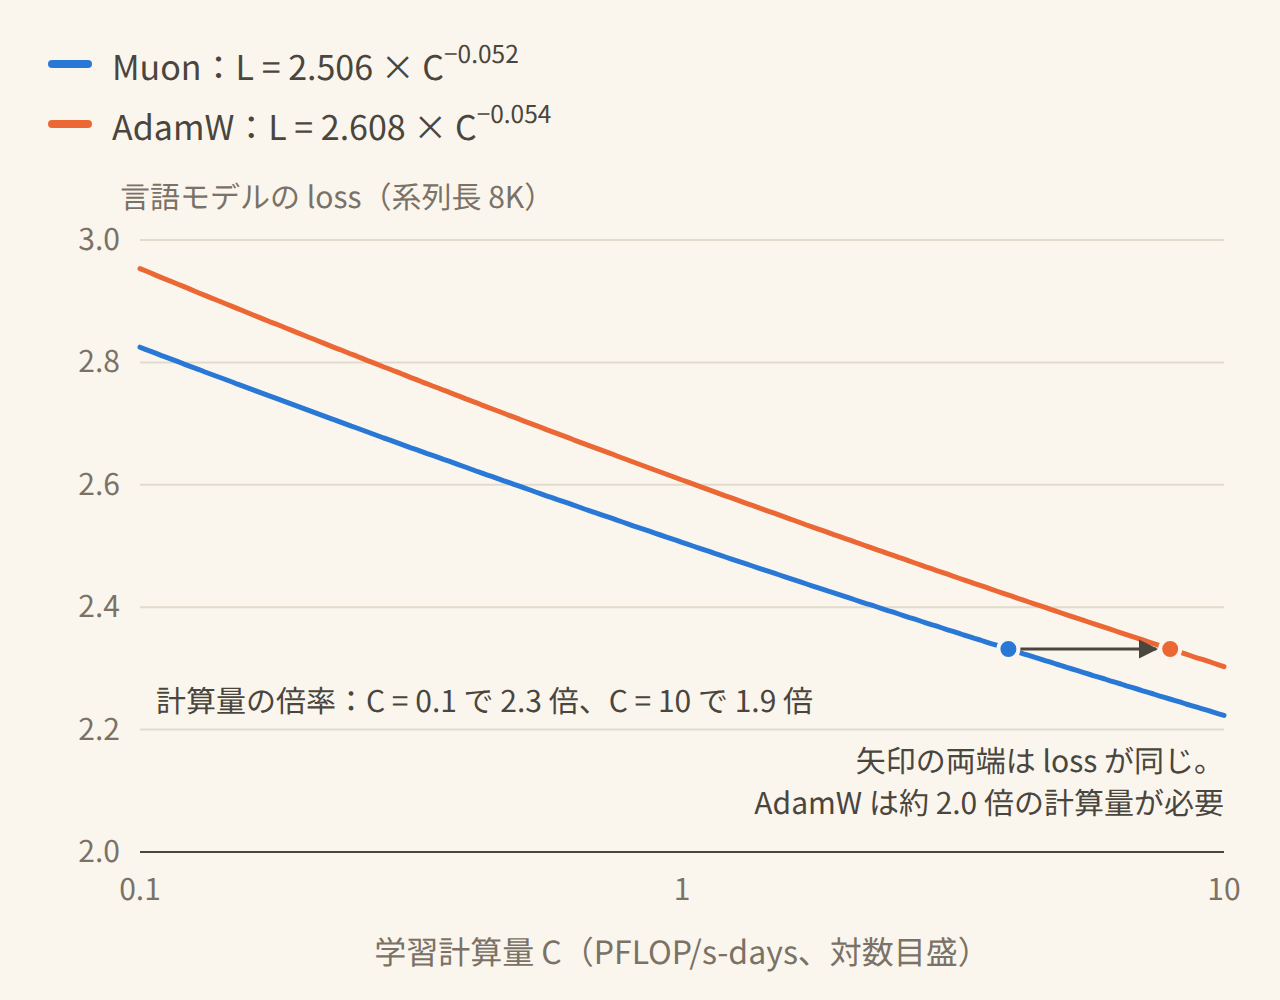
二本の当てはめ式は、Muon が 、AdamW が だ。論文の結論は、compute-optimal な設定では、Muon は約 52% の学習計算量で AdamW の loss に達する、つまり約 2 倍の計算効率だというものだ。
この二本の式で自分で計算してみると、同じ loss での計算量の倍率は、0.1 PFLOP/s-days で約 2.3 倍、最大の実験点付近の 4 PFLOP/s-days で約 2.0 倍、10 PFLOP/s-days に外挿すると約 1.9 倍まで下がる。AdamW の指数がわずかに大きいので、二本の線は少しずつ近づいていく。倍率が計算量とともに縮むことは、本稿が論文の当てはめ式から計算したもので、論文では議論されていない。
この実験には、覚えておくべき条件があと二つある。表の token 数はパラメータ数の約 22〜26 倍で、Chinchilla の最適比(20 倍)に近い。つまり試したデータ量はこの一種類だけだ。AdamW の学習率はこのスケーリング則の手順の中で選ばれたもので、8e-4 から 1e-3 の間にある。この 2 点は、後にどちらも議論の的になった。
Moonlight:オプティマイザだけを替えた比較
本番のモデルは DeepSeek-V3-Small のアーキテクチャを踏襲し、アクティブ 2.24B、合計 15.29B パラメータ(埋め込みを含めると 3B/16B)で、マルチ token 予測を外すなど何か所か小さく変えている。最長コンテキストは 8K、重み減衰は全体を通じて 0.1。学習は 3 段階に分かれる。
- 最初の 33B token:2,000 ステップのうちに学習率を 4.2e-4 まで線形に上げ、バッチは 2,048 件。
- 33B から 5.2T:cosine で 4.2e-4 から 4.2e-5 まで下げ、200B token 以降はバッチを 2 倍の 4,096 件にする。
- 最後の 500B token:学習率をまず 1e-4 まで上げ、それから 0 まで線形に下げ、最も品質の高いデータに切り替える。数学、コード、推論が中心だ。
最もきれいな比較は Moonlight-A で、学習設定はまったく同じまま、オプティマイザだけを AdamW に戻したものだ。どちらも 1.2T token の時点の途中チェックポイントで比べる。
| 評価 | AdamW | Muon |
|---|---|---|
| MMLU | 60.2 | 60.4 |
| MMLU-pro | 26.8 | 28.1 |
| BBH | 45.3 | 43.2 |
| HumanEval | 29.3 | 37.2 |
| MBPP | 49.2 | 52.9 |
| GSM8K | 43.8 | 45.0 |
| MATH | 16.1 | 19.8 |
原論文 Table 4 から抜粋。どちらも 1.2T token、学習率がまだ減衰しきっていない途中のチェックポイント。
MMLU はほとんど同じで、BBH はむしろ AdamW が高い。差が最も大きいのはコードと数学で、HumanEval は 7.9 ポイント高い。著者らも Muon が数学とコードで目立って良いことに特に触れているが、理由は今後の研究に委ねている。
5.7T token を読み終えた Moonlight の MMLU は 70.0 だ。パラメータ規模が同じで、同じく 5.7T token を読み、AdamW で学習させた DeepSeek-V2-Lite は 58.3、18T token を読んだ Qwen2.5-3B は 65.6。これらは別々のチームが別々のデータで作ったもので、言えるのは Moonlight が学習計算量と成績のトレードオフで最前線に位置するということまでだ。オプティマイザの比較実験として扱うことはできない。
学習はとても順調で、loss や勾配ノルムのスパイクはなかった。付録には細部が二つある。一つ目は、一部の層の最大注意ロジットが学習の初期に 100 以上まで上がり続けたことで、著者らは、AdamW のほうがこの値の制御で「より健全に振る舞う」と明記している。100 を超えるロジットは約 1 万分の 1 しかなく、その後ゆっくり下がった。二つ目は、RMSNorm のゲインのパラメータにも重み減衰を加える必要があることで、そうしないと各層の出力の RMS が大きくなりすぎる。
更新も重みも、より分散している
Muon は重みをより多くの方向へ学習させる。この直感は測ることができる。著者らは各重み行列の SVD エントロピーを計算した。
特異値が均等なほどエントロピーは 1 に近く、少数の特異値に支配されているとエントロピーは低い。1.2T token の事前学習の過程で、注意、エキスパート、共有エキスパート、ルーター、最初の dense 層など六つのグループの重みについて、どのチェックポイントでも Muon の平均 SVD エントロピーは AdamW より高かった。重み行列の 90% 超でも、Muon のエントロピーのほうが高い。差が最も大きいのは MoE のルーターで、著者らはこれをもとに、MoE のほうが Muon からより多くの恩恵を受けると推測している。
ファインチューニングでオプティマイザを替えるか
これは Jordan の三つ目の問いへの部分的な答えだ。著者らは 1.2T token の二つのチェックポイントを、それぞれ Muon と AdamW で、Tülu 3 の SFT データで 2 エポックファインチューニングした。
| 事前学習 → SFT | MMLU | HumanEval | GSM8K |
|---|---|---|---|
| Muon → Muon | 55.7 | 57.3 | 68.0 |
| AdamW → Muon | 55.3 | 53.7 | 62.1 |
| Muon → AdamW | 50.2 | 52.4 | 64.9 |
| AdamW → AdamW | 52.0 | 53.1 | 64.6 |
原論文 Table 6 から抜粋。
最初から最後まで Muon を使うのが最も良い。しかし事前学習とファインチューニングのオプティマイザが違うと、Muon にははっきりした優位がない。Muon で事前学習して AdamW でファインチューニングした場合、MMLU はむしろ最も低い。公開されている Qwen2.5-7B のベースモデルを Adam と Muon でそれぞれファインチューニングすると、両者はほぼ同じで、Muon の GSM8K はむしろ 4 ポイント低かった(89.8 対 85.8)。著者らの結論は、Muon の恩恵は主に事前学習にあるというものだ。この「事前学習とファインチューニングのオプティマイザの不一致」という現象は、未解決の問題として挙げている。著者らはまた、既存の事前学習チェックポイントの多くは AdamW で学習されていて、この不一致のせいで、それらが Muon から直接恩恵を受けるのは難しいとも述べている。
その後:Kimi K2 の QK-Clip
注意ロジットが上がる現象は、もっと大きなモデルで実際にトラブルになった。2025 年 7 月の Kimi K2 技術報告によれば、原版の Muon でアクティブ 9B、総パラメータ 53B の MoE を学習させたところ、最大注意ロジットはすぐに 1,000 を超えた。ロジットがこの桁になると、たいてい loss のはっきりしたスパイクを招き、発散することさえある。彼らの実験では、この問題は AdamW より Muon でよく起きた。彼らの仮説は、Muon の更新はすべての特異値が同じで実効ランクがフルなので、、 のスペクトルノルムが一緒に大きくなりやすい、というものだ。
解決策が QK-Clip だ。毎回の更新の後、各注意ヘッドについてこのバッチでの最大ロジット を見て、しきい値 を超えていれば、そのヘッドの 、 を一緒に縮める。スケーリング係数 は query と key の両側に均等に分ける(それぞれ を掛ける。MLA の RoPE 部分には別の規則がある)。変えるのは重みだけで、そのステップの順伝播と逆伝播の計算は変えず、しきい値を超えた少数のヘッドだけを動かす。
Muon に重み減衰、RMS の整合(つまりこの論文の式)、そして QK-Clip を加えたものを、まとめて MuonClip と呼ぶ。Kimi K2 はこれを使って、総パラメータ 1 兆、アクティブパラメータ 320 億のモデルに 15.5 兆 token を読ませた。 で、全体を通して loss のスパイクはなかった。QK-Clip が作用したのは最初の 7 万ステップだけで、その間に注意ヘッドの 12.7% で一度は発動した。その後、すべてのヘッドの最大ロジットは自然に 100 未満まで下がり、この保険は二度と動かなかった。
その後 Muon を採用したのは Moonshot AI だけではない。Zhipu AI の GLM-4.5(2025 年 8 月)は、単語埋め込み、バイアス、RMSNorm の重みを除くすべてのパラメータに Muon を使い、設定はこの論文のままで、5 ステップの反復、モーメンタム 0.95、更新の RMS を 0.2 にスケーリングしている。DeepSeek-V4 もパラメータの大部分を Muon に替えた。その注意には query と KV にもともと RMSNorm があってロジットが爆発しないので、QK-Clip は要らない。
「2 倍」はその後どうなったか
2 倍という数字は、何度も検証し直された。
Stanford の Wen ら(2025 年 9 月)は、各オプティマイザで完全なハイパーパラメータ走査を行ってから token 効率を比べた。彼らが測った Muon の AdamW に対する倍率は、130M から 520M で約 1.3〜1.4 倍、1.2B では約 1.1 倍まで下がる。彼らは付録で、この論文の二つの条件を名指ししている。一つは AdamW の学習率が低めで、400M から 1.5B で 8e-4 から 9e-4 を使っていたが、彼らが調整して得た最適値はもっと高いこと。もう一つは、Moonlight と Moonlight-A の比較が学習率の減衰しきっていない途中のチェックポイントで取られていることだ。彼らの実験では、Muon は序盤に大きくリードすることが多いが、減衰の段階で追いつかれる。
Essential AI の独立研究(2025 年 5 月、100M から 4B)の結論は、Muon は同じ loss に達するのに AdamW より 10%〜15% 少ない token で済むというものだ。その優位は、バッチを臨界バッチサイズよりはるかに大きくしても保たれ、むしろ大きくなる。NVIDIA も 2026 年 7 月に、30B から 72B の MoE、バッチあたり 2,500 万 token 以上の設定で、AdamW は大きなバッチで劣化し、Muon は持ちこたえることを確かめている。
まとめると、Muon の進歩は本物だが、調整済みの AdamW を相手にすると、token 効率の差は 2 倍よりずっと小さい。よりはっきりした優位は、大きなバッチでの学習にある。この論文の当時の 2 倍は、1× Chinchilla に近く、AdamW の学習率が低めのスケーリング則から来ていた。Moonlight 対 Moonlight-A の比較は、学習率が減衰しきっていない途中のチェックポイントで取られていた。
結論
Moonshot AI は Muon に分離型の重み減衰を補い、重みと出力の RMS が大きくなり続けないようにした。さらに を掛けて、各行列の更新の RMS を AdamW の 0.2 にそろえた。ZeRO-1 方式の分散実装も加えて、Muon は 5.7 兆 token の MoE 事前学習を無事に走りきり、しかも AdamW のハイパーパラメータをそのまま使えた。約 2 倍の計算効率のほうは条件付きで読む必要があり、後にベースラインを調整した研究が測ったのは 1.1〜1.4 倍だった。
Muon に替えたいなら、埋め込み層、分類ヘッド、LayerNorm、バイアスは AdamW に残し、それ以外の 2D の重みを Muon に任せる。使う実装がどちらのスケーリングかを確かめること。Moonlight 式なら AdamW の学習率をそのまま使えるが、Jordan 式なら走査し直す必要がある。手元にあるのが AdamW で事前学習したモデルなら、Muon でファインチューニングする前に小規模で試しておくとよい。
Jordan はブログの最後に、Muon が 200 億パラメータ、1 兆 token まで拡張できるかはわからないと書いていた。7 か月後、Kimi K2 はそれを使って 1 兆パラメータ、15.5 兆 token のモデルを学習させた。