原始論文
Muon is Scalable for LLM Training
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2502.16982
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizersmuonscalable2025,
  title = {{Muon is Scalable for LLM Training}},
  author = {Jingyuan Liu and Jianlin Su and Xingcheng Yao and Zhejun Jiang and Guokun Lai and Yulun Du and Yidao Qin and Weixin Xu and Enzhe Lu and Junjie Yan and Yanru Chen and Huabin Zheng and Yibo Liu and Shaowei Liu and Bohong Yin and Weiran He and Han Zhu and Yuzhi Wang and Jianzhou Wang and Mengnan Dong and Zheng Zhang and Yongsheng Kang and Hao Zhang and Xinran Xu and Yutao Zhang and Yuxin Wu and Xinyu Zhou and Zhilin Yang},
  year = {2025},
  eprint = {2502.16982},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2502.16982}
}
Muon 是在一個比賽裡成名的。
NanoGPT speedrun 是 Keller Jordan 在 GitHub 上維護的公開競賽。規則是用 8 張 H100,把語言模型訓練到 FineWeb 驗證集上 3.28 的 loss,比誰用的時間短;3.28 是 Andrej Karpathy 復現 GPT-2 small 時達到的成績。2024 年 10 月 15 日,Jordan 把優化器從 AdamW 換成自己設計的 Muon,訓練速度一口氣快了 35%,刷新紀錄。之後兩個月,7 位研究者又創下 12 次新紀錄,每一次都沿用 Muon。
2024 年 12 月,Jordan 寫了一篇部落格介紹 Muon 的設計。文章最後列了三個他自己也答不出來的問題:能不能擴展到 200 億參數、1 兆 token 以上?Newton–Schulz 迭代能不能分散到大型 GPU 叢集上?會不會只適用於預訓練,到了微調或強化學習就不行?
兩個月後,月之暗面(Moonshot AI,Kimi 的開發商)發表這份技術報告,回應前兩題和一部分的第三題。他們用 Muon 從頭訓練了一個 30 億啟用參數、160 億總參數的 MoE 模型,讀了 5.7 兆 token,取名 Moonlight。
Muon 本身沒有論文,所以這篇筆記先從 Jordan 的部落格把 Muon 講清楚,再看月之暗面為了放大規模補了哪兩件事,最後看「約 2 倍計算效率」這個主張後來被檢驗成什麼樣子。
定義問題
Muon 是什麼
Jordan 的定義只有四行(部落格的 Algorithm 2):
前兩行就是 SGD 加動量。差別在第三行,Muon 先把動量矩陣 「正交化」,再拿來更新。若 的奇異值分解是 ,正交化就是把它換成 ,方向(、)保留,所有奇異值都設成 1。NewtonSchulz5 是用五步矩陣乘法近似這件事的程式,後面會拆開來看。
這個操作只對矩陣有意義,所以 Muon 只用在隱藏層的 2D 權重上,例如 Transformer 裡的注意力投影與前饋層。純量與向量參數(LayerNorm 的增益、偏置),以及雖然是 2D 的嵌入層和最後的分類頭,都交給 AdamW。卷積核則把後三維攤平成矩陣。
實作上用的是 Nesterov 式動量,把 送進正交化,動量係數 0.95。部落格也記錄了 Vlado Boza 的實驗,把 Q、K、V 三個投影分開各自正交化,比合成一個矩陣效果好。
為什麼要正交化
Jordan 的經驗觀察是,SGD 動量和 Adam 對 Transformer 2D 權重算出來的更新,條件數都很高,幾乎是低秩矩陣。整個更新被少數幾個奇異方向主導,其他方向的分量小得可以忽略。他的推測是,那些小方向雖然小,對學習仍然重要,正交化把所有方向拉到一樣大,等於放大了這些「少見的方向」。
另一個說法來自 Jeremy Bernstein 與 Laker Newhouse 2024 年的 Old Optimizer, New Norm。他們把優化器看成「在某個範數限制下,沿梯度走最陡的一步」。限制每個座標的大小( 範數),最陡的一步就是對梯度取 sign;限制整個矩陣的譜範數(最大奇異值),最陡的一步就是 。關掉 EMA 的 Adam 會退化成前者,關掉累積的 Shampoo 則剛好是後者。
權重矩陣是作用在隱藏向量上的線性算子,用譜範數衡量它被改了多少比較合理。月之暗面在論文裡也採用這個觀點,認為 Muon 的範數限制比 Adam 合理。
放大之後會怎樣
Muon 在 1.5B 以下的模型上很亮眼。Jordan 用 Muon 把 1.5B 的模型訓練到 GPT-2 XL 的 HellaSwag 水準,花 10 個 8×H100 小時,AdamW 要 13.3 小時。可是這些都是小模型、短訓練。
月之暗面把模型和 token 數一放大,就發現 Muon 對 AdamW 的優勢在縮小。這篇論文要找出原因,並讓 Muon 在數千億到數兆 token 的訓練裡直接可用,不必另外調參。
解決問題
Newton–Schulz:不做 SVD 的正交化
SVD 能直接算出 ,但在 GPU 上太慢。Shampoo 實作常用的 coupled Newton 迭代,Jordan 發現要 float32 才穩,也慢。Newton–Schulz 迭代只用矩陣乘法,在 bfloat16 下就能穩定執行。
我們看一步迭代對矩陣做了什麼。設 ,一步 Newton–Schulz 是
和 原封不動,只有每個奇異值 被送進一個五次多項式 。迭代 次,就是把 連續套 次。
所以只要兩個條件成立,迭代就會把矩陣推向 。
- 所有奇異值一開始落在 內:先把矩陣除以它的 Frobenius 範數就行,正交化不在乎整體縮放。
- 選好係數,讓 反覆套用後把 裡的值都推向 1。
已經能收斂。但 Jordan 在意的是步數。, 越大,很小的奇異值被放大得越快。他還發現,最後的奇異值不必剛好等於 1,落在 0.7 到 1.3 之間,訓練的 loss 曲線也不受影響。於是他在這個容許範圍下把 盡量調大,用梯度法得到 ,五步就夠。
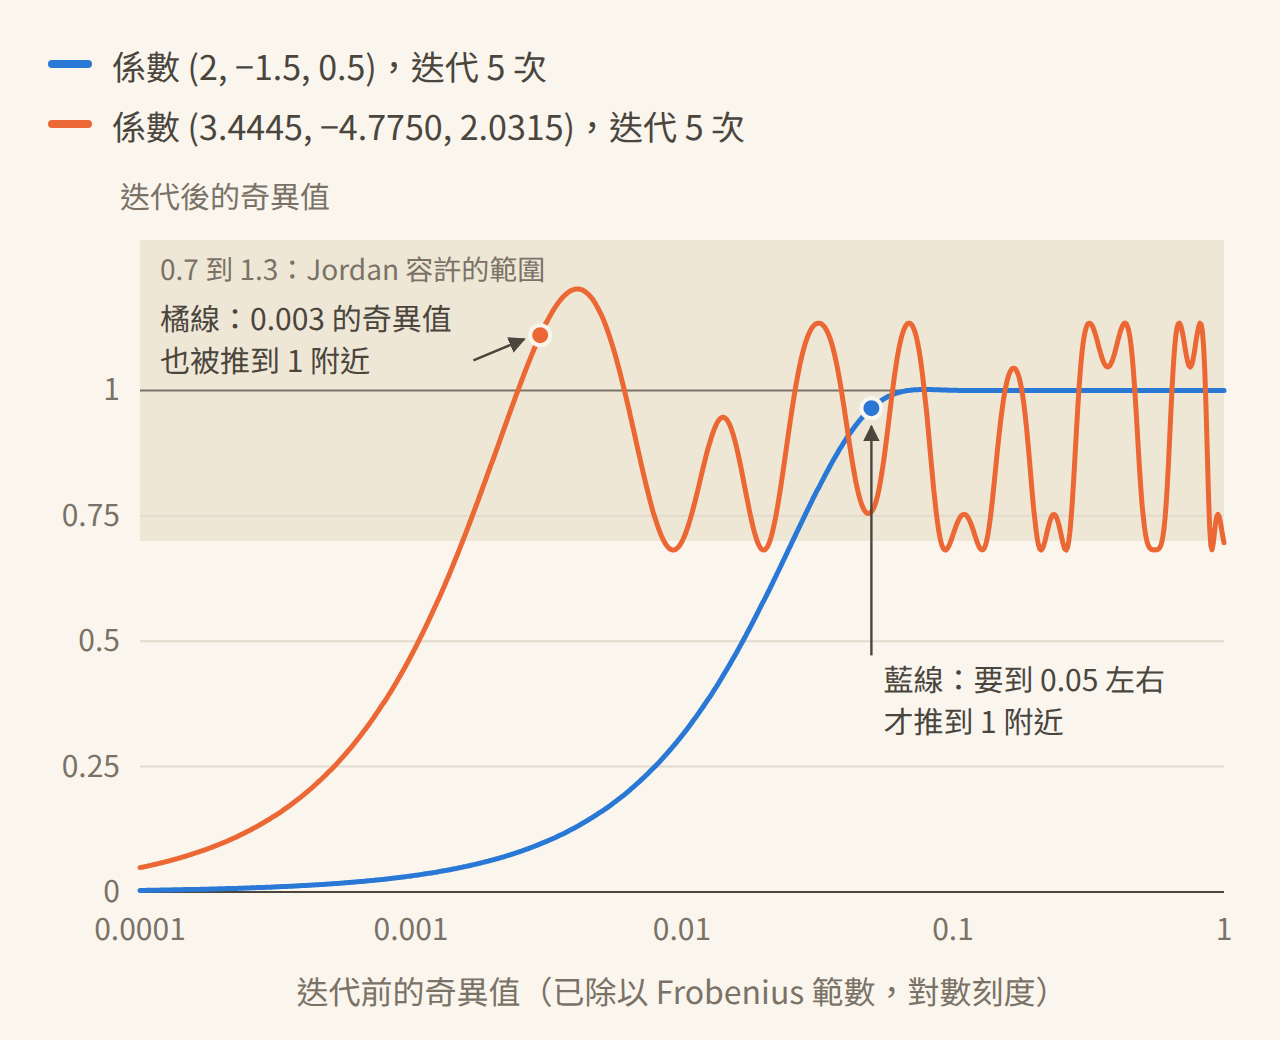
藍線是保守的係數,收斂到 1 很乾淨,但奇異值要有 0.05 左右才推得上去;更小的奇異值五步之後還是很小,正交化沒做完。橘線是 Jordan 調過的係數,小到 0.003 的奇異值也被推到 1 附近,代價是結果在約 0.68 到 1.2 之間擺盪。Muon 用的就是這條橘線,它算出來的嚴格說是「奇異值大致相近」的 。
官方實作(KellerJordan/Muon)就是這幾行:
def zeropower_via_newtonschulz5(G, steps: int):
    a, b, c = (3.4445, -4.7750,  2.0315)
    X = G.bfloat16()
    if G.size(-2) > G.size(-1):
        X = X.mT                                   # 讓 X @ X.mT 是較小的那一邊
    X = X / (X.norm(dim=(-2, -1), keepdim=True) + 1e-7)   # 奇異值壓進 [0, 1]
    for _ in range(steps):
        A = X @ X.mT
        B = b * A + c * A @ A
        X = a * X + B @ X                          # aX + b(XXᵀ)X + c(XXᵀ)²X
    if G.size(-2) > G.size(-1):
        X = X.mT
    return X
計算成本也不高。一個 ()的矩陣,每步迭代約 次浮點運算。Jordan 估算額外開銷最多是 , 是迭代步數、 是模型維度、 是每批 token 數。NanoGPT speedrun 的 、,開銷約 0.7%;換成 Llama 405B 的 、 約 1,600 萬,約 0.5%。
第一件事:權重衰減
Jordan 的原版 Muon 沒有權重衰減。月之暗面在放大規模時觀察到,權重與各層輸出的 RMS 會一路變大,最後超出 bfloat16 的高精度範圍。他們的解法是加上和 AdamW 一樣的解耦權重衰減:
為了確認效果,他們訓練一個 8 億參數的模型讀 1,000 億 token,大約是依他們 scaling law 推出的最佳 token 數的 5 倍。沒有權重衰減的 Muon 一開始收斂得最快,大約在第 24,000 步時領先加了權重衰減的版本 0.023;之後部分權重長得太大,到第 66,000 步反被超前 0.017。加了權重衰減的 Muon 在這段過度訓練的區間,同時勝過原版 Muon 與 AdamW。
後來的獨立評估也支持這一點。EPFL 的 Semenov 等人在 124M 到 720M 的模型上比較兩種版本,原版 Muon 的表現隨模型變大而退步,這篇論文的版本(他們稱為 D-Muon)在所有設定下都穩定。
第二件事:讓每個矩陣的更新一樣大
第二個問題藏在正交化本身。 的每個奇異值都是 1,它的 Frobenius 範數平方就等於秩 。一個 的滿秩矩陣,秩是 ,所以每個元素的均方根(RMS)是
這是論文的 Lemma 1。訓練中量到的 Muon 更新 RMS,也確實接近這個理論值。
代入一個隱藏維度 的模型算算看。注意力的 query 投影是 ,更新 RMS 約 ;傳統 MLP 的第一層是 ,更新 RMS 只有約 ,小了一半。同一個學習率底下,不同形狀的矩陣每一步實際走的距離不一樣。
論文指出兩種會出事的情況。 很大的矩陣(例如大型 dense MLP),更新太小,學不動; 很小的矩陣(例如在 GQA 或 MLA 裡把每個 KV head 當成獨立參數),更新又太大,訓練不穩。
修正的方法是把每個矩陣的更新乘上 ,抵消 Lemma 1。月之暗面再往前推一步。Muon 只管矩陣,嵌入層、分類頭和 RMSNorm 還是交給 AdamW,兩套優化器最好共用同一組學習率與權重衰減。AdamW 的更新 RMS 在他們的經驗裡大約是 0.2 到 0.4,於是把 Muon 的更新也縮放到這個範圍:
這麼一來,每個矩陣的更新 RMS 都是 0.2,Muon 就能直接沿用替 AdamW 調好的學習率和權重衰減。這是論文最實用的一條式子。對應到 Moonlight 的開源範例,只是一行 adjusted_ratio = 0.2 * math.sqrt(max(A, B)),用它放大 Muon 那一項的學習率;權重衰減那一項乘的還是原本的 lr。
0.2 這個數字有實驗依據。在一個小模型上訓練 2,000 步(約 20 億 token),把 Muon 的更新 RMS 設成 0.05、0.1、0.2、0.4、0.8,驗證 loss 分別是 3.503、3.374、3.325、3.314、3.543,AdamW 是 3.679。0.2 和 0.4 幾乎一樣好,作者選了 0.2。
另一組實驗比了三種控制 RMS 的做法。為了把形狀差異放大,他們把 800M 模型的 SwiGLU 換成 的兩層 MLP,在 4B token 時評估:
| 做法 | 驗證 loss | MLP 權重 RMS |
|---|---|---|
| 一律乘 | 2.812 | 0.0252 |
| 輸出直接正規化到 RMS 0.2 | 2.789 | 0.0501 |
| 乘 | 2.789 | 0.0489 |
整理自原論文 Table 1。
只看隱藏維度 的第一種做法,在 的 MLP 上更新只有後兩種的一半(),loss 也較高。後兩種一樣好,論文選了成本較低的第三種。
其他超參數照舊。Newton–Schulz 迭代 10 步雖然正交得更準,訓練結果沒有更好,所以用 5 步;動量調了沒有一致的增益,維持 0.95。
分散式 Muon
大型訓練通常用 ZeRO-1 把優化器狀態切到各個資料平行(DP)節點,每個節點只更新自己那一片參數。這對 AdamW 沒問題,它是逐元素運算;Muon 卻需要完整的矩陣才能正交化。
論文的 Distributed Muon 在 ZeRO-1 上多加兩步:
- 照常把梯度 reduce-scatter 到各節點,用本地那一片動量更新;
- 多加:在 DP 群組內把更新後的梯度片段 gather 成完整矩陣;
- 多加:在完整矩陣上跑 Newton–Schulz,只留下屬於自己那一片的結果,套用更新;
- 照常 all-gather 參數。
記憶體方面,Muon 只有一份動量,AdamW 有兩份,多出來的優化器記憶體是分散式 AdamW 的一半。通訊方面,多出的 gather 只涉及本地那一片,而且在 bfloat16 下做,總通訊量是分散式 AdamW 的 1 到 1.25 倍。延遲方面,優化器步驟通常只占前向加反向時間的 1% 到 3%,gather 還能和計算重疊。作者說在他們的叢集上,看不到明顯的延遲差異。
討論
scaling law:約 2 倍
為了公平,作者先替 AdamW 做 scaling law 研究。在多個計算預算下改變模型大小與 token 數,找出最佳組合,再對學習率與批次大小做網格搜尋,重複兩三輪。最後得到 5 個 Llama 架構的 dense 模型,從 399M 到 1.5B(不含嵌入),token 數 8.9B 到 38.9B,學習率 9.5e-4 到 8.3e-4。Muon 因為已經對齊了更新 RMS,直接沿用 AdamW 的最佳超參數。
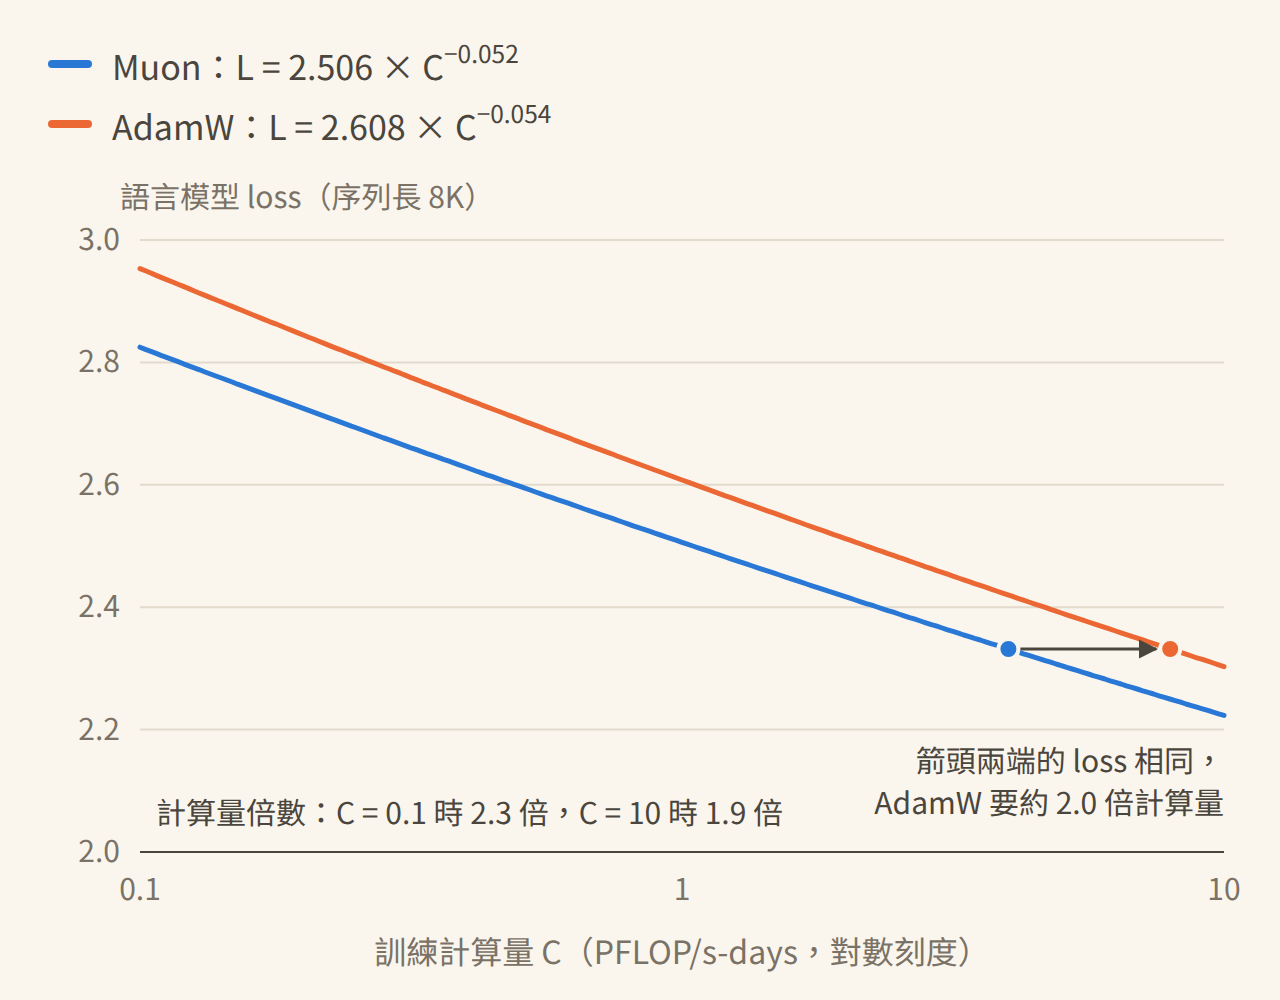
兩條擬合式分別是 Muon 、AdamW 。論文的結論是,在 compute-optimal 的設定下,Muon 只要約 52% 的訓練計算量,就能達到 AdamW 的 loss,也就是約 2 倍的計算效率。
用這兩條式子自己算一下,同一個 loss 下的計算量倍數,在 0.1 PFLOP/s-days 時約 2.3 倍,最大實驗點附近的 4 PFLOP/s-days 約 2.0 倍,外推到 10 PFLOP/s-days 時降到約 1.9 倍。AdamW 的指數稍大,兩條線慢慢靠近。倍數隨計算量增加而縮小,這是本文用論文的擬合式算出來的,論文沒有討論。
這組實驗還有兩個條件要記住。表中的 token 數約是參數量的 22 到 26 倍,接近 Chinchilla 的最佳比例(20 倍),也就是只測了這一種資料量;AdamW 的學習率是在這套 scaling law 流程中選出來的,落在 8e-4 到 1e-3 之間。這兩點後來都被拿出來討論。
Moonlight:只換優化器的對照
正式模型沿用 DeepSeek-V3-Small 的架構,啟用 2.24B、總計 15.29B 參數(含嵌入是 3B/16B),小改了幾處,例如拿掉多 token 預測。最長上下文 8K,權重衰減全程 0.1。訓練分三段:
- 前 33B token:2,000 步內把學習率線性升到 4.2e-4,批次 2,048 筆;
- 33B 到 5.2T:cosine 從 4.2e-4 降到 4.2e-5,200B token 之後批次加倍到 4,096 筆;
- 最後 500B token:學習率先升到 1e-4,再線性降到 0,改用最高品質的資料,以數學、程式與推理為主。
最乾淨的比較是 Moonlight-A,訓練設定完全相同,只把優化器換回 AdamW。兩者都取 1.2T token 時的中途 checkpoint 比較:
| 評測 | AdamW | Muon |
|---|---|---|
| MMLU | 60.2 | 60.4 |
| MMLU-pro | 26.8 | 28.1 |
| BBH | 45.3 | 43.2 |
| HumanEval | 29.3 | 37.2 |
| MBPP | 49.2 | 52.9 |
| GSM8K | 43.8 | 45.0 |
| MATH | 16.1 | 19.8 |
節錄自原論文 Table 4;兩者皆為 1.2T token、學習率尚未衰減完的中途 checkpoint。
MMLU 幾乎一樣,BBH 反而是 AdamW 高。差距最大的是程式與數學,HumanEval 多了 7.9 分。作者也特別提到 Muon 在數學與程式上表現突出,原因留給後續研究。
讀完 5.7T token 後,Moonlight 的 MMLU 是 70.0;參數規模相同、同樣讀 5.7T token、用 AdamW 訓練的 DeepSeek-V2-Lite 是 58.3,讀了 18T token 的 Qwen2.5-3B 是 65.6。這幾組來自不同團隊、不同資料,只能說 Moonlight 在訓練計算量與成績的取捨上排在前緣,不能當成優化器的對照實驗。
訓練過程很平順,沒有 loss 或梯度範數的尖峰。附錄裡有兩個細節。第一,某些層的最大注意力 logit 在訓練初期一路升到 100 以上,作者寫明 AdamW 在控制這個數值上「表現得比較健康」;超過 100 的 logit 只占約萬分之一,之後也慢慢降下來。第二,RMSNorm 的增益參數也要加權重衰減,否則各層輸出的 RMS 會變得太大。
更新更分散,權重也是
Muon 讓權重往更多方向學習,這個直覺可以量。作者計算每個權重矩陣的 SVD 熵:
奇異值越平均,熵越接近 1;被少數幾個奇異值主導,熵就低。在 1.2T token 的預訓練過程中,注意力、專家、共享專家、路由器、第一層 dense 等六組權重,每個 checkpoint 上 Muon 的平均 SVD 熵都高於 AdamW;超過 90% 的權重矩陣也是 Muon 的熵比較高。差距最大的是 MoE 的路由器,作者據此推測 MoE 從 Muon 得到的好處更多。
微調時換不換優化器
這是 Jordan 第三個問題的部分答案。作者把 1.2T token 的兩個 checkpoint,各用 Muon 和 AdamW 在 Tülu 3 的 SFT 資料上微調兩個 epoch:
| 預訓練 → SFT | MMLU | HumanEval | GSM8K |
|---|---|---|---|
| Muon → Muon | 55.7 | 57.3 | 68.0 |
| AdamW → Muon | 55.3 | 53.7 | 62.1 |
| Muon → AdamW | 50.2 | 52.4 | 64.9 |
| AdamW → AdamW | 52.0 | 53.1 | 64.6 |
節錄自原論文 Table 6。
全程用 Muon 最好。但預訓練和微調的優化器一旦不同,Muon 就沒有明顯優勢;Muon 預訓練、AdamW 微調的 MMLU 甚至最低。拿公開的 Qwen2.5-7B 基底模型分別用 Adam 和 Muon 微調,兩者差不多,Muon 的 GSM8K 還低了 4 分(89.8 對 85.8)。作者的結論是,Muon 的好處主要在預訓練;這種「預訓練與微調優化器不匹配」的現象,他們列為還沒解決的問題。作者也提到,現有的預訓練 checkpoint 大多以 AdamW 訓練,這個不匹配讓它們很難直接從 Muon 得到好處。
後來:Kimi K2 的 QK-Clip
注意力 logit 升高的問題,到了更大的模型上就出事了。2025 年 7 月的 Kimi K2 技術報告寫道,他們用原版 Muon 訓練一個 9B 啟用、53B 總參數的 MoE,最大注意力 logit 很快就超過 1,000;logit 到了這個量級,通常會帶來明顯的 loss 尖峰,甚至發散。在他們的實驗裡,這個問題在 Muon 上比在 AdamW 上常見。他們的假設是,Muon 的更新所有奇異值相同、有效秩是滿的,比較容易讓 、 的譜範數一起長大。
解法是 QK-Clip。每一步更新完,看每個注意力頭在這一批資料裡的最大 logit ;超過門檻 ,就把這個頭的 、 一起縮小,縮放因子 平均分到 query 與 key 兩邊(各乘 ;MLA 的 RoPE 部分另有規則)。它只改權重,不改當步的前向與反向計算,也只動超標的那幾個頭。
Muon 加上權重衰減、RMS 對齊(就是本篇的式子),再加 QK-Clip,合稱 MuonClip。Kimi K2 用它訓練 1 兆總參數、320 億啟用參數的模型,讀 15.5 兆 token,,全程沒有 loss 尖峰。QK-Clip 只在前 7 萬步有作用,期間有 12.7% 的注意力頭觸發過;之後所有頭的最大 logit 都自己降到 100 以下,這道保險就再也沒動過。
後來採用 Muon 的不只月之暗面。智譜的 GLM-4.5(2025 年 8 月)除了詞嵌入、偏置與 RMSNorm 權重,全部參數都用 Muon,設定直接照本篇:5 步迭代、動量 0.95、更新 RMS 縮放到 0.2。DeepSeek-V4 也把大部分參數換成 Muon;它的注意力在 query 和 KV 上本來就有 RMSNorm,logit 不會爆,所以不需要 QK-Clip。
「2 倍」後來怎麼了
2 倍這個數字被重新檢驗過好幾次。
Stanford 的 Wen 等人(2025 年 9 月)對每個優化器都做了完整的超參數掃描,再比較 token 效率。他們量到的 Muon 對 AdamW,在 130M 到 520M 約 1.3 到 1.4 倍,到 1.2B 降到約 1.1 倍。他們在附錄點名這篇論文的兩個條件。一是 AdamW 的學習率偏低,400M 到 1.5B 用 8e-4 到 9e-4,他們調出來的最佳值更高;二是 Moonlight 與 Moonlight-A 的比較取在學習率還沒衰減完的中途 checkpoint,而他們的實驗顯示,Muon 在前期常常大幅領先,衰減階段會被追上。
Essential AI 的獨立研究(2025 年 5 月,100M 到 4B)結論是,Muon 達到同樣 loss 需要的 token 比 AdamW 少 10% 到 15%;它的優勢在批次放大到遠超過臨界批次時仍然保持,甚至變大。NVIDIA 在 2026 年 7 月用 30B 到 72B 的 MoE、每批 2,500 萬 token 以上的設定,也看到 AdamW 在大批次時退化、Muon 撐得住。
綜合起來,Muon 的進步是真的,但在調好的 AdamW 面前,token 效率的差距比 2 倍小得多;它更明顯的優勢在大批次訓練。這篇論文當時的 2 倍來自接近 1× Chinchilla、AdamW 學習率偏低的 scaling law;Moonlight 對 Moonlight-A 的比較,則取在學習率還沒衰減完的中途 checkpoint。
結論
月之暗面替 Muon 補上解耦權重衰減,讓權重與輸出的 RMS 不再一路長大;再乘上 ,讓每個矩陣的更新 RMS 都對齊 AdamW 的 0.2。加上 ZeRO-1 式的分散式實作,Muon 在 5.7 兆 token 的 MoE 預訓練上順利跑完,而且直接沿用 AdamW 的超參數。約 2 倍的計算效率則要帶著條件讀,後來調好基準的研究量到的是 1.1 到 1.4 倍。
想換成 Muon 的話,嵌入層、分類頭、LayerNorm 與偏置留給 AdamW,其他 2D 權重交給 Muon;確認你用的實作是哪一種縮放,Moonlight 式的可以直接拿 AdamW 的學習率,Jordan 式的要重新掃。手上是 AdamW 預訓練的模型,用 Muon 微調前先小規模試一下。
Jordan 在部落格最後寫,他不知道 Muon 能不能擴展到 200 億參數、1 兆 token。七個月後,Kimi K2 用它訓練了 1 兆參數、15.5 兆 token 的模型。