原論文
Shampoo: Preconditioned Stochastic Tensor Optimization
- 発表先
- ICML 2018国際会議
- arXiv への初回投稿
- arXiv:1802.09568
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersshampoo2018,
  title = {{Shampoo: Preconditioned Stochastic Tensor Optimization}},
  author = {Vineet Gupta and Tomer Koren and Yoram Singer},
  year = {2018},
  eprint = {1802.09568},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1802.09568}
}
この論文の名前の由来は、2 ページ目の脚注に隠れている。「We call it Shampoo because it has to do with preconditioning.」
conditioner はヘアコンディショナーで、preconditioning は「コンディショナーの前」。となれば、もちろんシャンプーだ。謝辞では、この名前を考えた Roy Frostig にわざわざ礼を述べている。
冗談はさておき、論文が扱うのはかなり現実的な厄介ごとだ。パラメータどうしがどう影響し合っているかをオプティマイザがはっきり見ようとすると、「パラメータ数の 2 乗」の大きさの行列を保持しなければならない。Google Brain の Vineet Gupta、Tomer Koren と Princeton の Yoram Singer は、この行列を実際には保存せずに済む方法を探した。
問題の定義
前処理は何をしているのか
最も素朴な勾配降下法では、どのパラメータも同じ学習率で勾配の逆方向に進む。前処理(preconditioning)を使う手法は、進む前に行列を一つ勾配に掛ける。
が対角行列なら、その効果はパラメータごとに歩幅を個別にスケーリングすることで、Adam や AdaGrad はこの類に入る。 が完全な行列なら、勾配の「向きを変える」こともできる。損失地形が斜めに延びた細長い谷で、二つのパラメータが一緒に動かないと谷底に沿って進めないとき、対角行列は二つの座標軸を別々にスケーリングすることしかできない。斜めの谷をまっすぐに直せるのは、完全な行列だけだ。
full-matrix AdaGrad は大きすぎる
AdaGrad には完全な行列を使う版があり、前処理は勾配の外積を累積したものの平方根だ。
理論的な性質は対角版より良いが、重すぎて誰も手が出せない。 の全結合層で計算すると、平坦化したパラメータは 万個で、 は 、約 個の要素になり、単精度で 4 TB を超える。しかも毎回これの平方根を取って逆行列を求める必要があり、計算量は だ。
当時の逃げ道はいくつかあった。対角近似は安いが、パラメータ間の相関をすべて捨ててしまう。sketch などの推定法について、著者らは「seldom practical at large scale」と評している。K-FAC も Kronecker 分解を使うが、近似しているのは Fisher 行列で、モデルの予測分布からサンプリングする必要があり、さらに順伝播ネットワークの逆伝播の構造に依存するので、アーキテクチャを変えると導出し直さなければならない。
ニューラルネットワークのパラメータは、もともと行列やテンソルだ。全結合層は 、畳み込みカーネルは 4 次元。この論文の問いは、この形を保ったまま、いくつかの小さな行列であの巨大な前処理を近似できないか、というものだ。
問題の解決
左右に一つずつ
行列の場合、Shampoo は の重み行列一つに対して二つの前処理を保持する。左が 、右が だ(Algorithm 1)。
初期値は 、。 が累積するのは各「行」の間の相関で、全結合層でいえば出力ユニットの間だ。 が累積するのは各「列」の間、つまり入力特徴の間だ。更新では、勾配に左から 1 回、右から 1 回掛ける。
同じ の層なら、 と を合わせて 万個の要素で、単精度で 8 MB。メモリは から に、行列べき乗を計算するコストは から に下がる。
この二つの小さな行列は、実は一つの大きな行列が姿を変えたものだ。論文の Lemma 4 は Kronecker 積の恒等式を示していて、 を平坦化すると、 に平坦化した勾配を掛けたものに等しい。つまり Shampoo は の前処理 を使っていることになる。ただ、この行列は最初から最後まで一度も組み立てられない。
コードにすると、行列パラメータ一つの更新はこれだけだ。
import torch

def matrix_power(A, p):
    """対称正定値行列の p 乗:固有値分解して固有値だけを p 乗する"""
    lam, Q = torch.linalg.eigh(A)
    return Q @ torch.diag(lam ** p) @ Q.T

class ShampooMatrix:
    """Algorithm 1:m×n の重み行列一つに Shampoo を適用する"""
    def __init__(self, m, n, lr, eps=1e-4):
        self.L = eps * torch.eye(m)   # L_0 = εI_m
        self.R = eps * torch.eye(n)   # R_0 = εI_n
        self.lr = lr

    @torch.no_grad()
    def step(self, W, G):
        self.L += G @ G.T             # m×m の左統計量を累積
        self.R += G.T @ G             # n×n の右統計量を累積
        W -= self.lr * matrix_power(self.L, -0.25) @ G @ matrix_power(self.R, -0.25)
論文自身の実装は TensorFlow で、行列べき乗は SVD で計算しているが、やり方は同じだ。
なぜ 1/4 なのか
AdaGrad は平方根を取るのだから、指数は のはずでは? ところが Shampoo が使うのは で、しかも左右に 1 回ずつだ。
答えは Lemma 8 にある。各ステップの勾配行列のランクが 以下だと仮定すると、著者らは次を証明している。
左辺は full AdaGrad の統計量だ。証明は 2 段階になっている。まず と を別々に示す。つまり左右それぞれに上界がある。次に行列の幾何平均の単調性を使い、二つの上界をそれぞれ 乗して掛け合わせる。最初の はここから来る。
AdaGrad の前処理では、統計量の平方根をもう一度取る。半正定値行列では平方根を取っても順序が保たれるので、両辺を 乗すると次が得られる。
つまり で、半分は幾何平均から、半分は AdaGrad の平方根から来ている。Shampoo の は、full AdaGrad の前処理の上にかぶさる Kronecker 構造の行列だ。著者らは、full-matrix 前処理のうち前処理の効果を最も左右する小さな固有値が、この近似によって消えることはないと特に指摘している。
論文はもう一つ直感的な説明も示している。この指数のおかげで全体の歩幅は で減衰し、これはちょうど確率的最適化でよく見る速度だ。勾配の大きさが安定しているとき、 と はステップ数 にほぼ比例して増え、 と がそれぞれ ずつ寄与して、合わせてちょうど になる。
この は、証明に出てくる上界の産物だ。後の実装では指数を調整できるようにし、 に変えることが多い。これは議論の節でまた取り上げる。
テンソル版
畳み込みカーネルは 4 次元だ。Shampoo の一般形(Algorithm 2)は、テンソルの各次元 に の前処理 を一つずつ持たせる。統計量は、勾配をほかのすべての次元に沿って縮約して得た行列だ。更新では次元ごとに を掛ける。 はテンソルの階数で、行列なら となり、 に戻る。
論文の CIFAR-100 実験で最大の畳み込みカーネル で計算すると、パラメータは 589,824 個で、full AdaGrad の前処理は約 個の要素になる。Shampoo なら行列 4 つで済み、 個の要素、指数は だ。
収束保証とその条件
理論はオンライン凸最適化の枠組みで証明されている(Theorem 7)。勾配のランクが 以下なら、regret の上界は次のとおりだ。
は反復の過程での と最適解の距離の最大値だ。勾配のスペクトルノルムが 1 以下なら、二つの trace はそれぞれ で増え、regret の合計は になる。これはオンライン凸最適化ではすでに最良の速度だ。テンソル版(Theorem 10)も同様で、 は各次元のランクの幾何平均に置き換わる。
条件はきちんと読んでおきたい。損失は凸でなければならない。 は とともに大きくなりうるので、有界にするには各ステップで を球の中に射影し直す必要がある。しかもこの射影には が誘導するノルムを使うので、計算コストがとても高い。そこで著者らはアルゴリズムではこれを省き、「slightly looser」な界を受け入れている。深層ネットワークは凸ではないので、この証明はアルゴリズムの出どころと動機であり、ニューラルネットワークでの証拠は実験のほうだ。
実用化での妥協
実装上の取捨選択は二つある。パラメータテンソルはそれぞれ個別に扱うので、全体としてはブロック対角の前処理になり、異なる層の間の相関は無視される。ある次元が大きすぎるとき(実験でのしきい値は約 1200)、その次元は自動的に対角版(付録 A の Algorithm 3)に切り替わり、対角要素だけを保存する。さらに実験では二つのヒューリスティックな調整を加えている。行列の根を 20〜100 ステップに 1 回だけ計算し直すこと、そして係数 0.9 の勾配モーメンタムだ。著者らは、前者は精度に「almost no impact」だと述べている。
議論
実験の規模は小さい
すべての実験でバッチサイズは 128 で、前処理はバッチ全体の平均勾配で更新する。画像分類では、CIFAR-10 で 2.4M パラメータの 32 層 ResNet と 1.65M パラメータの小型 Inception、CIFAR-100 で 13.5M パラメータの BatchNorm なしの 55 層 ResNet を使い、各オプティマイザについて 0.01 から 10 の間で 10 通りの学習率を走査した。この部分で論文が描いているのは学習損失の曲線だけで、テスト精度の比較表はない。
言語モデルは LM1B で学習させた 9.8M パラメータの Attention モデルで、最大のテンソルは だ。
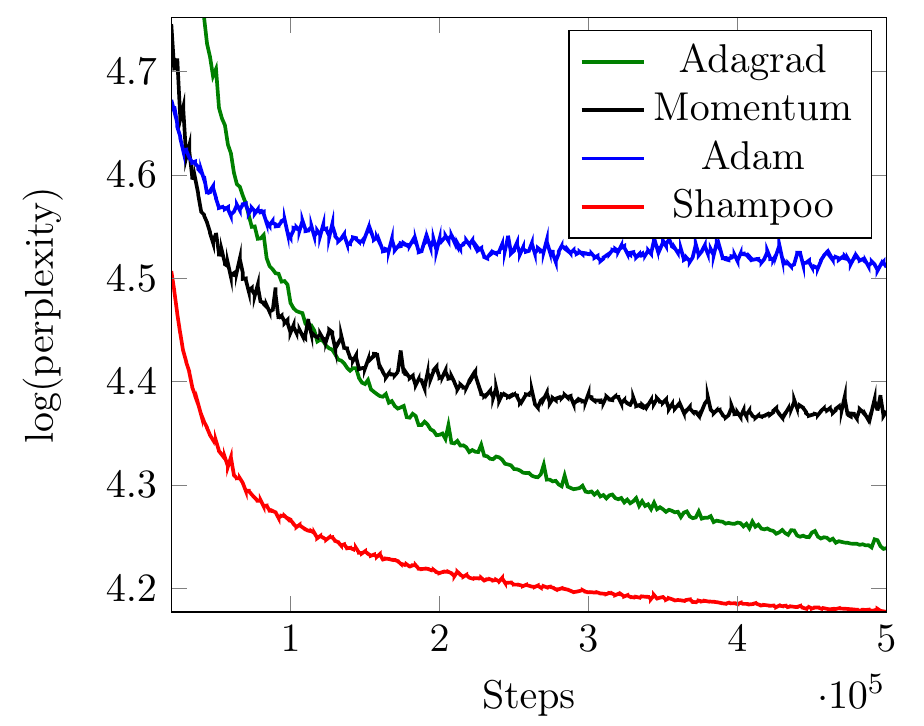
赤い線は最初の点からずっと一番下にあり、50 万ステップで約 4.18。緑の AdaGrad は約 4.24、黒の Momentum は約 4.37 で、青の Adam はかなり早くから 4.5 付近で止まっている。
この図の比較条件は対称ではない。Shampoo はデフォルトの学習率 をそのまま使い、ほかの手法は「explored various different settings」とされているが、論文は Adam でどの値を走査したかを載せていない。Adam は Attention モデルで AdaGrad に大きく後れを取っている。本稿の推測では、これは後に Transformer の学習で Adam が広く使われるようになった経験とあまり合わず、差は調整の非対称から来ている可能性が高い。この図を読むときは、その点を織り込んでおく必要がある。
1 ステップあたりどれだけ余計にかかるか
「行列演算は遅すぎないか」という疑問に、論文は 1 秒あたりのステップ数の表で答えている(Tesla K40、バッチ 128)。
| 実験 | SGD | Shampoo | 比率 |
|---|---|---|---|
| ResNet-32(C10) | 2.184 | 2.151 | 98% |
| Inception(C10) | 3.638 | 3.506 | 96% |
| ResNet-55(C100) | 1.210 | 1.249 | 103% |
| Attention(LM1B) | 4.919 | 3.509 | 71% |
原論文 Table 1 をもとに整理。比率は本稿で計算。Adam と AdaGrad の数値は SGD とほぼ同じなので、表では省略した。
畳み込みネットワークではほとんど差がなく、ResNet-55 では SGD より少し速いくらいだ。LM1B では 1 秒あたりのステップ数が SGD の 71% しかなく、論文はその原因を分析していない。このモデルの最大のテンソルは で、実験で使った約 1200 のしきい値に従えば、2000 の次元は対角版に回る。これらの数値は、モデルが数百万パラメータしかなく、根を 20〜100 ステップに 1 回計算するという条件で測ったものだ。
その後の Shampoo
2018 年の原版は、大規模学習からはまだほど遠かった。その後の二つの版が主にやったのは、エンジニアリングだ。
Anil ら(2020)の Distributed Shampoo。 著者には原論文の 3 人も含まれ、論文タイトルは「Scalable Second Order Optimization for Deep Learning」だ。彼らは、実際のモデルの は条件数が極めて大きく、行列の根を倍精度で計算しなければならず、それが TPU では高くつくことに気づいた。変更点は次のとおりだ。
- アクセラレータは各ステップで統計量を累積するだけにし、逆 乗根は ステップごとにホストの CPU に送って非同期に計算し、すべてのコアに分散させて学習ループを止めない。
- 逆根の計算に SVD ではなく coupled Newton 反復を使い、warm start と組み合わせる。
- embedding や softmax のように次元が数百万ある層は片側だけ前処理し、大きな全結合層はブロックに分けてそれぞれ前処理する。
- 前処理は数百ステップに 1 回だけ更新する。
- grafting。方向は Shampoo から取り、歩幅の大きさは調整済みの一次手法(たとえば対角 AdaGrad)から取って、層ごとに個別に接ぎ木する。
- 指数を調整可能なハイパーパラメータにし、統計量には指数移動平均を使う。
結果として、WMT'14 英仏翻訳の Transformer でステップ数が半分になり、実時間は 45% 短くなった(約 12 時間から 6.7 時間へ)。
Shi ら(2023)の PyTorch 版。 Meta のチームが GPU でのデータ並列学習向けに書き直した。各 worker は一部のパラメータブロックの前処理だけを受け持ち、計算が終わったら AllGather で方向を集めるので、1 ステップあたりの実時間は対角手法より最大でも 10% 多いだけだ。行列の根は torch.linalg.eigh で計算するように変え、単精度で通常は十分だとわかった。小さな次元はまとめ、大きな次元はブロックに切り、ImageNet 実験ではブロックの上限を 2048 にした。grafting、バイアス補正、decoupled weight decay、Nesterov もひととおりそろっている。ImageNet の ResNet-50 では、Shampoo は 60 エポックで SGD-Nesterov の 90 エポックの検証精度に達し、総実時間では 1.35 倍速かった。
AlgoPerf 2024。 MLCommons は 2024 年 8 月に第 1 回 AlgoPerf 学習アルゴリズムコンペティションの結果を発表し、外部チューニング部門の優勝はこの PyTorch Distributed Shampoo だった。スコアは 0.78 で、NAdamW のベースラインより平均約 28% 速い。大会後の分析論文の細部のほうが見ものだ。八つのワークロードのうち、最速だったのは Criteo 1TB と ViT の 2 項目だけ。WMT では最速の提出の 2 倍以上の時間がかかり、ResNet では時間予算内に安定して目標に届かなかった。勝因は、ほぼすべての項目で安定して悪くなかったことにある。
同じ年の Gemini 1.5 技術報告にも、1.5 Flash は「is trained with higher-order preconditioned methods」と書かれていて、AdaGrad などの文献を引用しているが、どの手法かは名指ししていない。
1/4 か 1/2 か
指数の問題には、後に答えが出た。Anil らは付録で、指数をハイパーパラメータとして扱うとより良い場合があると書き、彼らのオートエンコーダ実験では を使っている。Shi らの実装は、全結合層が中心のネットワークでは指数を に上書きする、つまり同じく にするか、元の指数を 1.82 倍にすることを勧めている。説明を与えたのは Morwani ら(2024)だ。 は、「full AdaGrad の統計量の最良の Kronecker 近似を求める」ためのべき乗法を 1 ステップ行った結果にちょうど等しく、しかも最良近似にかなり近い。 そのものが を近似しているのだから、AdaGrad の 乗をまねるには、左右それぞれ を取るのが正しい。Morwani ら(2024)の結果から振り返り、本稿では原論文の を、十分にタイトでない上界から出てきた指数とまとめておく。
にも使い道はあった。累積を取り除き、そのステップの勾配 だけを見ると、
すべての特異値が 1 に押しつぶされる。これが Muon の直交化更新だ。Shampoo の最初のステップでは統計量に勾配が一つしかないので、ε が小さいとき進む方向は になる。上のコードで のランダムな勾配に対して 1 ステップ進めると、結果と の違いは ε による偏りだけで、たいてい のオーダーだ。Keller Jordan が 2024 年 12 月に Muon を紹介した記事にも、累積のない Shampoo にモーメンタムを加えたものが Muon だと書かれている。違いは、Shampoo が逆 4 乗根を計算するのに対し、Muon は Newton–Schulz 反復で安く近似するところだ。
結論
Shampoo は二つの小さな行列の Kronecker 積で、full-matrix AdaGrad の保存しきれない前処理を近似し、メモリを から に減らし、凸の設定で の regret を証明した。論文の実験は千万パラメータ規模までで、主に示したのは「1 ステップがそれほど遅くならない」ことだ。
今日試すなら、Meta の Distributed Shampoo をそのまま使い、grafting に Adam、指数 、前処理の更新は数十ステップに 1 回、というところから調整を始めるとよい。その前に、自分のモデルで最大の次元が 1 ステップをどれだけ遅くするかを測っておくこと。原版のコードは、アルゴリズムを理解するために取っておけば十分だ。
論文の 12 ページには「We plan to implement Shampoo in PyTorch in the near future」と書かれている。その後 AlgoPerf で優勝したのは、まさに Meta のチームが 5 年後に書いた PyTorch 版だった。