原論文
Fantastic Pretraining Optimizers and Where to Find Them
- 発表先
- ICLR 2026国際会議
- arXiv への初回投稿
- arXiv:2509.02046
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersfantasticoptimizers2025,
  title = {{Fantastic Pretraining Optimizers and Where to Find Them}},
  author = {Kaiyue Wen and David Hall and Tengyu Ma and Percy Liang},
  year = {2025},
  eprint = {2509.02046},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2509.02046}
}
1.3 億パラメータの言語モデルを用意し、GPT-3 論文のレシピどおり AdamW で学習させる。ピーク学習率は 6e-4 だ。ここで数字を一つだけ変え、学習率を 8e-3 にして、ほかの設定は何も動かさない。同じ loss に達するまでのステップ数は半分になった。
この実験は論文の最初の図に載っている。GPT-3 のレシピによるこの AdamW の曲線こそ、Sophia、MARS、Cautious などの新しいオプティマイザの論文が比較に使ってきたベースラインで、これらの論文が主張する高速化の多くは 2 倍だ。Muon の大規模版は約 2 倍、SOAP は 1.4 倍を主張し、DION に至っては 3 倍を報告している。
ベースラインの学習率を調整するだけで 2 倍になるのなら、これらのオプティマイザは本当はどれだけ速いのか? Stanford の Kaiyue Wen、David Hall、Tengyu Ma(馬騰宇)、Percy Liang は、11 個のオプティマイザを同じ手順に載せ、どれもゼロから調整して、1.3 億パラメータから 12 億パラメータまで比べ続けた。
論文タイトルは、映画『ファンタスティック・ビーストと魔法使いの旅』の原題 Fantastic Beasts and Where to Find Them をもじっている。このノートで見るのは、彼らがどうやって公平な比較を設計したか、測った高速化率はどれくらいか、そして同時期や後の大規模評価とどこが違うかだ。
問題の定義
著者らは、新しいオプティマイザがなかなか AdamW に取って代われない原因は評価方法にあると考えていて、主な問題は二つある。
一つ目は調整の不均衡だ。新手法の著者は自分のオプティマイザを真剣に調整するが、ベースラインは古いレシピのままか、すべてのオプティマイザに同じ学習率と重み減衰を使わせることが多い。
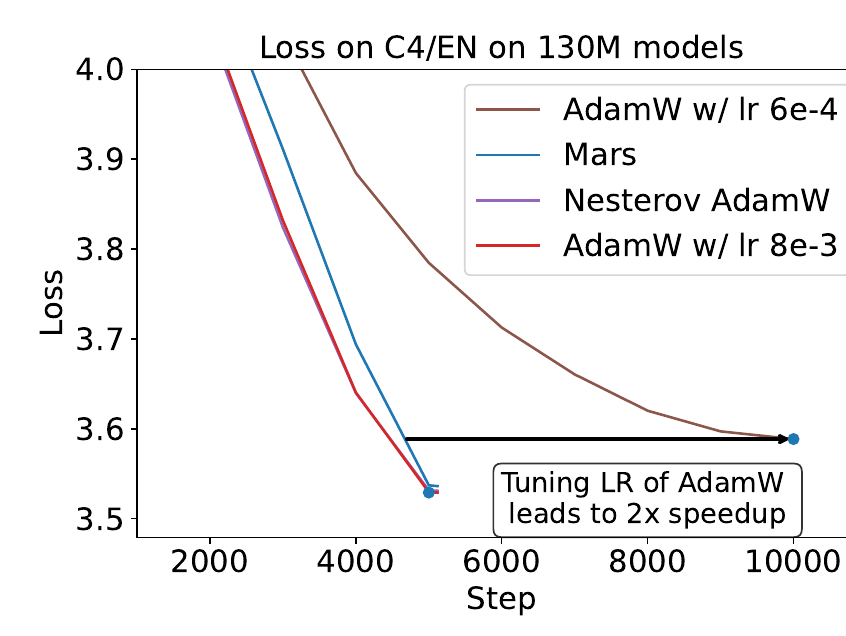
茶色の線は学習率 6e-4 の AdamW、赤い線は 8e-3 だ。赤い線は 5,000 ステップもかからずに、茶色の線の 10,000 ステップ目の終点の loss まで下がり、最後はさらに低い約 3.53 で止まる。MARS(青い線)と Nesterov AdamW(紫の線)も図に描かれていて、終点はどちらも調整済みの赤い線にとても近い。茶色の線をベースラインにすると、MARS は 2 倍速く見える。赤い線に替えると、差はずっと小さくなる。
ハイパーパラメータの共用も公平ではない。よく似たオプティマイザでも、最適なハイパーパラメータは大きく違うことがある。Lion を例にとると、論文の走査で見つかった最適な重み減衰は約 0.6、AdamW は約 0.1 だ。二つが同じ値を共用すれば、どちらかが必ず損をする。
二つ目は評価の設定が狭すぎることだ。多くの論文は 1× Chinchilla 付近、一つか二つのモデルサイズでしか比べておらず、学習途中のチェックポイントで比べるものもある。1× Chinchilla とは Chinchilla 論文が導いた計算最適な比率で、1 パラメータあたり約 20 token を読む。実際の大規模モデルは 1 倍から 50 倍以上までさまざまで、1× で勝つ手法が、データの多い領域でも勝つとは限らない。
この論文が答えようとしているのは、この二つだ。各オプティマイザが最適に近いところまで調整されていることを、どう確かめるか? 異なるモデルサイズ、異なるデータ量のもとで、高速化率はどれくらいか?
問題の解決
実験の舞台
データは OLMo 2 に倣い、DCLM-baseline(3.8T token)、StarCoder V2(0.25T)、ProofPile 2(55B)を混ぜ、Llama 3 の tokenizer を使う。モデルはどれも Llama アーキテクチャで、32 層、系列長 4,096、幅だけを変える。
| モデル | 隠れ次元 | FFN 次元 | 注意ヘッド |
|---|---|---|---|
| 130M | 512 | 2,048 | 8 |
| 300M | 768 | 3,072 | 12 |
| 520M | 1,024 | 4,096 | 16 |
| 1.2B | 1,536 | 6,144 | 24 |
原論文 Table 2 をもとに整理。
データ量は Chinchilla の倍数で 1×、2×、4×、8× と表す(非埋め込みパラメータ数の 20 倍を 1× とする)。主な指標は C4 英語サブセットの検証 loss で、ほかに HellaSwag、ARC など十数項目の下流の正解率も追跡する。実験は 128 個の TPU v5 lite で JAX を使って走らせ、著者らの見積もりでは H100 約 12 枚に相当する。
比較の単位は「同じ loss に達するのに何 token 必要か」で、1 ステップごとに余計にかかる計算時間は含めない。著者らの理由は、SOAP と Kimi の Muon 論文がどちらも、行列型オプティマイザはうまく実装すれば 1 ステップあたりの追加のオーバーヘッドを 10% 未満に抑えられると示していることだ。
11 個のオプティマイザは五つのグループに分かれる。
- ベースライン:AdamW
- 更新の分散を下げる AdamW の変種:NAdamW(Nesterov モーメンタム)、MARS、Cautious
- メモリ節約:Lion、Adam-mini
- 行列型:Muon、Scion、Kron(PSGD)、SOAP
- ヘッセ行列の近似:Sophia(結果は付録)
スカラー型と行列型の違いは、前処理がどう作用するかにある。AdamW、Lion、MARS などのスカラー型は、各パラメータにそれぞれスカラーを掛ける。Muon、SOAP、Kron などの行列型は、重み行列全体を一つのまとまりとして扱い、行列積で勾配を処理する。
3 段階の調整
すべての組み合わせを完全に探索するのは高すぎるので、著者らは 3 段階に分けた。
第 1 段階は座標降下法だ。 各ハイパーパラメータには離散的な候補値の組があり、AdamW なら学習率、重み減衰、ウォームアップのステップ数、、、、勾配クリッピングの上限、バッチサイズが含まれる。出発点は原論文が勧める設定だ。各ラウンドではほかのハイパーパラメータを固定して一つだけを走査し、検証 loss の改善が を超えれば新しい値に替える。どのハイパーパラメータでもそれ以上はっきりした改善が得られなくなるまで、ラウンドを重ねて走査する。この手順を 6 個の設定でそれぞれ一度ずつ行う。130M、300M、520M の 1× と、130M の 2×、4×、8× だ。
論文は AdamW の例を示している。初期設定は学習率 0.008、重み減衰 0.1、ウォームアップ 1,000 ステップ、バッチ 256 件で、loss は 3.298。1 ラウンド目でウォームアップを 2,000 ステップに変えると 3.282 に下がり、2 ラウンド目でバッチを 128 件に変えると 3.263 に下がる。最後に勾配クリッピングの上限を 2 に変えても loss は 3.263 のままで、走査は終わる。
第 2 段階では、規模とともに変わるハイパーパラメータだけを調整する。 著者らは二つのことに気づいた。多くのハイパーパラメータは、最適値の付近にありさえすれば loss にほとんど影響しない。loss に影響するものも、最適値は規模によってあまり変わらないことが多い。
そこで彼らは、loss が最適値との差 以内の設定をすべて「最適に近い」とみなした。あるハイパーパラメータに、どの設定でも最適に近くなる値が存在すれば、それは規模に鈍感なので固定する。そうでなければ規模に敏感なので、第 2 段階に持ち込んで調整を続ける。
結果として、どのオプティマイザも調整し直す必要のあるハイパーパラメータは多くなかった。AdamW は学習率、ウォームアップ、重み減衰、バッチサイズ、Lion は学習率と 、Muon と Kron はどちらも学習率だけだ。第 2 段階は 300M、520M の 2×、4×、8× の計 6 個の設定でやり直し、第 1 段階と合わせて全部で 12 個の設定になる。
第 3 段階では規則を外挿する。 調整し直す必要のある各ハイパーパラメータ について、12 個の設定の最適値で次を当てはめる。
はパラメータ数、 は token 数だ。著者らは 1.2B、1× で AdamW について第 1 段階を完全にもう一度行って検証した。当てはめ式で予測したハイパーパラメータの loss は、実際に見つかった最適値との差が 以内だった。続いてこの予測を使って、もっと大きな事例を二組走らせた。一組は 1.2B モデルの 1× から 8×、もう一組は 130M、300M を 16× まで読ませたものだ。
最適値が規模とともにどう変わるかは、付録の表から見て取れる。AdamW の 130M、1× での最適な学習率は 0.008、重み減衰 0.1、バッチ 128 件だが、1.2B、1× になると学習率 0.002、重み減衰 0.2、バッチ 256 件に変わる。Muon の行列部分の学習率は 0.016 から 0.004 に下がる(1.2B、1× では 0.008 を使い、loss はわずかに低い)。モデルが約 9 倍になると、学習率は 2〜4 倍小さくなる。130M で調整した学習率をそのまま 1.2B に使うと、ベースラインが損をする。
高速化率をどう測るか
高速化率は token 数で換算する。各モデルサイズについて、まず AdamW の 1×、2×、4×、8× の四つの loss で曲線を当てはめる。
あるオプティマイザが 個の token で loss に達したら、AdamW の曲線で逆に解き、AdamW が同じ に達するのに必要な 個の token を求める。高速化率は だ。
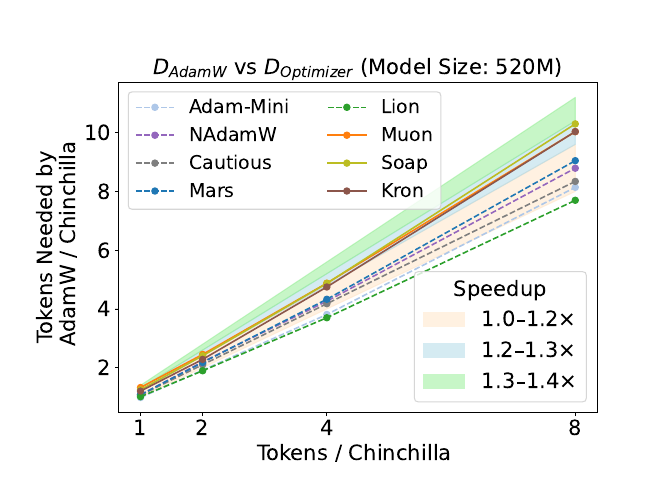
この図を読むときは、各線が対角線からどれだけ離れているかを見る。あるオプティマイザが AdamW と同じ速さなら、その点は の上に乗る。点が上にあるほど、AdamW が追いつくのにより多くの token を読む必要があることを示す。520M では、実線の行列型オプティマイザはおおむね 1.2〜1.4 倍の色帯に入っていて、データ量が大きいほど、線ははっきり上に反っていく。
議論
主な結果:最大 1.4 倍、しかも規模が大きいほど縮む
三つのモデルサイズ、四つのデータ量の結果をまとめると、四つの規則が見えてくる。
- どの手法も 2 倍に届かない。調整済みの AdamW に対しては、最高でも約 1.4 倍だ。SOAP はベースラインを自分で真剣に調整した数少ない論文で、主張する 1.4 倍はここで測った値に最も近く、300M、520M では実際には 1.2〜1.3 倍だった。
- 行列型がスカラー型に勝つ。どのモデルサイズでも、Muon、SOAP、Kron、Scion はスカラー型のオプティマイザを上回る。1× では Muon が最も良いが、8× になると SOAP と Kron が追いついて追い越す。行列型の高速化率はデータ量とともに増え、モデルが大きくなるにつれて減る。
- スカラー型は調整すればどれも AdamW とほぼ同じで、平均の高速化は 1.2 倍に届かない。NAdamW、MARS、Cautious など分散を下げる変種は、AdamW にわずかに勝つ。
- メモリを節約する Lion と Adam-mini は AdamW にぴったりついていく。最大で 5% 遅く、ときどきわずかに速い。モデルが大きくなると、Lion はどんどん後れを取り、Adam-mini は逆に差を詰めていく。
付録にある各設定の最良の loss を見れば、差がどれほど小さいかがすぐわかる。いくつかのセルを抜き出す。
| オプティマイザ | 130M、1× | 520M、8× | 1.2B、8× |
|---|---|---|---|
| AdamW | 3.529 | 2.913 | 2.752 |
| NAdamW | 3.531 | 2.907 | 2.749 |
| Lion | 3.552 | 2.915 | — |
| Muon | 3.464 | 2.906 | 2.748 |
| SOAP | 3.483 | 2.899 | 2.749 |
本稿で整理。原論文の付録 C、D、E の各設定で最良の設定の行から取った。C4/EN の検証 loss で、低いほど良い。1.2B は四つのオプティマイザだけを走らせた。
130M、1× では、Muon は AdamW より 0.065 低く、これが表全体で最大の差だ。1.2B、8× になると、四つのオプティマイザは 0.004 の範囲にひしめいている。
1.2B:1.1 倍まで下がる
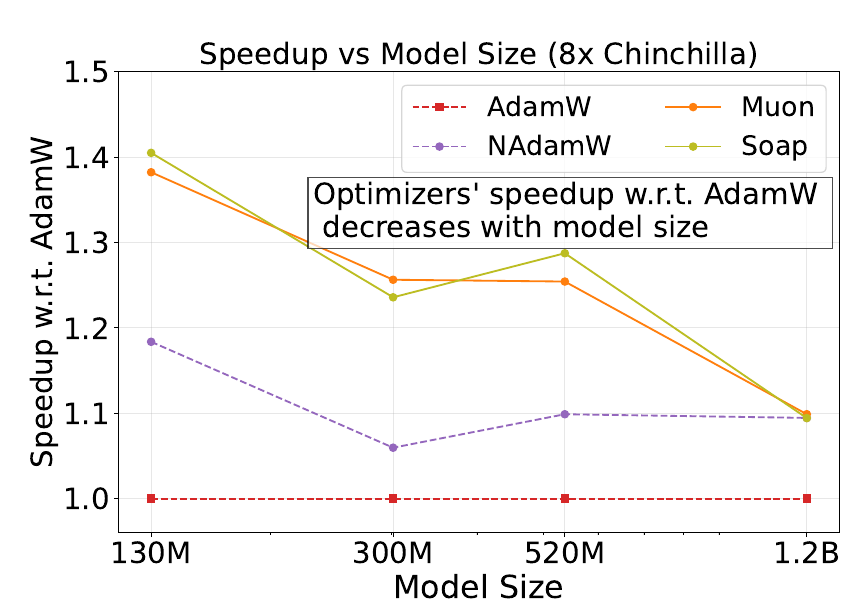
この図は 8× Chinchilla に固定し、高速化率がモデルサイズとともにどう変わるかを見ている。SOAP と Muon は 130M ではどちらも 1.4 倍に近いが、1.2B では約 1.1 倍しか残らず、NAdamW とほとんど同じになる。
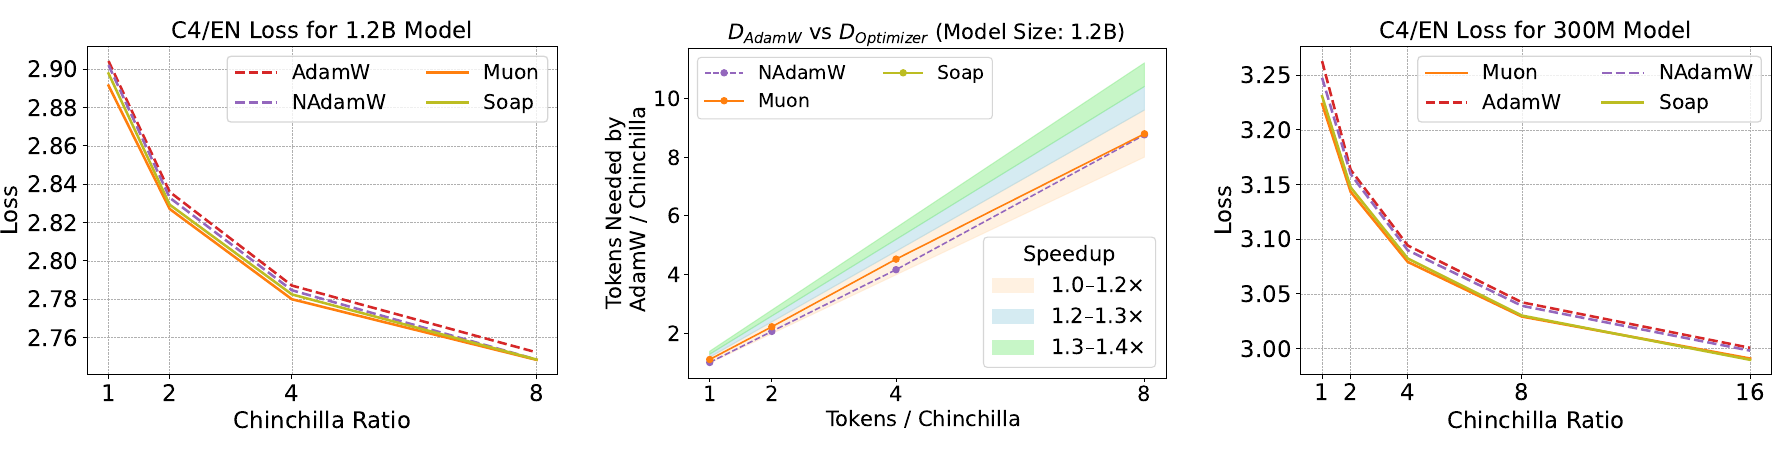
左図は 1.2B の loss だ。NAdamW、Muon、SOAP はやはり AdamW より速いが、三つの間にはほとんど差がない。中央の図で高速化率に換算すると、約 1.1 倍だ。下流の評価でも差は見えず、8×(193B token)での 10 項目のタスクの平均は AdamW 67.15、NAdamW 66.70、Muon 66.98 だった。
著者らは 16 回の学習で AdamW と Muon のスケーリング則 を当てはめ、7B、1× になると Muon の loss がかえって AdamW より高くなると予測している。付録の係数で計算すると、7B、1× では AdamW が 2.5706、Muon が 2.5729 で、差は 0.002。Muon の当てはめ自体の RMS 誤差 0.005 より小さい。この予測は当てはめの範囲から 6 倍外挿したもので、言えるのは、Muon の優位がこの線の上では見えないほど縮むということまでだ。どちらが勝つかはまだわからない。
右図は 16× Chinchilla まで延ばしたものだ。8× の時点で SOAP はすでに 130M と 520M で Muon を上回っていたが、著者らは 300M で 16× まで読ませてもう一度確かめ、SOAP はやはり勝った。130M でも同じだ。彼らは、SOAP や Kron が保持している二次モーメントが、データ量の多いときにより役立つのだろうと推測している。ただし付録の表では、300M、16× の最良の loss は SOAP 2.990、Muon 2.991 で、差は 0.001 しかなく、彼ら自身が座標降下法で「改善とみなす」しきい値 0.003 より小さい。この節のより確かな読み方は、データ量を増やすと、Muon がもともと持っていたリードが消えた、というものだ。
序盤の曲線は人をだます
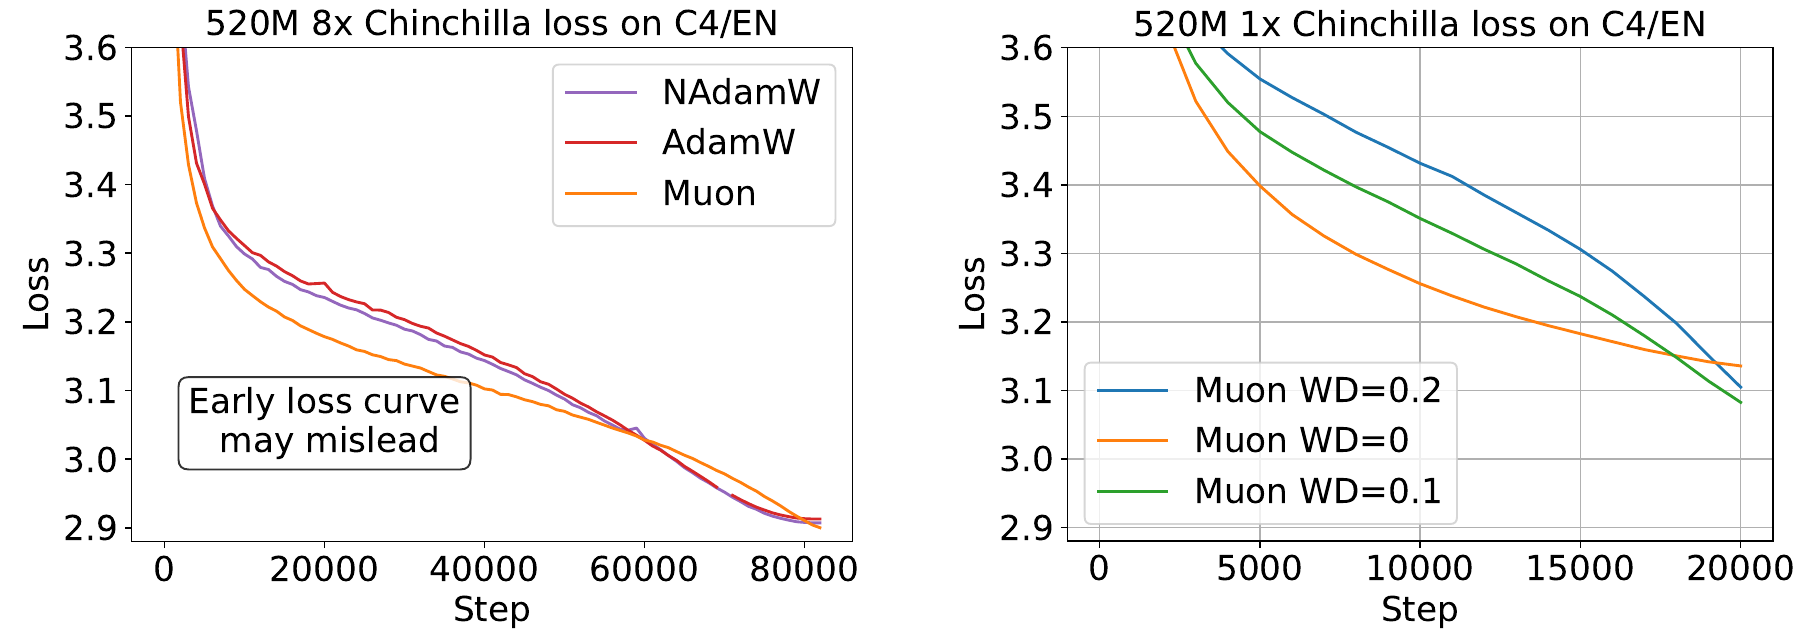
左図は 520M、8× の学習曲線の全体だ。Muon は前半で大きくリードしていて、3 万ステップ目で止めて比べればずっと速く見える。学習率が大きく減衰し始めると、AdamW と NAdamW が追いついてきて、約 6 万ステップで 3 本の線が交わり、終点はほとんど同じになる。
右図は、同じオプティマイザで 3 通りの重み減衰を使ったものだ。重み減衰を加えない Muon は序盤が最も速いが、後半は停滞し、最後は三つの中で最も悪い。重み減衰 0.1 の終点が最も良い。
だから著者らは、最終チェックポイントだけで比べることを勧めている。ここで彼らは Kimi の Muon 論文を名指ししている。その報告は Muon と AdamW の MoE モデルを比べるのに、まさに学習率が減衰しきっていない途中のチェックポイントを使っていた。
同じ節には観察がもう二つある。
- ハイパーパラメータ一つの違いで順位がひっくり返る。520M、8× で SOAP の学習率を最適値の 2 倍にすると、MARS に対するリードはほとんど消える。著者らが、ハイパーパラメータを一つだけ変えて loss が最適値から 0.02 以内に収まったすべての学習を集計すると、Muon、SOAP、MARS の三つの分布は互いに重なっていた。系統的な走査がなければ、順位はほとんど任意になりうる。
- 最適な重み減衰はオプティマイザによって違う。先に触れたように Lion は約 0.6、Kron は約 0.5 で、これが Kron が AdamW に勝てる鍵になっている。
これまでの「2 倍」はどこから来たのか
付録 G は先行論文の設定を一つずつ照らし合わせ、高速化が過大評価された原因を突き止めている。
- Sophia(2 倍):ピーク学習率が 6e-4 より低い。原因の一つは、当時使っていた Levanter のデータ読み込みが完全にはランダムにシャッフルしていなかったことで、著者らは再現時に、完全にシャッフルしてはじめて大きな学習率を安定して使えることに気づいた。彼らの設定では、Sophia は 0.5B 以下で有意な高速化を示さない。
- MARS(2 倍):ベースラインは Sophia と似ている。MARS 論文の第 1 版の図は、実は AdamW の学習率を 3e-3 に上げると大幅に良くなることをすでに示していた。
- Muon(2 倍):NanoGPT speedrun では約 1.3 倍。Kimi は 2 倍と測ったが、彼らの AdamW の学習率は低めで、400M から 1.5B で 8e-4 から 9e-4 しか使っていない。MoE の比較も、学習率が減衰しきっていない時点で取っていた。Essential AI の独立研究が測った token 効率は 1.1〜1.2 倍だ。
- SWAN、DION(2〜3 倍):1× Chinchilla 未満の区間で比べていて、そこではもともと高速化が大きく出る。DION が売りにしている通信コストは、この論文の比較には含まれていない。
- SPlus(2 倍):減衰させない固定の学習率を使っていて、これは一般的な事前学習の設定ではない。
同時期のもう一つの評価
Fantastic の 1 日前に、EPFL の Semenov、Pagliardini、Jaggi も arXiv で Benchmarking Optimizers for Large Language Model Pretraining を発表した。彼らは約 2,900 個のモデルを学習させ、約 3 万 GPU 時間を使って、同じく 11 種類の手法を比べた。モデルは 124M から 720M で、ほかに 520M の MoE が一つある。データは FineWeb で、系列長はわずか 512、バッチは 1.6 万から 200 万 token までさまざまだ。
両者には共通する結論が少なくない。たとえば重み減衰は 0 にしてはいけない、学習率は十分低くまで減衰させる必要がある、MARS のように分散を下げる AdamW の変種は確かに効く、といった点だ。最大の食い違いは行列型オプティマイザにある。Semenov らは AdEMAMix と MARS が Muon に勝ち、720M、バッチあたり 100 万 token では二つがはるかにリードすることを見出した。ところが Fantastic の結果は、Muon が MARS にはっきり勝つというものだった。
Fantastic は関連研究の節で、その原因を自ら分析している。
- バッチサイズ:Semenov らが 124M で最も丁寧に調整した実験は、バッチあたり 1.6 万と 13 万 token しかない。Fantastic が調整して得たバッチは、どれも約 40 万 token を下回らない。MARS や AdEMAMix は勾配を平均してノイズを下げるので、ノイズが支配的な小さなバッチの領域では有利だが、バッチが大きくなるとその優位は縮む。
- ハードウェア:EPFL は主に 1〜8 枚の H100 を使っているようで、小さなバッチのほうが効率がよい。Fantastic は 128 個の TPU を使っていて、大きなバッチでないと並列度を使い切れない。
- 調整:520M 前後の規模で、Fantastic が走査して得た最適な学習率は 4e-3 から 8e-3 だが、EPFL が使ったのは 1e-3 から 2e-3 で、その一部は小さなモデルからそのまま持ち込んで調整し直していなかった。Fantastic はさらに、Muon の埋め込み層と行列の重みの学習率を別々に調整している。
二つの研究には呼応するところもある。EPFL は、Lion と Signum はバッチを大きくするとはっきり改善するが、モデルが大きくなるとまたついていけなくなることを見出した。重み減衰を加えた Muon はすべての設定で安定していたが、原版の Muon はモデルが大きくなるにつれて性能が落ちた。
もっと大きな規模
1.2B という上限は、論文自身も限界として挙げている。2026 年 7 月、NVIDIA の SOAP, Muon, and Beyond: Pushing LLM Pretraining Scales は、比較を数十億パラメータまで押し広げた。
彼らの設定は Fantastic と大きく違う。
- モデルとデータ:8B の dense と、総パラメータ 30B・アクティブ 3B、総パラメータ 72B・アクティブ 8B の MoE。1 兆から 3 兆 token を読む。
- バッチ:ベースラインはバッチあたり約 2,500 万 token で、それを 2 倍、3 倍、4 倍に大きくし、要旨では最大約 1 億 token に触れている。
- 調整の方法:AdamW は Nemotron の元の本番レシピを使い、Muon と SOAP の学習率は主に Kimi の更新 RMS の整合で換算し、バッチを大きくするときは平方根則で学習率を調整した。Fantastic のように一つずつ走査してはいない。
結果は、Muon と SOAP が一貫して AdamW に勝ち、差はバッチが大きいときに最もはっきりした。バッチを大きくすると AdamW は劣化し、Muon は安定したままだ。30B の MoE では、同じバッチのもとで Muon の下流の成績はおおむね同等かそれ以上で、たとえば MMLU-Pro は 58.19 対 54.45、数学系の平均は 82.52 対 79.65 だった。72B の MoE で 2 倍のバッチの Muon と 1 倍のバッチの AdamW を比べると、コード系の平均は 4.5 高いが、数学系の平均は 3.2 低かった。SOAP は大きなバッチでの不安定さを直した後、loss が Muon よりわずかに低く、彼らはメモリが許すなら SOAP を優先するよう勧めている。
この二つの結果は両立しうる。Fantastic が測ったのは、AdamW が使いやすいバッチ(約 50 万〜100 万 token)で徹底的に調整した後の token 効率だ。NVIDIA が測ったのは、バッチを AdamW の臨界バッチサイズよりはるかに大きくしたとき、どれがまだ持ちこたえるかだ。Essential AI が 100M から 4B で見た状況も同じで、Muon は同じ loss に達するのに 10%〜15% 少ない token で済み、しかもこの優位はバッチを大きくしても維持されるか、むしろ広がる。
そのほかの観察と限界
すべてのオプティマイザに共通する現象がほかにもいくつかある。重み減衰があると、パラメータのノルムはどれも学習率スケジュールに合わせて先に上がってから下がる。学習率の減衰期間には勾配ノルムが上がるが、loss はそれにつれて悪化しない。各オプティマイザの学習 loss と検証 loss は同じように推移し、どれかの汎化が特に良いということは見られない。
限界としては、モデルが最大 1.2B までであることを著者ら自身がはっきり書いている。ほかの条件も一緒に覚えておく必要がある。この論文は token 効率だけを比べていて、実時間や通信は考慮していない。データのレシピは一つ、アーキテクチャは dense の Llama だけだ。バッチはどれも数十万 token 以上だ。
結論
この論文は 3 段階の調整で 11 個のオプティマイザをそれぞれ最適に近づけ、130M から 1.2B、1× から 8× Chinchilla で token 効率を換算した。調整した後では、最も速い行列型オプティマイザでも、小さなモデルで約 1.3〜1.4 倍、1.2B では約 1.1 倍しか残らない。スカラー型は AdamW とほぼ同じだ。これまでの 2 倍の多くは、弱いベースラインと途中のチェックポイントから来ていた。
オプティマイザの論文を読むときは、まず AdamW の学習率が走査されているか、比べているのが学習を終えたチェックポイントか、そして実験がいくつのモデルサイズとデータ量にまたがっているかを確かめるとよい。自分でオプティマイザを替える前にも、まず AdamW の学習率、重み減衰、ウォームアップを一通り走査しておくこと。出発点が GPT-3 のレシピのような低めの学習率なら、この作業だけで学習のステップ数を半分にできるかもしれない。
では、ビーストたちはどこで見つかるのか(Where to Find Them)。NVIDIA の 2026 年の結果を見る限り、どうやらバッチ 2,500 万 token 以上のあたりらしい。