原論文
Symbolic Discovery of Optimization Algorithms
- 発表先
- NeurIPS 2023国際会議
- arXiv への初回投稿
- arXiv:2302.06675
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizerslion2023,
  title = {{Symbolic Discovery of Optimization Algorithms}},
  author = {Xiangning Chen and Chen Liang and Da Huang and Esteban Real and Kaiyuan Wang and Yao Liu and Hieu Pham and Xuanyi Dong and Thang Luong and Cho-Jui Hsieh and Yifeng Lu and Quoc V. Le},
  year = {2023},
  eprint = {2302.06675},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.06675}
}
まずコードを一つ見てほしい。勾配をクリッピングしてから arcsin を取り、続いて内挿を 2 回行う。そのうち 1 回の係数は 1.109 で、1 より大きい。更新量を計算した後で、今度はモーメンタムの変数を更新量の cosh に書き換えている。
このコードは人間が書いたものではない。Google Brain のチームは AdamW から出発し、コンピュータに一文ずつランダムにプログラムを書き換えさせ、全部で百万を超える候補を生み出し、約 3,000 TPU v2 日を費やして、この一つを選び出した。作用のない文を削って簡略化すると、残るのはわずか 4 行で、名前は Lion(EvoLved Sign Momentum)だ。
この 4 行が保存するのはモーメンタム一つだけで、各パラメータの更新は符号しか見ない。論文によれば、Lion は ImageNet で ViT の精度を最大 2% 上げ、JFT では事前学習の計算を最大 5 倍節約し、さらに BASIC-L のゼロショット ImageNet を 88.3% まで押し上げた。
同じ論文は Lion が勝てない場面も挙げていて、しかもかなり正直に挙げている。このノートは二つに分けて読む。前半では、コンピュータがどうやってこの 4 行を探し出したかを見る。後半では、「符号しか見ない」という設計が何をもたらし、代わりに何を犠牲にするのか、そして後に言語モデルの事前学習でどうだったかを見る。
問題の定義
2023 年の時点で、人手で設計されたオプティマイザはすでにたくさんあり、その多くは適応的手法だった。それでも大規模な言語、視覚、マルチモーダルのモデルを学習させるとき、みんなが使っていたのは AdamW か、メモリを節約するための Adafactor だった。
コンピュータにオプティマイザを探させる試みも少なくないが、どれもどこかで行き詰まっていた。
- 学習による最適化(learning to optimize):ニューラルネットワークを学習させ、パラメータの更新量を直接出力させる。こうしたブラックボックスのオプティマイザは少数の小さなタスクでしか学習されておらず、大きなモデルや長い学習に移ると汎化しない。
- 式の木の中で探索する:たとえば 2017 年に Bello らは強化学習で PowerSign、AddSign を見つけた。探索を回せるように演算子は固定され、木の大きさも制限されていたので、モーメンタムをどう累積し、どう更新に入れるかは変えられない。論文は、これがまさに Lion の最も重要な部分だと特に指摘している。
- AutoML-Zero:機械学習の流れ全体まで探索に任せるが、評価はおもちゃのようなタスクでしか行っていない。
著者らは問題を二つに分けた。一つ目は、プログラムの空間は無限で、良いプログラムは極めてまばらだということ。安い代理タスクで 200 万個のプログラムをランダムにサンプリングしたが、最良のものでも AdamW にはっきり負けた。二つ目は、探索は小さなタスクでしか評価できず、本当に使いたいタスクは 1 万倍以上大きいことだ。小さなタスクで勝ったプログラムは、大きなタスクになるとうまくいかないことが多い。
問題の解決
オプティマイザを一つのプログラムとして書く
探索の対象は train 関数だ。入力は重み w、勾配 g、このステップの学習率 lr に、履歴を記録するための 0 で初期化された二つの変数 m、v を加えたもので、出力はこのステップで引く更新量だ。AdamW をこの形で書くと次のようになる(論文の Program 3。バイアス補正と は省略)。
def train(w, g, m, v, lr):
    g2 = square(g)
    m = interp(g, m, 0.9)
    v = interp(g2, v, 0.999)
    sqrt_v = sqrt(v)
    update = m / sqrt_v
    wd = w * 0.01
    update = update + wd
    lr = lr * 0.001
    update = update * lr
    return update, m, v
interp(x, y, a) は (1 - a) * x + a * y に等しく、つまり指数移動平均だ。このシグネチャは意図的に AdamW と同じく追加の変数を二つだけにしているので、見つかるアルゴリズムが AdamW よりメモリを食うことはない。
関数の本体は代入文の並びで、長さにもローカル変数の数にも上限はなく、各文は四十数個のよく使われる数学関数のどれか一つを呼び出す。その多くは NumPy の関数や線形代数の演算に対応している。条件分岐、ループ、ユーザー定義関数も試したが、より良い結果にはつながらなかったので入れていない。
突然変異は 3 種類ある。ランダムに文を一つ挿入する、文を一つ削除する、ある文の引数を一つ変える。引数は既存の変数にも、新しい定数にも置き換えられる。既存の定数には を掛け、 は標準正規分布から引く。定数はアルゴリズムのハイパーパラメータで、たとえば上の 0.001 はピーク学習率、0.01 は重み減衰だ。
プログラムの中には、出力に影響しない冗長な文があってもかまわない。突然変異は一度に一文しか変えないので、2〜3 文が協調する必要のある大きな変更をしたいとき、冗長な文がひとまず足がかりになる。
探索を回せるようにする
探索には正則化進化(regularized evolution)を使う。個体群は 1,000 個のプログラムに保ち、各ラウンドでランダムに二つを引き、良いほうを複製して突然変異させ、新しいプログラムを個体群に加えて、最も古いものを取り除く。
初期の個体群はすべて AdamW にし、2 種類のリスタートを組み合わせる。一つは AdamW からやり直すもので、何度も走らせて探索の幅を広げる。もう一つは現時点で最良のプログラムからやり直すもので、さらに深く掘り下げる。探索ごとの成績のばらつきが大きいので、何度も走らせることが欠かせない。4 倍の計算を使った AdamW のハイパーパラメータ調整や、4 倍の計算を使ったランダム探索と比べても、進化的探索ははっきり勝った。
コストを抑えるもう一つの鍵が、抽象実行(abstract execution)だ。プログラムを実際に実行する前に、三つのことを行う。
- 各変数の型と形状を推論し、型や形状が合わないプログラムはそのまま捨て、正しい子プログラムが生まれるまで突然変異を続ける。
- 入力から出力までの関数ハッシュを計算する。意味が同じで書き方だけ違うプログラムは表を引けばよく、走らせ直す必要はない。
- 出力がどの文に依存しているかを追跡し、冗長な文を見つけ出す。
5 回の探索、各回 30 万個のプログラムの統計では、探索の後半には約 70% の文が冗長で、それを削るとプログラムは平均で 3 分の 1 の長さになった。キャッシュのヒット率は約 89% で、探索コストは約 10 分の 1 に下がった。
代理タスクはどれも小さい。視覚では ImageNet の 10% で 3 層、96 次元の ViT を学習させ、画像を 64×64 に縮め、バッチサイズ 64 で 30k ステップ。言語では LM1B で 2 層、128 次元の Transformer を学習させ、20K ステップ。各プログラムは 1 個の TPU v2 で 20 分以内に評価を終え、検証精度かパープレキシティを fitness にする。
各探索は 100 個の TPU v2 で約 72 時間走り、20〜30 万個のプログラムを生み出すが、キャッシュのおかげで実際に実行されるのは 2〜3 万個だけだ。5 回の探索に、最良のプログラムからリスタートする 1 ラウンドを加えて、総コストは約 3,000 TPU v2 日になる。
小さなタスクから大きなタスクへ
探索の fitness は上がり続けるのに、もう少し大きなタスクで検証すると下がり始める。論文はこれを meta-overfitting、つまり代理タスクへの過学習と呼んでいる。著者らは 50 回探索を走らせ、それぞれ探索のどの段階で過学習が始まるかを記録した。半分の探索はかなり早く過学習し、かなり後になって起きるロングテールもあった。そして過学習が遅い探索ほど、見つかったプログラムは大きなタスクで良かった。
そこで彼らは探索に加えて、ファネル選択(funnel selection)というふるいをもう一段設けた。代理タスク A から出発し、モデルとステップ数を大きくして 10 倍の大きさのタスク B を作る。B でベースラインに勝ったプログラムだけを、100 倍の大きさのタスク C に送る。
ふるいを通ったプログラムは、さらに 3 回簡略化する。まず抽象実行で冗長な文を削る。次に「作用はあるが、削っても差がとても小さい」文を削る(挿入を禁止した進化で行うこともできる)。最後に人手で並べ替え、変数名を変えて、数学的に等価な簡単な形にまとめる。
Program 4 から 4 行の Lion へ
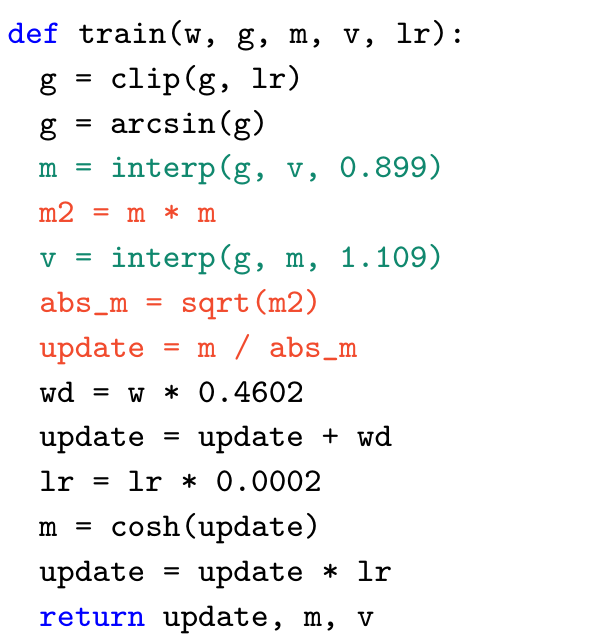
冒頭のあの奇妙なコードがこれだ。1 行ずつ簡略化していこう。
- 赤の 3 行:
m2 = m * m、abs_m = sqrt(m2)、update = m / abs_mは 、つまりsign(m)だ。 clipとarcsin:取り除いても品質が下がらなかったので削った。このステップは元の式と等価ではない。clipはそのステップの勾配ノルムに応じて勾配全体を縮め、その倍率はステップごとに違う。勾配がモーメンタムの内挿に入った後も、そのステップと履歴の相対的な比重を変えてしまう。これらを削った根拠は実験結果だ。- 最後の
cosh:mに書き込まれるが、次のラウンドの最初でmは代入し直されるので、この行には作用がない。 - 緑の 2 行:
mは現在の勾配とvを 0.899 で内挿したもので、vは勾配とこの新しいmを 1.109 で内挿したものだ。1 行目を 2 行目に代入すると、vは係数が 1 に近い移動平均を別の書き方にしただけのものになる。論文はこれを に整理している。mのほうは、sign に送る前に、現在の勾配と履歴を約 0.9 で内挿した結果だ。 - 定数:
0.4602は重み減衰、0.0002は学習率のスケーリングで、簡略化すると二つのハイパーパラメータになる。
もう一つ、Adam の移動平均は 0 から始まるので、最初の数ステップの推定は小さめになり、更新の大きさがずれないようにバイアス補正が必要になる。論文は、バイアス補正は方向を変えず、sign は方向しか見ないので、このステップも取り除いたと指摘している。
整理した Lion(論文の Algorithm 2)は次のとおりだ。
デフォルトは 、。AdamW と比べると、二次モーメント がなく、 もなく、バイアス補正もない。公式の PyTorch 実装の 1 ステップはこれだけだ(google/automl)。
p.data.mul_(1 - lr * weight_decay)                # 分離型の重み減衰
update = exp_avg * beta1 + grad * (1 - beta1)     # c_t:現在の勾配とモーメンタムを内挿
p.add_(update.sign_(), alpha=-lr)                 # 符号だけを取る
exp_avg.mul_(beta2).add_(grad, alpha=1 - beta2)   # m_t:beta2 でモーメンタムを更新
最後の 2 行の順序に注意してほしい。重みの更新に使うのは で、次のステップのために保存するのは だ。二つは使う係数が違う。
二つの β はそれぞれ何を受け持つのか
なぜ β が二つ必要なのか? を展開すると、過去の各勾配が更新方向の中でどれだけの比重を占めるかを計算できる。現在の勾配 は を占める。 ステップ前の勾配は を占め、デフォルト値で計算するとおよそ だ。下の図は、直近 ステップの比重を足し合わせて描いたものだ。
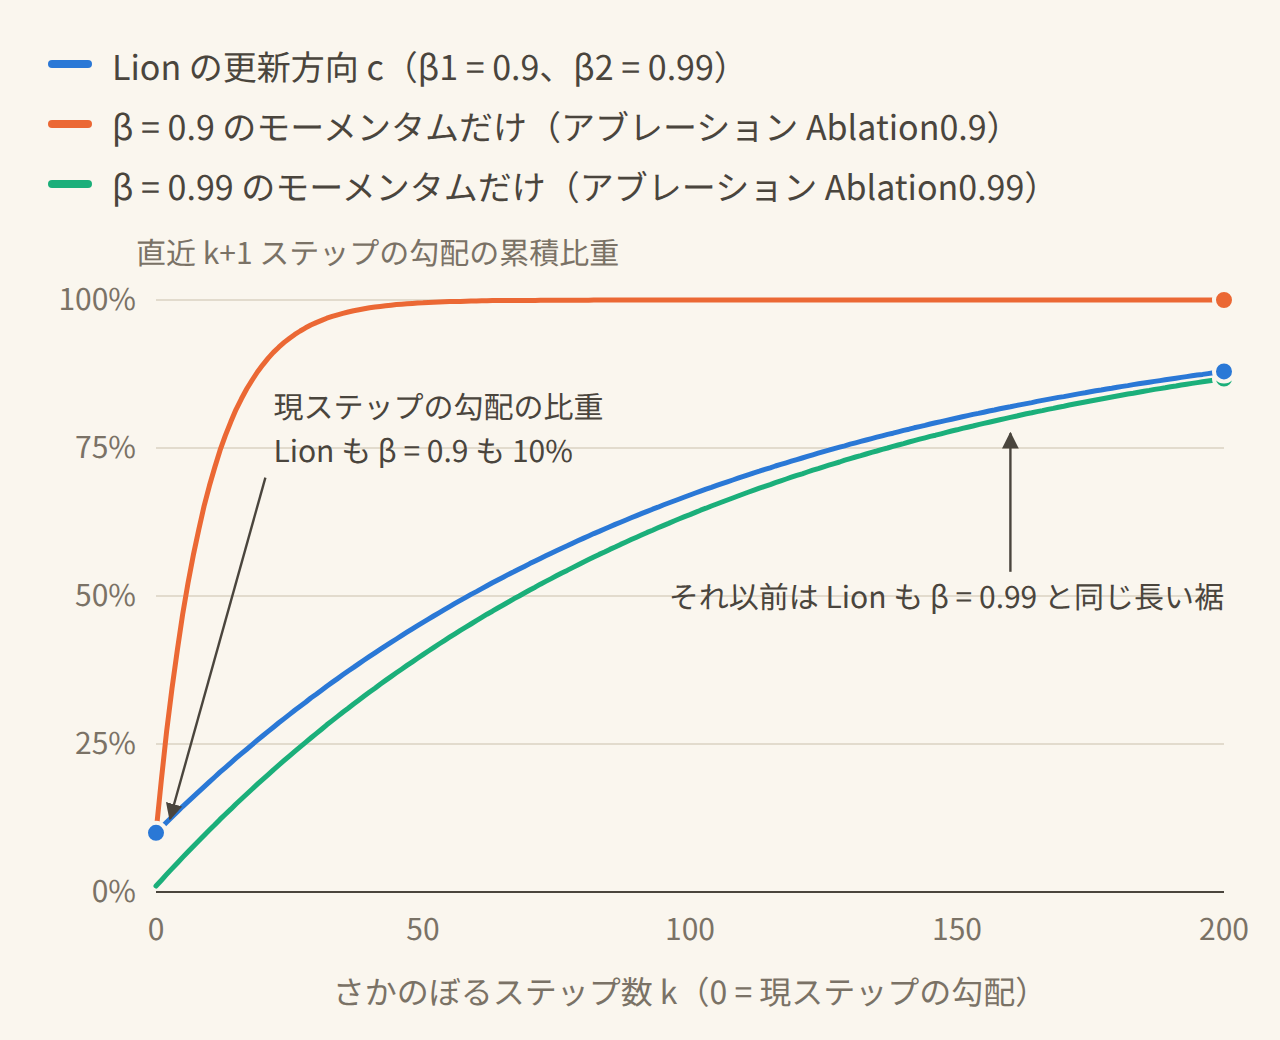
橙の線は のモーメンタムを一つだけ使ったもので、現ステップの勾配は 10% を占めるが、覚えているのは直近の 20〜30 ステップだけだ。緑の線は だけを使ったもので、覚えている履歴は約 10 倍長くなるが、現ステップの勾配は 1% しかない。Lion の青い線は両方を取る。更新では現ステップの勾配が 10% を占め、橙の線と同じだ。それより前の部分は、緑の線の長い裾をたどる。
論文のアブレーションでやっているのが、まさにこの橙の線と緑の線だ。ViT-B/16(ImageNet、RandAug と Mixup あり)では、モーメンタムを一つだけ使って sign を取る二つの版の精度は 79.54%()と 79.90%()で、どちらも AdamW の 80.12% に負け、Lion は 80.77% だった。PG-19 の言語モデルでも結論は同じだ。
Lion と 2018 年の signSGD(およびそのモーメンタム版)の違いもここにある。どちらも sign を取るが、モーメンタムの累積の規則が違う。signSGD の出発点は分散学習の通信量を減らすことで、画像分類の畳み込みネットワークでの性能は劣る。
sign を取る代償
sign は各座標の更新の大きさをすべて同じにする。重み減衰を除けば、各パラメータは 1 ステップごとに か のどちらかだ。
Adam の更新 は座標ごとに大きさが違い、全体の二乗平均平方根(RMS)は通常 1 より小さい。Moonshot AI が Muon の論文で測った値は 0.2〜0.4 だ。sign の出力はすべて ±1 なので RMS はちょうど 1 で、更新ベクトル全体のノルムは大きくなる。論文の勧めは、Lion の学習率を AdamW より 3〜10 倍小さくし、初期、ピーク、終了の学習率をすべて同じ比率で縮めることだ。学習率スケジュールや勾配クリッピングなど、そのほかの設定は変えなくてよい。
学習率を小さくすれば、重み減衰も合わせて調整しなければならない。分離型の重み減衰が実際に重みに作用する強さは なので、 が 3〜10 倍小さくなれば、 を 3〜10 倍大きくして、近い強さを保つ必要がある。論文が挙げている実際の数値をいくつか示す。
| タスク | Lion(、) | 比較対象(、) |
|---|---|---|
| ViT-B/16、強い拡張 | 1e-4、10.0 | AdamW 1e-3、1.0 |
| 拡散モデル | 3e-5、0.1 | AdamW 3e-4、0.01 |
| 7.5B 言語モデル | 1e-4、0.01 | Adafactor 1e-3、0.001 |
原論文 §5 をもとに整理。
は原則としてデフォルト値でよい。言語モデルの実験だけは別途調整し、、 に変えている。著者らの経験では、 を少し小さくして覚える履歴を少し短くすると、学習が安定しやすい。
利点はメモリと速度にある。Lion が保存するのはモーメンタム一つだけで、AdamW は二つ保存しなければならない。ViT-B/16、解像度 224、バッチ 4,096 を例にとると、AdamW は少なくとも 16 個の TPU v4 がないと載らないが、Lion なら 8 個で済む(どちらもモーメンタムは bfloat16 で保存)。演算が単純なので、実験では 1 秒あたりのステップ数も AdamW や Adafactor より 2%〜15% 速かった。どれだけ速いかは、タスク、コード、ハードウェアによって変わる。
議論
比較はすべて AdamW を相手にしていて、メモリが厳しい大規模モデルでは Adafactor を相手にしている。モーメンタム SGD とは ResNet でしか比べていない。どのオプティマイザも、ピーク学習率と重み減衰を対数スケールで調整した。デフォルトは cosine 減衰に 10K ステップのウォームアップで、モーメンタムは bfloat16 で保存する。
画像分類:最も見栄えのする一組
ImageNet でゼロから学習させた結果(3 回の平均。ResNet-50 はバッチ 1,024 で 90 エポック、ほかのモデルはバッチ 4,096 で 300 エポック)から、Top-1 を抜き出す。
| モデル | 拡張 | AdamW | Lion |
|---|---|---|---|
| ResNet-50 | なし | 76.34 | 76.45 |
| Mixer-B/16 | なし | 68.12 | 70.11 |
| ViT-B/16 | なし | 75.48 | 77.44 |
| ViT-B/16 | あり | 80.12 | 80.77 |
| CoAtNet-3 | あり | 84.45 | 84.87 |
原論文 Table 2 をもとに整理。「あり」は RandAug と Mixup。ResNet-50 にはほかにモーメンタム SGD の 76.22 がある。
傾向はとても一貫している。ViT や MLP-Mixer のように帰納バイアスの少ないアーキテクチャほど差が大きい。強いデータ拡張を加えると差は縮み、畳み込みネットワークの ResNet-50 では三つのオプティマイザがほぼ引き分けになる。
著者らの ViT についての説明は、sign がある種のノイズをもたらし、それが正則化の効果を持つというものだ。Lion で学習させた ViT-B/16 は学習損失がむしろ高い(0.75 対 0.61)のに、検証精度は 2% 高い。重みにガウスノイズを加えたときの Lion のモデルの損失(1.37)も、AdamW のモデル(3.74)よりはるかに低く、より平坦な領域に収束していることを示している。この説明には、今のところこうした間接的な証拠しかない。
JFT のような大規模データでは、差はさらにはっきりする。
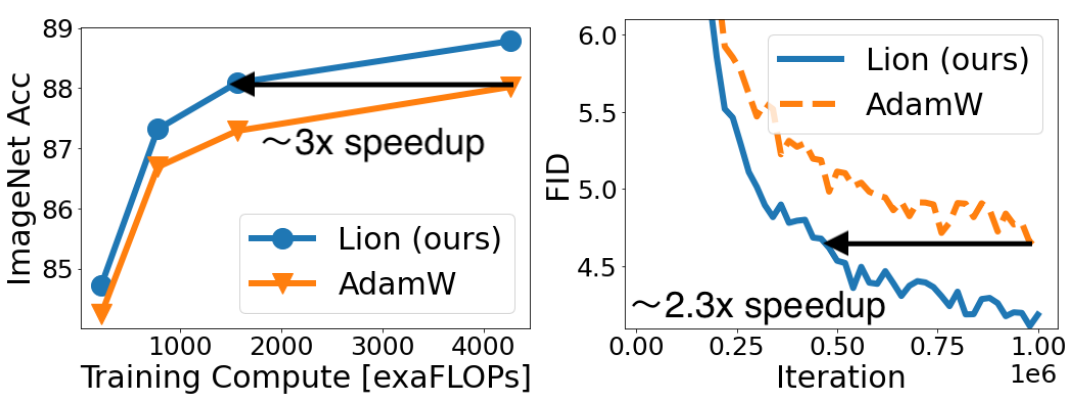
左図の横軸は事前学習の計算量、縦軸はファインチューニング後の ImageNet 精度で、曲線上の点は ViT-B/16、ViT-L/16、ViT-H/14 と、異なる事前学習予算にわたる。矢印が示しているのは、Lion で学習させた ViT-L/16 が AdamW で学習させた ViT-H/14 に追いつき、ImageNet と ImageNet V2 では事前学習の計算を 3 倍、ImageNet ReaL では 5 倍節約することだ。Zhai らが AdamW で ViT-L/16 を 400 万ステップまで学習させても、成績は Lion の 100 万ステップに及ばなかった。
ファインチューニング後、より難しい分布シフトのテストセットでは、Lion で学習させた ViT-L/16 のリードはさらに大きく、ImageNet-A で 6.08、ImageNet-R で 5.54 高い。データを JFT-3B に替えると、Lion で学習させた ViT-g/14 はパラメータ数が 1.8 分の 1 でありながら以前の ViT-G/14 を上回り、Lion の ViT-G/14 は 90.71% に達した。
画像とテキストの対照学習でも進歩があった。LiT は画像タワーを凍結してテキストタワーだけを学習させるもので、ゼロショット ImageNet は三つの規模すべてで約 0.7〜1.1 高くなった。BASIC-L は画像タワーの事前学習と対照学習の二つの段階をどちらも Lion に替え、ゼロショット ImageNet は Adafactor の 85.7% から 88.3% に上がり、当時の最高記録より 2.0 高かった。ファインチューニング後は 91.1% で、記録より 0.1 高い。
拡散モデル:解像度が高いほど差が開く
右図は ImageNet 256×256 の無条件生成だ(改良版 U-Net、バッチ 2,048、一定の学習率、DDPM サンプリング 1,000 ステップ、guidance なし)。Lion は 44 万ステップで AdamW の最終 FID に達し、ステップ数を 2.3 倍節約した。最終 FID は 4.1 対 4.7。64×64、128×128 でも改善はあるが、解像度が高いほど差は大きい。
Imagen 型のテキストからの画像生成では、良し悪しが入り混じる。64×64 のベースモデルでははっきりした改善がない。64→256 の超解像モデルでは、Lion のほうが CLIP スコアが高く、FID の曲線のノイズも少ない。
言語モデル:規模が大きくなると引き分け
小規模な実験には Wiki-40B と PG-19 を使い、モデルは 110M、336M、731M、各バッチ token で 12.5 万ステップ学習させた。Lion の検証パープレキシティは常に低く、中型モデルではそれぞれ 1.6 倍、1.5 倍の高速化、大型モデルは PG-19 で 2 倍に達した。
規模を大きくすると話が変わる。著者らは 1.6 兆 token のデータセットで、GPT-3 のやり方に倣って 1.1B、2.1B、7.5B の三つのモデルを、それぞれ 300B token、バッチ 3M token で学習させ、比較対象は Adafactor にした。学習の全過程を通じて、両者のパープレキシティに差はなかった。Lion がわずかにリードしたのは 1-shot の in-context 評価の平均スコアだけで、たとえば 7.5B モデルでは生成系タスクの平均が 24.1 → 24.7、理解系タスクの平均が 61.3 → 61.7 だった。
マスク言語モデル(C4)のパープレキシティは、Lion 対 AdamW で 4.18 対 4.25、3.42 対 3.54、3.18 対 3.25。T5 を GLUE でファインチューニングすると、三つの規模で平均スコアがそれぞれ 0.4〜0.5 高い。
バッチサイズと調整の許容幅
sign は勾配のノイズを増幅するので、直感的には、Lion は方向を正確に推定するために大きめのバッチが必要なはずだ。著者らは実際に測った。
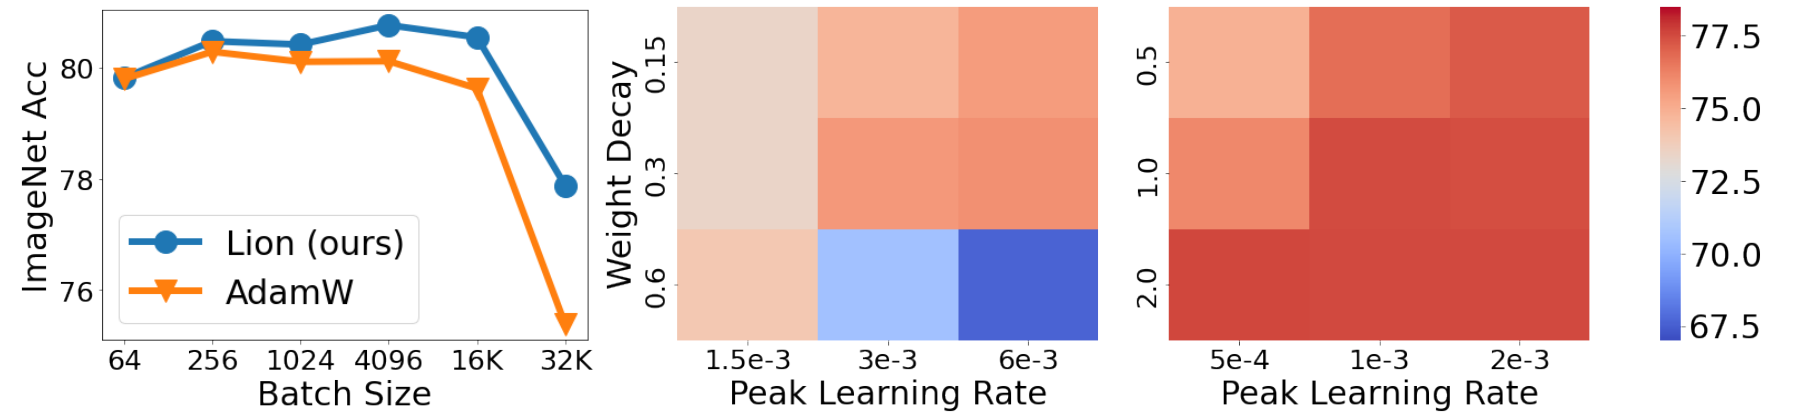
左図は学習を 300 エポックに固定し、バッチサイズを変えている。AdamW の最良のバッチは 256、Lion は 4,096 で、確かに大きなバッチを好む。ただしバッチを 64 まで縮めても、Lion は崩れなかった。バッチを 32K まで大きくすると(ステップは 1.1 万しか残らない)、Lion 77.9%、AdamW 75.4% だ。
中央と右の 2 枚のヒートマップは、それぞれ 3 通りの学習率と 3 通りの重み減衰を走査している。AdamW は学習率と重み減衰がどちらも大きめの隅で 67.5% 付近まで落ちる。Lion の 9 マスのうち、色がはっきり薄いのは、学習率と重み減衰がどちらも最小のマスだけだ。この設定では、Lion はハイパーパラメータに比較的鈍感だ。ただし 2 枚の図のマスはそれぞれ推奨範囲に従って選ばれたもので、Lion の学習率はもともと 3〜10 倍小さいことに注意してほしい。
論文は RAdam、NAdam、AdaBelief、AMSGrad、そして AutoML で見つかった PowerSign、AddSign とも比べている(それぞれ学習率と重み減衰を調整し、残りは Optax のデフォルト値)。ViT-B/16 では、これらのベースラインは 78.50%〜80.32% の間に収まり、はっきりした勝者はおらず、Lion は 80.77% だった。PowerSign と AddSign が最も悪い二つで、これも「自動で探したオプティマイザは実際のタスクに一般化しにくい」という昔からの経験と合っている。
論文自身が書いた限界
著者らは第 6 節で限界をはっきり列挙している。
- 探索の偏り:探索空間の設計はやはり一次のオプティマイザから着想を得ているので、見つかるものは既存のアルゴリズムに似やすく、二次の手法に必要な関数も欠けている。探索のコストは高く、簡略化にも人手が要る。
- 差がとても小さいか、差がないタスク:ResNet では三つのオプティマイザの差はとても小さい。強い拡張は改善を食ってしまう。Imagen のベースモデル、大規模な社内データセットでの言語モデルのパープレキシティ、C4 のマスク言語モデルでは、Lion は AdamW とほぼ同じだ。著者らは、共通点はデータ量が多く品質が高いことだと考えている。
- バッチが小さすぎる:バッチが 64 より小さいと、Lion は AdamW より良くならないかもしれない。
- メモリ:それでも bfloat16 のモーメンタムを一つ保存する必要があり、超大規模モデルにとってはやはり高くつく。
2 点目を挙げるとき、著者らはさらに、パープレキシティは in-context の評価より信頼できる指標だと言える、と一言補っている。言い換えると、著者ら自身がより信頼できると考えるその指標で、大規模言語モデルには差が見られなかったということだ。
その後の評価
言語モデルの事前学習はその後オプティマイザの主戦場になり、Lion は複数の独立した研究で測り直されたが、見られた改善はどれも原論文より小さかった。
- Kaddour ら(NeurIPS 2023):固定した計算予算で BERT と T5 を事前学習させると、Lion や Sophia などの手法の改善は、学習率を最後まで完全に減衰させるベースラインを相手にすると消えてしまった。
- Zhao ら(ICLR 2025):150M から 1.2B の自己回帰言語モデルで、SGD を除けば、Adam、Adafactor、Lion、Sophia の最良の性能と学習率に対する安定性はどれも似たようなものだった。彼らはまた、 の Lion は Signum(モーメンタム付きの signSGD)そのものだと指摘している。
- Semenov ら(2025 年 9 月):Lion と Signum は小さなバッチではとても悪く、バッチを大きくすると大幅に改善する。しかし 720M のモデル、各バッチ 100 万 token になると、ほかの手法についていけなくなる。
- Wen ら(2025 年 9 月):各オプティマイザでそれぞれ完全なハイパーパラメータ走査を行った後では、Lion は AdamW より最大 5% 遅く、ときどきわずかに速い程度で、モデルが大きいほど後れが大きくなる。彼らが走査で見つけた最適値は、ちょうど上の推奨を検証するのに使える。130M、1× Chinchilla の設定で、AdamW の最適な学習率は 0.008、重み減衰は 0.1 だった。Lion の表での最良の組み合わせは 0.002 と 0.7 で、学習率だけを 0.001 に、あるいは重み減衰だけを 0.6 に変えると、loss はさらに 0.003 ほど低くなる。学習率が 4〜8 倍小さく、重み減衰が 6〜7 倍大きいのは、どちらも Lion 論文の「3〜10 倍」の推奨の範囲に収まっている。
コミュニティの実装での経験も似ている。lucidrains の lion-pytorch の README には、一連の使用報告が記録されている。Adam の学習率をそのまま使うと、Lion は Adam よりずっと悪い。学習率を 3 で割ると、序盤はむしろ勝つ。「10 倍小さく」のルールをそのまま当てはめた回は、最悪の結果になった。README は最後に、バッチ 64 以上でだけ使うよう勧め、否定的な結果の多くは強化学習のように論文が評価していない設定で出ていることも記している。
結論
Lion はプログラム探索で見つかり、人手で簡略化されたオプティマイザだ。更新は で、モーメンタムは別に で累積する。各パラメータの 1 ステップあたりの移動量はどれも一定の で、保存するモーメンタムは一つだけだ。進歩が最もはっきりしているのは ViT と JFT、画像とテキストの対照学習、高解像度の拡散モデルで、その進歩にもどれも条件が付く。大きなバッチ、Transformer 系のアーキテクチャ、そして強すぎないデータ拡張だ。
AdamW を Lion に替えるなら、学習率を 3〜10 で割り、重み減衰に同じ倍率を掛け、バッチが小さすぎないことを確かめる。そのうえで 3 倍から走査を始め、いきなり 10 倍を当てはめないこと。言語モデルなら、まず 、 を試すとよい。
探索は AdamW から出発し、3,000 TPU 日かけて進化して、最後に言語モデルの事前学習では AdamW とほぼ同じ速さのオプティマイザにたどり着いた。少なくとも、オプティマイザの状態は半分になった。