原論文
Adafactor: Adaptive Learning Rates with Sublinear Memory Cost
- 発表先
- ICML 2018国際会議
- arXiv への初回投稿
- arXiv:1804.04235
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersadafactor2018,
  title = {{Adafactor: Adaptive Learning Rates with Sublinear Memory Cost}},
  author = {Noam Shazeer and Mitchell Stern},
  year = {2018},
  eprint = {1804.04235},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1804.04235}
}
T5 論文の学習設定を開くと、オプティマイザの行には「For optimization, we use AdaFactor」と書いてある。その後の FLAN や Flan-T5 の微調整、PaLM の 5,400 億パラメータの事前学習も、これを使っていた。
源流に戻ると、Adafactor の論文で実験したタスクは一つだけで、英独翻訳の Transformer、学習 1 回あたり TPU v2 1 個で 2 時間足らずだった。Noam Shazeer と Mitchell Stern が解決したかった問題は 1 ページ目に書いてある。Adam はメモリを食いすぎるのだ。
問題の定義
Adam はパラメータ一つごとに、一次モーメント と二次モーメント という二つの数を余分に保存する。論文によれば、これでメモリは 3 倍になる。重みが 1 セット、 が 1 セット、 が 1 セットだ。 のフィードフォワード層の重みで計算すると、パラメータは 4,194,304 個あるので、Adam はさらに 8,388,608 個の数を保存しなければならない。
2018 年当時、著者らは計算能力の伸びがメモリ容量の伸びよりはるかに速く、メモリがすでにモデルサイズの上限の一つになっていると見ていた。重みとオプティマイザの状態だけを数えるなら、Adam が余分に持つ 2 セットのせいで、同じメモリに載るモデルは 3 分の 1 の大きさになる。
著者らは四つのことを実現しようとした。
- 二次モーメントを 個から 個に圧縮する。
- 一次モーメントを取り除く()。
- モーメンタムを取り除いたあとに出てくる不安定さに対処する。
- ステップサイズを、パラメータの大きさに対する比率に変える。
最初の二つはメモリの節約、三つ目は節約によって生じた面倒の後始末、四つ目は著者らがついでに加えた改良だ。
問題の解決
行和と列和だけを覚える
ある層の重みが の行列だとすると、Adam はそれと同じ大きさの、勾配の 2 乗の指数平均 を保持する。もし二つの小さな行列 、 だけを保存して とできれば、メモリはずっと少なくて済む。問題は、どんな方法で分解するかだ。
最もよく使われる低ランク近似は打ち切り SVD で、Frobenius ノルムのもとで最適だが、問題が二つある。一つは、上位 個の特異ベクトルは足し合わせられないことだ。二つの行列を足した後の特異ベクトルは、それぞれの特異ベクトルと単純な関係にないので、指数平均につなげられない。もう一つは、近似した要素が負になりうることで、Adam は の平方根をとって逆数にする必要がある。
著者らは代わりに、非負値行列分解でよく使われる generalized KL divergence、別名 I-divergence を使った。
これは常に 0 以上で、 のときだけ 0 になる。目標は、、 がどちらも非負という条件のもとで を最小にすることだ。一般のランク では交互最適化が必要になるが、ランク 1 の場合には解析解がある(論文の Lemma 1)。
は各行(row)の和、 は各列(column)の和で、分母はすべての要素の総和だ。平たく言えば、第 行・第 列の推定値は「第 行の和 × 第 列の和 ÷ 総和」になる。
の例で計算してみよう。
左上は 、右下は で、行列全体がそっくりそのまま復元される。2 行目がちょうど 1 行目の 3 分の 1 なので、 自体がランク 1 だからだ。右下の 2 を 8 に変えると、行和は 、列和は 、総和は 30 になり、右下の推定値は にしかならない。この分解は、各行・各列の全体的な大きさは覚えていられるが、あるマスだけが突出していることは覚えていられない。
この解は行和と列和しか使わず、どちらも の線形関数なので、「平均してから合計する」と「合計してから平均する」は同じになる。実装では、行和と列和にそれぞれ指数平均をかければよく、完全な を先に復元する必要はない。 のあの重みなら、二次モーメントは 4,194,304 個の数から 5,120 個になる。
著者らは の版を Algorithm 2 として書いている。
そのうえで、Adam と同じように で更新する。バイアスやベクトル形式のパラメータは、もとどおり要素ごとの を保つ。もともと大きくないからだ。
モーメンタムを外したら、問題が起きた
二つ目はもっと単純で、 として も保存しない。
実験はすべて WMT'14 英独の Transformer で行い、100,000 ステップ、各バッチはソース側トークン約 4,096 個とターゲット側トークン約 4,096 個で、元の Transformer 論文のおよそ 8 分の 1 だ。どの設定も 2 回ずつ走らせる。1 回はウォームアップありで、学習率は 。もう 1 回はウォームアップなしで、最初から を使う。指標は newstest2013 開発セットの BLEU だ。
| 設定 | ウォームアップあり | ウォームアップなし |
|---|---|---|
| (A) Adam、 | 25.6 | 0.1 |
| (B) Adam、 | 25.4 | 23.1 |
| (C) 二次モーメントを分解、 | 25.4 | 0.2 |
| (D) 行平均のみ | 25.2 | 0.3 |
| (E) 列平均のみ | 0.3 | 0.5 |
原論文 Table 2 をもとに整理。すべての設定で 。
ウォームアップありなら、モーメンタムを外しても(A 対 B)、さらに二次モーメントを分解しても(C)、BLEU の差はコンマ数ポイントだけだ。(D)、(E) はさらに節約した二つの対照で、行平均だけ、または列平均だけを保存する。行平均はベースラインとほぼ同じだが、列平均はまったく駄目になる。著者らの説明では、このモデルは単語埋め込みと出力 softmax で同じ重み行列を共有していて、各行が一つのトークンに対応する。高頻度トークンの行の勾配は低頻度トークンよりはるかに大きいので、列平均だけを保存すると、すべてのトークンが同じスケールに混ぜ合わされてしまう。
厄介なのは右の列だ。ウォームアップなしでは、モーメンタムのある (B) はまだ 23.1 あるのに、モーメンタムを外した (A) は 0.1 まで落ちる。
古くなった二次モーメント
著者らは に問題があると疑った。 が小さいと二次モーメントは速く減衰し、それが収束の問題を引き起こすことは Reddi らがすでに指摘している。 が大きいと推定値はずっと前の勾配から来ていて、モデルが速く変化しているときには追いつけない。
どちらの状況も観察できる。 ではウォームアップありで 25.6、なしで 0.1。 では 18.4 と 15.6 で、安定はしているがよく学習できていない。
「追いつけない」かどうかを確かめるため、著者らは一つの量を定義した。
は、学習率を掛ける前の更新だ。 が正確に推定されていれば、各パラメータの はどれも 1 の近くにあるはずで、行列全体の RMS も 1 に近くなる。
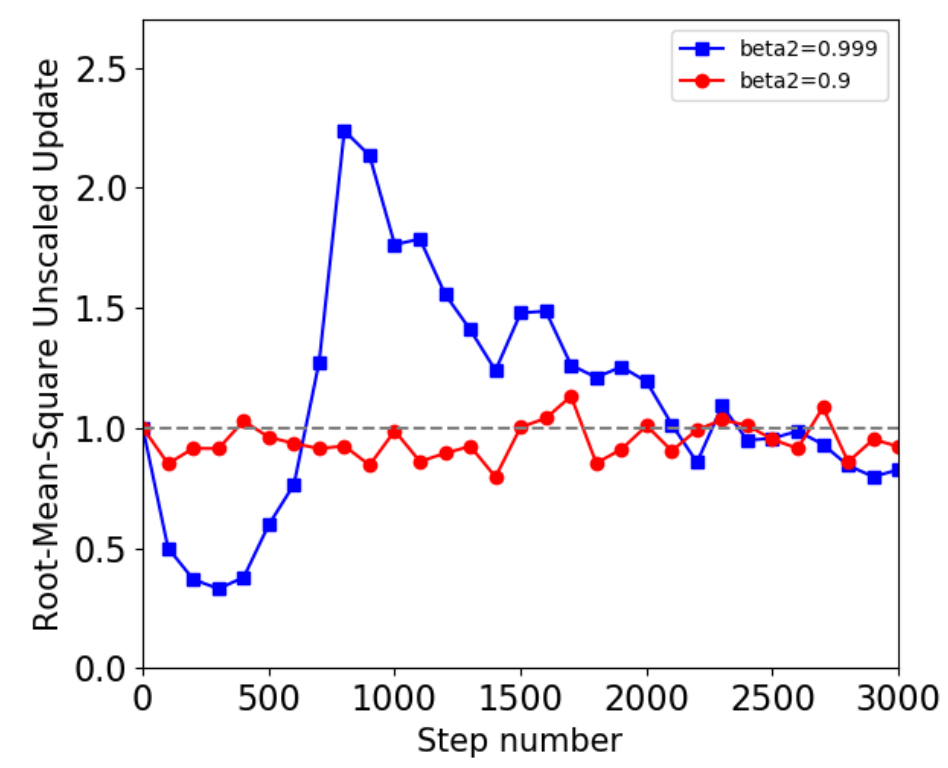
赤線は で、ずっと 1 の近くにある。青線は で、最初の 300 ステップでまず 0.33 前後まで下がり、更新が想定より小さくなる。続いて 800 ステップあたりで 2.24 まで跳ね上がり、更新は想定の 2 倍以上になる。この 2 回の学習はどちらもウォームアップありで、最後まで発散していないので、「学習が崩れたせいで更新が大きくなった」という順序ではない。著者らは大きすぎる更新が不安定を引き起こしていると考えているが、この図は裏づけであって、まだ証明ではないとも率直に認めている。
Update clipping
更新が大きすぎるのが問題なら、更新を直接制限すればいい。
RMS がしきい値 を超えたら、行列全体の更新を同じ比率で まで縮める。これはよくある勾配クリッピングとは違う。勾配クリッピングが制限するのは勾配だが、Adam のような手法はさらにパラメータごとに で割るので、 が古くなっていると、クリッピングした勾配でもやはり大きな更新に拡大されうる。update clipping は、最後に実際に使われるその一歩を直接制限する。
なら、ウォームアップなしの 0.1 が 21.5 まで持ち直す。 ではしきい値が緩すぎて、やはり 0.2 にとどまる。ウォームアップありでは、クリッピングの有無ではっきりした差は出ない。
をステップ数とともに上げる
もう一つの道は、 を最初は小さく、後で大きくすることだ。著者らはまず、Adam のバイアス補正そのものが、増加していく と等価であることを指摘した。
これは で 0 になり、その後だんだん に近づく。著者らは別のスケジュールを提案した。
論文が採用した を例にとると、10 ステップ目で 0.84、100 ステップ目で 0.975、1,000 ステップ目で 0.996、およそ 5,600 ステップ目で 0.999 を超え、10,000 ステップ目で 0.9994 になる。学習初期は速い減衰のようにふるまって安定し、後期は遅い減衰のようにふるまって推定がより正確になる。
このスケジュールにはさらに二つの利点がある。 なので、過去のすべての勾配の重みの合計がちょうど 1 になり、バイアス補正が要らない。また著者らは無限積の収束条件を使って、 のときに限り、古い勾配の一つ一つの重みが最終的に 0 に近づくことを証明した。 だと の上昇が速すぎて、初期の勾配がいつまでも無視できない比重で残る。 はちょうど、すべての 2 乗勾配の算術平均になる。
| 設定 | ウォームアップあり | ウォームアップなし |
|---|---|---|
| (G) | 18.4 | 15.6 |
| (H) 、クリッピング | 25.4 | 21.5 |
| (I) 、クリッピング | 25.7 | 0.2 |
| (J) 分解、、クリッピング | 25.6 | 22.4 |
| (K) | 25.6 | 21.1 |
| (L) | 25.6 | 0.1 |
| (N) 、クリッピング | 25.9 | 22.4 |
原論文 Table 2 をもとに整理。すべて 。
は単独でもウォームアップなしの条件を持ちこたえた。 は単独ではまだ足りず、クリッピングと組み合わせる必要がある。(N) はウォームアップありで表全体の最高となる 25.9 を出し、(J) は二次モーメントの分解にクリッピングを加えても、モーメンタムつきの Adam とほぼ同じ安定性が得られることを示している。
相対ステップサイズ
最後の部品はメモリとは関係ない。Adam の学習率は絶対的なステップサイズだが、著者らはパラメータの相対的な変化のほうが重要だと考え、ステップサイズにパラメータ自身の大きさを掛けることにした。
はそのパラメータ行列の現在の二乗平均平方根で、 は下限だ。これで 0 に初期化されたパラメータも原点から離れられる。論文の謝辞では、Geoffrey Hinton の見解に特に触れている。1 回の更新の大きさがパラメータの大きさのおよそ から 倍のとき、学習はとても順調に進むというものだ。
著者らは単語埋め込みの 3 通りの初期化でテストした(50,000 ステップ、バッチ 16,384 トークン、単語埋め込みは softmax と共有しない)。元の Transformer のやり方は、標準偏差 で初期化し、計算時に を掛けるというもので、こうすると同じ絶対学習率が単語埋め込みにもほかの重みにも適切になる。結果は Adam 26.4、Adafactor 26.6。より素朴な初期化に替えると Adam は 25.8 と 24.2 に落ちるが、Adafactor は 26.4 と 25.4 を保った。パラメータのスケールがうまく設定されていないときは、相対ステップサイズのほうが影響を受けにくい。
組み上げる
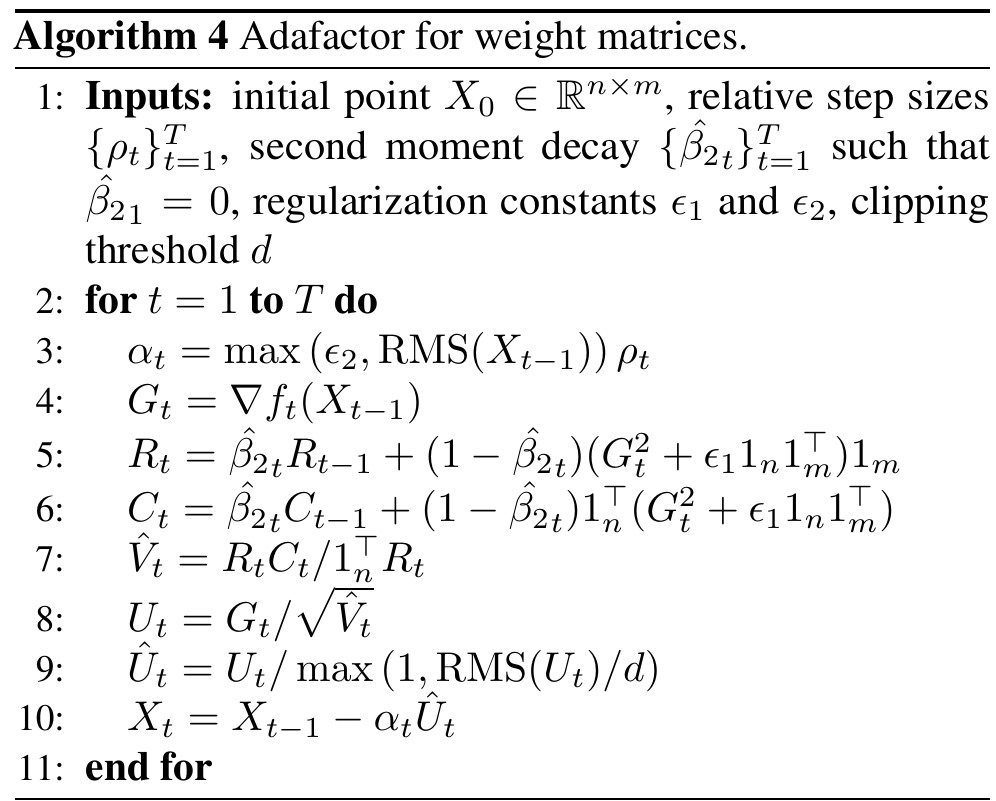
五つの部品をつなげると Algorithm 4 になる。3 行目が相対ステップサイズ、5、6 行目が を加えた行和と列和の平均、7 行目で二次モーメントを復元し、9 行目が update clipping だ。論文が推奨するハイパーパラメータは 、、、、 で、モーメンタムはない。オプティマイザ全体で、 の行列一つに対して余分に保存するのは 個の数だけだ。
議論
完全版の成績
| 設定 | ウォームアップあり | ウォームアップなし |
|---|---|---|
| (A) Adam、 | 25.6 | 0.1 |
| (B) Adam、 | 25.4 | 23.1 |
| (O) Adafactor | 25.0 | 25.5 |
| (P) Adafactor にモーメンタムを戻す | 24.9 | 25.3 |
| (Q) SGD、最良の学習率 | 24.3 | 9.1 |
原論文 Table 2 をもとに整理。(O)、(P) は相対ステップサイズ を使用。(Q) はウォームアップありで 、なしで を使い、それより大きい学習率はウォームアップなしですべて発散した。
完全な Adafactor はウォームアップなしで表全体の最高となる 25.5 を出し、ウォームアップありでは 25.0 で、モーメンタムなしの (A) より 0.6、モーメンタムありの (B) より 0.4 低い。著者ら自身も、相対ステップサイズを使う設定のステップサイズはほかの行と直接比べられないので、安定性が相対ステップサイズによるものかどうかは断定できないと述べている。SGD も余分なメモリを使わないが、最良でも 24.3 で、しかも学習率にとても敏感だ。
これらの結果は、一つの翻訳タスク、一種類のモデル、10 万ステップ、元の設定より 8 倍小さいバッチから得られたものだけだ。論文は最後に、節約したメモリで「はるかに大きなモデルを学習できるはずだ」と述べているが、大規模モデルの実験は一つもなく、メモリや速度の実測もない。
その後の Adafactor
本当の大規模テストは、ほかの人たちが行った。
T5 は Adafactor をそのまま採用し、事前学習の学習率は「最初の 1 万ステップは 0.01 で固定し、その後は平方根の逆数で減衰」させた。これは実はこの論文の そのものだ。T5 が公開した学習設定ファイルも、論文の 、update clipping のしきい値 1.0、二次モーメントの分解、パラメータスケーリングを踏襲している。
DeepMind は Gopher の学習で別の方向を試した。14 億パラメータでは Adafactor は安定して使いやすかったが、71 億パラメータになると小さな損失の発散が出始めた。Adam の最大学習率は だったが、Adafactor は まで下げてもまだ不安定だった。それでも彼らは、最終的に Gopher の微調整には Adafactor を使った。ハードウェアの要件がずっと低いからだ。
Google は 20 億パラメータの ViT-G を学習したとき、Adafactor は「そのままでは使えない」として、3 か所を変えた。半精度の一次モーメントを戻し、重みノルムに対するステップサイズのスケーリングを無効にし、 の上限を 0.999 で打ち切ったのだ。変更後は Adam と同等か、わずかに良かった。
PaLM のやり方はもっと直接的だ。論文は「分解しない」Adafactor を使ったと明記していて、効果はパラメータスケーリングつきの Adam に近い。モーメンタムは 、二次モーメントは を使い、学習率は最初の 1 万ステップが 、その後 で減衰させる。彼らは、この のスケジュールは固定の 0.99 より安定すると特に説明している。まれなトークンの単語埋め込みは、短い時間窓では二次モーメントを正確に推定できないからだ。
update clipping も単独で持ち出された。Wortsman らは 2023 年、大規模な CLIP の学習で起きる loss spike が、必ず二次モーメントが 2 乗勾配を過小評価した 1〜8 ステップ後に現れることを見つけ、StableAdamW を提案した。つまり「Adafactor の update clipping を加えた AdamW」だ。彼らはまた、大規模学習では元の形の Adafactor はもうあまり使われておらず、その理由は二次モーメントの分解かモーメンタムがないことだろうと推測している。
パッケージの側では、Hugging Face Transformers にはかなり早くから Adafactor があり、PyTorch は 2.5 版でようやく torch.optim.Adafactor を加えた。どちらもデフォルトでは相対ステップサイズを使う(Hugging Face ではオフにできる)。PyTorch の版は lr を の上限として扱い、 の位置を意図的に論文からずらしたと説明している。
結論
Adafactor は行和と列和によるランク 1 分解で二次モーメントを から に圧縮し、さらにモーメンタムを取り除いた。取り除いたあとの不安定さについては、著者らは原因を古くなった二次モーメントにまでたどり、update clipping と の スケジュールで片づけた。これらは一つの翻訳タスクで成り立ち、その後 T5 の規模でも持ちこたえた。数十億パラメータの規模になると、Gopher は不安定だと報告し、PaLM と ViT-G はモーメンタムを戻した。
Hugging Face で Adafactor を使いつつ学習率を自分で制御したいなら、relative_step=False と scale_parameter=False を忘れずに設定すること。そうしないと、オプティマイザは組み込みの に切り替えるか、こちらの学習率にさらにパラメータの RMS を掛けてしまい、書いておいた学習率スケジュールがそのとおりには効かなくなる。
PaLM が使った Adafactor は、最後には factor まで取り除いていた。