原論文
On the Convergence of Adam and Beyond
- 発表先
- ICLR 2018国際会議
- arXiv への初回投稿
- arXiv:1904.09237
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersamsgrad2019,
  title = {{On the Convergence of Adam and Beyond}},
  author = {Sashank J. Reddi and Satyen Kale and Sanjiv Kumar},
  year = {2019},
  eprint = {1904.09237},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1904.09237}
}
まず小さなゲームをしよう。
パラメータ は から のあいだにしかいられない。3 ステップを 1 ラウンドとし、1 ステップ目の損失は 、2 ステップ目と 3 ステップ目の損失はどちらも だ。1 ラウンドの合計は なので、 は小さいほど良く、答えは になる。
勾配は簡単に計算できて、1 ステップ目が 、あとの 2 ステップが だ。SGD は 1 ラウンドごとに負の方向へ正味 1 ステップ分進み、最後は に止まる。
Adam は 、区間全体で最悪の点に止まる。
この例は Google の Sashank Reddi、Satyen Kale、Sanjiv Kumar によるものだ。彼らはこれを使って Adam の元論文の収束定理が間違っていることを証明し、さらに誤りの箇所から、一行だけを変えた修正版 AMSGrad を導いた。
問題の定義
Adam が主張した収束
Adam の論文は、オンライン凸最適化の枠組みで収束を分析している。各ステップで、アルゴリズムはまずパラメータ を選び、そのあとでこのステップの凸損失関数 を見る。評価基準はリグレット(regret)、つまり累積損失が「後から見て最良の固定パラメータ」よりどれだけ多いかだ。
平均リグレット が 0 に近づけば、平均的にはアルゴリズムが最良の固定解に追いついたことになる。Adam の論文の Theorem 4.1 は、勾配が有界、、学習率 などの条件のもとで、Adam のリグレットは で、平均リグレットは 0 に近づくと主張した。
冒頭のゲームは、まさにオンライン凸最適化だ。どの も線形関数で、実行可能領域は 。Adam は に止まり、1 ラウンドごとに より一定の損失を余計に払うので、平均リグレットはいつまでも 0 に近づかない。
実効学習率は大きくなりうるか
Reddi らは、問題をある量に絞り込んだ。各種の適応的手法を同じ枠組みで書くと、各ステップの更新は で、 が各パラメータの実際の学習率になる。その逆数が時間とともにどう変わるかを見る。
SGD の は固定で、 は減っていく。AdaGrad の は過去の勾配の二乗の平均で、 と組み合わせると、分母は実質的に勾配の二乗和になり、増える一方だ。どちらも が負になることはなく、学習率は小さくなるだけだ。
Adam と RMSProp が使うのは指数移動平均だ。直近の勾配が小さくなると もそれにつれて小さくなり、学習率はかえって大きくなる。 は負になりうる。
論文の冒頭では、実際に見られる状況を説明している。出力空間がとても大きい問題では、一部のミニバッチがとても大きく情報量の多い勾配をもたらすが、それはめったに現れない。指数移動平均のせいでその影響はすぐに消え、訓練はうまく収束しない。この論文がやろうとしているのは、この直感を証明できる反例にすることだ。
問題の解決
反例:3 ステップに一度の大きな勾配
論文の Theorem 1 は、冒頭のゲームを一般化したものだ。損失関数は順に
1 ラウンドの勾配の合計は で、最適解は だ。Adam の設定は 、、 で、さらに 。このパラメータは、Adam の論文が要求する を満たしている。論文の付録は帰納法で、 から出発すると、毎ラウンドの終わりに が必ず に戻ることを証明している。
なぜだろうか? をとると になるので、1 ラウンドを直接計算してみよう。 は数ラウンドで一定の周期に入り、下の表はその周期の 1 ラウンドだ。表の最後の 2 列は で、正の値は を の方へ押し、負の値は の方へ押すことを表す。実際の更新量にはさらに が掛かるが、同じラウンドの 3 ステップの はほぼ同じなので、ここでは無視する。
| ステップ | Adam | AMSGrad | ||
|---|---|---|---|---|
| 1 | 8.21 | |||
| 2 | 1.72 | |||
| 3 | 1.07 | |||
| 1 ラウンド |
本稿での試算。、、 で、Theorem 1 の設定。AMSGrad の分母は過去最大の 、つまり 8.21 を使う。
まず Adam の列を見よう。1 ステップ目の勾配は だが、 も同時にそれに押し上げられて 8.21 になり、 と、大きな勾配が 3 倍近く縮められている。論文が、大きな勾配 は「ほぼ 倍」縮められると言っているのは、このことだ。続く 2 ステップでは勾配は しかなく、 は 1 ステップごとに 1 割しか残らない速さで 1.72、1.07 まで下がり、学習率は 2 ステップのうちに 3 倍近くまで膨らむ。二つの小さな勾配は合わせて 押す。1 ラウンドを終えると、正味では間違った方向に 進んでいる。
これが の具体的な姿だ。大きな勾配がもたらした教訓は、2 ステップ後にはほとんど忘れられている。
この設定で として実際に 30 万ステップ反復すると、Adam は に止まり、平均リグレットは 、ちょうど論文が示す下界 になる。同じ条件で AMSGrad は まで進む。
論文はさらにいくつか補足している。この例は固定の歩幅 でも同様に成り立つ。分母に を足しても救えず、付録の Theorem 6 は、任意の に対して同様の反例を作れることを示している。SGD と AdaGrad は、同じ問題で平均リグレットがどちらも 0 に近づく。
実際に使う に変えると
はあまりに作為的で、実際には はどれも 1 に近い。論文は続けて、より強い結果を二つ証明している。
Theorem 2 は、 であれば(実際の設定はほぼすべて満たす)、Adam の平均リグレットが 0 に近づかないオンライン凸問題が存在すると述べる。構成の仕方は同じで、周期を 3 から に延ばすだけだ。 ステップに一度勾配 が現れ、残りはすべて になる。 は十分大きく、 の記憶が 1 周期もたないほど大きくなければならない。
十分大きいとは、どれくらいか? 付録には三つの条件が挙げられていて、その一つが だ。数字を代入して計算すると、 では は少なくとも 3,218(付録 B は が偶数であることも求めている。この不等式だけなら 3,217)、 では少なくとも 42,622 になる。つまり 4 万ステップあまりに一度、普段より 4 万倍以上大きい勾配が現れるということだ。
Theorem 3 は舞台を確率的最適化に移す。各ステップで独立にサンプリングし、確率 で を、それ以外は を見る。損失の期待値は で、最適解はやはり だ。しかし が十分大きいと、Adam の各ステップの移動量の期待値は正になり、パラメータは最適解から遠ざかる方向へ漂っていく。
著者らの結論は、こうした振る舞いを避けたければ、、、 をすべて問題に応じて決める必要がある、というものだ。高次元の問題では次元ごとに一組ずつ必要になることさえあり、これはハイパーパラメータの調整がいらないという適応的手法の本来の趣旨に反する。彼らは例が意図的に構成されたものであることも認めているが、実際の状況でも似た現象が少なくとも収束を遅らせるだろうと考えている。
証明はどこで間違えたか
反例があるなら、Adam の元の証明のどこかの段階が成り立っていないはずだ。論文は第 4 節と付録 D で、Adam の証明は が半正定値、つまり学習率が大きくならないと仮定しており、この仮定は Adam では成り立たないと指摘している。さらに、Adam の証明の補題 10.3 と 10.4 にも問題がある。
SGD と AdaGrad の学習率はもともと単調非増加なので、この問題にはぶつからない。この観察が、そのまま修正の方法を指し示している。
AMSGrad
問題が が小さくなることにあるなら、分母に過去の最大値を覚えさせればよい。
Adam との違いは 3 行目だけだ。 はこれまでどおり指数移動平均で更新するので、勾配のスケールの推定は直近の一定期間だけを見る。しかし実際に分母として使う は増える一方なので、学習率 は単調非増加になり、 が半正定値であることが保証される。追加のコストは、パラメータと同じ大きさのベクトル 1 本だけだ。
上の表の AMSGrad の列に戻ろう。分母はずっと 8.21 のままで、二つの はそれぞれ しか押さず、1 ラウンドの正味の効果は、正しい方向に 進むことになる。
著者らは AMSGrad を、ある状況で Adam、AdaGrad と比べている。あるステップで 、つまりこのステップの勾配が直近の平均より小さいとする。
- Adam は積極的に学習率を大きくする。前の反例は、まさにこの点に足をすくわれた。
- AdaGrad は学習率を少し小さくする。長期的に積み重なると、学習率はほとんど動かないほど小さくなりかねない。
- AMSGrad は大きくも小さくもしない。
AMSGrad の収束保証(Theorem 4)は、Adam の論文の分析の枠組みを引き継ぎ、上の問題を修正したものだ。条件は 、、、そして実行可能領域の直径と勾配が有界であることで、リグレットの上界には が一つ加わる。論文によれば、、あるいはより穏やかな をとれば、どちらでも のリグレットが保証される。
注意すべき細部が二つある。証明には が時間とともに減ることが必要だが、著者らも、実際にはふつう を固定すると明記している。また、論文の Adam はバイアス補正を外している。脚注によれば簡単のためで、反例の議論は補正ありの版にも同様に当てはまる。AMSGrad の Algorithm 2 にもバイアス補正はない。
論文はもう一つの道として AdamNC も示している。構造は変えず、 を時間とともに大きくするものだ。 とすると、 はちょうど過去のすべての勾配の二乗の平均になり、モーメンタム付きの AdaGrad と同じになる。
議論
合成実験
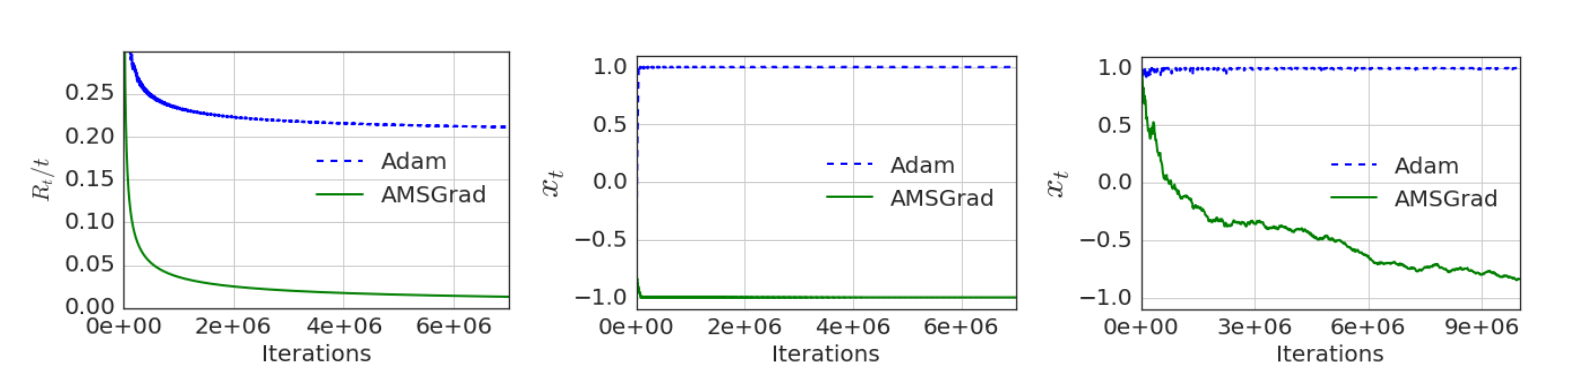
実験に使ったのは、反例を拡大した版だ。101 ステップに一度損失 が現れ、残りの 100 ステップは で、1 周期の勾配の合計は 、最適解はやはり だ。今回は一般的な 、 を使い、二つの手法のパラメータは同じにしている。
左図は平均リグレットだ。Adam の青い破線は 0.21 付近で平らになり、もう下がらない。AMSGrad の緑線は 0 近くまで下がる。中央の図はパラメータそのもので、Adam は に、AMSGrad は に止まる。
右図は確率的な版で、各ステップで 1% の確率で を、それ以外は を見る。Adam はやはり に止まる。AMSGrad はとてもゆっくり下がっていき、1,000 万ステップでおよそ と、まだ には届いていない。
実データ
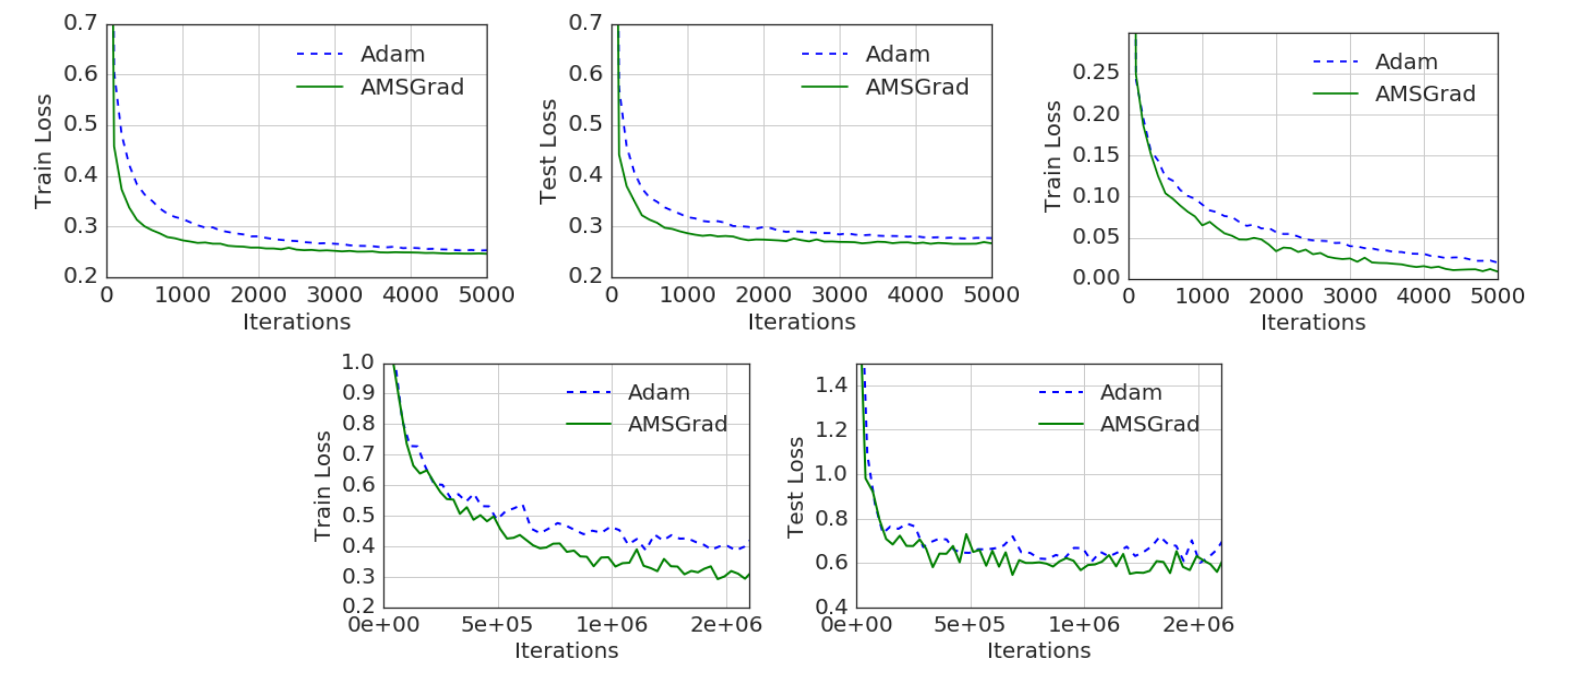
実データの実験は三組あり、バッチサイズはどれも 128、、 は から選ぶ。
- MNIST のロジスティック回帰(上段の左と中央)。凸問題で、学習率は理論どおり で減衰させ、 と はグリッドサーチで決める。AMSGrad は訓練損失もテスト損失もわずかに低く、著者らは、パラメータの変動にも比較的鈍感だと述べている。
- MNIST の隠れ層 1 層のネットワーク(上段の右)。ReLU 100 個で、学習率は固定。AMSGrad の訓練損失はずっと Adam よりわずかに低い。
- CIFAR-10 の CIFARNET(下段)。64 チャネル、 の畳み込み 2 層に、384 と 192 の全結合層が続き、あいだに最大プーリング、局所応答正規化、dropout が入る。差が最もはっきり出るのは訓練損失で、およそ 0.3 対 0.4。テスト損失は両者とも 0.6 付近で、AMSGrad がわずかに低い。
この結果を読むときは、その範囲を知っておく必要がある。図には損失しかなく、正解率はない(本文では AMSGrad の正解率も良いと言っているが、数字は示していない)。どの曲線も 1 回の実行に見え、誤差の幅はない。モデルもどれも小さい。著者ら自身、貢献のリストでこれを予備的な実験と呼んでいる。
実務での反応
AMSGrad はすぐに主要なフレームワークに取り込まれ、PyTorch と Keras の Adam にはどちらも amsgrad 引数がある。デフォルトはオフだ。
実際に試した人たちの反応は、あまり熱のこもったものではなかった。fast.ai の Sylvain Gugger と Jeremy Howard は 2018 年 7 月の記事で、CIFAR-10 の Wide ResNet、Stanford Cars での ResNet-50 の微調整、WikiText-2 での AWD-LSTM と QRNN の言語モデルで比べ、amsgrad は正解率でもほかの指標でも一度も良い結果をもたらさなかったと書き、「非常に期待外れ」だったと評している。
AMSGrad 自身の証明も、のちに問題を指摘された。Phuong と Phong は 2019 年、その証明が と を扱う際に両者を等しいものとみなしていると指摘した。Adam の元の証明にも同じ見落としがある。彼らは新しい証明を示し、別の変種 AdamX も提案した。
Adam は実は収束する?
反例は成り立つ。そして Adam は実際に使いやすい。この二つをどう両立させればよいのか? 後続のいくつかの研究が出した答えは、先に何を固定したかによって違う。
| 研究 | 先に固定するもの | 結論 |
|---|---|---|
| Reddi ら 2018 | 先に を選び、次に問題を作る | Adam は収束しないことがある |
| Zhang ら 2022 | 先に問題を与え、次に を選ぶ | が十分大きければ収束する |
| ADOPT 2024 | アルゴリズムを変える | どんな でも収束する |
Zhang ら 2022 は、順序の問題を指摘した。Reddi らは先に を選び、それに合わせて悪い問題を構成している。前に計算したとおり、 には 4 万ステップあまりの周期が必要だ。ところが実際には、問題が先にあって、私たちはそれからハイパーパラメータを調整する。彼らは、固定した問題に対して、 が十分大きく(しきい値は問題による)、かつ であれば、更新則を一切変えない Adam が臨界点の近くに収束し、その範囲の大きさは確率的勾配の分散に比例することを証明した。より強い条件のもとでは、臨界点そのものに収束する。この分析は非凸の有限和問題を対象とし、エポックごとにサンプルの順序をランダムに並べ替えるもので、勾配が有界という仮定を必要とせず、デフォルトの もカバーしている。逆に、 が小さすぎると、発散する の領域が広く存在する。
同じ時期、Défossez らは、滑らかな非凸で勾配が有界という条件のもとで簡潔な収束証明を示し、デフォルトのパラメータの Adam は厳密には収束せず、振る舞いは固定歩幅の SGD に近いことも指摘した。
ADOPT 2024 は、AMSGrad を見直した。非凸問題での AMSGrad の収束証明は、どれも確率的勾配が一様有界だと仮定しているが、変分オートエンコーダや拡散モデルのように勾配にガウスノイズを注入するモデルは、この条件を満たさない。問題は最大値を取るステップにあり、期待値の制御が難しい。ADOPT は別のやり方をとる。一つ前のステップの でこのステップの勾配を正規化して、分母に現在の勾配が含まれないようにし、さらに先に正規化してからモーメンタムを蓄積する。勾配の二次モーメントが有限という条件のもとで、任意の に対して の収束レートを達成する。
最後に、脚注をもう一つ。2026 年 7 月のプレプリント〈On the Convergence of Adam, Revisited〉は、Reddi らと同じオンライン設定で、 という条件すら必要なく、任意の に対して Adam の平均リグレットが 0 にならない例を見つけられると主張している。使っているのはやはり傾き の 3 ステップの周期で、しかも AdamW や Muon などの変種にも一般化できるという。これは Zhang らの肯定的な結果と矛盾しない。両者は、順序の異なる問いに答えている。
結論
この論文は、3 ステップで 1 ラウンドの線形関数を使って Adam の元の収束定理が誤っていることを証明し、問題が、指数移動平均によって学習率が大きくなりうる点にあると突き止めた。AMSGrad は過去の最大値を分母に使って学習率を単調非増加にし、凸問題での収束保証を取り戻した。実データでの改善はわずかで、実験も予備的な段階にとどまり、のちの独立したテストの多くでは利点が見られなかった。この論文がのちの研究に残したのは、 という分析の視点と、「どちらを先に固定するか」という問いだ。
実務では、amsgrad=True はただのスイッチだ。データにまれだが重要な大きい勾配があると疑われるときは、 を大きくすることと並べて、比較の候補に入れるとよい。前者の追加コストはパラメータと同じ大きさの状態 1 本分だけで、後者はコストがまったく増えない。Zhang らは、 が小さすぎると発散する領域が広く存在することを証明した。この結果に従うなら、反応を速くしようとして を下げ、訓練が不安定になったときは、まず 1 に近い値に戻してみることだ。
3 ステップで 1 ラウンドの小さなゲームは、その後も引退していない。8 年後もやはり同じ で、今回は すら仮定せず、ついでに AdamW と Muon まで巻き込んだ。