原論文
Adam: A Method for Stochastic Optimization
- 発表先
- ICLR 2015国際会議
- arXiv への初回投稿
- arXiv:1412.6980
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersadam2014,
  title = {{Adam: A Method for Stochastic Optimization}},
  author = {Diederik P. Kingma and Jimmy Ba},
  year = {2014},
  eprint = {1412.6980},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1412.6980}
}
この論文の 1 ページ目の脚注には、2 人の著者の貢献は等しく、著者の順番は Google Hangout 上でコインを投げて決めたと書かれている。
コインを投げた結果、Diederik Kingma が前、Jimmy Ba が後ろになり、論文は 2014 年 12 月に arXiv に公開された。Algorithm 1 の説明文には「Good default settings for the tested machine learning problems」という一文があり、そのあとに四つの数字が続く。、、、 だ。
10 年後に PyTorch を開いても、torch.optim.Adam のデフォルト値はこの四つの数字のままだ。
このノートでは、Algorithm 1 を一行ずつ分解して見ていく。二つの移動平均はそれぞれ何を推定しているのか? なぜ で割るのか? 一歩でいったいどこまで進むのか? 論文の実験は何を示し、どの部分がのちに覆されたのか?
問題の定義
ニューラルネットワークを訓練するとき、手元にあるのはミニバッチで計算した勾配だけで、どのステップにもノイズが乗っている。dropout のような正則化は、さらにもう一層のランダム性を加える。パラメータはたやすく数百万を超え、二次の手法は高くつきすぎるので、論文は最初から対象を一次の手法に限っている。
最も基本的な SGD は、すべてのパラメータに同じ学習率を使う。ところが、パラメータごとの勾配の大きさは何桁も違うことがあり、同じ学習率では、あるパラメータには大きすぎ、別のパラメータには小さすぎる。
当時、この問題にはすでに二つの道があった。
- AdaGrad はパラメータごとに過去の勾配の二乗和を記録し、その平方根で勾配を割る。。めったに現れない特徴量は勾配の二乗和が小さいので歩幅が大きくなり、スパースなデータで特に効く。その代わり、和は増える一方なので、学習率はどんどん小さくなっていく。
- RMSProp は和を指数移動平均に置き換え、直近の一定期間の勾配だけを見る。学習率が小さくなり続けることはなく、目的関数が時間とともに変わる状況にも比較的対応しやすい。
Adam は両方の長所を取りたかった。論文の第 5 節はさらに、RMSProp にはバイアス補正がないことを指摘している。 が 1 に近いと(スパースな勾配にはまさにこの設定が必要だ)、補正のない RMSProp は最初の歩幅が非常に大きくなり、そのまま発散することも多い。
つまりこの論文が答えようとしているのは、一次の勾配だけを使い、追加のメモリはパラメータと同じ大きさのもの 2 つ分だけで、スパースな勾配と変化する目的関数の両方に対応でき、しかも訓練の最初から安定して進めるオプティマイザを作れるか、という問いだ。
問題の解決
Algorithm 1
まずアルゴリズム全体を書き出す。演算はすべて要素ごとで、 は 、 は の 乗を表す。
最初は 、 で、各ラウンドでまず を 1 増やす。
は勾配の指数移動平均で、論文では一次モーメントの推定、つまり勾配の平均と呼んでいる。 は勾配の二乗の指数移動平均で、二次モーメント(平均を引かない分散)の推定だ。Adam という名前は adaptive moment estimation から取られている(謝辞によると、考えたのは Ivo Danihelka と Tom Schaul だ)。
更新量は だ。分子が方向を決め、移動平均なのでモーメンタムの効果も持つ。分母はパラメータごとに固有のスケールを換算する。これは各パラメータが自分の学習率 を持つのと同じで、ただしこの学習率は毎ステップ、直近の勾配から推定し直される。
論文には、二つの補正を一つの係数にまとめた、計算を節約する書き方も載っている。
二つの書き方の違いは を足す位置だけで、ここでの は Algorithm 1 の とは別の量だ。この小さな違いはのちに各フレームワークに残っていて、議論の節でまた取り上げる。
バイアス補正
真ん中の二行の割り算が、この論文と RMSProp の最大の違いであり、第 3 節がまるごと導出に充てているところでもある。
の漸化式を展開すると、過去のすべての勾配の二乗の重み付き和になる。
両辺の期待値を取る。勾配の二乗の期待値が時間によって変わらないと仮定すれば、 を外に出せて、残りは等比級数になる。
二次モーメントが本当に時間によって変わらないなら だ。変わる場合でも、 によって古い勾配の重みが十分小さくなっていれば、 はそれほど大きくならない。残る は、すべて から走り出したことによるもので、これで割れば推定値は正しいスケールに戻る。 の導出もまったく同じだ。
デフォルト値で最初の一歩を計算してみよう。 のとき、
- で、真の値の 10 分の 1 しかない。
- で、平方根を取ると 、真のスケールの 30 分の 1 程度しかない。
どちらも小さすぎるが、 のほうがずれが大きい。補正しなければ、最初の一歩の大きさは になる。補正すると 、 となり、各パラメータの最初の一歩はちょうど になる。
これが Adam の第一歩だ。勾配が でも でも、どのパラメータも だけ進む。
では補正しなければ、大きすぎる歩幅はどれくらい続くのか? 毎ステップの勾配が同じだと仮定すると、補正なしの歩幅は になる。これを図にしてみよう。
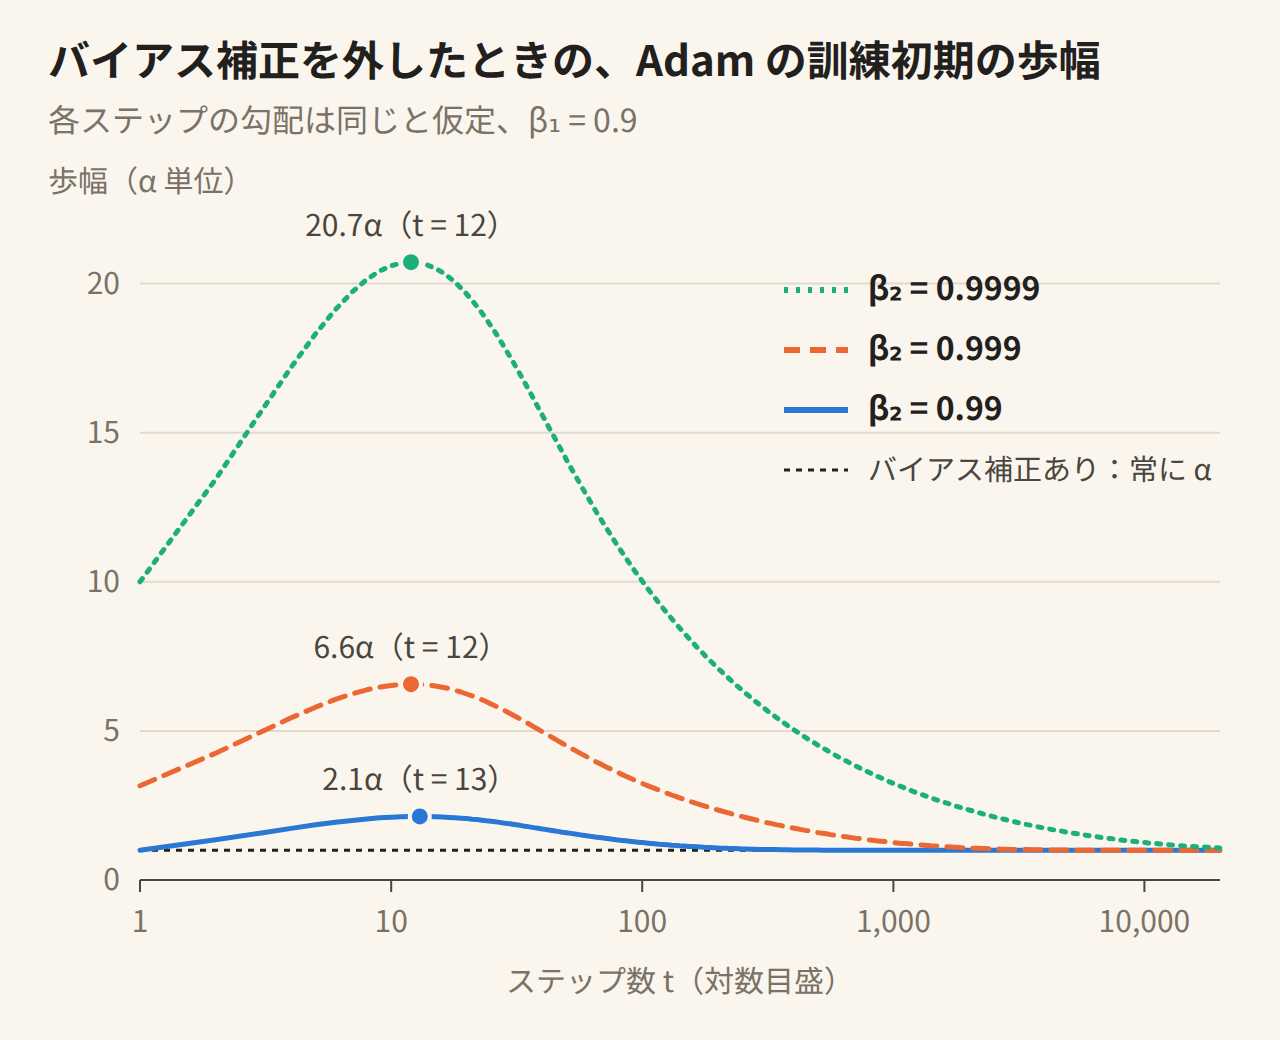
3 本の線はどれも第 12、13 ステップあたりで最大になる。このとき はすでに真の値の 7 割ほどまで溜まっているが、 は のとき約 1% しか溜まっておらず、平方根を取っても 1 割強しかない。分子は追いついたのに、分母はまだだ。 では最大 で、 以内に戻るのは 1,700 ステップあまり後。 では最大 で、1 万 7,000 ステップあまりかかる。
さらにモーメンタムを外すと()、補正なしの最初の一歩は になり、 では だ。学習率は に設定したはずなのに、最初の一歩は を使ったのと同じになる。
これがまさに論文の言う状況だ。スパースな勾配では十分な数のサンプルを平均するために大きな が必要で、 が 1 に近いほど、補正なしの初期バイアスはひどくなる。
一歩でどこまで進むか
第 2.1 節では続いて、更新量そのものを分析している。まず とすると、各ステップの実効的な歩幅は だ。
は「勾配の平均」を「勾配の二乗の平均の平方根」で割ったものだ。 なので、この比の絶対値はふつう 1 を超えず、 はおおよそ で抑えられる。
例外が一つある。あるパラメータの勾配がずっと 0 で、このステップだけ突然値を持った場合、 はおよそ 、 はおよそ になり、比は になる。そのため論文の上界は二つの場合に分かれる。
デフォルト値を代入すると、 は より大きいので、デフォルト設定は一つ目の場合に当たり、最悪で だ。これは極端にスパースなパラメータでしか起きない。論文によれば、スパースさがそこまで極端でなければ、実効的な歩幅はこれより小さくなる。
この性質から、実用上の帰結が三つ得られる。
- がそのまま歩幅になる。 これはおおよそ、各ステップでパラメータ空間を進む距離そのものだ。論文はこれを、現在のパラメータのまわりに信頼領域を描くことにたとえている。良い解が初期値からどれくらい離れているか見当がつけば、 の桁を見積もれる。
- 勾配のスケールに依存しない。 勾配を 倍すると、 は 倍、 は 倍になり、比は変わらない。損失関数を 1000 倍すると SGD の歩幅も 1000 倍になるが、Adam はまったく影響を受けない。
- 自動的なアニーリング。 論文は「SN 比」(signal-to-noise ratio)という言葉を借りて を呼んでいる。最適解に近づくと、勾配の符号がよく入れ替わり、平均は 0 に近づくが、二乗の平均は残る。比が小さくなり、歩幅もそれにつれて小さくなる。
AdaGrad、RMSProp との関係
第 5 節では、Adam をもとの系譜に戻して比較している。
RMSProp との違いは二つある。モーメンタム付きの RMSProp は、先に勾配をスケールで割り、割った結果にモーメンタムをかける。Adam は勾配の一次と二次のモーメントを別々に推定してから割る。もう一つの違いがバイアス補正だ。
AdaGrad との関係はもっと面白い。 とし、 を 0 に近づけ、学習率を に置き換えると、バイアス補正した は になり、更新式に戻すとちょうど AdaGrad になる。この対応はバイアス補正を残したときにしか成り立たない。補正を外すと、 が 1 に近づくにつれて が 0 に近づき、更新量が無限大になる。
論文はまた、 は Fisher 情報行列の対角の近似とみなせ、Adam はその平方根の逆数で前処理(preconditioning)していることになる、とも述べている。Fisher の逆行列をそのまま使う自然勾配と比べると、このやり方は少し控えめだ。
AdaMax
第 7.1 節は拡張だ。Adam は勾配の ノルムでスケーリングしているが、著者らはこれを に一般化した。
が大きいと数値的に不安定になるが、 として とおくと、重み付き和には最大の項だけが残り、とても単純な漸化式が得られる。
は「割り引かれた過去の最大勾配」だ。あるステップで が出ると は 10 になり、その後は毎ステップ 0.999 が掛かって、1,000 ステップ後でも約 3.7 が残る。 は少なくとも現在の に等しく、0 からゆっくり上がっていくことがないので、バイアス補正はいらない。歩幅の上界もより単純で、 だ。論文が勧めるデフォルト値は で、、 は Adam と同じ。
ほかに第 7.2 節では、パラメータの指数移動平均 も提案しており、同じく で初期バイアスを補正する。
収束の証明
第 4 節は、オンライン凸最適化の枠組みで Adam を分析している。各ステップで事前にはわからない凸関数 に向き合い、評価基準はリグレット(regret)、つまり累積損失が、後から見て最良の固定パラメータと比べてどれだけ多いかだ。
Theorem 4.1 には条件がたくさんある。勾配が有界であること、反復点どうしの距離が有界であること、、学習率は で減衰させ、 も で時間とともに減衰させること。これらの条件のもとで、論文は のリグレットを得ており、平均リグレット は 0 に近づく。
実際にはこの条件どおりに Adam を回すことはまずない。学習率は固定か別のスケジュールのことが多く、 も 0.9 に固定する。論文自身も第 6.2 節で、この分析はニューラルネットワークのような非凸問題には当てはまらないと認めている。
この定理はのちに誤りだと示された。2018 年、Reddi、Kale、Kumar は、付録の証明がある段階で を負にならないものとして扱っていると指摘した。この量は「実効学習率の逆数」の時間変化で、Adam の は移動平均なので、勾配が小さくなれば小さくなる。だからこの量は負になりうる。彼らは同時に補題 10.3、10.4 にも問題があると指摘し、定理の条件を満たす 1 次元の凸問題を作って、Adam がその上で最悪の点に収束することを示した。
議論
ロジスティック回帰、多層パーセプトロン、畳み込みネットワークの三組の実験は、どれもバッチサイズ 128 で、オプティマイザどうしを比べるときは同じ初期パラメータを使っている。学習率やモーメンタムなどのハイパーパラメータは密なグリッドで探索し、最良の組を報告している。論文が描いているのは損失の曲線だけで、最初の三組は訓練損失だと明記されており、テスト精度はない。図を読むときはこの点を覚えておきたい。これらの実験が比べているのは「誰が訓練損失を速く下げるか」だ。
ロジスティック回帰
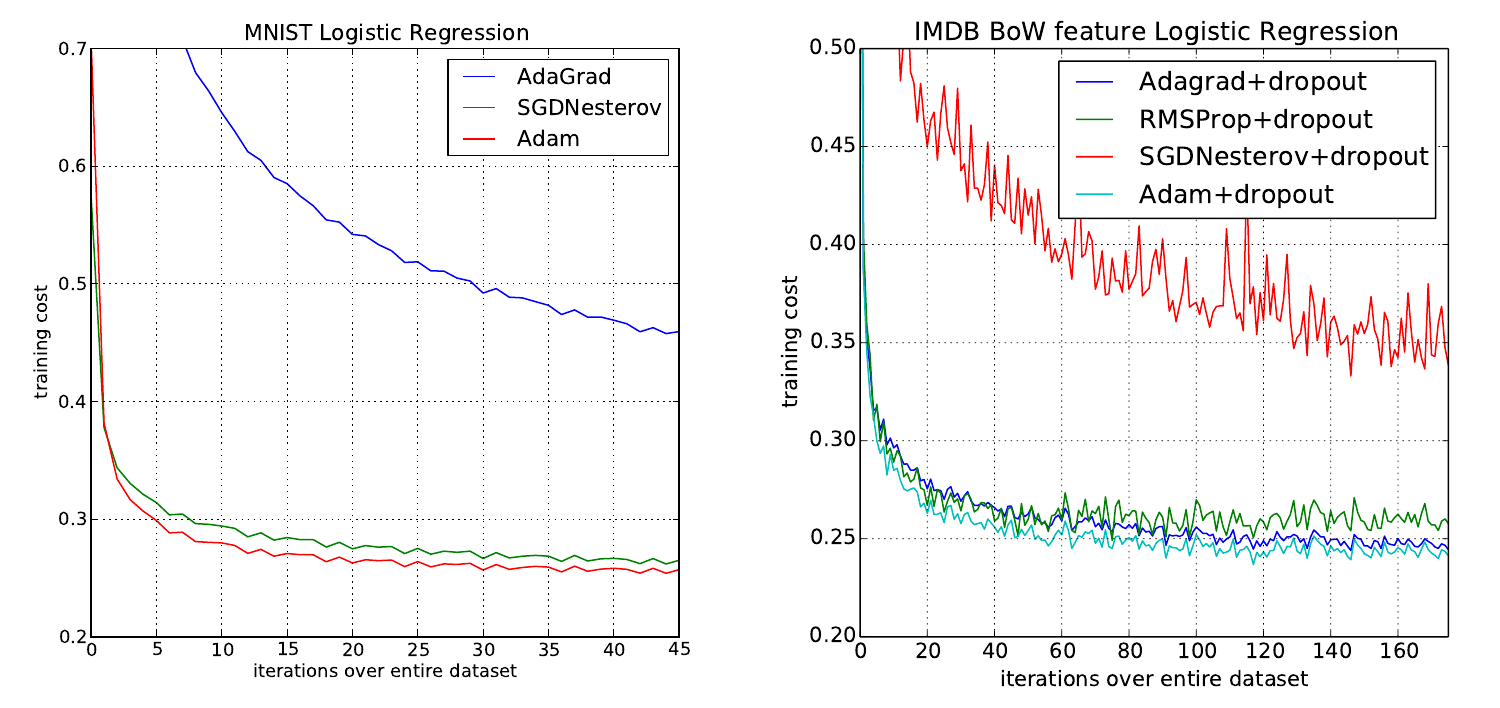
ロジスティック回帰は凸問題で、局所最小値を心配する必要がなく、オプティマイザを単純に比べるのに向いている。この実験の学習率は、第 4 節の理論どおり で減衰させている。
左は MNIST で、784 次元の画素ベクトルをそのまま分類する。Adam と SGD モーメンタムはほぼ同じで、どちらも AdaGrad よりずっと速い。
Adam が本当に示したかったのは右の図だ。著者らは IMDB の映画レビューを、頻出上位 10,000 語の bag-of-words ベクトルに変換した。各レビューはそのうちごく一部の単語しか使わないので、とてもスパースな特徴量になる。過学習を防ぐため、特徴量には 50% の dropout をかけている。ここでは AdaGrad が SGD を大きくリードし、Adam は AdaGrad と同じくらい速い。スパースな特徴量での強みを、Adam はちゃんと受け継いでいる。
多層パーセプトロン
次は、2 層でそれぞれ 1000 個の ReLU ユニットを持つ全結合ネットワークで、同じく MNIST を使う。dropout を加えた版では、Adam の訓練損失は AdaGrad、RMSProp、SGD モーメンタム、AdaDelta より低い。
dropout を加えず L2 重み減衰を使う版では、著者らは別に SFO とも比べている。SFO はミニバッチで動く準ニュートン法で、各ステップで曲率の情報を更新するため、Adam より 5 から 10 倍遅く、メモリもミニバッチの数に比例して増える。Adam は反復回数で数えても実時間で数えても SFO より速い。しかも SFO は各部分関数が決定的だと仮定しているので、dropout があると収束しない。
畳み込みネットワーク
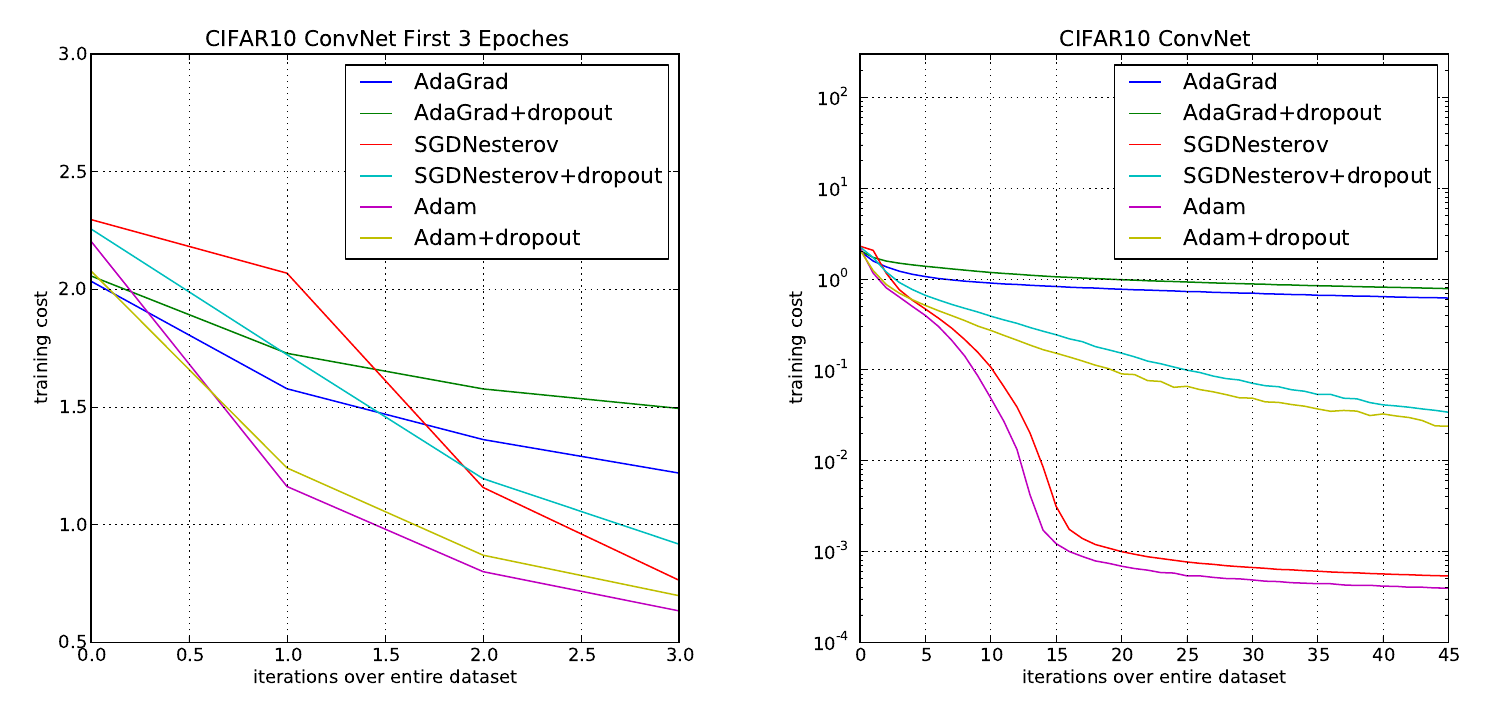
ネットワークは 畳み込みと、・ストライド 2 の最大プーリングの 3 段構成で、チャネル数は 64、64、128、最後に 1000 個の ReLU を持つ全結合層が続く。入力は事前に白色化し、入力層と全結合層に dropout をかける。
左図の最初の 3 エポックでは、Adam も AdaGrad も速く下がる。しかし右図で 45 エポックまで伸ばすと、AdaGrad はかなり早い段階で止まり、Adam と SGD モーメンタムは 未満まで下がり続ける。
この結果について、著者らの説明はとても具体的だ。彼らの観察では、数エポック訓練すると はほぼ 0 まで小さくなり、分母は に支配されて、二次モーメントはもうこの問題の幾何をうまく表せなくなる。畳み込みネットワークで主に効いているのは一次モーメントで、ミニバッチのノイズを平均して打ち消している。この説明を推し進めると、分母が に支配されているとき、Adam の振る舞いはモーメンタム付き SGD に近くなる。両者の曲線がよく似ていることとも合う。著者らは正直に、Adam は SGD モーメンタムに対して小幅な改善にとどまると書いている。利点は、層ごとに学習率のスケールを自動で調整してくれることで、畳み込み層のために小さめの学習率を手で選ぶ必要がない。
は「ゼロ除算を避けるための小さな定数」とされているが、 がそれと同じ桁まで小さくなれば、実際に更新に加わっている。
バイアス補正の実験
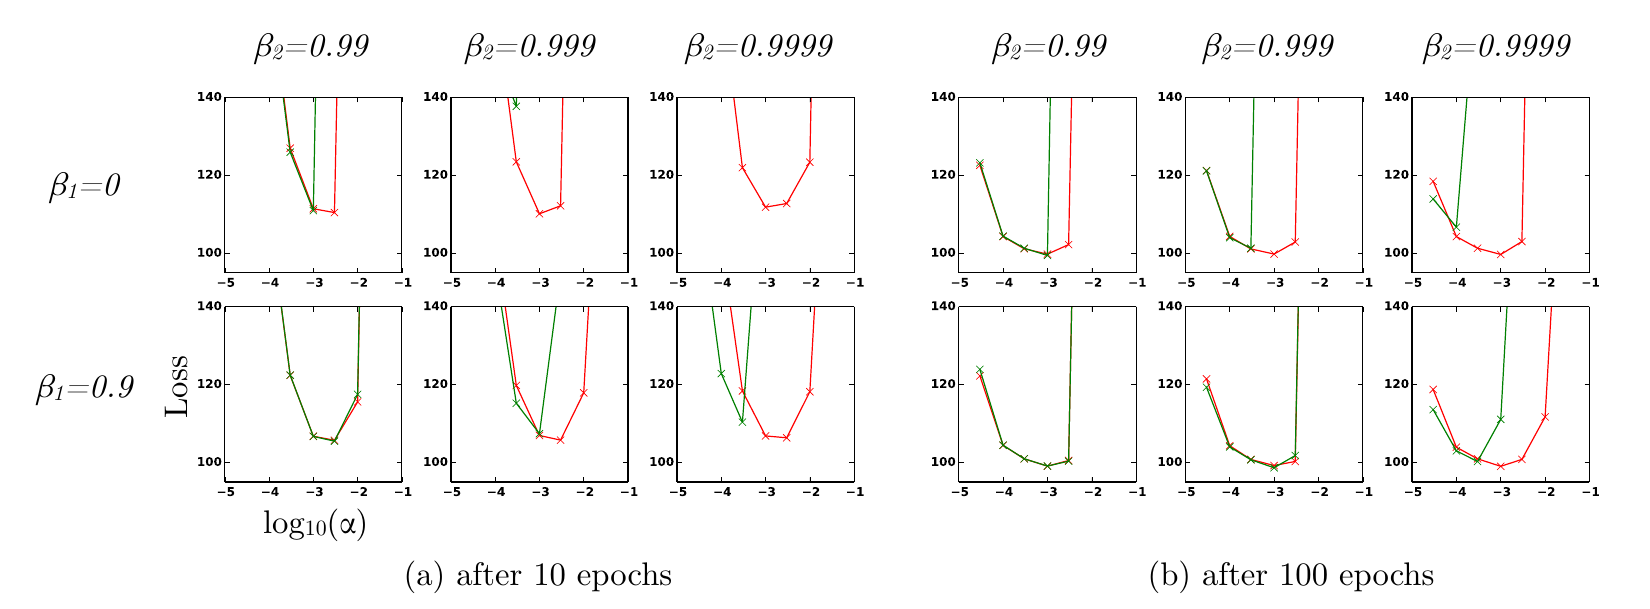
これは論文全体で、設計を最も直接に検証している図だ。著者らは変分オートエンコーダ(VAE、隠れ層 1 層、softplus ユニット 500 個、50 次元のガウス潜在変数)を訓練し、、、そして から までの を掃引した。バイアス補正を外した Adam を、論文はモーメンタム付き RMSProp の一種とみなしている。
各小図の横軸は学習率、縦軸は損失で、赤線が補正あり、緑線が補正なしだ。
- の列では、赤と緑の 2 本はおおむね重なり、 の行の緑線が最大の学習率で先に図の外へ飛び出すだけだ。この設定では、補正なしによるバイアスは 100〜200 ステップほどで消え、訓練全体への影響は小さい。
- 右に進んで の列を見ると、緑線はより大きな学習率のところで図の外に飛び出す。いちばんひどいのは左の組の 1 行目 で、 と の緑線はほぼ全体が図の外にある。この 2 マスでは、補正なしの最初の一歩がそれぞれ と になる。
- 右の組で 100 エポックまで訓練すると、6 枚すべてで赤線の最低点は 100 付近にある。 の列では赤線の最低点が にあり、同じ学習率で緑線は ではすでに図の外、 では 110 前後まで上がっている。赤線のほうが、使える学習率の範囲がずっと広い。
著者らの結論は、 が 1 に近いとき、バイアス補正がないと訓練が不安定になり、特に最初の数エポックでそうなる、というものだ。最良の結果は が小さく、しかもバイアス補正がある設定で得られた。掃引したすべてのハイパーパラメータで、Adam は RMSProp に劣らなかった。
著者らはもう一つ観察を加えている。訓練の後半には隠れユニットがそれぞれ専門化し、勾配がよりスパースになるので、大きな の利点がこの時期にいっそうはっきりする。つまり、1 に近い はもともと望ましい設定で、バイアス補正のおかげで安心してそれを使える。
をどこに足すか
前に出てきた二つの書き方の違いに戻ろう。Algorithm 1 は を補正後の に足し、計算を節約する書き方は を補正前の に足す。換算すると で、訓練の初期ほど差が大きい。
フレームワークによって選んだ書き方が違う。PyTorch は Algorithm 1 に従い、デフォルトは eps=1e-8。Keras のドキュメントは、その epsilon が論文の だと明記しており、デフォルト値は 1e-7 だ。二つのフレームワークのあいだでハイパーパラメータを移すとき、同じ epsilon という名前でも、実は別の量になっている。
どうでもよさそうに見えるこの定数は、大規模モデルの訓練では調整の対象にもなる。OLMo 2 は AdamW の を から に下げ、それによって訓練初期の勾配ノルムがより低く、より安定したと報告している。
バイアス補正が外されていた数年
第 3 節の導出は細かい話に聞こえるが、実際に後日談がある。
BERT の公式コードにあるオプティマイザ BERTAdam は、バイアス補正の二行を外していた。この書き方は、Hugging Face Transformers(2019 年 7 月にようやく標準の Adam に戻された)や AllenNLP など、よく使われるライブラリにもそのまま複製された。2020 年、Zhang らの〈Revisiting Few-sample BERT Fine-tuning〉は、BERT を小さなデータセットで微調整すると不安定になる原因を追い、まさにこれが主な原因の一つだと突き止めた。
彼らは RTE、MRPC、STS-B、CoLA の四つの小さなデータセットで、それぞれ 50 個の乱数シードで微調整した。バイアス補正がないと、多くの実行でそもそも訓練が立ち上がらなかった。RTE を例にとると、実行の 48% は正解率が 55% を下回り、当てずっぽうに近い。バイアス補正を戻すと、結果のばらつきは大きく縮まった。
理由は、前の歩幅の図と同じことだ。こうした小さなデータセットでの微調整はたいてい 1,000 ステップに満たず、全体がまだバイアスの最も大きい区間にある。訓練ステップ数の多い MNLI に変えると、補正の有無の差は誤差の範囲に収まる(検証セットの正解率で、補正なし 86.0、補正あり 85.9)。
その後の三つの問題
Adam はすぐにデフォルトのオプティマイザになった。その後の数年、Adam への疑問はおおよそ三つの線に分かれる。
- 収束。 前に触れた証明の誤り。Reddi らは 3 ステップに一度大きな勾配が現れる例を使い、 がまれな大きい勾配を「忘れて」しまうことを示して、過去の最大値を保持する AMSGrad を提案した。
- 汎化。 2017 年、Wilson らはいくつかの視覚と言語のタスクで、Adam は訓練損失を速く下げるのに、テストの成績はよく調整した SGD にしばしば負けることを見出した。
- 正則化。 Loshchilov と Hutter は、Adam で L2 正則化を勾配に書き込むことと、重み減衰を直接行うことは等価ではないと指摘し、AdamW を提案した。
結論
Adam は二つの指数移動平均で勾配の平均と二乗の平均を別々に推定し、割り算でパラメータごとの歩幅を得る。さらに で 0 から走り出したことによるバイアスを補正し、最初の一歩から のスケールに乗るようにする。論文で最も説得力のある証拠は VAE の実験で、 が 1 に近いほどバイアス補正が重要になる。ほかの実験は訓練損失しか比べておらず、畳み込みネットワークでは SGD モーメンタムとの差もわずかだ。収束定理は 3 年後に誤りを指摘された。
Adam を自分で実装するとき、あるいは他人の訓練コードを流用するときは、まずバイアス補正の二行が残っているかを確かめ、次に がバイアス補正の前に足されているか後に足されているか、値はいくつかを確かめよう。訓練ステップ数が少ないほど、この二つの細部が結果に与える影響は大きくなる。フレームワークのあいだでハイパーパラメータを移すときも、両方の epsilon が同じ量とは限らないことを覚えておきたい。
2025 年、この論文は ICLR の Test of Time Award を受賞した。収束の証明に問題があると指摘されてから、すでに 7 年が経っていた。著者の順番のほうは、今もあのコインが決めたままだ。