原始論文
Adafactor: Adaptive Learning Rates with Sublinear Memory Cost
- 發表版本
- ICML 2018會議
- arXiv 首次提交
- arXiv:1804.04235
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizersadafactor2018,
  title = {{Adafactor: Adaptive Learning Rates with Sublinear Memory Cost}},
  author = {Noam Shazeer and Mitchell Stern},
  year = {2018},
  eprint = {1804.04235},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1804.04235}
}
翻開 T5 論文的訓練設定,優化器那一行寫著「For optimization, we use AdaFactor」。之後 FLAN、Flan-T5 的微調,PaLM 的 5,400 億參數預訓練,用的也是它。
回到源頭,Adafactor 的論文只做了一個實驗任務,一個英翻德的 Transformer,每次訓練在一顆 TPU v2 上不到兩小時。Noam Shazeer 和 Mitchell Stern 想解決的問題寫在第一頁,Adam 太吃記憶體了。
定義問題
Adam 為每個參數多存兩個數,一階動差 和二階動差 。論文說這讓記憶體變成三倍,權重一份、 一份、 一份。拿一個 的前饋層權重來算,它有 4,194,304 個參數,Adam 就得再存 8,388,608 個數。
2018 年時,作者觀察到運算能力的成長遠快於記憶體容量,記憶體已經是模型大小的上限之一。只算權重與優化器狀態的話,Adam 多出來的那兩份,讓同樣的記憶體只放得下三分之一大的模型。
作者想做到四件事:
- 把二階動差從 個數壓到 個;
- 拿掉一階動差,;
- 處理拿掉動量之後冒出來的不穩定;
- 把步長改成相對於參數大小的比例。
前兩件是省記憶體,第三件是省出來的麻煩,第四件則是作者順手的改進。
解決問題
只記列和與行和
假設某一層權重是 的矩陣,Adam 會為它維護同樣大小的平方梯度指數平均 。如果只存兩個小矩陣 、,讓 ,記憶體就會小很多。問題是要用什麼方法分解。
最常見的低秩近似是截斷 SVD,在 Frobenius 範數下最優,但它有兩個問題。一是前 個奇異向量不能拆開相加,兩個矩陣相加之後的奇異向量,和各自的奇異向量沒有簡單的關係,接不上指數平均;二是近似出來的元素可能是負的,而 Adam 要對 開根號再取倒數。
作者改用非負矩陣分解常用的 generalized KL divergence,又叫 I-divergence:
它永遠不小於 0,只在 時等於 0。目標是在 、 都非負的條件下,讓 最小。一般的秩 需要交替最佳化;秩 1 的情況有解析解(論文 Lemma 1):
是每一列(row)的和, 是每一行(column)的和,分母是全部元素的總和。換成白話,第 列、第 行的估計值,等於「第 列的和 × 第 行的和 ÷ 總和」。
我們拿一個 的例子算算看:
左上角是 ,右下角是 ,整個矩陣原封不動地還原了,因為第二列剛好是第一列的三分之一, 本身就是秩 1。把右下角的 2 改成 8,列和變成 ,行和變成 ,總和 30,右下角的估計只剩 。分解記得住每一列、每一行的整體大小,記不住某一格自己特別突出。
這個解只用到列和與行和,兩者都是 的線性函數,所以「平均之後再加總」等於「加總之後再平均」。實作上直接對列和、行和各做指數平均就行,不必先還原出完整的 。 的那層權重,二階動差從 4,194,304 個數變成 5,120 個。
作者把 的版本寫成 Algorithm 2:
再照 Adam 的方式用 更新。偏差和向量形式的參數維持原本的逐元素 ,它們本來就不大。
拿掉動量,然後出事
第二步更簡單,,連 都不存了。
實驗都在 WMT'14 英翻德的 Transformer 上做,100,000 步,每個 batch 約 4,096 個來源 token 加 4,096 個目標 token,大約是原始 Transformer 論文的八分之一。每種設定都跑兩次,一次有暖身,學習率 ;一次沒有,開頭直接用 。指標是 newstest2013 開發集的 BLEU。
| 設定 | 有暖身 | 無暖身 |
|---|---|---|
| (A) Adam, | 25.6 | 0.1 |
| (B) Adam, | 25.4 | 23.1 |
| (C) 分解二階動差, | 25.4 | 0.2 |
| (D) 只用列平均 | 25.2 | 0.3 |
| (E) 只用行平均 | 0.3 | 0.5 |
整理自原論文 Table 2,所有設定 。
有暖身時,拿掉動量(A 對 B)、再分解二階動差(C),BLEU 只差零點幾。(D)、(E) 是兩個更省的對照,只存列平均或只存行平均。列平均和基準差不多,行平均直接壞掉。作者的解釋是這個模型的詞嵌入和輸出 softmax 共用同一個權重矩陣,每一列對應一個 token;高頻 token 那一列的梯度遠大於低頻 token,只存行平均就把所有 token 混成同一個尺度。
麻煩在右邊那一欄。沒有暖身時,有動量的 (B) 還有 23.1,拿掉動量的 (A) 直接掉到 0.1。
過時的二階動差
作者懷疑問題出在 。 小,二階動差衰減快,Reddi 等人已經指出這會造成收斂問題; 大,估計值來自很久以前的梯度,模型變化快的時候就跟不上。
兩種情況都看得到。 時有暖身 25.6、無暖身 0.1; 時兩邊是 18.4 和 15.6,穩定但學不好。
為了檢查「跟不上」,作者定義了一個量:
是還沒乘學習率的更新。如果 估得準,每個參數的 都應該在 1 附近,整個矩陣的 RMS 也接近 1。
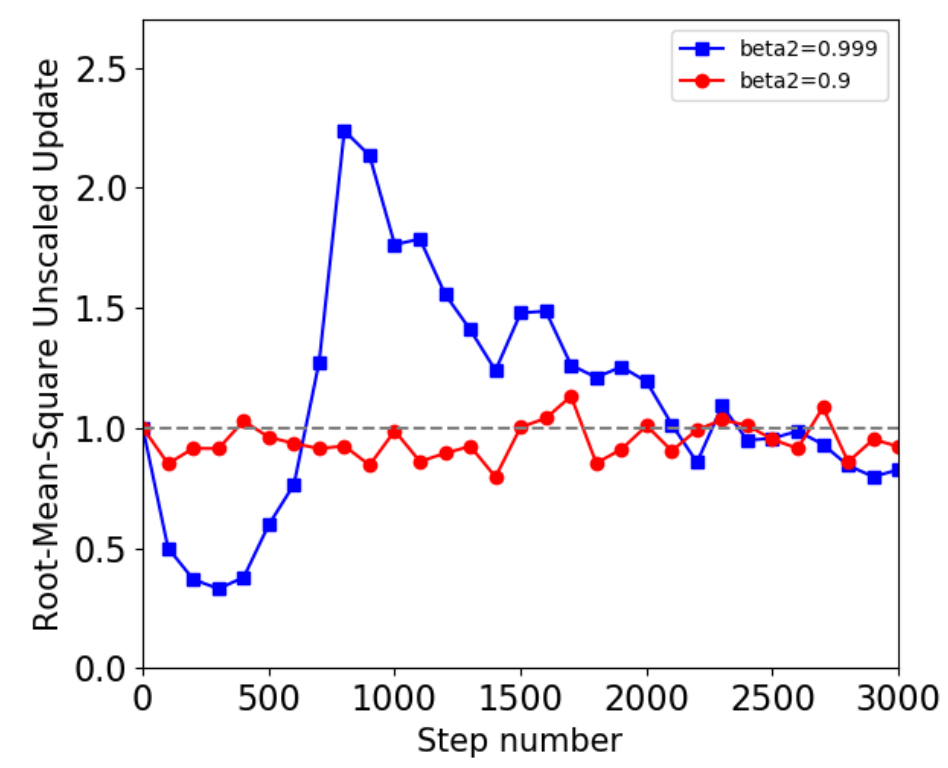
紅線是 ,一直在 1 附近。藍線是 ,前 300 步先掉到 0.33 左右,更新比預期小;接著在第 800 步左右衝到 2.24,更新比預期大了一倍多。這兩次訓練都有暖身,最後都沒有發散,所以不是「訓練崩了才導致更新變大」;作者認為是過大的更新造成不穩定,並坦承這張圖只是支持,還不是證明。
Update clipping
既然問題是更新過大,就直接限制更新:
RMS 超過門檻 ,就把整個矩陣的更新等比例縮回 。這和常見的梯度裁剪不同。梯度裁剪限制的是梯度,但 Adam 這類方法還會逐參數除以 , 一旦過時,裁剪過的梯度照樣能被放大成很大的更新;update clipping 直接限制最後真正用上的那一步。
時,沒有暖身的 0.1 救回到 21.5; 門檻太鬆,仍然只有 0.2。有暖身時,加不加裁剪沒有明顯差別。
讓 隨步數上升
另一條路是讓 一開始小、後來大。作者先指出,Adam 的偏差修正本身就等價於一個遞增的 :
它在 時是 0,之後漸漸逼近 。作者提出另一個排程:
以論文採用的 為例,第 10 步是 0.84,第 100 步 0.975,第 1,000 步 0.996,大約第 5,600 步越過 0.999,第 10,000 步是 0.9994。訓練初期像快衰減,穩定;後期像慢衰減,估計更準。
這個排程還有兩個好處。,所以所有歷史梯度的權重總和恰好是 1,不需要偏差修正。另外,作者用無窮乘積的收斂條件證明, 才能讓每一筆舊梯度的權重最後都趨近 0; 時 升得太快,早期的梯度會一直留著不小的份量。 正好是所有平方梯度的算術平均。
| 設定 | 有暖身 | 無暖身 |
|---|---|---|
| (G) | 18.4 | 15.6 |
| (H) ,裁剪 | 25.4 | 21.5 |
| (I) ,裁剪 | 25.7 | 0.2 |
| (J) 分解,,裁剪 | 25.6 | 22.4 |
| (K) | 25.6 | 21.1 |
| (L) | 25.6 | 0.1 |
| (N) ,裁剪 | 25.9 | 22.4 |
整理自原論文 Table 2,皆為 。
單獨使用就撐住了無暖身的情況; 單獨使用還不夠,要配上裁剪。(N) 拿到全表有暖身時最高的 25.9,(J) 則顯示分解二階動差加上裁剪,也能做到和有動量的 Adam 差不多的穩定。
相對步長
最後一個零件和記憶體無關。Adam 的學習率是絕對步長,作者認為參數的相對變化比較重要,於是讓步長乘上參數本身的大小:
是這個參數矩陣目前的均方根, 是下限,讓初始化為 0 的參數也能離開原點。論文的致謝特別提到 Geoffrey Hinton 的看法,每次更新的大小大約是參數大小的 到 倍時,訓練會很順。
作者用三種詞嵌入初始化測試(50,000 步,batch 16,384 個 token,詞嵌入不和 softmax 共用)。原始 Transformer 的做法是用標準差 初始化、計算時再乘 ,這樣同一個絕對學習率對詞嵌入和其他權重都合適,Adam 26.4、Adafactor 26.6。換成較天真的初始化,Adam 掉到 25.8 和 24.2,Adafactor 還有 26.4 和 25.4。參數尺度設得不好時,相對步長受的影響比較小。
組起來
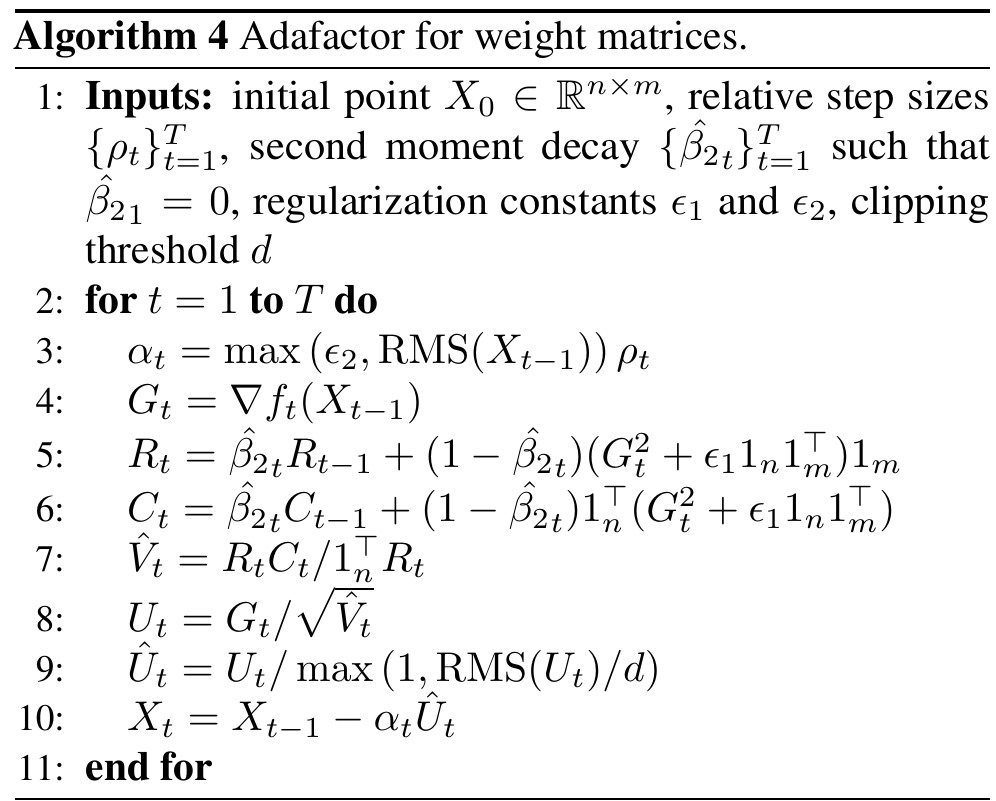
把五個零件串起來就是 Algorithm 4。第 3 行是相對步長,第 5、6 行是加了 的列和、行和平均,第 7 行還原二階動差,第 9 行是 update clipping。論文建議的超參數是 、、、、,沒有動量。整個優化器對一個 矩陣只多存 個數。
討論
完整版的成績
| 設定 | 有暖身 | 無暖身 |
|---|---|---|
| (A) Adam, | 25.6 | 0.1 |
| (B) Adam, | 25.4 | 23.1 |
| (O) Adafactor | 25.0 | 25.5 |
| (P) Adafactor 加回動量 | 24.9 | 25.3 |
| (Q) SGD,最佳學習率 | 24.3 | 9.1 |
整理自原論文 Table 2;(O)、(P) 使用相對步長 ,(Q) 有暖身時 、無暖身時 ,更大的學習率在無暖身時全部發散。
完整的 Adafactor 在沒有暖身時拿到全表最高的 25.5,有暖身時是 25.0,比沒有動量的 (A) 低了 0.6,比有動量的 (B) 低 0.4。作者自己也說,相對步長的步長和其他列不能直接比,無法斷定穩定性是不是相對步長帶來的。SGD 同樣不額外佔記憶體,但最好也只有 24.3,而且對學習率很敏感。
這些結果只來自一個翻譯任務、一種模型、10 萬步,以及比原始設定小八倍的 batch。論文最後說省下的記憶體「應該」能訓練大得多的模型,但沒有任何大模型實驗,也沒有實測記憶體或速度。
後來的 Adafactor
真正的大規模測試,是別人做的。
T5 直接採用 Adafactor,預訓練的學習率「前一萬步固定 0.01,之後按平方根倒數衰減」,其實就是這篇的 。T5 公開的訓練設定檔也沿用論文的 、update clipping 門檻 1.0、分解二階動差與參數縮放。
DeepMind 訓練 Gopher 時試過另一個方向。在 14 億參數時 Adafactor 穩定好用,到了 71 億參數就開始出現小幅的損失發散;Adam 的最大學習率是 ,Adafactor 降到 還是不穩。他們最後仍用 Adafactor 微調 Gopher,因為硬體需求低很多。
Google 訓練 20 億參數的 ViT-G 時,說 Adafactor「不能直接用」,改了三處,加回半精度的一階動差、停用相對於權重範數的步長縮放,並把 的上限截在 0.999。改完後和 Adam 表現相當或略好。
PaLM 的做法更直接。論文寫明用的是「不做分解」的 Adafactor,效果近似帶參數縮放的 Adam;動量 ,二階動差用 ,學習率前一萬步 再按 衰減。他們特別說明,這個 排程比固定 0.99 穩定,因為罕見 token 的詞嵌入在短時間窗內估不準二階動差。
update clipping 也被單獨帶走了。Wortsman 等人在 2023 年發現大型 CLIP 訓練的 loss spike,總在二階動差低估平方梯度後的 1 到 8 步出現,於是提出 StableAdamW,也就是「加上 Adafactor update clipping 的 AdamW」。他們也寫道,大規模訓練已經不太用原始形式的 Adafactor,推測原因是分解二階動差或沒有動量。
在套件這邊,Hugging Face Transformers 很早就有 Adafactor,PyTorch 則到 2.5 版才加入 torch.optim.Adafactor。兩者預設都用相對步長(Hugging Face 可以關掉);PyTorch 的版本把 lr 當作 的上限,並說明 的位置刻意偏離了論文。
結論
Adafactor 用列和與行和的秩 1 分解,把二階動差從 壓到 ,再拿掉動量。拿掉之後的不穩定,作者追到過時的二階動差,用 update clipping 和 的 排程處理掉。這些在一個翻譯任務上成立,後來在 T5 的規模也撐住了;到了數十億參數,Gopher 回報它不穩,PaLM 和 ViT-G 則把動量加了回來。
在 Hugging Face 裡用 Adafactor 又想自己控制學習率的話,記得設 relative_step=False 和 scale_parameter=False。不然優化器會改用內建的 ,或把你的學習率再乘上參數的 RMS,寫好的學習率排程就不會照原樣生效。
PaLM 用的那個 Adafactor,最後連 factor 都拿掉了。